Statistiques de base
Avant d'apprendre divers algorithmes intéressants, nous devons d'abord poser une base cruciale—les statistiques。
Nous pouvons considérer les statistiques comme lelangageet laboîte à outils; sans elles, les modèles d'apprentissage automatique sont comme des explorateurs sans carte, incapables de comprendre les données, de faire des prédictions ou d'évaluer leurs propres performances.
Cet article présentera systématiquement les concepts statistiques essentiels à l'apprentissage automatique, en utilisant un langage simple et des exemples concrets pour vous aider à bâtir une solide base théorique.
Pourquoi l'apprentissage automatique a-t-il besoin de statistiques ?
Raison principale: L'apprentissage automatique consiste essentiellement àapprendre des motifs à partir des données, et à utiliser ce motif pour laprédictionouet la prise de décision.Et la statistique, précisément, est la science de la façon de collecter, analyser, interpréter et présenter des données.
- Compréhension des données: La statistique nous aide à décrire les caractéristiques de base des données (par ex., taille moyenne, répartition des revenus). C'est la première étape du nettoyage et de l'exploration des données.
- Fouille de motifs: Elle fournit des méthodes pour inférer des motifs généraux (modèles) à partir des données, et nous indique à quel point ces motifs sont fiables.
- Prédiction et évaluation: La théorie statistique sous-tend la façon dont nous utilisons les modèles pour faire des prédictions, et comment évaluer objectivement la qualité d'un modèle (devine-t-il aveuglément ou comprend-il vraiment ?).
- Quantification de l'incertitude: Le monde réel est plein de bruit ; la statistique nous permet de quantifier l'incertitude dans les prédictions (par ex., « Je suis sûr à 95% qu'il pleuvra demain »).
En termes simples,la statistique est la pierre angulaire théorique de l'apprentissage automatique, transformant l'intelligence de la mystique en science.
Concept clé 1 : Statistique descriptive
La statistique descriptive, c'est comme prendre un instantané et un rapport de bilan de santé des données, en utilisant quelques indicateurs clés pour résumer l'image globale d'un ensemble de données. C'est le point de départ de tout projet d'analyse de données.
1. Tendance centrale : Où les données se regroupent-elles ?
Ces indicateurs nous disent où se situe le centre ou la valeur typique des données.
| Métrique | Explication (métaphore) | Formule de calcul (brève) | Caractéristiques et utilisations |
|---|---|---|---|
| Moyenne | La moyenne arithmétique de toutes les données. Comme le « salaire moyen ». |
Sum / Number of data points |
La plus couramment utilisée, mais très sensible aux valeurs extrêmes (par ex. les milliardaires) et facilement « tirée vers le haut par la moyenne ». |
| Médiane | Après avoir trié les données de la plus petite à la plus grande,la valeurexactement au milieu. Comme le « salaire médian ». |
Prendre la valeur à la position centrale après tri. | Robuste, non affectée par les valeurs extrêmes, et reflète mieux les situations typiques. |
| Mode | La valeur qui apparaîtle plus fréquemmentdans les données. Comme la pointure la plus vendue dans un magasin. |
La valeur ayant la fréquence la plus élevée | Convient aux données catégorielles, ou pour trouver la catégorie la plus fréquente. |
Exemple: Les salaires mensuels (en milliers de yuans) de 5 employés d’un service sont :[30, 35, 40, 45, 200](Le patron est parmi eux.)
- Moyenne = (30+35+40+45+200)/5 = 70. Cette valeur est artificiellement élevée à cause du 200 du patron et ne peut pas représenter le revenu des employés.
- Médiane= le troisième nombre après le tri40. Cette valeur représente mieux le revenu d’un employé « typique » du service.
- Mode= toutes les valeurs n’apparaissent qu’une seule fois, doncil n’y a pas de mode.。
2. Dispersion : À quel point les données sont-elles dispersées ?
Connaître uniquement le centre ne suffit pas ; nous devons aussi savoir si les données sont étroitement regroupées autour du centre ou largement dispersées. La dispersion mesure la volatilité ou la diversité des données.
| Métrique | Explication (métaphore) | Formule de calcul (brève) | Caractéristiques et utilisations |
|---|---|---|---|
| Variance | La distance de chaque point de données par rapport à la moyenne,au carré,est moyennée. | Σ(每个值 - 均值)² / (n-1) |
Mesure la dispersion globale ; l’unité est le carré de l’unité d’origine. |
| Écart type | La racine carrée positive de la variance.。 Comme « l'amplitude moyenne des fluctuations. » |
√Variance |
Le plus couramment utilisé, avec la même unité que les données d'origine, reflétant intuitivement l'ampleur des fluctuations. Plus la valeur est grande, plus les données sont dispersées. |
| Range | La différence entre les valeurs maximale et minimale. « Étendue des salaires. » |
Maximum value - Minimum value |
Simple à calculer, mais déterminée uniquement par deux valeurs extrêmes, facilement affectée par les valeurs aberrantes. |
En reprenant l'exemple ci-dessus: calculez l'écart-type des salaires des employés (utiliser 40 comme moyenne estimée est plus raisonnable).
- Calculez la variance :
[(30-40)² + (35-40)² + (40-40)² + (45-40)² + (200-40)²] / 4 ≈ 5875 - Écart-type =
√5875 ≈ 76.65. Cet énorme écart-type (76.65) est bien plus grand que la moyenne (40),ce qui indique fortement qu'il existe une valeur aberrante extrême dans les données (le 200 du patron), nécessitant une analyse plus approfondie.
3. Distribution des données et visualisation
Les mesures numériques sont abstraites ; les graphiques nous permettent de « voir » intuitivement les données.
- Histogramme: montre la distribution des fréquences des données dans différents intervalles (classes). Il révèle si les données sont unimodales ou multimodales, et si elles sont symétriques.
- Diagramme en boîte: utilise une « boîte » et des « moustaches » pour afficher leminimum, le premier quartile (Q1), la médiane (Q2), le troisième quartile (Q3) et le maximumdes données, et c'est un outil puissant pour identifier lesvaleurs aberrantes.
Exemple
import matplotlib.pyplot as plt
import seaborn as sns
import numpy as np
# Données de salaire des employés, contenant une valeur aberrante
salaries = np.array([30, 35, 40, 45, 200])
employee_names = ['Alice', 'Bob', 'Charlie', 'Diana', 'Boss']
plt.figure(figsize=(8, 5))
# Créer un diagramme en boîte
sns.boxplot(y=salaries)
plt.title('Répartition des salaires du département (diagramme en boîte)')
plt.ylabel('Salaire (k)')
plt.grid(axis='y', linestyle='--', alpha=0.7)
# Marquer le point correspondant à la valeur aberrante
for i, (name, salary) in enumerate(zip(employee_names, salaries)):
if salary > 45 + 1.5 * (45-35): # Règle simple pour la détection des valeurs aberrantes
plt.annotate(f'{name}: {salary}', xy=(0, salary), xytext=(0.2, salary),
arrowprops=dict(facecolor='red', shrink=0.05))
plt.show()
Explication du code:
sns.boxplot()Tracez un diagramme en boîte. La boîte s'étend de Q1 à Q3, et la ligne médiane est la médiane.- Les « moustaches » d'un diagramme en boîte s'étendent généralement jusqu'au point de données le plus éloigné dans un intervalle de 1,5 fois l'écart interquartile (IQR = Q3 - Q1) ; les points au-delà sont considérés comme desvaleurs aberranteset sont marqués séparément par des points. Sur la figure,
200ce point est clairement identifié comme une valeur aberrante.
Concept clé 2 : Probabilité et distributions
Si la statistique descriptive consiste à examiner l'historique, alors les probabilités servent à prédire l'avenir. Elles quantifientla probabilité qu'un événement se produise.。
1. Probabilités de base
- Probabilité P(A): La probabilité que l'événement A se produise, allant de 0 (impossible) à 1 (certain).
- Probabilité conditionnelle P(A|B): Sous la condition que l'événement Bse soit produit, la probabilité que l'événement A se produise. C'est essentiel pour comprendre de nombreux algorithmes d'apprentissage automatique (comme Naive Bayes).
- Formule :
P(A|B) = P(A 且 B) / P(B)
- Formule :
2. Distributions de probabilité
Décrit les règles de probabilité d'une variable aléatoire prenant diverses valeurs possibles. La plus importante en apprentissage automatique est :
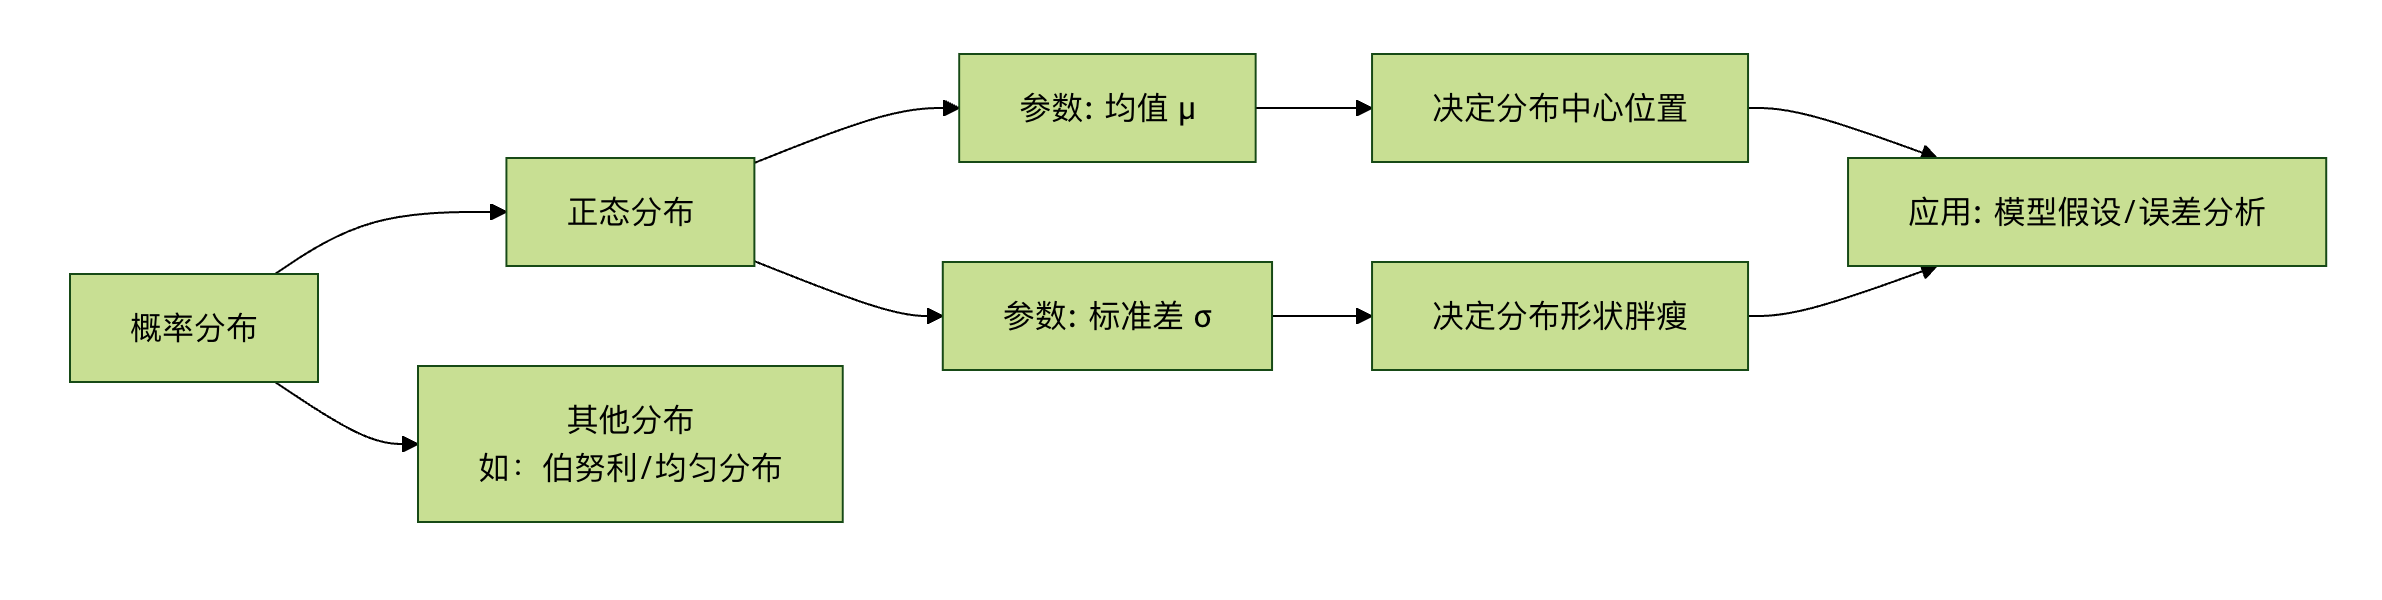
- Distribution normale (distribution gaussienne):
- Forme: La fameuse « courbe en cloche », symétrique à gauche et à droite.
- Paramètres: La **moyenne (μ)** détermine la position centrale, et l'**écart-type (σ)** détermine l'« épaisseur » (dispersion) de la courbe.
- Importance: De nombreux phénomènes de la nature et des sciences sociales suivent approximativement une distribution normale (par ex. la taille, les erreurs de mesure). Le théorème central limite indique que la somme d'un grand nombre de variables aléatoires indépendantes tend vers une distribution normale, ce qui en fait la pierre angulaire de l'inférence statistique.
- Règle 68-95-99.7: Les probabilités que les données se situent dans l'intervalle moyenne ±1σ, ±2σ et ±3σ sont approximativement de 68%, 95% et 99.7%, respectivement.
Concept clé 3 : Statistique inférentielle
C'est la « version avancée » des statistiques ; l'objectif est de passer desdonnées d'échantillonà l'inférence despropriétés de la population.
1. Théorème central limite
Définition: Peu importe la distribution de la population, lorsqu'on prélève un grand nombre d'échantillons indépendantsaléatoires de la population, et qu'on calcule lamoyennede chaque échantillon, la distribution de ces moyennes d'échantillon tend vers unedistribution normale.。
Importance pour l'apprentissage automatique: Cela nous permet d'utiliser les propriétés de la distribution normale pour effectuer destests d'hypothèseset desintervalles de confiancesur les paramètres du modèle (comme la moyenne), fournissant ainsi une base. Même si nous ne connaissons pas la vraie distribution de la population, nous pouvons analyser la fiabilité des estimations fondées sur des échantillons.
2. Tests d'hypothèses
Il est utilisé pour déterminer si une hypothèse concernant la population (comme « le nouveau médicament est inefficace ») est soutenue par les données de l'échantillon.
- Hypothèse nulle (H0): Elle signifie généralement « aucun effet » ou « aucune différence » (position par défaut).
- Hypothèse alternative (H1): L'hypothèse que nous voulons confirmer (par exemple, « le nouveau médicament est efficace »).
- Valeur p: La probabilité d'observer les données d'échantillon actuelles (ou des données plus extrêmes) en supposant que l'hypothèse nulle est vraie.
- Comment décider: Si la valeur p est très petite (généralement < 0.05), cela signifie que la situation actuelle est extrêmement improbable sous H0, donc nous avons suffisamment de preuves pourrejeter H0et accepter H1.
- Niveau de signification (α): Le seuil utilisé pour déterminer si la valeur p est « suffisamment petite », souvent fixé à 0.05.
Applications en apprentissage automatique: Utilisées pour la sélection de caractéristiques afin de déterminer s'il existe une corrélation statistiquement significative entre une caractéristique et la variable cible, plutôt qu'une association fortuite.
3. Corrélation et causalité
C'est l'un des concepts les plus facilement confondus et les plus importants de l'analyse de données.
- Corrélation: mesure la tendance de deux variables àévoluer ensemble. Elle est souvent représentée par le **coefficient de corrélation (allant de -1 à 1)**.
- 1: corrélation positive parfaite (augmentent et diminuent ensemble).
- -1: corrélation négative parfaite (l'une augmente tandis que l'autre diminue).
- 0: aucune corrélation linéaire.
- Causalité: désigne une variable (cause) dontla modification entraîne directementla modification d'une autre variable (effet).
Différence clé:La corrélation n'équivaut pas à la causalité !
- Sophisme classique: les ventes de glaces et les noyades sont fortement corrélées positivement en été. Mais cela ne signifie pas que manger des glaces provoque la noyade. Leurcause commune (variable de confusion)Ouiest le temps chaud.。
- Implications pour l'apprentissage automatique: les modèles d'apprentissage automatique (en particulier les modèles prédictifs) excellent à découvrir descorrélations, mais ne peuvent pas déterminer par eux-mêmes lacausalité. Prendre des corrélations fortes trouvées par les modèles pour des relations causales est une erreur courante en pratique. L'établissement de modèles causaux nécessite des plans expérimentaux plus rigoureux (par ex., des essais contrôlés randomisés) ou des méthodes spéciales d'inférence causale.
Mise en pratique : analyse statistique de base avec Python
Utilisons Python et le célèbrepandas、seabornbibliothèque pour effectuer une analyse statistique descriptive et exploratoire simple sur un jeu de données réel.
Exemple
import seaborn as sns
import matplotlib.pyplot as plt
import numpy as np
# 1. Charger le jeu de données (en utilisant le jeu de données 'tips' sur les pourboires intégré à seaborn)
df = sns.load_dataset('tips')
print("5 premières lignes du jeu de données :")
print(df.head())
print(f"\n"Dimensions du jeu de données : {df.shape}") # Voir le nombre de lignes et de colonnes
print("\n"Informations de base :")
print(df.info())
print("\n"Statistiques descriptives :")
print(df.describe())
# 2. Explorer les variables numériques : montant total de l'addition (total_bill) et pourboire (tip)
print(f"\n"Montant moyen de l'addition : {df['total_bill'].mean():.2f}")
print(f"Montant médian de l'addition : {df['total_bill'].median():.2f}")
print(f"Écart-type du montant de l'addition : {df['total_bill'].std():.2f}")
print(f"Coefficient de corrélation entre le pourboire et le montant de l'addition : {df['tip'].corr(df['total_bill']):.3f}")
# 3. Visualisation
fig, axes = plt.subplots(2, 2, figsize=(12, 10))
# 3.1 Histogramme et estimation de densité du montant de l'addition
sns.histplot(df['total_bill'], kde=True, ax=axes[0, 0])
axes[0, 0].set_title('Distribution du montant total')
axes[0, 0].axvline(df['total_bill'].mean(), color='red', linestyle='--', label=f'Moyenne : {df["total_bill"].mean():.1f}')
axes[0, 0].axvline(df['total_bill'].median(), color='green', linestyle='--', label=f'Médiane : {df["total_bill"].median():.1f}')
axes[0, 0].legend()
# 3.2 Nuage de points du pourboire en fonction du montant total (pour examiner la corrélation)
sns.scatterplot(data=df, x='total_bill', y='tip', hue='time', ax=axes[0, 1])
axes[0, 1].set_title('Pourboire vs montant total (coloré selon le moment du repas)')
# 3.3 Diagramme en boîte du pourboire groupé par sexe (pour comparer les différences entre les groupes)
sns.boxplot(data=df, x='sex', y='tip', ax=axes[1, 0])
axes[1, 0].set_title('Montant du pourboire selon le genre')
# 3.4 Diagramme à barres de l'addition moyenne selon le statut tabagique
bill_by_smoker = df.groupby('smoker')['total_bill'].mean().reset_index()
sns.barplot(data=bill_by_smoker, x='smoker', y='total_bill', ax=axes[1, 1])
axes[1, 1].set_title('Addition totale moyenne selon le statut tabagique')
for index, row in bill_by_smoker.iterrows():
axes[1, 1].text(index, row['total_bill']+0.5, f"{row['total_bill']:.1f}", ha='center')
plt.tight_layout()
plt.show()
Tâches pratiques:
Exécuter le code: Exécutez le code ci-dessus dans votre environnement Python, observez les sorties et les graphiques.
Interpréter les résultats:
- À partir du tableau de statistiques descriptives, pouvez-vous indiquer l'étendue approximative et la médiane du montant total de l'addition ?
- Le pourboire et le montant total de l'addition sont-ils corrélés positivement ou négativement ? Pouvez-vous le déduire du nuage de points ?
- À partir du diagramme en boîte, y a-t-il une différence significative dans le pourboire médian donné par les hommes et les femmes ?
Formulez une hypothèse: À partir du diagramme à barres de l'addition moyenne selon le statut tabagique, pouvez-vous proposer une hypothèse nulle pour letest d'hypothèse? (Par exemple : H0 : il n'y a pas de différence dans l'addition moyenne entre les fumeurs et les non-fumeurs).
Autres extensions