Régression polynomiale
Imaginez que vous observez la trajectoire d'un objet tombant du ciel. Sa vitesse de chute n'est pas uniforme, mais augmente de plus en plus. Si vous utilisez une ligne droite pour ajuster cette trajectoire, le résultat sera très mauvais, car une ligne droite ne peut pas décrire ce changement courbe. À ce stade, nous avons besoin d'une ligne qui peut se courber — la régression polynomiale est un outil puissant pour résoudre ce type de problèmes.
En termes simples,la régression polynomialeest une extension de la régression linéaire. Elle projette les données dans un espace de dimension supérieure en ajoutant des termes de degré supérieur (tels que des termes au carré, des termes au cube) aux caractéristiques d'origine, utilisant ainsi une « courbe » pour ajuster les relations non linéaires présentes dans les données.
1. Concepts fondamentaux : des lignes droites aux courbes
1.1 Rappel de la régression linéaire
La formule du modèle pour la régression linéaire est très simple :y = w₁ * x + boù :
yest la valeur cible que nous voulons prédire.xest la caractéristique d'entrée.w₁est le poids (pente) de la caractéristique.best le terme de biais (ordonnée à l'origine).
Ce modèle détermine qu'il ne peut tracer qu'uneligne droite。
1.2 Introduction à la régression polynomiale
L'idée centrale de la régression polynomiale est :Traiter les puissances supérieures de la caractéristique comme de nouvelles caractéristiquespuis appliquer une régression linéaire sur cet ensemble de caractéristiques étendu.
Par exemple, un modèle de régression polynomiale quadratique :y = w₁ * x + w₂ * x² + b
Vous voyez, bien que l'équation contienne maintenantx²mais si nousxetx²les considérons comme deux caractéristiques indépendantesX1etX2alors le modèle devient :y = w₁ * X1 + w₂ * X2 + bCeci est essentiellement encore unmodèle linéairemais il est linéaire par rapport auxcaractéristiques X1etX2linéaire. C'est pourquoi la régression polynomiale est appelée une « extension de la régression linéaire ».
1.3 Termes clés
- Degré/Ordre: L'exposant le plus élevé dans le polynôme. Le degré 2 est une courbe quadratique (parabole), le degré 3 est une courbe cubique, et ainsi de suite.
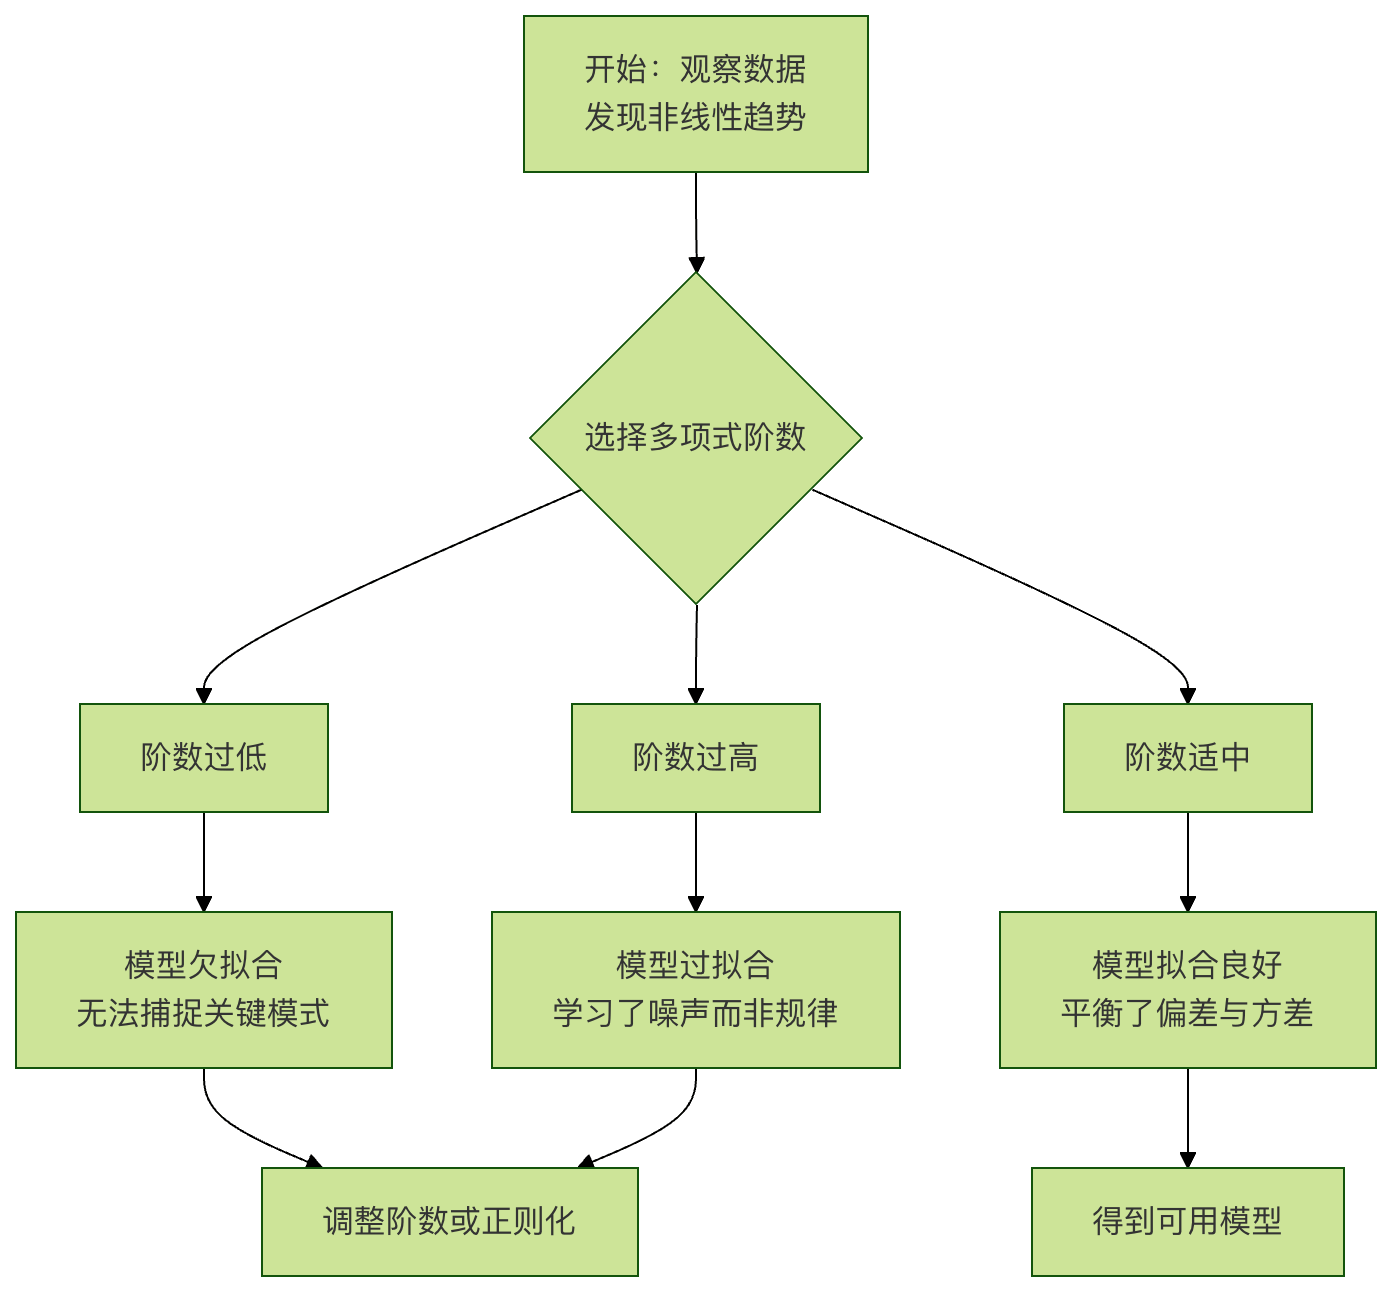
- Surapprentissage: Si le degré choisi est trop élevé, le modèle devient très « tortueux », passant parfaitement par tous les points de données d'entraînement, mais sa capacité à prédire de nouvelles données chute fortement. C'est comme utiliser un filet complexe pour attraper quelques points ; si les mailles sont trop fines, il peut ne pas réussir à attraper de gros poissons.
- Sous-apprentissage: Si le degré est trop faible (par exemple, en utilisant une droite pour ajuster des données clairement courbes), le modèle ne peut pas capturer le schéma sous-jacent dans les données, et sa capacité prédictive est également médiocre.
L'organigramme ci-dessous illustre un processus de réflexion typique pour appliquer la régression polynomiale :
2. Mise en pratique : Implémentation de la régression polynomiale en Python
Nous utiliseronsscikit-learncette puissante bibliothèque d'apprentissage automatique, qui rend l'implémentation de la régression polynomiale très simple.
2.1 Préparation de l'environnement et des données
Tout d'abord, assurez-vous que les bibliothèques nécessaires sont installées, et créez un ensemble de données non linéaires simulées.
Exemple
import numpy as np
import matplotlib.pyplot as plt
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score
# Définir la graine aléatoire pour garantir des résultats cohérents d'une exécution à l'autre
np.random.seed(42)
# Créer des données simulées : y est une fonction quadratique de x plus un bruit aléatoire
X = 6 * np.random.rand(100, 1) - 3 # Générer 100 nombres aléatoires dans l'intervalle [-3, 3)
y = 0.5 * X**2 + X + 2 + np.random.randn(100, 1) # y = 0.5x^2 + x + 2 + bruit
# Visualiser les données d'origine
plt.scatter(X, y, s=10, alpha=0.7, label='Données d'origine')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Données non linéaires simulées')
plt.legend()
plt.show()
En exécutant ce code, vous verrez que les points de données suivent approximativement une distribution en forme de "U" (parabole), et qu'ajuster une droite est clairement inapproprié.
2.2 Étapes clés : transformation des caractéristiques et entraînement du modèle
L'étape clé consiste à utiliserPolynomialFeaturespour générer des termes de caractéristiques de degré supérieur.
Exemple
# Le paramètre degree détermine le degré du polynôme ; ici, nous essayons le degré 2
poly_features = PolynomialFeatures(degree=2, include_bias=False)
# Transformer la caractéristique d'origine X en une nouvelle matrice de caractéristiques X_poly contenant X et X^2
X_poly = poly_features.fit_transform(X)
print(f"Forme d'origine de X : {X.shape}")
print(f"Forme de X_poly après transformation : {X_poly.shape}")
print(f"5 premières lignes des données X_poly :\n{X_poly[:5]}")
# La sortie montre que X_poly a deux colonnes : la première colonne est X, et la seconde est X^2
# 2. Entraîner un modèle de régression linéaire sur les caractéristiques transformées
lin_reg = LinearRegression()
lin_reg.fit(X_poly, y) # Utiliser X_poly au lieu de X d'origine
# 3. Afficher les paramètres appris du modèle (poids et biais)
print(f"\nParamètres du modèle (poids w1, w2) : {lin_reg.coef_.ravel()})
print(f"Biais du modèle (ordonnée à l'origine b) : {lin_reg.intercept_}")
# La sortie doit être proche des paramètres [1, 0.5] et 2 utilisés lors de la génération des données
2.3 Visualisation des résultats de l'ajustement
Voyons à quoi ressemble le modèle « courbe » entraîné.
Exemple
X_new = np.linspace(-3, 3, 100).reshape(100, 1)
# Appliquez la même transformation de caractéristiques polynomiales à ces nouveaux points
X_new_poly = poly_features.transform(X_new)
# Utilisez le modèle pour faire des prédictions
y_new = lin_reg.predict(X_new_poly)
# Commencer le tracé
plt.scatter(X, y, s=10, alpha=0.7, label='Données d’entraînement')
plt.plot(X_new, y_new, 'r-', linewidth=2, label='Ajustement par régression polynomiale (degré=2)')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Effet d'ajustement de la régression polynomiale quadratique')
plt.legend()
plt.show()
Vous devriez voir une belle courbe rouge qui capture bien la tendance parabolique des données.
3. Sujet important : Comment choisir le bon degré ?
Le choix du degré est un processus de compromis. Nous pouvons comprendre cela intuitivement en visualisant les effets d'ajustement des différents degrés.
Exemple
degrees = [1, 2, 15]
plt.figure(figsize=(15, 4))
for i, degree in enumerate(degrees):
# Créer des sous-graphiques
ax = plt.subplot(1, len(degrees), i + 1)
# Générer les caractéristiques polynomiales et entraîner le modèle
poly_features = PolynomialFeatures(degree=degree, include_bias=False)
X_poly = poly_features.fit_transform(X)
lin_reg = LinearRegression()
lin_reg.fit(X_poly, y)
# Prédire et tracer
y_new = lin_reg.predict(poly_features.transform(X_new))
ax.scatter(X, y, s=10, alpha=0.7)
ax.plot(X_new, y_new, 'r-', linewidth=2)
ax.set_title(f'Degré = {degree}')
ax.set_xlabel('X')
ax.set_ylabel('y')
# Calculer et afficher le score R² (plus proche de 1, c'est mieux)
y_pred = lin_reg.predict(X_poly)
r2 = r2_score(y, y_pred)
ax.text(0.05, 0.95, f'$R^2$ = {r2:.3f}', transform=ax.transAxes,
verticalalignment='top', bbox=dict(boxstyle='round', facecolor='wheat', alpha=0.5))
plt.tight_layout()
plt.show()
Observation et interprétation :
- Degré=1 (linéaire): une droite,
R²le score est faible, clairementsous-apprentissage, incapable d'exprimer la courbure des données. - Degré=2 (quadratique): une courbe lisse,
R²le score est élevé, et l'effet d'ajustement est très bon. - Degré=15 (quinzième degré): la courbe oscille fortement, passe par de nombreux points de données, mais prédit bizarrement entre les points de données. Sur les données d'entraînement, il
R²peut être proche de 1, mais ses prédictions sur de nouvelles données seront très mauvaises. C'est un cas typique desurapprentissage。
3.1 Une approche plus scientifique : la validation croisée
En pratique, nous utilisonsla validation croiséepour évaluer la performance de modèles de différents degrés sur des données non vues, et sélectionner le modèle ayant la meilleure performance sur l'ensemble de validation.scikit-learndecross_val_scorepeut facilement y parvenir.
Exemple
# Tester une plage de degrés
degrees_to_try = range(1, 11)
cv_scores = []
for degree in degrees_to_try:
poly_features = PolynomialFeatures(degree=degree, include_bias=False)
X_poly = poly_features.fit_transform(X)
lin_reg = LinearRegression()
# Utiliser une validation croisée à 5 plis avec l'erreur quadratique moyenne négative comme métrique de score (convention sklearn : un score plus élevé est meilleur, donc utiliser la MSE négative)
scores = cross_val_score(lin_reg, X_poly, y, cv=5, scoring='neg_mean_squared_error')
cv_scores.append(-scores.mean()) # Prendre la moyenne et reconvertir en MSE positive
# Trouver le degré qui minimise l'erreur de validation croisée
best_degree = degrees_to_try[np.argmin(cv_scores)]
print(f"D'après la validation croisée, le meilleur degré est : {best_degree}")
# Visualiser comment l'erreur de validation croisée change avec le degré
plt.plot(degrees_to_try, cv_scores, 'bo-')
plt.xlabel('Degré du polynôme')
plt.ylabel('MSE moyen de la validation croisée à 5 plis')
plt.title('Sélection du meilleur degré par validation croisée')
plt.axvline(x=best_degree, color='r', linestyle='--', label=f'Meilleur degré={best_degree}')
plt.legend()
plt.grid(True)
plt.show()
4. Exercices pratiques
Il est maintenant temps de passer à la pratique et de consolider ce que vous avez appris.
Exercice 1 : Diagnostiquer et corrigerExécutez le code suivant. Il tente d'ajuster des données avec une régression polynomiale, mais le résultat est médiocre. Veuillez analyser où se situe le problème, puis modifier le code pour qu'il s'ajuste correctement.
Exemple
import numpy as np
import matplotlib.pyplot as plt
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
X = np.array([1, 2, 3, 4, 5]).reshape(-1, 1)
y = np.array([2, 4, 9, 16, 25]) # Environ y = x^2
# Essayez d'ajuster avec un polynôme de degré 1 (linéaire)
poly = PolynomialFeatures(degree=1)
X_poly = poly.fit_transform(X)
model = LinearRegression().fit(X_poly, y)
X_plot = np.linspace(1, 5, 100).reshape(-1, 1)
X_plot_poly = poly.transform(X_plot)
y_plot = model.predict(X_plot_poly)
plt.scatter(X, y, label='Données')
plt.plot(X_plot, y_plot, 'r-', label='Ajustement')
plt.legend()
plt.show()
Exercice 2 : Explorer un ensemble de données réelUtilisezscikit-learnintégréBoston housing price datasetouDiabetes dataset, sélectionnez une caractéristique qui présente une relation non linéaire avec la valeur cible, et appliquez une régression polynomiale.
- Tracez un nuage de points des données d'origine.
- Essayez différents degrés (2, 3, 4), et visualisez les courbes ajustées.
- Utilisez la validation croisée pour trouver le degré polynomial qui donne la meilleure performance de prédiction pour cette caractéristique.
Exercice 3 : Défi - Régression polynomiale multivariéeDans notre exemple ci-dessus, il n'y a qu'une seule caractéristiquex. La régression polynomiale fonctionne également pour plusieurs caractéristiques. Par exemple, avec deux caractéristiquesx1etx2,degree=2les caractéristiques polynomiales incluraient :x1, x2, x1², x1*x2, x2².(x1, x2)Essayez de créer un jeu de données simulé contenant deux caractéristiquesy = x1 + x2² + 噪声(e.g.,PolynomialFeatures(degree=2)), et utilisez