Полиномиальная регрессия
Представьте, что вы наблюдаете за траекторией объекта, падающего с неба. Его скорость падения не постоянна, а становится всё быстрее и быстрее. Если вы используете прямую линию для аппроксимации этой траектории, результат будет очень плохим, потому что прямая линия не может описать это криволинейное изменение. В этот момент нам нужна линия, которая может изгибаться, — полиномиальная регрессия — мощный инструмент для решения таких задач.
Проще говоря,полиномиальная регрессия— это расширение линейной регрессии. Она отображает данные в пространство более высокой размерности, добавляя к исходным признакам члены более высоких степеней (такие как квадратичные, кубические), тем самым используя «кривую» для аппроксимации нелинейных зависимостей, присутствующих в данных.
1. Основные концепции: от прямых линий к кривым
1.1 Обзор линейной регрессии
Формула модели линейной регрессии очень проста:y = w₁ * x + bгде:
y— это целевое значение, которое мы хотим предсказать.x— входной признак.w₁— это вес (наклон) признака.b— это член смещения (свободный член).
Эта модель определяет, что она может провести толькопрямую линию。
1.2 Введение в полиномиальную регрессию
Основная идея полиномиальной регрессии заключается в следующем:рассматривать более высокие степени признака как новые признакиа затем применить линейную регрессию к этому расширенному набору признаков.
Например, модель квадратичной полиномиальной регрессии:y = w₁ * x + w₂ * x² + b
Как видите, хотя уравнение теперь содержитx²но если мыxиx²рассматриваем их как два независимых признакаX1иX2то модель принимает вид:y = w₁ * X1 + w₂ * X2 + bПо сути, это всё ещёлинейная модельно она линейна относительнопризнаков X1иX2линейна. Именно поэтому полиномиальная регрессия называется «расширением линейной регрессии».
1.3 Ключевые термины
- Степень/Порядок: Наибольший показатель степени в полиноме. Степень 2 — это квадратичная кривая (парабола), степень 3 — кубическая кривая, и так далее.
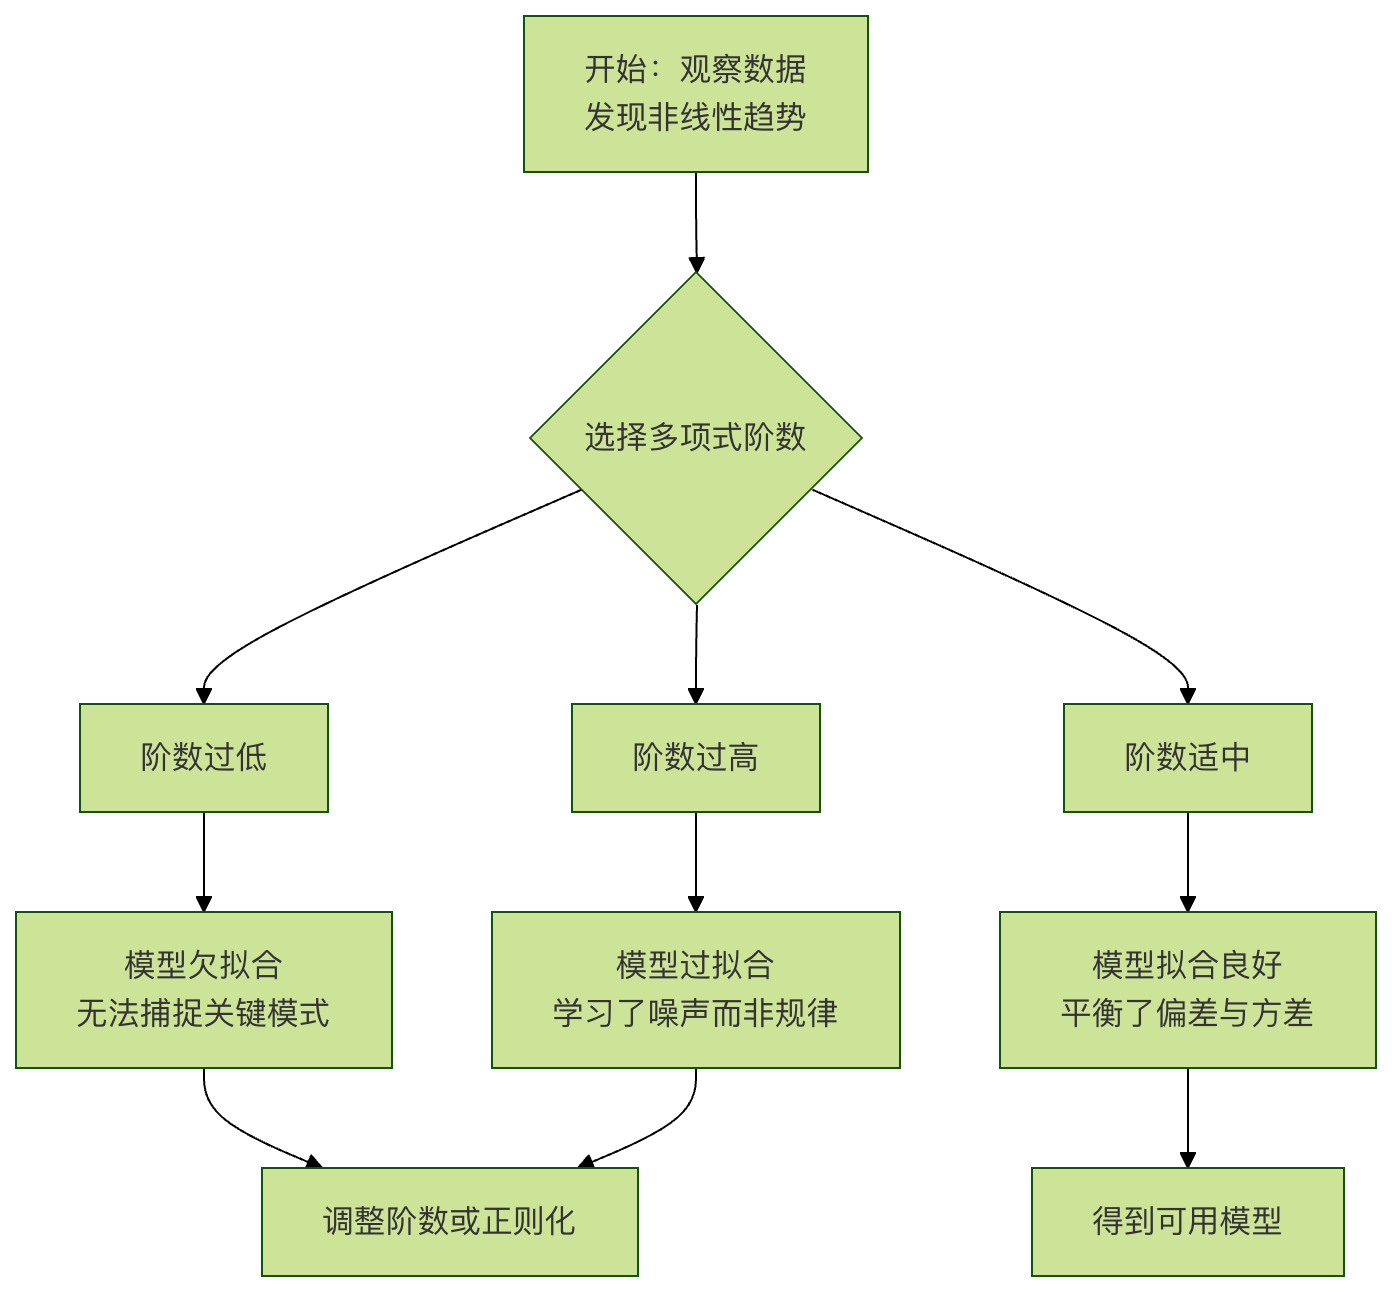
- Переобучение: Если выбранная степень слишком высока, модель становится очень «извилистой», идеально проходя через все точки обучающих данных, но её способность предсказывать новые данные резко падает. Это как использовать сложную сеть, чтобы поймать несколько точек; если ячейки слишком мелкие, она может не поймать крупную рыбу.
- Недообучение: Если степень слишком низка (например, использование прямой линии для аппроксимации явно криволинейных данных), модель не может уловить лежащую в основе данных закономерность, и её предсказательная способность также плоха.
Приведённая ниже блок-схема иллюстрирует типичный ход мыслей при применении полиномиальной регрессии:
2. Практика: реализация полиномиальной регрессии на Python
Мы будем использоватьscikit-learnэта мощная библиотека машинного обучения, которая делает реализацию полиномиальной регрессии очень простой.
2.1 Подготовка окружения и данных
Сначала убедитесь, что необходимые библиотеки установлены, и создайте набор симулированных нелинейных данных.
Пример
import numpy as np
import matplotlib.pyplot as plt
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score
# Установите зерно генератора случайных чисел, чтобы обеспечить одинаковые результаты при разных запусках
np.random.seed(42)
# Создайте симулированные данные: y — квадратичная функция от x плюс некоторый случайный шум
X = 6 * np.random.rand(100, 1) - 3 # Сгенерировать 100 случайных чисел в интервале [-3, 3)
y = 0.5 * X**2 + X + 2 + np.random.randn(100, 1) # y = 0.5x^2 + x + 2 + шум
# Визуализировать исходные данные
plt.scatter(X, y, s=10, alpha=0.7, label='Исходные данные')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Смоделированные нелинейные данные')
plt.legend()
plt.show()
Запустив этот код, вы увидите, что точки данных приблизительно следуют распределению в форме буквы "U" (параболы), и подгонка прямой линии явно неуместна.
2.2 Основные шаги: преобразование признаков и обучение модели
Ключевой шаг — использоватьPolynomialFeaturesдля создания признаков более высокой степени.
Пример
# Параметр degree определяет степень полинома; здесь мы пробуем степень 2
poly_features = PolynomialFeatures(degree=2, include_bias=False)
# Преобразуйте исходный признак X в новую матрицу признаков X_poly, содержащую X и X^2
X_poly = poly_features.fit_transform(X)
print(f"Исходная форма X: {X.shape}")
print(f"Форма преобразованного X_poly: {X_poly.shape}")
print(f"Первые 5 строк данных X_poly:\n{X_poly[:5]}")
# Вывод показывает, что X_poly имеет два столбца: первый столбец — X, а второй — X^2
# 2. Обучите модель линейной регрессии на преобразованных признаках
lin_reg = LinearRegression()
lin_reg.fit(X_poly, y) # Используйте X_poly вместо исходного X
# 3. Просмотрите параметры обученной модели (веса и смещение)
print(f"\nПараметры модели (веса w1, w2): {lin_reg.coef_.ravel()})
print(f"Смещение модели (свободный член b): {lin_reg.intercept_}")
# Вывод должен быть близок к параметрам [1, 0.5] и 2, использованным при генерации данных
2.3 Визуализация результатов подгонки
Посмотрим, как выглядит обученная модель "curve".
Пример
X_new = np.linspace(-3, 3, 100).reshape(100, 1)
# Примените то же преобразование полиномиальных признаков к этим новым точкам
X_new_poly = poly_features.transform(X_new)
# Используйте модель для получения прогнозов
y_new = lin_reg.predict(X_new_poly)
# Начинаем построение графика
plt.scatter(X, y, s=10, alpha=0.7, label='Обучающие данные')
plt.plot(X_new, y_new, 'r-', linewidth=2, label='Подгонка полиномиальной регрессии (degree=2)')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Эффект подгонки квадратичной полиномиальной регрессии')
plt.legend()
plt.show()
Вы должны увидеть красивую красную кривую, которая хорошо отражает параболический тренд данных.
3. Важная тема: как выбрать правильную степень?
Выбор степени — это компромиссный процесс. Мы можем интуитивно понять это, визуализируя эффекты подгонки для разных степеней.
Пример
degrees = [1, 2, 15]
plt.figure(figsize=(15, 4))
for i, degree in enumerate(degrees):
# Создать подграфики
ax = plt.subplot(1, len(degrees), i + 1)
# Сгенерировать полиномиальные признаки и обучить модель
poly_features = PolynomialFeatures(degree=degree, include_bias=False)
X_poly = poly_features.fit_transform(X)
lin_reg = LinearRegression()
lin_reg.fit(X_poly, y)
# Прогнозирование и построение графика
y_new = lin_reg.predict(poly_features.transform(X_new))
ax.scatter(X, y, s=10, alpha=0.7)
ax.plot(X_new, y_new, 'r-', linewidth=2)
ax.set_title(f'Степень = {degree}')
ax.set_xlabel('X')
ax.set_ylabel('y')
# Вычислить и отобразить оценку R² (чем ближе к 1, тем лучше)
y_pred = lin_reg.predict(X_poly)
r2 = r2_score(y, y_pred)
ax.text(0.05, 0.95, f'$R^2$ = {r2:.3f}', transform=ax.transAxes,
verticalalignment='top', bbox=dict(boxstyle='round', facecolor='wheat', alpha=0.5))
plt.tight_layout()
plt.show()
Наблюдение и интерпретация:
- Степень=1 (линейная): прямая линия,
R²оценка низкая, явноенедообучение, не способное выразить кривизну данных. - Степень=2 (квадратичная): гладкая кривая,
R²оценка высокая, и качество подгонки очень хорошее. - Степень=15 (пятнадцатая степень): кривая резко колеблется, проходит через многие точки данных, но даёт странные прогнозы между точками данных. На обучающих данных её оценка
R²может быть близка к 1, но её прогнозы на новых данных будут очень плохими. Это типичноепереобучение。
3.1 Более научный подход: кросс-валидация
На практике мы используемкросс-валидациюдля оценки эффективности моделей с разными степенями на ранее не встречавшихся данных и выбираем модель с лучшей эффективностью на валидационной выборке.scikit-learnизcross_val_scoreпозволяет легко этого добиться.
Пример
# Проверить диапазон степеней
degrees_to_try = range(1, 11)
cv_scores = []
for degree in degrees_to_try:
poly_features = PolynomialFeatures(degree=degree, include_bias=False)
X_poly = poly_features.fit_transform(X)
lin_reg = LinearRegression()
# Используйте 5-кратную кросс-валидацию с отрицательной среднеквадратичной ошибкой в качестве метрики оценки (в sklearn принято, что более высокий балл лучше, поэтому используйте отрицательный MSE)
scores = cross_val_score(lin_reg, X_poly, y, cv=5, scoring='neg_mean_squared_error')
cv_scores.append(-scores.mean()) # Возьмите среднее значение и преобразуйте обратно в положительный MSE
# Найдите степень, которая минимизирует ошибку кросс-валидации
best_degree = degrees_to_try[np.argmin(cv_scores)]
print(f"Согласно кросс-валидации, лучшая степень: {best_degree}")
# Визуализируйте, как ошибка кросс-валидации меняется в зависимости от степени
plt.plot(degrees_to_try, cv_scores, 'bo-')
plt.xlabel('Степень полинома')
plt.ylabel('средний MSE 5-кратной кросс-валидации')
plt.title('Выбор лучшей степени с помощью кросс-валидации')
plt.axvline(x=best_degree, color='r', linestyle='--', label=f'Лучшая степень={best_degree}')
plt.legend()
plt.grid(True)
plt.show()
4. Практические упражнения
Теперь пришло время перейти к практике и закрепить то, что вы узнали.
Упражнение 1: Диагностика и исправлениеЗапустите следующий код. Он пытается подогнать данные с помощью полиномиальной регрессии, но результат получается плохим. Проанализируйте, в чём может быть проблема, и измените код так, чтобы он правильно подгонял данные.
Пример
import numpy as np
import matplotlib.pyplot as plt
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
X = np.array([1, 2, 3, 4, 5]).reshape(-1, 1)
y = np.array([2, 4, 9, 16, 25]) # Приблизительно y = x^2
# Попробуйте подогнать с помощью полинома 1-й степени (линейного)
poly = PolynomialFeatures(degree=1)
X_poly = poly.fit_transform(X)
model = LinearRegression().fit(X_poly, y)
X_plot = np.linspace(1, 5, 100).reshape(-1, 1)
X_plot_poly = poly.transform(X_plot)
y_plot = model.predict(X_plot_poly)
plt.scatter(X, y, label='Данные')
plt.plot(X_plot, y_plot, 'r-', label='Подгонка')
plt.legend()
plt.show()
Упражнение 2: Исследуйте реальный набор данныхИспользуйтеscikit-learnвстроенныйBoston housing price datasetилиDiabetes dataset, выберите признак, имеющий нелинейную связь с целевым значением, и примените полиномиальную регрессию.
- Постройте диаграмму рассеяния для исходных данных.
- Попробуйте разные степени (2, 3, 4) и визуализируйте подогнанные кривые.
- Используйте кросс-валидацию, чтобы найти степень полинома, которая обеспечивает наилучшую производительность прогнозирования для этого признака.
Упражнение 3: Задача — многомерная полиномиальная регрессияВ нашем примере выше есть только один признакx. Полиномиальная регрессия также работает для нескольких признаков. Например, с двумя признакамиx1иx2,degree=2полиномиальные признаки будут включать:x1, x2, x1², x1*x2, x2².(x1, x2)Попробуйте создать синтетический набор данных, содержащий два признакаy = x1 + x2² + 噪声(e.g.,PolynomialFeatures(degree=2)), и используйте