Función de pérdida y gradiente
En este capítulo exploraremos juntos dos conceptos centrales de vital importancia:la función de pérdidayy el gradiente, los cuales son los cimientos sobre los que los algoritmos de aprendizaje automático puedenaprenderyy mejorar.
Imagina que estás aprendiendo a lanzar a la canasta. Después de cada tiro, observas si la pelota entró, se desvió a la izquierda o a la derecha. La diferencia entre ese resultado observado y un tiro perfecto es tupérdida. Y para lanzar con más precisión la próxima vez, ajustas tu postura y fuerza según la dirección y la magnitud de esta desviación; estadirección y magnitud de ajustees similar algradiente。
. En el aprendizaje automático, el modelo es eseaprendiz, la función de pérdida mide sugrado de error, y el gradiente le indicacómo mejorar. Si los entiendes, dominas la lógica central de cómo funciona el aprendizaje automático.
1. Función de pérdida: el boletín de calificaciones del modelo
1.1 ¿Qué es la función de pérdida?
La función de pérdida, a veces también llamadafunción de costooo función objetivo, es una función utilizada paracuantificar la diferencia entre el valor predicho por el modelo y el valor real.
- Función principal: asigna una “nota” concreta al rendimiento de predicción del modelo. Cuanto menor sea esta nota, más precisa es la predicción del modelo; cuanto mayor sea, mayor es el error de predicción.
- Analogía para entenderlo: al igual que en un examen, la “nota” de la función de pérdida es la calificación del modelo. Nuestro objetivo final es, mediante el “aprendizaje” (ajustar los parámetros del modelo), hacer que esta nota (la pérdida) sea cada vez más baja.
1.2 Ejemplos de funciones de pérdida comunes
Diferentes tareas requieren diferentescriterios de puntuación; a continuación se presentan las dos funciones de pérdida más básicas:
Error cuadrático medio- Adecuado para problemas de regresión (predicción de valores continuos, como precios de vivienda o temperatura)
El error cuadrático medio calcula, para todas las muestras, elpromedio de los cuadrados de las diferencias entre el valor predicho y el valor real。
Fórmula: MSE = (1/n) * Σ(真实值ᵢ - 预测值ᵢ)²
n: número de muestrasΣ: símbolo de sumatoriovalor realᵢ: valor real de la i-ésima muestravalor predichoᵢ: valor predicho por el modelo para la i-ésima muestra
Característica: al usar el cuadrado, penaliza más los errores grandes (con un error de 2, el cuadrado aporta 4; con un error de 10, el cuadrado aporta hasta 100).
Ejemplo de código:
Ejemplo
# Supongamos que tenemos los valores reales y predichos de 5 muestras
y_true = np.array([3, -0.5, 2, 7, 4]) # valores reales
y_pred = np.array([2.5, 0.0, 2, 8, 5]) # valores predichos
# Cálculo manual del MSE
n = len(y_true)
squared_errors = (y_true - y_pred) ** 2 # Calculamos el error cuadrático de cada muestra
mse_manual = np.sum(squared_errors) / n # Sumamos y calculamos el promedio
print(fMSE calculado manualmente: {mse_manual})
# Verificamos usando la función de la librería sklearn
from sklearn.metrics import mean_squared_error
mse_sklearn = mean_squared_error(y_true, y_pred)
print(fMSE calculado con Sklearn: {mse_sklearn})
Pérdida de entropía cruzada- Adecuada para problemas de clasificación (predicción de categorías, como si una imagen es un gato o un perro)
La entropía cruzada mide la diferencia entrela distribución de probabilidad predicha por el modeloyy la distribución de probabilidad real. En la clasificación binaria, la distribución real suele ser[1, 0](es la clase A) o[0, 1](es la clase B).
Fórmula de clasificación binaria (pérdida logarítmica):
Log Loss = - (1/n) * Σ [真实值ᵢ * log(预测概率ᵢ) + (1 - 真实值ᵢ) * log(1 - 预测概率ᵢ)]
Comprensión intuitiva: cuando la etiqueta real es 1, esperamos que la probabilidad predicha por el modelo también se acerque a 1. Si en ese momento el modelo predice una probabilidad muy baja (por ejemplo, 0.1), entonceslog(0.1)será un número negativo muy grande y, al multiplicarlo por el signo negativo delante, hará que el valor de pérdida sea muy grande, lo que indica un castigo severo.
Ejemplo de código:
Ejemplo
from sklearn.metrics import log_loss
# Ejemplo de clasificación binaria: etiqueta real (1 significa “sí”, 0 significa “no”)
y_true_binary = np.array([1, 0, 0, 1]) # Clases reales: sí, no, no, sí
# Probabilidad que el modelo predice para la clase “sí”
y_pred_prob = np.array([0.9, 0.1, 0.2, 0.8]) # Probabilidades predichas: 0.9, 0.1, 0.2, 0.8
# Calculamos la pérdida de entropía cruzada (pérdida logarítmica) con sklearn
ce_loss = log_loss(y_true_binary, y_pred_prob)
print(fPérdida de entropía cruzada (Log Loss): {ce_loss})
2. Gradiente: la “brújula” que guía la dirección de la optimización
Ahora que sabemos cómo calificar al modelo (función de pérdida), la pregunta más clave a continuación es:¿Cómo mejora el modelo a partir de esta calificación?La respuesta es mediante elgradiente。
2.1 ¿Qué es el gradiente?
En el aprendizaje automático, el modelo normalmente está formado por muchosparámetros(también llamadospesos). Podemos considerar que lafunción de pérdida Les una función de todos estos parámetros:L(w1, w2, ..., wn)。
- El gradientees el vector de las derivadas parciales de la función de pérdida (respecto acada parámetro).deDichas derivadas parcialesconstituyen el vector.
- Representación matemática:
∇L = [∂L/∂w1, ∂L/∂w2, ..., ∂L/∂wn] - Significado fundamental:
- Dirección: la dirección a la que apunta el vector gradiente es la deascenso más rápidode la función de pérdida en ese punto.
- Magnitud: el valor absoluto de cada derivada parcial indica lasensibilidad de la función de pérdida ante cambios en ese parámetro.。
2.2 ¿Por qué el gradiente puede guiar la optimización?
Nuestro objetivo esminimizar la función de pérdida. Dado que el gradiente apunta en la dirección de ascenso más rápido de la pérdida, su dirección opuesta-∇Lnaturalmente es la dirección dedescenso más rápidode la pérdida.
El proceso de optimización (descenso de gradiente) se puede entender de forma gráfica como::
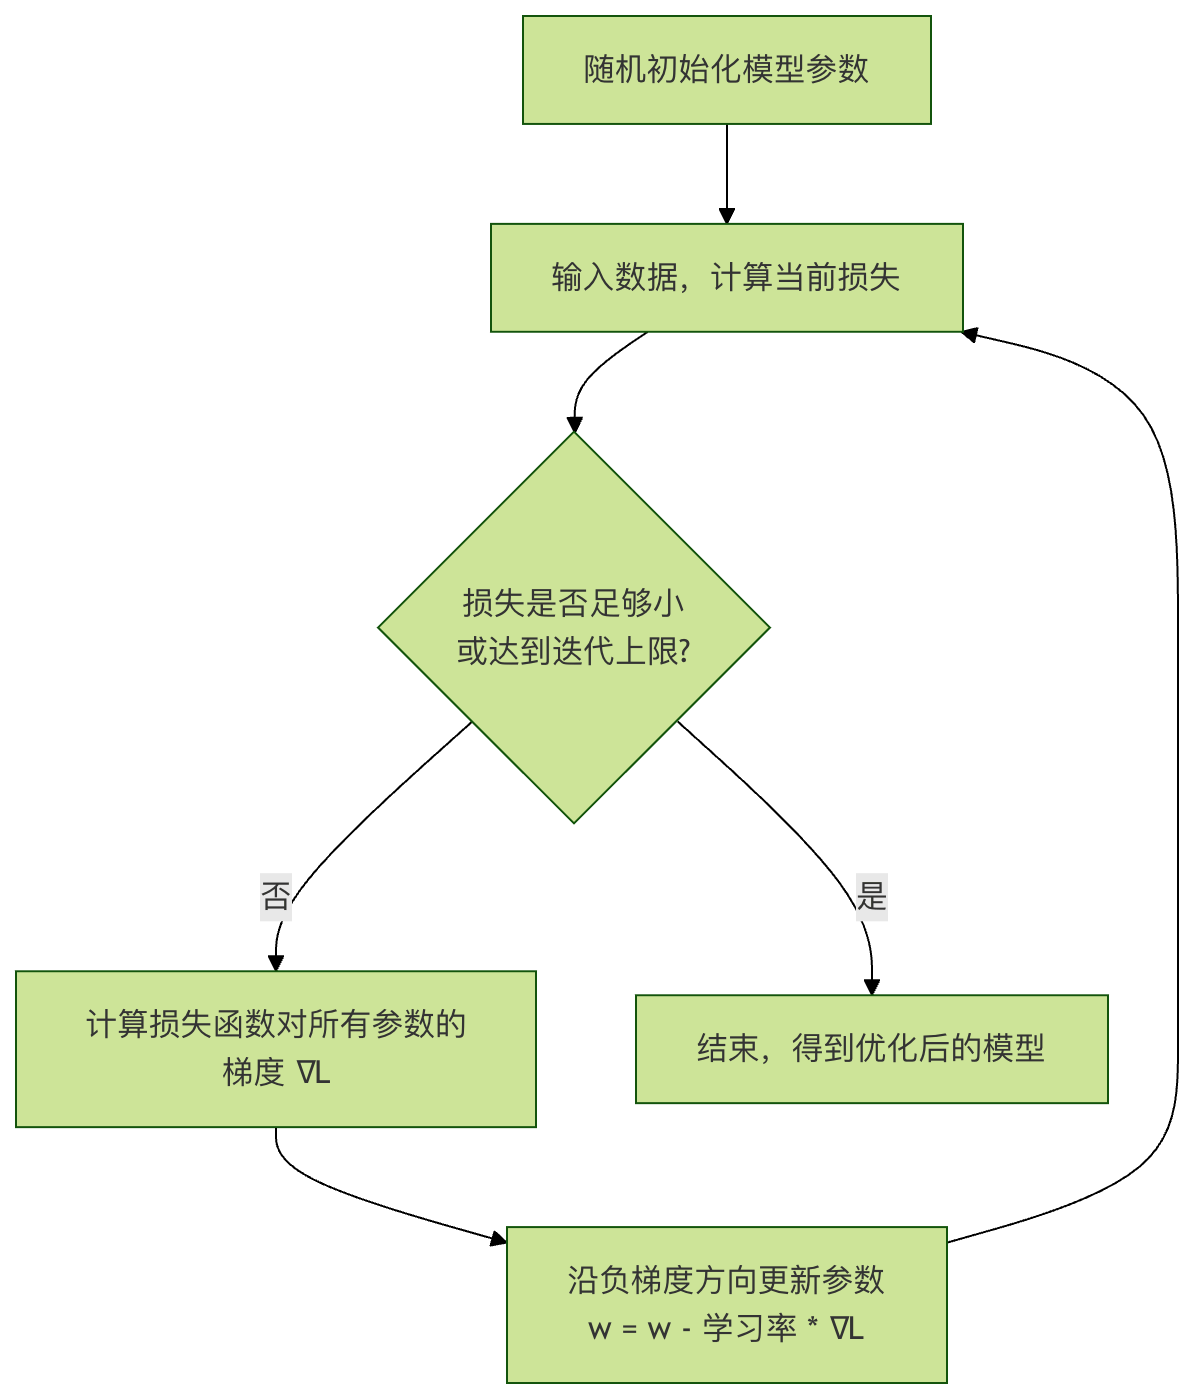
estás de pie en una ladera de un valle (superficie de pérdida), con los ojos vendados y quieres llegar al fondo del valle (el punto de pérdida mínima). Antes de cada paso, usas el pie para sentir en qué dirección la pendiente es más pronunciada (calcular el gradiente) y avanzas hacia lacuesta abajo más pronunciada(dirección del gradiente negativo) das un paso (actualizar parámetros). Repitiendo este proceso, finalmente llegas al fondo del valle.
Este proceso se puede resumir con el siguiente diagrama de flujo:
2.3 Ejemplo sencillo de descenso de gradiente
Usemos el ejemplo más simple: un modelo lineal con un solo parámetrowpara demostrar el descenso de gradiente.
Supongamos que nuestra función de pérdida esL(w) = w². Obviamente, cuandow = 0, la pérdida es mínima.
- Cálculo del gradiente:
∇L = dL/dw = 2w - Fórmula de actualización de parámetros:
w_new = w_old - η * (2 * w_old)ηSíTasa de aprendizaje, controla el tamaño de cada paso.
Ejemplo
import matplotlib.pyplot as plt
# Definimos la función de pérdida L(w) = w^2
def loss(w):
return w ** 2
# Definimos el gradiente dL/dw = 2*w
def gradient(w):
return 2 * w
# Algoritmo de descenso de gradiente
def gradient_descent(start_w, learning_rate, iterations):
w = start_w
w_history = [w] # Registramos el historial de cambios de w
loss_history = [loss(w)] # Registramos el historial de cambios de la pérdida
for i in range(iterations):
grad = gradient(w) # Calculamos el gradiente en el punto actual
w = w - learning_rate * grad # Actualizamos el parámetro en la dirección del gradiente negativo
w_history.append(w)
loss_history.append(loss(w))
return w_history, loss_history
# Ejecutamos el descenso de gradiente: comenzamos en w=5, con tasa de aprendizaje 0.1 y 20 iteraciones
w_start = 5.0
lr = 0.1
iters = 20
w_hist, loss_hist = gradient_descent(w_start, lr, iters)
print(fw inicial: {w_hist)
print(fw final: {w_hist[-1]:.4f}, pérdida final: {loss_hist[-1]:.4f})
# Visualizamos el proceso de optimización
plt.figure(figsize=(12, 4))
# Gráfico 1: curva de la función de pérdida y trayectoria de optimización
plt.subplot(1, 2, 1)
w_vals = np.linspace(-6, 6, 100)
plt.plot(w_vals, loss(w_vals), label='L(w) = w²')
plt.scatter(w_hist, loss_hist, c='red', s=20, label='Gradient Descent Steps')
plt.plot(w_hist, loss_hist, 'r--', alpha=0.5)
plt.xlabel('Parameter w')
plt.ylabel('Loss L(w)')
plt.title('Gradient Descent on L(w)=w²')
plt.legend()
plt.grid(True)
# Gráfico 2: curva de disminución del valor de pérdida según el número de iteraciones
plt.subplot(1, 2, 2)
plt.plot(range(len(loss_hist)), loss_hist, 'b-o')
plt.xlabel('Iteration')
plt.ylabel('Loss')
plt.title('Loss Reduction Over Iterations')
plt.grid(True)
plt.tight_layout()
plt.show()
Al ejecutar este código, verás que:
- el gráfico de la izquierda muestra cómo el parámetro
wcomienza en 5.0 y “rueda” paso a paso por la parábola hasta acercarse al punto mínimo 0. - El gráfico de la derecha muestra cómo el valor de pérdida disminuye rápidamente a medida que aumentan las iteraciones.
3. Puntos clave y resumen de la relación
| Concepto | Metáfora | Función principal | Puntos clave |
|---|---|---|---|
| Función de pérdida | Boletín de calificaciones / regla de medición de errores | Evalúa cuantitativamente qué tan buenas son las predicciones del modelo. | 1. Diferentes tipos de tareas (regresión, clasificación) utilizan diferentes funciones de pérdida. 2. Cuanto menor sea el valor de la pérdida, mejor será el rendimiento del modelo. |
| Gradiente | Brújula / dirección de descenso más pronunciado | Indica cómo se debe ajustar cada parámetro del modelo para reducir la pérdida lo más rápido posible. | 1. Es el vector de derivadas parciales de la función de pérdida con respecto a todos los parámetros. 2. Dirección del gradiente negativoEs la dirección en la que la pérdida disminuye más rápido. |
| Descenso de gradiente | Método de bajar la montaña con los ojos vendados | Utiliza la información del gradiente para actualizar los parámetros de forma iterativa y minimizar la pérdida. | 1. Tasa de aprendizajeEs un hiperparámetro clave: si es demasiado pequeño, el aprendizaje es lento; si es demasiado grande, puede no converger. 2. Es el algoritmo de optimización subyacente para entrenar la mayoría de los modelos de aprendizaje automático. |
La cadena de relación entre ellos es:: El modelo hace una predicción → la función de pérdida calcula el error → se calcula el gradiente del error con respecto a cada parámetro → se actualizan los parámetros en la dirección del gradiente negativo → el modelo mejora → repetir...
Otras extensiones