Fonctions de perte et gradients
Dans ce chapitre, nous allons explorer deux concepts fondamentaux cruciaux :Fonction de perteetGradient, qui sont la pierre angulaire permettant aux algorithmes d'apprentissage automatique d'apprendreets'améliorer.
Imaginez que vous apprenez à tirer au basket-ball. Après chaque tir, vous observez si le ballon est entré, a dévié à gauche ou a dévié à droite. L'écart entre ce résultat observé et un tir parfait est votreperte. Pour tirer plus précisément la prochaine fois, vous ajustez votre posture et votre force en fonction de la direction et de l'amplitude de cet écart. Cettedirection et l'amplitude de l'ajustementsont similaires augradient。
En apprentissage automatique, le modèle est l'apprenant, la fonction de perte mesure sondegré d'erreur, et le gradient lui indiquecomment s'améliorer. Comprendre ces éléments vous donne la logique fondamentale du fonctionnement de l'apprentissage automatique.
I. Fonctions de perte : Le bulletin scolaire du modèle
1.1 Qu'est-ce qu'une fonction de perte ?
Une fonction de perte, parfois appeléefonction de coûtoufonction objectif, est une fonction utilisée pourquantifier l'écart entre les prédictions du modèle et les valeurs réelles.
- Rôle central: Il donne un "score" concret à la performance de prédiction du modèle. Plus ce score est bas, plus les prédictions du modèle sont précises ; plus ce score est élevé, plus l'erreur de prédiction est grande.
- Analogie: Tout comme un examen, le "score" de la fonction de perte est la note d'examen du modèle. Notre objectif ultime est de rendre ce score (la perte) de plus en plus bas grâce à l'"apprentissage" (l'ajustement des paramètres du modèle).
1.2 Exemples de fonctions de perte courantes
Différentes tâches nécessitent différentscritères d’évaluation. Voici deux des fonctions de perte les plus élémentaires :
Erreur quadratique moyenne- Adaptée aux problèmes de régression (prédiction de valeurs continues, telles que les prix immobiliers, la température)
L’erreur quadratique moyenne calcule lamoyenne des différences au carré entre les valeurs prédites et les valeurs réelles sur tous les échantillons。
Formule: MSE = (1/n) * Σ(真实值ᵢ - 预测值ᵢ)²
n: nombre d’échantillonsΣ: symbole de sommationTrue valueᵢ: valeur réelle du i-ème échantillonPredicted valueᵢ: valeur prédite du modèle pour le i-ème échantillon
Caractéristiques: Comme elle utilise la mise au carré, elle pénalise plus lourdement les erreurs plus grandes (lorsque l’erreur est 2, la contribution au carré est 4 ; lorsque l’erreur est 10, la contribution au carré atteint 100).
Exemple de code:
Exemple
# Supposons que nous ayons les valeurs réelles et prédites pour 5 échantillons
y_true = np.array([3, -0.5, 2, 7, 4]) # Valeurs réelles
y_pred = np.array([2.5, 0.0, 2, 8, 5]) # Valeurs prédites
# Calculer manuellement le MSE
n = len(y_true)
squared_errors = (y_true - y_pred) ** 2 # Calculer l'erreur quadratique pour chaque échantillon
mse_manual = np.sum(squared_errors) / n # Additionner et faire la moyenne
print(f"MSE calculé manuellement : {mse_manual}")
# Vérifier à l'aide de la fonction de la bibliothèque sklearn
from sklearn.metrics import mean_squared_error
mse_sklearn = mean_squared_error(y_true, y_pred)
print(f"MSE calculé par Sklearn : {mse_sklearn}")
Perte d'entropie croisée- Adaptée aux problèmes de classification (prédire des catégories, par exemple déterminer si une image est un chat ou un chien)
L'entropie croisée mesure la différence entre ladistribution de probabilité prédite par le modèleetet la véritable distribution de probabilité. En classification binaire, la distribution vraie est généralement[1, 0](est la catégorie A) ou[0, 1](est de catégorie B).
Formule de classification binaire (perte logarithmique):
Log Loss = - (1/n) * Σ [真实值ᵢ * log(预测概率ᵢ) + (1 - 真实值ᵢ) * log(1 - 预测概率ᵢ)]
Compréhension intuitive: Lorsque l'étiquette réelle est 1, nous espérons que la probabilité prédite par le modèle soit également proche de 1. Si le modèle prédit une probabilité très faible (par ex. 0.1) à ce stade, alorslog(0.1)il s'agira d'un nombre négatif très grand ; la multiplication par le signe négatif précédent fait que la valeur de perte devient très grande, ce qui indique une pénalité forte.
Exemple de code:
Exemple
from sklearn.metrics import log_loss
# Exemple de classification binaire : étiquettes réelles (1 représente « oui », 0 représente « non »)
y_true_binary = np.array([1, 0, 0, 1]) # Classes réelles : oui, non, non, oui
# Probabilité prédite par le modèle pour la classe « oui »
y_pred_prob = np.array([0.9, 0.1, 0.2, 0.8]) # Probabilités prédites : 0.9, 0.1, 0.2, 0.8
# Utiliser sklearn pour calculer la perte d'entropie croisée (perte logarithmique)
ce_loss = log_loss(y_true_binary, y_pred_prob)
print(f"Perte d'entropie croisée (perte logarithmique) : {ce_loss}")
II. Gradient : La « boussole » guidant la direction de l'optimisation
Maintenant que nous savons comment évaluer le modèle (fonction de perte). La question suivante, la plus cruciale, est :Comment le modèle s'améliore-t-il à partir de ce score ?La réponse passe par legradient。
2.1 Qu'est-ce qu'un gradient ?
En apprentissage automatique, un modèle est généralement composé de nombreuxparamètres(oupoids). Nous pouvons considérer lafonction de perte Lcomme une fonction de tous ces paramètres :L(w1, w2, ..., wn)。
- Le gradientest le vecteur formé par lesdérivées partiellesdela fonction de perte par rapport à chaque paramètre.
- Représentation mathématique:
∇L = [∂L/∂w1, ∂L/∂w2, ..., ∂L/∂wn] - Signification principale:
- Direction: La direction indiquée par le vecteur gradient est la direction dans laquelle la fonction de perteaugmente le plus rapidementen ce point.
- Amplitude: La valeur absolue de chaque dérivée partielle représente lasensibilité。
2.2 Pourquoi les gradients peuvent-ils guider l'optimisation ?
Notre objectif est deminimiser la fonction de perte. Comme le gradient pointe dans la direction où la perte augmente le plus rapidement, sa direction opposée-∇Lest naturellement celle où la pertediminue le plus rapidement.
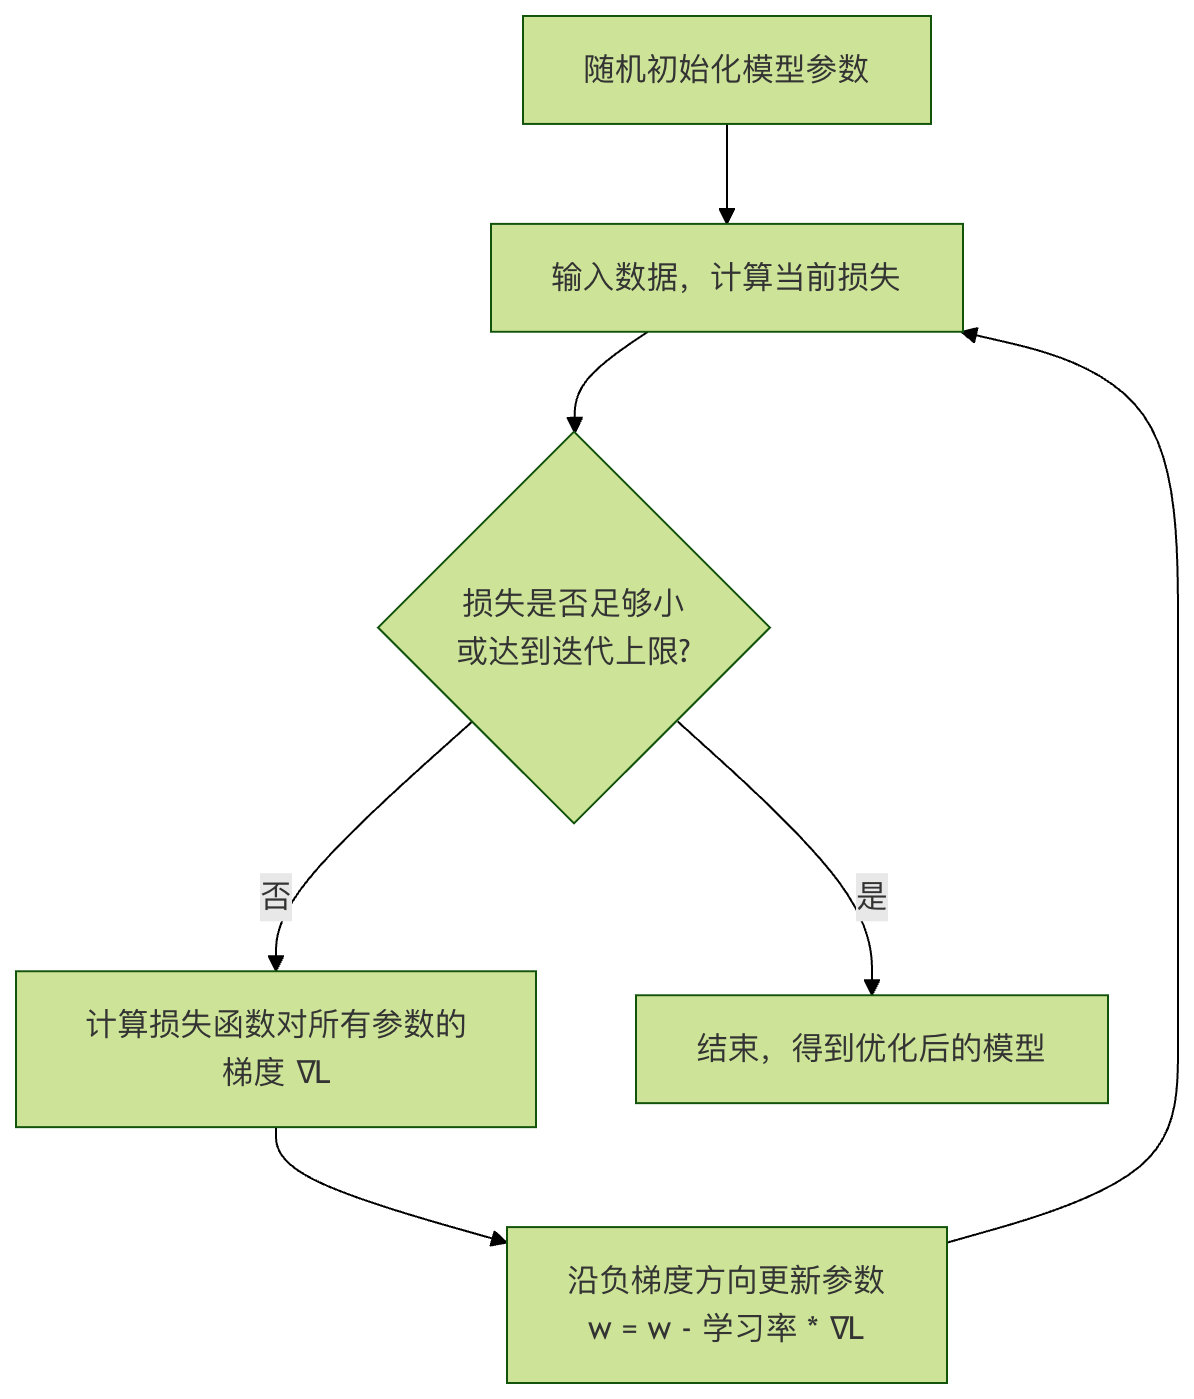
Le processus d'optimisation (descente de gradient) peut être compris de manière imagée comme:
se tenir sur le flanc d'une colline d'une vallée (surface de perte), les yeux bandés, en voulant atteindre le fond de la vallée (le point de perte minimale). Avant chaque pas, vous utilisez vos pieds pour sentir quelle direction autour de vous est la plus raide (calculer le gradient), puis vous vous dirigez vers la plus raidedirection descendante(direction du gradient négatif) pour faire un pas (mettre à jour les paramètres). En répétant ce processus, vous atteindrez finalement le fond de la vallée.
Ce processus peut être résumé par l'organigramme suivant :
2.3 Un exemple simple de descente de gradient
Utilisons un exemple très simple — un modèle linéaire avec un seul paramètrewpour démontrer la descente de gradient.
Supposons que notre fonction de perte soitL(w) = w². Évidemment, lorsquew = 0, la perte est minimisée.
- Calcul du gradient:
∇L = dL/dw = 2w - Formule de mise à jour des paramètres:
w_new = w_old - η * (2 * w_old)ηOuiTaux d'apprentissage, contrôle la taille de chaque pas.
Exemple
import matplotlib.pyplot as plt
# Définir la fonction de perte L(w) = w^2
def loss(w):
return w ** 2
# Définir le gradient dL/dw = 2*w
def gradient(w):
return 2 * w
# Algorithme de descente de gradient
def gradient_descent(start_w, learning_rate, iterations):
w = start_w
w_history = [w] # Enregistrer l'historique des changements de w
loss_history = [loss(w)] # Enregistrer l'historique des changements de perte
for i in range(iterations):
grad = gradient(w) # Calculer le gradient au point courant
w = w - learning_rate * grad # Mettre à jour les paramètres dans la direction opposée au gradient
w_history.append(w)
loss_history.append(loss(w))
return w_history, loss_history
# Exécuter la descente de gradient : partir de w=5, taux d'apprentissage 0.1, itérer 20 fois
w_start = 5.0
lr = 0.1
iters = 20
w_hist, loss_hist = gradient_descent(w_start, lr, iters)
print(f"w initial : {w_hist)
print(f"w final : {w_hist[-1]:.4f}, perte finale : {loss_hist[-1]:.4f}")
# Visualiser le processus d'optimisation
plt.figure(figsize=(12, 4))
# Figure 1 : Courbe de la fonction de perte et chemin d'optimisation
plt.subplot(1, 2, 1)
w_vals = np.linspace(-6, 6, 100)
plt.plot(w_vals, loss(w_vals), label='L(w) = w²')
plt.scatter(w_hist, loss_hist, c='red', s=20, label='Étapes de la descente de gradient')
plt.plot(w_hist, loss_hist, 'r--', alpha=0.5)
plt.xlabel('Paramètre w')
plt.ylabel('Perte L(w)')
plt.title('Descente de gradient sur L(w)=w²')
plt.legend()
plt.grid(True)
# Figure 2 : Courbe de décroissance de la valeur de perte au fil des itérations
plt.subplot(1, 2, 2)
plt.plot(range(len(loss_hist)), loss_hist, 'b-o')
plt.xlabel('Itération')
plt.ylabel('Perte')
plt.title('Réduction de la perte au fil des itérations')
plt.grid(True)
plt.tight_layout()
plt.show()
Exécutez ce code, et vous verrez:
- la figure de gauche montre comment le paramètre
wcommence à 5.0 et, étape par étape, « redescend » la parabole, pour finalement approcher le point minimum 0. - La figure de droite montre comment la valeur de perte diminue rapidement à mesure que le nombre d'itérations augmente.
III. Points clés et résumé des relations
| Concept | Métaphore | Rôle principal | Points clés |
|---|---|---|---|
| Fonction de perte | Bulletin de notes / règle de mesure de l'erreur | Évaluer quantitativement à quel point les prédictions du modèle sont bonnes ou mauvaises. | 1. Différents types de tâches (régression, classification) utilisent différentes fonctions de perte. 2. Plus la valeur de perte est faible, meilleures sont les performances du modèle. |
| Gradient | Boussole / direction de descente la plus raide | Indique comment chaque paramètre du modèle doit être ajusté pour réduire la perte le plus rapidement possible. | 1. C'est le vecteur des dérivées partielles de la fonction de perte par rapport à tous les paramètres. 2. Direction du gradient négatifEst la direction dans laquelle la perte diminue le plus rapidement. |
| Descente de gradient | Méthode de descente de colline à l'aveugle | Utilise les informations de gradient pour mettre à jour itérativement les paramètres afin de minimiser la perte. | 1. Taux d'apprentissageEst un hyperparamètre clé ; trop petit rend l'apprentissage lent, trop grand peut ne pas converger. 2. C'est l'algorithme d'optimisation sous-jacent pour l'entraînement de la plupart des modèles d'apprentissage automatique. |
La chaîne de relations entre eux est: Le modèle fait des prédictions → La fonction de perte calcule l'erreur → Calculer le gradient de l'erreur par rapport à chaque paramètre → Mettre à jour les paramètres dans la direction du gradient négatif → Le modèle s'améliore → Répéter...
Autres extensions