Propagation avant et rétropropagation
En apprentissage profond, la propagation avant et la rétropropagation sont les deux piliers essentiels qui soutiennent son fonctionnement. Elles sont comme les deux faces d'une même pièce, formant ensemble une boucle complète, de l'apprentissage à l'application, dans les réseaux de neurones. Comprendre en profondeur ces deux processus est la première clé pour ouvrir la porte de l'apprentissage profond.
Cet article vous fera parcourir pas à pas ces concepts apparemment complexes, à l'aide d'une logique claire et d'analogies vivantes, afin que vous sachiez non seulement ce qu'ils sont, mais aussi pourquoi ils fonctionnent.
Que sont la propagation avant et la rétropropagation ?
Avant d'entrer dans les détails, commençons par établir une compréhension globale.
Imaginez que vous apprenez à un enfant à reconnaître les chats et les chiens. Vous lui montrez une image (entrée), et, d'après les connaissances déjà présentes dans son cerveau (paramètres du réseau, c'est-à-dire les poids et les biais), il porte un jugement, puis vous dit qu'il s'agit d'un chat (sortie). Ce processus consistant à regarder l'image -> traitement cérébral -> donner une réponse estla propagation avant。
Mais le jugement de l'enfant peut être erroné. Vous lui dites : non, c'est un chien. La différence entre la réponse correcte et la réponse de l'enfant estune erreur. L'enfant doit réfléchir à partir de cette erreur : quelles connaissances (paramètres) dans mon cerveau ont conduit à cette mauvaise interprétation ? Comment dois-je les ajuster pour pouvoir reconnaître correctement la prochaine fois ? Ce processus d'ajustement des connaissances de l'arrière vers l'avant en fonction de l'erreur estrétropropagation。
Dans les réseaux de neurones :
- Propagation avant: Le processus par lequel les données partent de la couche d'entrée, traversent les couches cachées et atteignent finalement la couche de sortie, produisant un résultat de prédiction. C'est un processus d'inférence.
- Rétropropagation: En se basant sur l'erreur entre le résultat de prédiction produit par la propagation avant et la valeur réelle, en partant de la couche de sortie, elle calcule à rebours, couche par couche, la « contribution » de chaque paramètre (poids et biais) à l'erreur totale (c'est-à-dire le gradient), et met à jour les paramètres en conséquence. C'est unapprentissage.
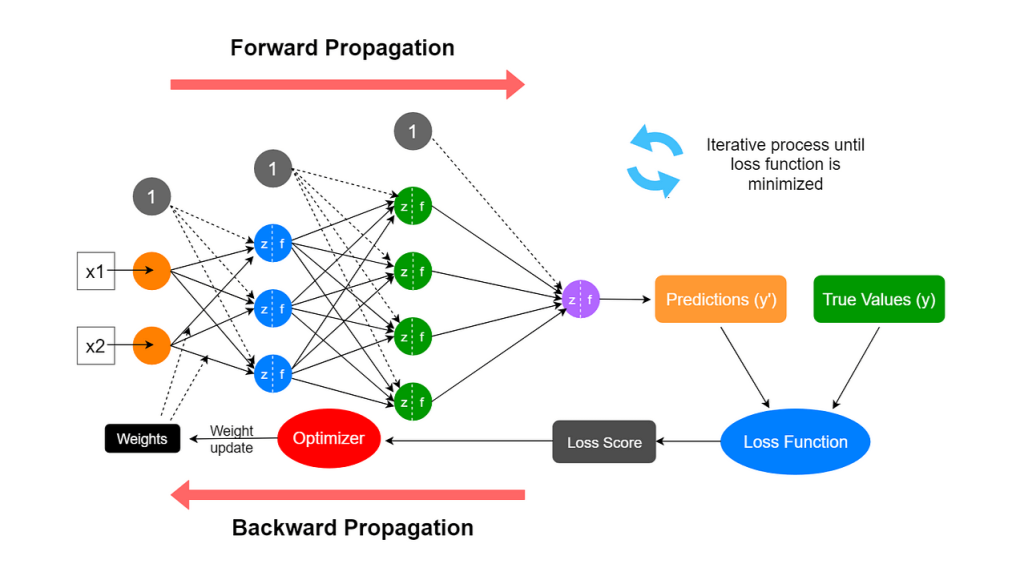
Leur relation peut être représentée par un simple diagramme de boucle d'apprentissage :
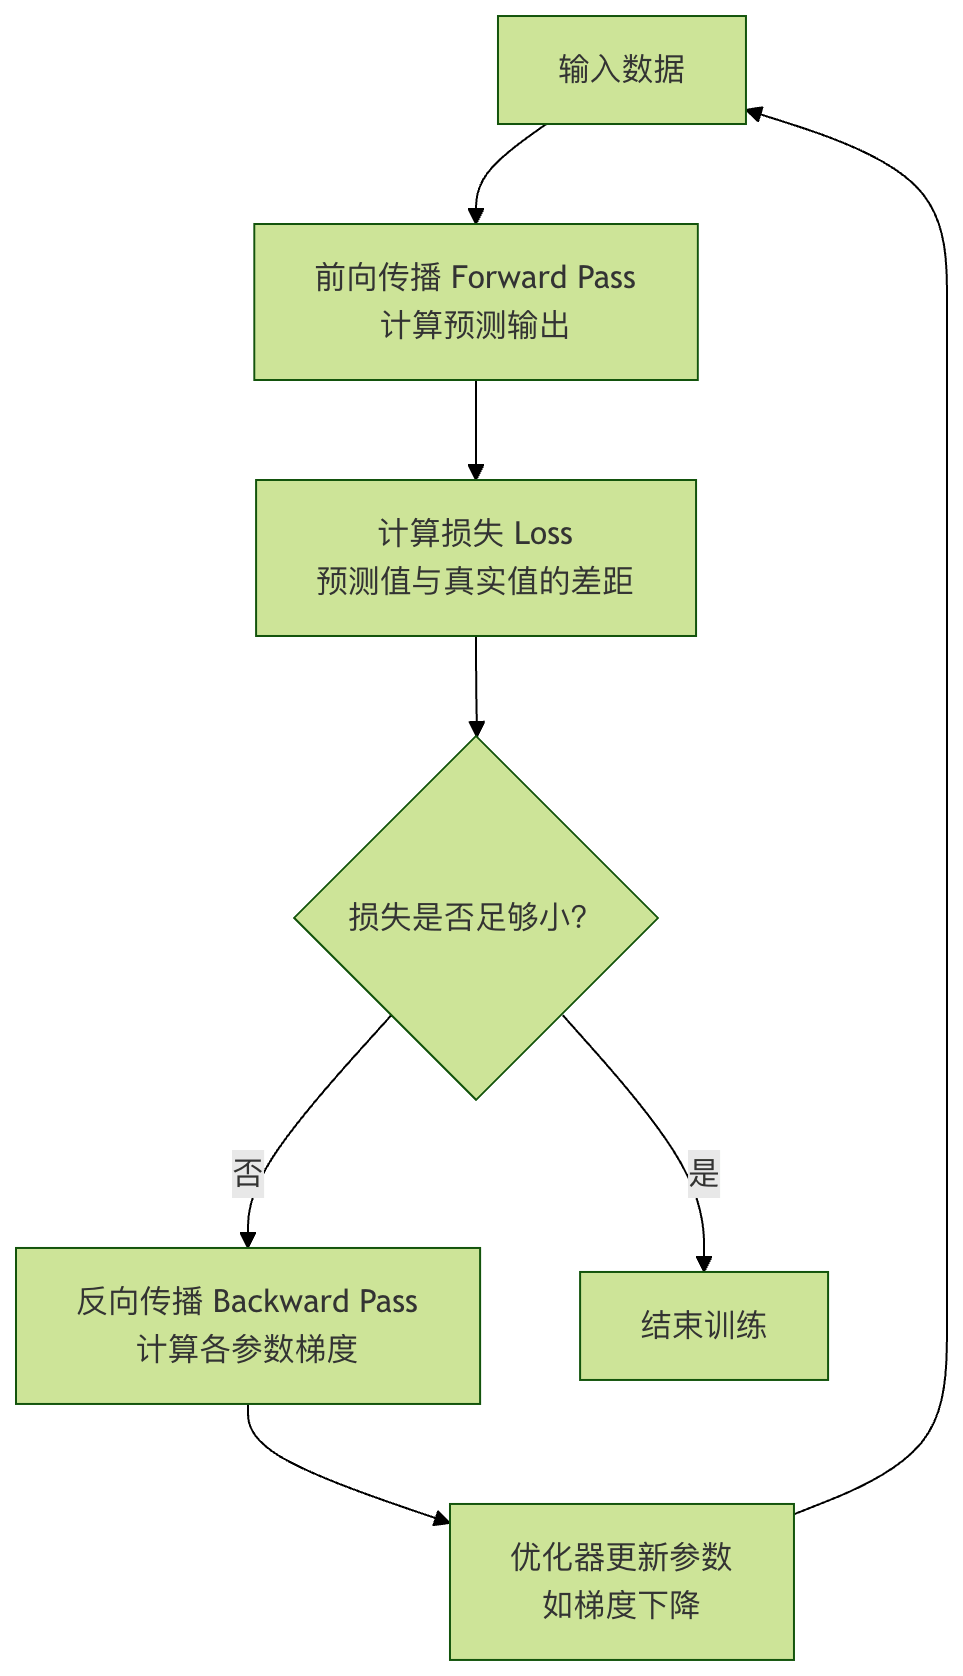
Propagation avant : le chemin d'inférence des réseaux de neurones
La propagation avant est le canal avant par lequel les réseaux de neurones effectuent des prédictions. Comprenons-la à travers un simple réseau de neurones à trois couches (couche d'entrée, une couche cachée, couche de sortie).
Concepts clés et calcul
Supposons que nous voulions prédire les prix des logements, et que l'entrée soit la superficie de la maisonx. Notre structure de réseau miniature est la suivante :
- Couche d'entrée: un neurone, recevant
x。 - Couche cachée: un neurone, avec le poids
w1et le biaisb1。 - Couche de sortie: un neurone, avec le poids
w2et le biaisb2, produisant le prix immobilier prédity_pred。
Le calcul de propagation avant est divisé en deux étapes :
1. Calcul de la couche cachée: entréexet le poidsw1, le biaisb1sont combinés, puis passés par une fonction d'activation (par ex., Sigmoid, notéeσ), produisant la sortie de la couche cachéea1。
z1 = w1 * x + b1
a1 = σ(z1) = 1 / (1 + exp(-z1))
z1est le résultat de la transformation linéaire.a1est la sortie après activation non linéaire, ce qui donne au réseau la capacité d'apprendre des motifs complexes.
2. Calcul de la couche de sortie: sortie de la couche cachéea1comme entrée, avec le poids de la couche de sortiew2, le biaisb2sont combinés pour produire la prédiction finaley_pred. Ici, par souci de simplicité, supposons que la couche de sortie n'utilise pas de fonction d'activation (c'est-à-dire une sortie linéaire).
y_pred = w2 * a1 + b2
Exemple de code : implémentation manuelle de la propagation avant
Exemple
def sigmoid(x):
"""Fonction d'activation sigmoïde"""
return 1 / (1 + np.exp(-x))
# Initialiser les paramètres du réseau (généralement une initialisation aléatoire, ici des valeurs spécifiées pour la démonstration)
w1, b1 = 2.0, -1.0 # Paramètres de la couche cachée
w2, b2 = 1.5, 0.5 # Paramètres de la couche de sortie
def forward_pass(x):
"""Effectuer une propagation avant"""
# Calcul de la couche cachée
z1 = w1 * x + b1
a1 = sigmoid(z1) # Appliquer la fonction d'activation
# Calcul de la couche de sortie
y_pred = w2 * a1 + b2 # Sortie linéaire
# Retourner les résultats intermédiaires et la prédiction finale pour une compréhension ultérieure
return {'z1': z1, 'a1': a1, 'y_pred': y_pred}
# On suppose que la superficie de la maison est de 3 (unité : 100 mètres carrés)
x_input = 3.0
result = forward_pass(x_input)
print(f"Entrée x = {x_input}")
print(f"Sortie linéaire de la couche cachée z1 = w1*x + b1 = {result['z1']:.4f}")
print(f"Sortie d'activation de la couche cachée a1 = sigmoid(z1) = {result['a1']:.4f}")
print(f"Final predicted housing price y_pred = w2*a1 + b2 = {result['y_pred']:.4f}")
Exemple de sortie :
输入 x = 3.0
隐藏层线性输出 z1 = w1*x + b1 = 5.0000
隐藏层激活输出 a1 = sigmoid(z1) = 0.9933
最终预测房价 y_pred = w2*a1 + b2 = 1.9899
Ceciy_predest le prix prédit par le réseau pour une maison d'une superficie de 3. Mais évidemment, cette valeur prédite (basée sur des paramètres que nous avons fixés à la légère) est probablement éloignée du prix réel de la maison. Comment mesurer cet écart et l'améliorer ? Cela nécessite unefonction de perteet larétropropagation à venir。
Fonction de perte : un étalon pour mesurer ce qui est bon ou mauvais
Avant que la rétropropagation ne commence, nous devons d'abord quantifier la valeur préditey_predet la valeur réelley_truel'écart entre elles. C'est le rôle de la fonction de perte.
Fonctions de perte courantes:
- Erreur quadratique moyenne: adaptée aux problèmes de régression (par ex., la prédiction des prix immobiliers, de la température).
Loss = (1/N) * Σ (y_true - y_pred)^2 - Perte d'entropie croisée: adaptée aux problèmes de classification (par ex., la classification d'images, la détection de spam).
En prenant l'erreur quadratique moyenne comme exemple, pour un échantillon unique :
Loss = (y_true - y_pred)^2
Notre objectif est d'ajusterw1, b1, w2, b2, pour rendre cetteLossvaleur aussi petite que possible.
Rétropropagation : le moteur d'apprentissage des réseaux de neurones
La rétropropagation est l'algorithme d'apprentissage central de l'apprentissage profond. Son essence estla règle de la chaîneappliquée efficacement dans les réseaux de neurones. L'objectif est de calculer la fonction de perteLpar rapport à chaque paramètre (w1, b1, w2, b2)dérivées partielles (gradients), i.e.,∂L/∂w1, ∂L/∂b1etc. Ces gradients indiquent dans quelle direction et de quelle ampleur chaque paramètre doit être ajusté pour réduire la perte.
Comprendre les gradients : direction et taille du pas pour descendre la pente
Imaginez que vous avez les yeux bandés et que vous êtes debout sur une montagne (surface de perte), et que l'objectif est de trouver le point le plus bas de la vallée (perte minimale). Avant chaque pas, vous devez utiliser vos pieds pour sentir la direction de descente la plus raide autour de vous. Cette direction de descente la plus raide estle gradient. La rétropropagation est précisément ce qui vous aide à calculer le gradient à chaque point sous vos pieds (correspondant à chaque ensemble de paramètres).
Étapes de calcul de la rétropropagation (règle de la chaîne)
Nous continuons à utiliser le réseau miniature précédent, et supposons que le vrai prix du logementy_true = 2.5, et la fonction de perte est l'erreur quadratique moyenneL = (y_true - y_pred)^2。
La rétropropagation part de la couche de sortie,en sens inverseet calcule les gradients couche par couche :
Calculer les gradients des paramètres de la couche de sortie
- Perte
Lpar rapport à la valeur préditey_predgradient :∂L/∂y_pred = -2 * (y_true - y_pred) - Parce que
y_pred = w2 * a1 + b2, donc :∂L/∂w2 = (∂L/∂y_pred) * (∂y_pred/∂w2) = (∂L/∂y_pred) * a1∂L/∂b2 = (∂L/∂y_pred) * (∂y_pred/∂b2) = (∂L/∂y_pred) * 1
Calculer les gradients des paramètres de la couche cachée
- Tout d'abord, nous avons besoin de la perte
Lpar rapport à la sortie de la couche cachéea1gradient.a1Viay_predaffecteL:∂L/∂a1 = (∂L/∂y_pred) * (∂y_pred/∂a1) = (∂L/∂y_pred) * w2 - Ensuite,
a1 = σ(z1), la dérivée de la fonction sigmoïdeσ'(z) = σ(z)*(1-σ(z))。 - Enfin, calculez
Lpar rapport aux paramètres de la couche cachéew1,b1gradients :∂L/∂w1 = (∂L/∂a1) * (∂a1/∂z1) * (∂z1/∂w1) = (∂L/∂a1) * σ'(z1) * x∂L/∂b1 = (∂L/∂a1) * (∂a1/∂z1) * (∂z1/∂b1) = (∂L/∂a1) * σ'(z1) * 1
Exemple de code : implémentation manuelle de la rétropropagation
Exemple
y_true = 2.5
y_pred = result['y_pred']
a1 = result['a1']
z1 = result['z1']
x = x_input
print(f"Valeur réelle y_true = {y_true}")
print(f"Valeur prédite y_pred = {y_pred:.4f}")
print(f"Perte initiale Loss = {(y_true - y_pred)**2:.4f}")
print("\n--- Démarrer la rétropropagation pour calculer les gradients ---")
# 1. Calculer le gradient de la perte par rapport à y_pred
dL_dy_pred = -2 * (y_true - y_pred)
print(f"Gradient ∂L/∂y_pred = -2*(y_true - y_pred) = {dL_dy_pred:.4f}")
# 2. Calculer les gradients des paramètres de la couche de sortie w2, b2
dL_dw2 = dL_dy_pred * a1
dL_db2 = dL_dy_pred * 1
print(f"Gradient ∂L/∂w2 = (∂L/∂y_pred) * a1 = {dL_dw2:.4f}")
print(f"Gradient ∂L/∂b2 = (∂L/∂y_pred) * 1 = {dL_db2:.4f}")
# 3. Calculer le gradient de la perte par rapport à la sortie de la couche cachée a1
dL_da1 = dL_dy_pred * w2
print(f"Gradient ∂L/∂a1 = (∂L/∂y_pred) * w2 = {dL_da1:.4f}")
# 4. Calculer la valeur de la dérivée de la fonction sigmoïde en z1
def sigmoid_derivative(x):
"""Dérivée de la fonction sigmoïde"""
s = sigmoid(x)
return s * (1 - s)
sigma_prime_z1 = sigmoid_derivative(z1)
print(f"Dérivée de la sigmoïde σ'(z1) = σ(z1)*(1-σ(z1)) = {sigma_prime_z1:.4f}")
# 5. Calculer les gradients des paramètres de la couche cachée w1, b1
dL_dw1 = dL_da1 * sigma_prime_z1 * x
dL_db1 = dL_da1 * sigma_prime_z1 * 1
print(f"Gradient ∂L/∂w1 = (∂L/∂a1) * σ'(z1) * x = {dL_dw1:.4f}")
print(f"Gradient ∂L/∂b1 = (∂L/∂a1) * σ'(z1) * 1 = {dL_db1:.4f}")
Exemple de sortie :
真实值 y_true = 2.5
预测值 y_pred = 1.9899
初始损失 Loss = 0.2602

--- 开始反向传播计算梯度 ---
梯度 ∂L/∂y_pred = -2*(y_true - y_pred) = -1.0202
梯度 ∂L/∂w2 = (∂L/∂y_pred) * a1 = -1.0134
梯度 ∂L/∂b2 = (∂L/∂y_pred) * 1 = -1.0202
梯度 ∂L/∂a1 = (∂L/∂y_pred) * w2 = -1.5303
Sigmoid导数 σ'(z1) = σ(z1)*(1-σ(z1)) = 0.0066
梯度 ∂L/∂w1 = (∂L/∂a1) * σ'(z1) * x = -0.0304
梯度 ∂L/∂b1 = (∂L/∂a1) * σ'(z1) * 1 = -0.0101
Maintenant, nous avons obtenu les gradients de tous les paramètres. Ces valeurs négatives signifient que si l'onaugmenteles valeurs de ces paramètres, la perte vaaugmenter(car la direction du gradient est la direction de la montée). Pour réduire la perte, nous devonsnous déplacer dans la direction opposée au gradientpour ajuster les paramètres.
Mise à jour des paramètres : descente de gradient
Après avoir obtenu les gradients, nous utilisons l'algorithme dedescente de gradientpour mettre à jour les paramètres :
parameter = parameter - learning rate * the gradient of that parameter
où,taux d'apprentissageest un hyperparamètre très important qui contrôle la taille du pas de chaque mise à jour de paramètre. Si la taille du pas est trop petite, l'apprentissage est lent ; si elle est trop grande, il peut ne pas converger ou même diverger.
Exemple de code : appliquer la descente de gradient pour mettre à jour les paramètres
Exemple
# Mettre à jour les paramètres
w1_new = w1 - learning_rate * dL_dw1
b1_new = b1 - learning_rate * dL_db1
w2_new = w2 - learning_rate * dL_dw2
b2_new = b2 - learning_rate * dL_db2
print("--- Paramètres mis à jour ---")
print(f"w1: {w1:.4f} -> {w1_new:.4f}")
print(f"b1: {b1:.4f} -> {b1_new:.4f}")
print(f"w2: {w2:.4f} -> {w2_new:.4f}")
print(f"b2: {b2:.4f} -> {b2_new:.4f}")
# Effectuer une passe avant avec les nouveaux paramètres pour vérifier si la perte a diminué
def forward_pass_with_params(x, w1, b1, w2, b2):
z1 = w1 * x + b1
a1 = sigmoid(z1)
y_pred = w2 * a1 + b2
return y_pred
y_pred_new = forward_pass_with_params(x_input, w1_new, b1_new, w2_new, b2_new)
loss_new = (y_true - y_pred_new)**2
print(f"\n"Prédiction avec les nouveaux paramètres : y_pred_new = {y_pred_new:.4f}")
print(f"Perte mise à jour : Nouvelle perte = {loss_new:.4f}")
print(f"Variation de la perte : {loss_new - (y_true-y_pred)**2:.4f} (une valeur négative signifie que la perte a diminué)")
Exemple de sortie :
--- 更新后的参数 ---
w1: 2.0000 -> 2.0030
b1: -1.0000 -> -0.9990
w2: 1.5000 -> 1.6013
b2: 0.5000 -> 0.6020

用新参数预测: y_pred_new = 2.1933
更新后的损失 New Loss = 0.0940
损失变化: -0.1662 (负值表示损失减小)
Parfait ! Après unepropagation avant -> calcul de la perte -> rétropropagation -> mise à jour par descente de gradientcycle complet, notre valeur préditey_predfrom1.99est plus proche de la valeur réelle2.5, et la perte est également passée de0.260réduite à0.094. En répétant ce cycle des milliers ou des millions de fois (sur de grandes quantités de données), le réseau de neurones peut apprendre des paramètres efficaces et faire des prédictions précises.
Exercice pratique : consolidez votre compréhension
Il est maintenant temps de passer à la pratique et de consolider ce que vous avez appris.
Exercice 1 : Étendre le réseauModifiez le code ci-dessus pour porter le nombre de neurones de la couche cachée à 2. Vous devez initialiserw1sous forme de tableau de dimensions(2,)tableau (deux poids),b1est(2,)tableau.
Exercice 2 : Changer la fonction d’activationRemplacez la fonction d’activation Sigmoid par la fonction ReLU (f(x) = max(0, x)). Vous devez redériver et implémenter la dérivée de ReLU (f'(x) = 1 if x>0 else 0). Comparez la manière dont le processus d’entraînement diffère selon les fonctions d’activation utilisées.
Exercice 3 : Implémenter une boucle d’entraînementÉcrivez une boucle d’entraînement complète pour ajuster un jeu de données simple (par exemple, construisez votre proprey = 2x + 1 + 噪声données) en entraînant un petit réseau pour l’ajuster. Définissez le nombre d’époques, affichez la perte après chaque itération et observez si la perte continue de diminuer au fil de l’entraînement.
Exercice 4 : Comprendre l’impact du taux d’apprentissageEn vous appuyant sur l’exercice 3, essayez différentslearning_rate(par ex., 0.01, 0.1, 0.5, 1.0). Observez comment la courbe de perte évolue lorsque le taux d’apprentissage est trop grand ou trop petit (s’il oscille, diverge ou converge lentement), et comprenez profondément l’importance du taux d’apprentissage en tant que pas.
Résumé
La propagation avant et la rétropropagation sont les dynamiques essentielles de l'apprentissage des réseaux de neurones :
- La propagation avantOuiest le chemin d'inférence, qui utilise les paramètres actuels pour mapper les entrées vers les sorties et calcule un score (perte) de la performance actuelle.
- La rétropropagationOuiest l'algorithme d'apprentissage, qui utilise la règle de la chaîne pour calculer efficacement le gradient de la fonction de perte par rapport à chaque paramètre du réseau, indiquant la direction pour l'optimisation des paramètres.
- La descente de gradientOuiest la stratégie d'optimisation, qui met effectivement à jour les paramètres en utilisant les gradients fournis par la rétropropagation avec le taux d'apprentissage comme taille de pas, améliorant progressivement les performances du réseau.