Прямое и обратное распространение
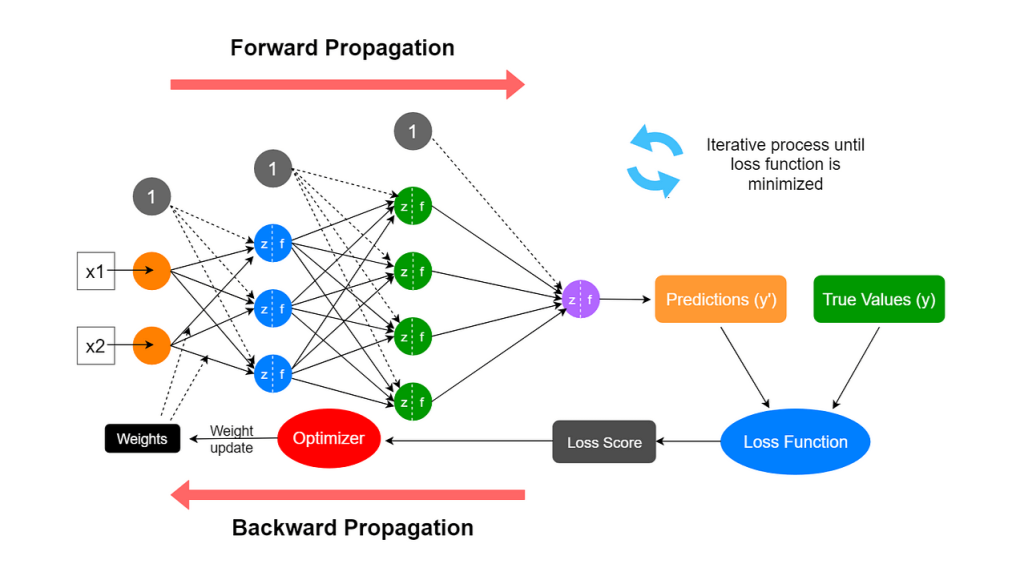
В глубоком обучении прямое распространение и обратное распространение — это два основных столпа, поддерживающих его работу. Они как две стороны одной медали и вместе образуют полный замкнутый цикл от обучения до применения в нейронных сетях. Тщательное понимание этих двух процессов — первый ключ, открывающий дверь в глубокое обучение.
Эта статья шаг за шагом проведёт вас через эти кажущиеся сложными концепции, используя ясную логику и яркие аналогии, чтобы вы не только знали, что это такое, но и понимали, почему они работают.
Что такое прямое распространение и обратное распространение?
Прежде чем углубляться в детали, давайте сначала сформируем понимание на макроуровне.
Представьте, что вы учите ребёнка распознавать кошек и собак. Вы показываете ему картинку (входные данные), и на основе знаний, уже имеющихся в его мозге (параметры сети, то есть веса и смещения), он делает вывод, а затем говорит вам, что это кошка (выход). Этот процесс: посмотреть на картинку -> обработка мозгом -> выдача ответа — этопрямое распространение。
Но суждение ребёнка может быть ошибочным. Вы говорите ему: нет, это собака. Разница между правильным ответом и ответом ребёнка — этоошибка. Ребёнку нужно поразмышлять на основе этой ошибки: какие знания (параметры) в моём мозге привели к этому неверному суждению? Как мне их скорректировать, чтобы в следующий раз распознать правильно? Этот процесс корректировки знаний от конца к началу на основе ошибки — этообратное распространение。
В нейронных сетях:
- Прямое распространение: процесс, в котором данные идут от входного слоя, проходят через скрытые слои и в конечном итоге достигают выходного слоя, выдавая результат прогноза. Это процессвывода.
- Обратное распространение: на основе ошибки между результатом прогноза, полученным при прямом распространении, и истинным значением, начиная с выходного слоя, в обратном порядке вычисляет, слой за слоем, «вклад» каждого параметра (веса и смещения) в общую ошибку (то есть градиент), и соответствующим образом обновляет параметры. Этопроцесс обучения.
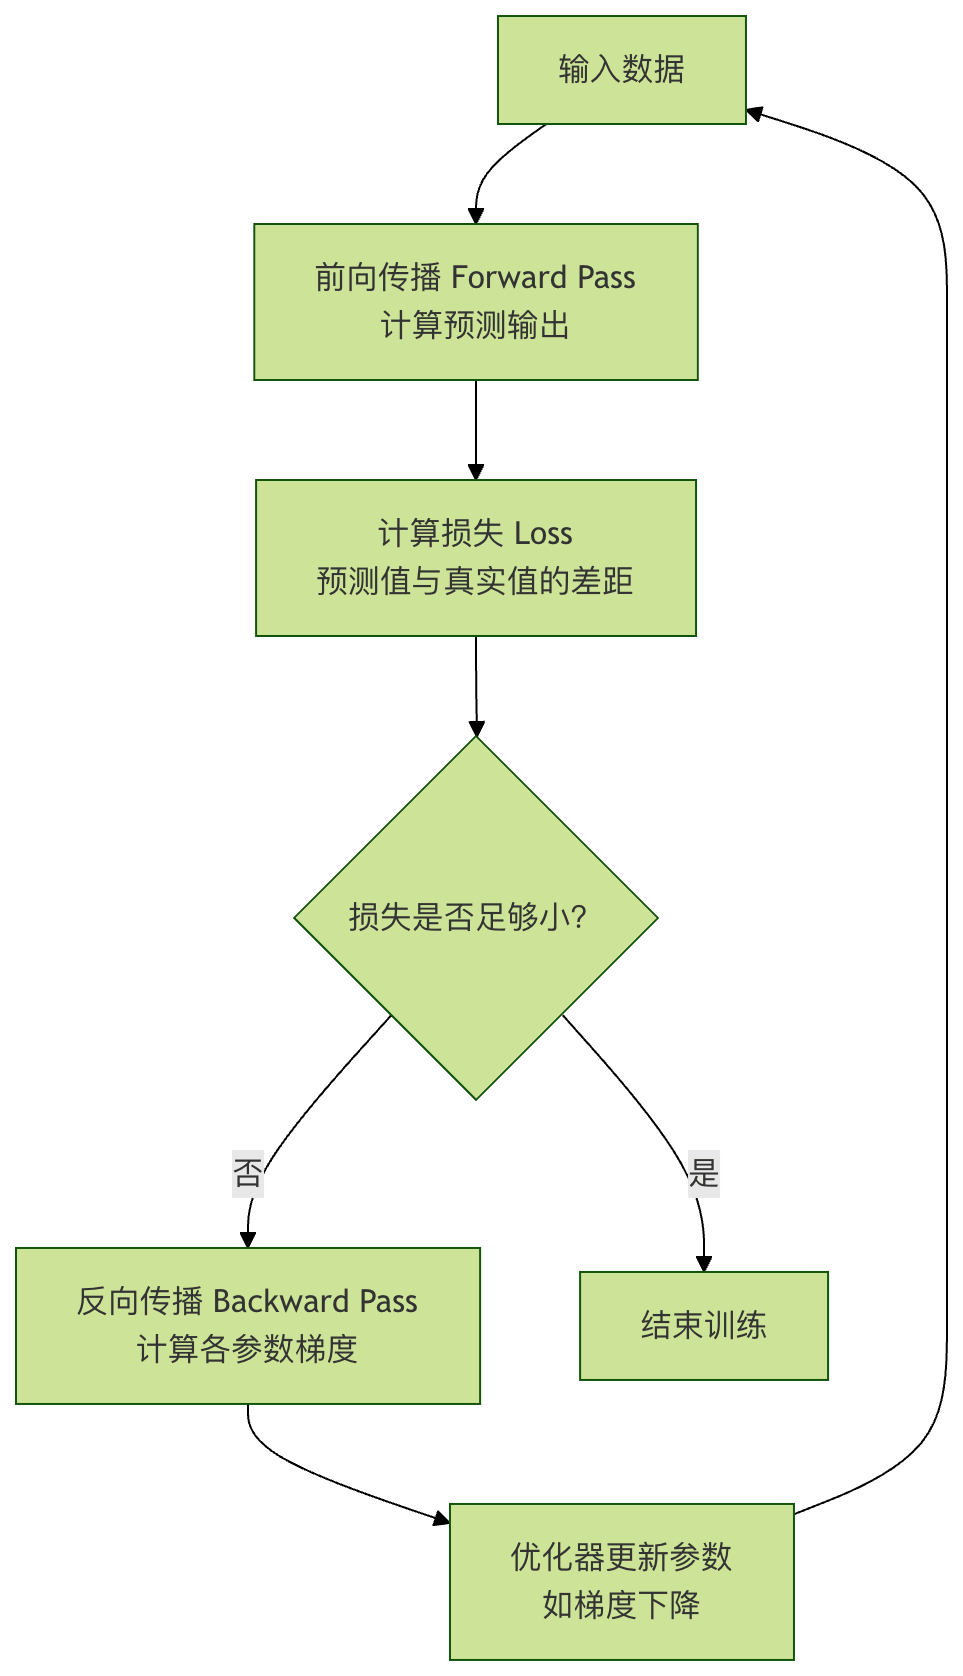
Их взаимосвязь можно представить простой схемой цикла обучения:
Прямое распространение: путь вывода нейронных сетей
Прямое распространение — это прямой канал, через который нейронные сети делают прогнозы. Давайте разберёмся на примере простой трёхслойной нейронной сети (входной слой, один скрытый слой, выходной слой).
Ключевые понятия и вычисления
Предположим, мы хотим предсказать цены на жильё, а входные данные — это площадь домаx. Структура нашей миниатюрной сети выглядит следующим образом:
- Входной слой: один нейрон, получающий
x。 - Скрытый слой: один нейрон, с весом
w1и смещениемb1。 - Выходной слой: один нейрон, с весом
w2и смещениемb2, выводящий прогнозируемую цену жильяy_pred。
Вычисление прямого распространения делится на два этапа:
1. Вычисление скрытого слоя: входxи весw1, смещениеb1объединяются, затем проходят через функцию активации (например, Sigmoid, обозначаемую какσ), формируя выход скрытого слояa1。
z1 = w1 * x + b1
a1 = σ(z1) = 1 / (1 + exp(-z1))
z1является результатом линейного преобразования.a1— это выход после нелинейной активации, что даёт сети возможность изучать сложные закономерности.
2. Вычисление выходного слоя: выход скрытого слояa1в качестве входа, с весом выходного слояw2, смещениеb2объединяются, чтобы получить окончательное предсказаниеy_pred. Здесь для простоты предположим, что выходной слой не использует функцию активации (т. е. линейный выход).
y_pred = w2 * a1 + b2
Пример кода: ручная реализация прямого распространения
Пример
def sigmoid(x):
"""Функция активации Sigmoid"""
return 1 / (1 + np.exp(-x))
# Инициализация параметров сети (обычно случайная инициализация, здесь указаны значения для демонстрации)
w1, b1 = 2.0, -1.0 # Параметры скрытого слоя
w2, b2 = 1.5, 0.5 # Параметры выходного слоя
def forward_pass(x):
"""Выполнить одно прямое распространение"""
# Вычисление скрытого слоя
z1 = w1 * x + b1
a1 = sigmoid(z1) # Применить функцию активации
# Вычисление выходного слоя
y_pred = w2 * a1 + b2 # Линейный выход
# Вернуть промежуточные результаты и итоговое предсказание для дальнейшего понимания
return {'z1': z1, 'a1': a1, 'y_pred': y_pred}
# Предположим, площадь дома равна 3 (единица измерения: 100 квадратных метров)
x_input = 3.0
result = forward_pass(x_input)
print(f"Вход x = {x_input}")
print(f"Линейный выход скрытого слоя z1 = w1*x + b1 = {result['z1']:.4f}")
print(f"Выход активации скрытого слоя a1 = sigmoid(z1) = {result['a1']:.4f}")
print(f"Final predicted housing price y_pred = w2*a1 + b2 = {result['y_pred']:.4f}")
Пример вывода:
输入 x = 3.0
隐藏层线性输出 z1 = w1*x + b1 = 5.0000
隐藏层激活输出 a1 = sigmoid(z1) = 0.9933
最终预测房价 y_pred = w2*a1 + b2 = 1.9899
Этотy_pred— это предсказанная сетью цена дома площадью 3. Но, очевидно, это предсказанное значение (основанное на параметрах, которые мы задали произвольно) вероятно далеко от реальной цены дома. Как измерить этот разрыв и улучшить его? Для этого требуетсяфункция потерьи предстоящееобратное распространение。
Функция потерь: мерило для оценки хорошего или плохого
Прежде чем начнётся обратное распространение, мы должны сначала количественно оценить предсказанное значениеy_predи истинное значениеy_trueразрыв между ними. В этом и заключается роль функции потерь.
Распространённые функции потерь:
- Среднеквадратичная ошибка: подходит для задач регрессии (например, предсказание цен на жильё, температуры).
Loss = (1/N) * Σ (y_true - y_pred)^2 - Кросс-энтропийная потеря: подходит для задач классификации (например, классификация изображений, обнаружение спама).
Взяв в качестве примера среднеквадратичную ошибку, для одного образца:
Loss = (y_true - y_pred)^2
Наша цель — настроитьw1, b1, w2, b2, чтобы сделать этоLossзначение как можно меньше.
Обратное распространение: движок обучения нейронных сетей
Обратное распространение — это основной алгоритм обучения в глубоком обучении. Его суть —правило цепочки, эффективно применяемое в нейронных сетях. Цель — вычислить функцию потерьLотносительно каждого параметра (w1, b1, w2, b2)частные производные (градиенты), i.e.,∂L/∂w1, ∂L/∂b1и т. д. Эти градиенты указывают, в каком направлении и на какую величину следует скорректировать каждый параметр, чтобы уменьшить потери.
Понимание градиентов: направление и величина шага при спуске
Представьте, что у вас завязаны глаза и вы стоите на горе (поверхность потерь), а цель — найти самую низкую точку долины (минимум потерь). Перед каждым шагом вам нужно ногами почувствовать самое крутое направление спуска вокруг вас. Это самое крутое направление спуска —градиент. Обратное распространение как раз и помогает вычислить градиент в каждой точке под вашими ногами (соответствующей каждому набору параметров).
Шаги вычисления обратного распространения (правило цепочки)
Мы продолжаем использовать предыдущую миниатюрную сеть и предполагаем, что истинная цена жильяy_true = 2.5, и функция потерь — среднеквадратичная ошибкаL = (y_true - y_pred)^2。
Обратное распространение начинается с выходного слоя,в обратном направлениии вычисляет градиенты слой за слоем:
Вычислите градиенты параметров выходного слоя
- Потери
Lпо предсказанному значениюy_predградиент:∂L/∂y_pred = -2 * (y_true - y_pred) - Потому что
y_pred = w2 * a1 + b2, следовательно:∂L/∂w2 = (∂L/∂y_pred) * (∂y_pred/∂w2) = (∂L/∂y_pred) * a1∂L/∂b2 = (∂L/∂y_pred) * (∂y_pred/∂b2) = (∂L/∂y_pred) * 1
Вычислите градиенты параметров скрытого слоя
- Сначала нам нужны потери
Lпо выходу скрытого слояa1градиент.a1Черезy_predвлияетL:∂L/∂a1 = (∂L/∂y_pred) * (∂y_pred/∂a1) = (∂L/∂y_pred) * w2 - Затем,
a1 = σ(z1), производная сигмоидной функцииσ'(z) = σ(z)*(1-σ(z))。 - Наконец, вычислите
Lотносительно параметров скрытого слояw1,b1градиенты:∂L/∂w1 = (∂L/∂a1) * (∂a1/∂z1) * (∂z1/∂w1) = (∂L/∂a1) * σ'(z1) * x∂L/∂b1 = (∂L/∂a1) * (∂a1/∂z1) * (∂z1/∂b1) = (∂L/∂a1) * σ'(z1) * 1
Пример кода: ручная реализация обратного распространения
Пример
y_true = 2.5
y_pred = result['y_pred']
a1 = result['a1']
z1 = result['z1']
x = x_input
print(f"Истинное значение y_true = {y_true}")
print(f"Предсказанное значение y_pred = {y_pred:.4f}")
print(f"Начальные потери Loss = {(y_true - y_pred)**2:.4f}")
print("\n--- Начало обратного распространения для вычисления градиентов ---")
# 1. Вычислить градиент функции потерь по отношению к y_pred
dL_dy_pred = -2 * (y_true - y_pred)
print(f"Градиент ∂L/∂y_pred = -2*(y_true - y_pred) = {dL_dy_pred:.4f}")
# 2. Вычислить градиенты параметров выходного слоя w2, b2
dL_dw2 = dL_dy_pred * a1
dL_db2 = dL_dy_pred * 1
print(f"Градиент ∂L/∂w2 = (∂L/∂y_pred) * a1 = {dL_dw2:.4f}")
print(f"Градиент ∂L/∂b2 = (∂L/∂y_pred) * 1 = {dL_db2:.4f}")
# 3. Вычислить градиент функции потерь по отношению к выходу скрытого слоя a1
dL_da1 = dL_dy_pred * w2
print(f"Градиент ∂L/∂a1 = (∂L/∂y_pred) * w2 = {dL_da1:.4f}")
# 4. Вычислить значение производной сигмоидной функции в точке z1
def sigmoid_derivative(x):
"""Производная сигмоидной функции"""
s = sigmoid(x)
return s * (1 - s)
sigma_prime_z1 = sigmoid_derivative(z1)
print(f"Производная сигмоиды σ'(z1) = σ(z1)*(1-σ(z1)) = {sigma_prime_z1:.4f}")
# 5. Вычисление градиентов параметров скрытого слоя w1, b1
dL_dw1 = dL_da1 * sigma_prime_z1 * x
dL_db1 = dL_da1 * sigma_prime_z1 * 1
print(f"Градиент ∂L/∂w1 = (∂L/∂a1) * σ'(z1) * x = {dL_dw1:.4f}")
print(f"Градиент ∂L/∂b1 = (∂L/∂a1) * σ'(z1) * 1 = {dL_db1:.4f}")
Пример вывода:
真实值 y_true = 2.5
预测值 y_pred = 1.9899
初始损失 Loss = 0.2602

--- 开始反向传播计算梯度 ---
梯度 ∂L/∂y_pred = -2*(y_true - y_pred) = -1.0202
梯度 ∂L/∂w2 = (∂L/∂y_pred) * a1 = -1.0134
梯度 ∂L/∂b2 = (∂L/∂y_pred) * 1 = -1.0202
梯度 ∂L/∂a1 = (∂L/∂y_pred) * w2 = -1.5303
Sigmoid导数 σ'(z1) = σ(z1)*(1-σ(z1)) = 0.0066
梯度 ∂L/∂w1 = (∂L/∂a1) * σ'(z1) * x = -0.0304
梯度 ∂L/∂b1 = (∂L/∂a1) * σ'(z1) * 1 = -0.0101
Теперь мы получили градиенты всех параметров. Эти отрицательные значения означают, что еслиувеличитьзначения этих параметров, потери будутувеличиваться(потому что направление градиента — это направление возрастания). Чтобы уменьшить потери, нам следуетдвигаться в направлении, противоположном градиенту, чтобы скорректировать параметры.
Обновление параметров: градиентный спуск
После получения градиентов мы используемградиентный спускв качестве алгоритма для обновления параметров:
parameter = parameter - learning rate * the gradient of that parameter
где,скорость обучения— очень важный гиперпараметр, который управляет размером шага при каждом обновлении параметра. Если размер шага слишком мал, обучение идет медленно; если слишком велик, обучение может не сойтись или даже разойтись.
Пример кода: применение градиентного спуска для обновления параметров
Пример
# Обновить параметры
w1_new = w1 - learning_rate * dL_dw1
b1_new = b1 - learning_rate * dL_db1
w2_new = w2 - learning_rate * dL_dw2
b2_new = b2 - learning_rate * dL_db2
print("--- Обновленные параметры ---")
print(f"w1: {w1:.4f} -> {w1_new:.4f}")
print(f"b1: {b1:.4f} -> {b1_new:.4f}")
print(f"w2: {w2:.4f} -> {w2_new:.4f}")
print(f"b2: {b2:.4f} -> {b2_new:.4f}")
# Выполнить прямой проход с новыми параметрами, чтобы проверить, уменьшилась ли потеря
def forward_pass_with_params(x, w1, b1, w2, b2):
z1 = w1 * x + b1
a1 = sigmoid(z1)
y_pred = w2 * a1 + b2
return y_pred
y_pred_new = forward_pass_with_params(x_input, w1_new, b1_new, w2_new, b2_new)
loss_new = (y_true - y_pred_new)**2
print(f"\n"Предсказание с новыми параметрами: y_pred_new = {y_pred_new:.4f}")
print(f"Обновлённые потери New Loss = {loss_new:.4f}")
print(f"Изменение потерь: {loss_new - (y_true-y_pred)**2:.4f} (отрицательное значение означает, что потери уменьшились)")
Пример вывода:
--- 更新后的参数 ---
w1: 2.0000 -> 2.0030
b1: -1.0000 -> -0.9990
w2: 1.5000 -> 1.6013
b2: 0.5000 -> 0.6020

用新参数预测: y_pred_new = 2.1933
更新后的损失 New Loss = 0.0940
损失变化: -0.1662 (负值表示损失减小)
Отлично! Послепрямого распространения -> вычисления потерь -> обратного распространения -> обновления градиентным спускомполного цикла, наше предсказанное значениеy_predfrom1.99ближе к истинному значению2.5, а потери также снизились с0.260снизилась до0.094. Повторяя этот цикл тысячи или миллионы раз (на больших объёмах данных), нейронная сеть может выучить эффективные параметры и делать точные предсказания.
Практическое упражнение: закрепите понимание
Теперь пришло время перейти к практике и закрепить то, что вы узнали.
Упражнение 1: Расширьте сетьИзмените код выше, чтобы увеличить число нейронов скрытого слоя до 2. Вам нужно инициализироватьw1как массив формы(2,)массив (два веса),b1является(2,)массива.
Упражнение 2: Измените функцию активацииЗамените функцию активации Sigmoid на функцию ReLU (f(x) = max(0, x)). Вам нужно заново вывести и реализовать производную ReLU (f'(x) = 1 if x>0 else 0). Сравните, как отличается процесс обучения при использовании разных функций активации.
Упражнение 3: Реализуйте цикл обученияНапишите полный цикл обучения, чтобы обучить простой набор данных (например, создайте собственныеy = 2x + 1 + 噪声данные), обучив крошечную сеть подгонке под них. Задайте количество эпох, выводите значение функции потерь после каждой итерации и наблюдайте, продолжает ли функция потерь уменьшаться по мере обучения.
Упражнение 4: Поймите влияние скорости обученияНа основе упражнения 3 попробуйте разныеlearning_rate(например, 0.01, 0.1, 0.5, 1.0). Наблюдайте, как меняется кривая функции потерь, когда скорость обучения слишком велика или слишком мала (колеблется ли она, расходится или медленно сходится), и глубоко поймите важность скорости обучения как размера шага.
Итог
Прямое распространение и обратное распространение — это основная динамика обучения нейронной сети:
- Прямое распространениеДа— это путь вывода, который использует текущие параметры для отображения входов в выходы и вычисляет оценку (потерю) текущей производительности.
- Обратное распространениеДа— это алгоритм обучения, который использует правило цепочки для эффективного вычисления градиента функции потерь по каждому параметру в сети, указывая направление для оптимизации параметров.
- Градиентный спускДа— это стратегия оптимизации, которая фактически обновляет параметры, используя градиенты, предоставленные обратным распространением, с скоростью обучения в качестве размера шага, постепенно улучшая производительность сети.