Régression linéaire
La régression linéaire est l'un des algorithmes les plus fondamentaux et les plus utilisés en apprentissage automatique.
La régression linéaire est l'algorithme d'apprentissage automatique le plus basique pour prédire des valeurs continues ; il suppose que la variable cibleyet les variables caractéristiquesxont une relation linéaire, et tente de trouver une droite d'ajustement optimale pour décrire cette relation.
y = w * x + b
Où :
yest la valeur préditexest la variable caractéristiquewest le poids (pente)best le biais (ordonnée à l'origine)
L'objectif de la régression linéaire est de trouver les paramètres optimauxwetb, afin que la valeur préditeyait l'erreur minimale par rapport à la valeur réelle. La fonction d'erreur couramment utilisée est l'erreur quadratique moyenne (MSE) :
MSE = 1/n * Σ(y_i - y_pred_i)^2
Où :
- y_i est la valeur réelle.
- y_pred_i est la valeur prédite.
- n est le nombre de points de données.
Notre objectif est de minimiser MSE en ajustant w et b.
Comment résoudre la régression linéaire ?
1. Méthode des moindres carrés
La méthode des moindres carrés est une approche courante pour résoudre la régression linéaire ; elle trouve les valeurs optimales de (w) et (b) en résolvant les équations suivantes.
L'objectif de la méthode des moindres carrés est de minimiser la somme des carrés des résidus (RSS), avec la formule :
\[ \text{RSS} = \sum_{i=1}^n (y_i - \hat{y}_i)^2 \]
Où :
\( y_i \)est la valeur réelle.\( \hat{y}_i \)est la valeur prédite, qui est\( \hat{y}_i = w x_i + b \)calculée par le modèle de régression linéaire.
En minimisant RSS, on peut obtenir les équations normales suivantes :
\[ \begin{cases} w \sum_{i=1}^n x_i^2 + b \sum_{i=1}^n x_i = \sum_{i=1}^n x_i y_i \\ w \sum_{i=1}^n x_i + b n = \sum_{i=1}^n y_i \end{cases} \]
Forme matricielle
Écrire les équations normales sous forme matricielle :
\[ \begin{bmatrix} \sum_{i=1}^n x_i^2 & \sum_{i=1}^n x_i \\ \sum_{i=1}^n x_i & n \end{bmatrix} \begin{bmatrix} w \\ b \end{bmatrix} = \begin{bmatrix} \sum_{i=1}^n x_i y_i \\ \sum_{i=1}^n y_i \end{bmatrix} \]
Méthode de résolution
En résolvant l'équation matricielle ci-dessus, on peut obtenir la solution optimale.\( w \)et\( b \):
\[ \begin{bmatrix} w \\ b \end{bmatrix} = \begin{bmatrix} \sum_{i=1}^n x_i^2 & \sum_{i=1}^n x_i \\ \sum_{i=1}^n x_i & n \end{bmatrix}^{-1} \begin{bmatrix} \sum_{i=1}^n x_i y_i \\ \sum_{i=1}^n y_i \end{bmatrix} \]
2. Descente de gradient
L'objectif de la descente de gradient est de minimiser la fonction de perte\( J(w, b) \) . Pour les problèmes de régression linéaire, l'erreur quadratique moyenne (MSE) est généralement utilisée comme fonction de perte :
\[ J(w, b) = \frac{1}{2m} \sum_{i=1}^m (y_i - \hat{y}_i)^2 \]
Où :
\( m \)est le nombre d'échantillons.\( y_i \)est la valeur réelle.\( \hat{y}_i \)est la valeur prédite, qui est\( \hat{y}_i = w x_i + b \)calculée par le modèle de régression linéaire.
Le gradient est la dérivée partielle de la fonction de perte par rapport aux paramètres, indiquant la direction de variation de la fonction de perte dans l'espace des paramètres. Pour la régression linéaire, le gradient est calculé comme suit :
\[ \frac{\partial J}{\partial w} = -\frac{1}{m} \sum_{i=1}^m x_i (y_i - \hat{y}_i) \]
\[ \frac{\partial J}{\partial b} = -\frac{1}{m} \sum_{i=1}^m (y_i - \hat{y}_i) \]
Règles de mise à jour des paramètres
La descente de gradient met à jour les paramètres à l'aide des règles suivantes :\( w \)et\( b \):
\[ w := w - \alpha \frac{\partial J}{\partial w} \]
\[ b := b - \alpha \frac{\partial J}{\partial b} \]
Où :
\( \alpha \)est le taux d'apprentissage, qui contrôle la taille du pas de chaque mise à jour.
Étapes de la descente de gradient
- Initialiser les paramètres: initialiser
\( w \)et\( b \)les valeurs (généralement définies à 0 ou à des valeurs aléatoires). - Calculer la fonction de perte: calculer la valeur de la fonction de perte sous les paramètres actuels
\( J(w, b) \)。 - Calculer le gradient: calculer la dérivée partielle de la fonction de perte par rapport à
\( w \)et\( b \)les paramètres. - Mettre à jour les paramètres: mettre à jour selon le gradient
\( w \)et\( b \)。 - Répéter l'itération: répéter les étapes 2 à 4 jusqu'à ce que la fonction de perte converge ou que le nombre maximal d'itérations soit atteint.
Implémentation de la régression linéaire avec Python
Ci-dessous, nous utilisons un exemple simple pour démontrer comment implémenter la régression linéaire avec Python.
1. Importer les bibliothèques nécessaires
Exemple
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
2. Générer des données simulées
Exemple
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
# Générer des données aléatoires
np.random.seed(0)
x = 2 * np.random.rand(100, 1)
y = 4 + 3 * x + np.random.randn(100, 1)
# Visualiser les données
plt.scatter(x, y)
plt.xlabel('x')
plt.ylabel('y')
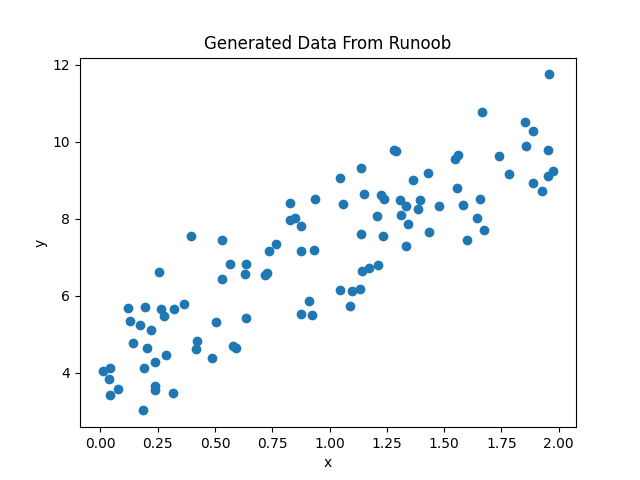
plt.title('Données générées à partir de cet exemple')
plt.show()
L'affichage est le suivant :
3. Utilisation de Scikit-learn pour la régression linéaire
Exemple
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
# Générer des données aléatoires
np.random.seed(0)
x = 2 * np.random.rand(100, 1)
y = 4 + 3 * x + np.random.randn(100, 1)
# Créer un modèle de régression linéaire
model = LinearRegression()
# Ajuster le modèle
model.fit(x, y)
# Afficher les paramètres du modèle
print(f"Pente (w): {model.coef_)
print(f"Ordonnée à l'origine (b): {model.intercept_)
# Prédire
y_pred = model.predict(x)
# Visualiser le résultat de l'ajustement
plt.scatter(x, y)
plt.plot(x, y_pred, color='red')
plt.xlabel('x')
plt.ylabel('y')
plt.title('Ajustement de la régression linéaire')
plt.show()
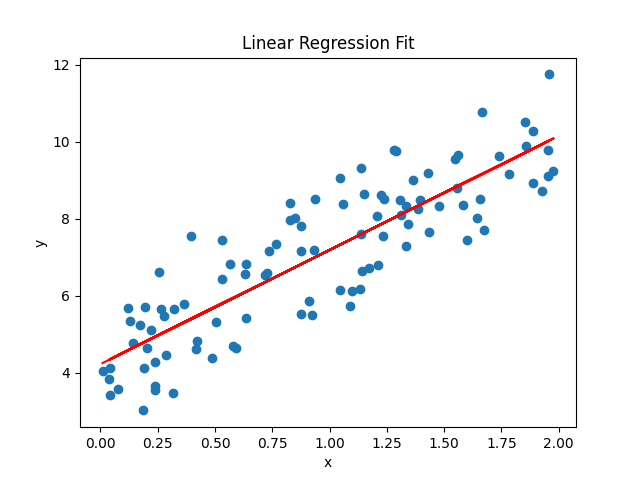
Résultat de sortie :
斜率 (w): 2.968467510701019
截距 (b): 4.222151077447231
L'affichage est le suivant :
Nous pouvons utiliser lascore()méthode pour évaluer la performance du modèle, renvoyant la valeur R^2.
Exemple
from sklearn.linear_model import LinearRegression
# Générer des données aléatoires
np.random.seed(0)
x = 2 * np.random.rand(100, 1)
y = 4 + 3 * x + np.random.randn(100, 1)
# Créer un modèle de régression linéaire
model = LinearRegression()
# Ajuster le modèle
model.fit(x, y)
# Calculer le score du modèle
score = model.score(x, y)
print("Score du modèle :", score)
Le résultat de sortie est:
模型得分: 0.7469629925504755
4. Implémentation manuelle de la descente de gradient
Exemple
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
# Générer des données aléatoires
np.random.seed(0)
x = 2 * np.random.rand(100, 1)
y = 4 + 3 * x + np.random.randn(100, 1)
# Initialiser les paramètres
w = 0
b = 0
learning_rate = 0.1
n_iterations = 1000
# Descente de gradient
for i in range(n_iterations):
y_pred = w * x + b
dw = -(2/len(x)) * np.sum(x * (y - y_pred))
db = -(2/len(x)) * np.sum(y - y_pred)
w = w - learning_rate * dw
b = b - learning_rate * db
# Afficher les paramètres finaux
print(f"Pente implémentée manuellement (w) : {w}")
print(f"Ordonnée à l'origine implémentée manuellement (b) : {b}")
# Visualiser le résultat de l'ajustement implémenté manuellement
y_pred_manual = w * x + b
plt.scatter(x, y)
plt.plot(x, y_pred_manual, color='green')
plt.xlabel('x')
plt.ylabel('y')
plt.title('Ajustement manuel par descente de gradient')
plt.show()
Résultat de sortie :
手动实现的斜率 (w): 2.968467510701028
手动实现的截距 (b): 4.222151077447219
L'affichage est le suivant :
