Machine Learning - Parcours d'apprentissage
L'apprentissage automatique est l'un des domaines techniques les plus en vue aujourd'hui ; il permet aux ordinateurs d'apprendre à partir de données et de faire des prédictions ou de prendre des décisions.
Pour les débutants, face à un vaste éventail d'algorithmes, de théories mathématiques et d'outils de programmation, il est facile de se sentir perdu et de ne pas savoir par où commencer.
Cet article présentera une feuille de route d'apprentissage automatique, depuis les bases jusqu'à la compétence pratique.
| Apprentissage automatique - Liste des cours | |
|---|---|
| Introduction de base | |
| Introduction de base | Tutoriel d'apprentissage automatique |
| Introduction de base | Introduction à l'apprentissage automatique |
| Introduction de base | Cycle de vie de l'apprentissage automatique |
| Introduction de base | Comment fonctionne l'apprentissage automatique |
| Introduction de base | Terminologie de base de l'apprentissage automatique |
| Introduction de base | Introduction à l'apprentissage automatique avec Python |
| Introduction de base | Bibliothèques Python d'apprentissage automatique |
| Introduction de base | Types de données courants |
| Introduction de base | Applications de l'apprentissage automatique |
| Traitement des données et statistiques | |
| Traitement des données et statistiques | Compréhension des données |
| Traitement des données et statistiques | Nettoyage des données |
| Traitement des données et statistiques | Ingénierie des fonctionnalités |
| Traitement des données et statistiques | Visualisation de données |
| Traitement des données et statistiques | Division entraînement-test |
| Traitement des données et statistiques | Fondamentaux des statistiques |
| Traitement des données et statistiques | Raisonnement probabiliste |
| Traitement des données et statistiques | Fonctions de perte et gradients |
| Traitement des données et statistiques | Surapprentissage, sous-apprentissage, biais et variance |
| Apprentissage supervisé | |
| Apprentissage supervisé | Algorithmes d'apprentissage automatique |
| Apprentissage supervisé | Régression linéaire |
| Apprentissage supervisé | Régression linéaire multiple |
| Apprentissage supervisé | Régression polynomiale |
| Apprentissage supervisé | Régression logistique |
| Apprentissage supervisé | Évaluation du modèle de régression |
| Apprentissage supervisé | Arbre de décision |
| Apprentissage supervisé | Machine à vecteurs de support (SVM) |
| Apprentissage supervisé | K plus proches voisins (KNN) |
| Apprentissage supervisé | Apprentissage ensembliste |
| Apprentissage supervisé | Bayes naïf |
| Apprentissage supervisé | Forêt aléatoire |
| Apprentissage supervisé | Métriques de classification |
| Apprentissage non supervisé | |
| Apprentissage non supervisé | Clustering |
| Apprentissage non supervisé | Réduction de dimensionnalité |
| Apprentissage par renforcement | |
| Apprentissage par renforcement | Cadre de base de l'apprentissage par renforcement |
| Apprentissage par renforcement | Apprentissage par renforcement : Exploration vs. Exploitation |
| Apprentissage par renforcement | Apprentissage par renforcement : Q-Learning et SARSA |
| Apprentissage par renforcement | Apprentissage par renforcement profond |
| Apprentissage profond | |
| Apprentissage profond | Structure de base des réseaux de neurones |
| Apprentissage profond | Propagation avant et rétropropagation |
| Apprentissage profond | Apprentissage profond vs. Apprentissage automatique traditionnel |
| Apprentissage profond | Types de réseaux courants |
| Optimisation et ingénierie des modèles | |
| Optimisation et ingénierie des modèles | Validation croisée |
| Optimisation et ingénierie des modèles | Régularisation |
| Optimisation et ingénierie des modèles | Fuite de données |
| Optimisation et ingénierie des modèles | Méthodes d'ensemble |
| Optimisation et ingénierie des modèles | Recherche d'hyperparamètres |
| Optimisation et ingénierie des modèles | Concepts MLOps |
| Optimisation et ingénierie des modèles | Dépannage courant |
| Limites et frontières de l'apprentissage automatique | |
| Limites et frontières de l'apprentissage automatique | Problèmes d'interprétabilité |
| Limites et frontières de l'apprentissage automatique | Limites des hypothèses |
| Limites et frontières de l'apprentissage automatique | Biais des données |
| Limites et frontières de l'apprentissage automatique | Coût réel des modèles |
| Cas pratiques | |
| Cas pratiques | Prédiction de survie sur le Titanic |
| Cas pratiques | Prédiction des prix immobiliers |
| Cas pratiques | Segmentation de la clientèle |
| Cas pratiques | Visualisation ACP |
| Cas pratiques | Exemple d'apprentissage par renforcement |
Phase 1 : Fondations - Bâtir une base solide
Avant de plonger dans des algorithmes complexes, vous devez d'abord poser les fondations qui soutiennent l'édifice de la connaissance. L'objectif de cette phase est de maîtriser les compétences nécessaires en mathématiques, en programmation et en analyse de données.
Compétence clé 1 : Langage de programmation (Python)
Python est la lingua franca de l'apprentissage automatique, apprécié pour sa syntaxe épurée et son riche écosystème de bibliothèques.
Objectifs d'apprentissage: Maîtriser la syntaxe de base de Python, les structures de données, les fonctions et la programmation orientée objet.
Bibliothèques clés:
NumPy: Utilisé pour le calcul numérique efficace ; c'est la base de presque toutes les bibliothèques de calcul scientifique.Pandas: Utilisé pour le nettoyage, l'analyse et le traitement des données ; un outil puissant pour manipuler des tableaux de données (DataFrames).Matplotlib/Seaborn: Utilisé pour la visualisation de données afin de convertir les données en graphiques intuitifs.
Ensuite, nous pouvons regarder un exemple.
Contenu du fichier de données de test house_prices.csv :
面积,价格,房龄,卧室数,城市
45,120,15,1,北京
60,180,12,2,北京
75,260,8,2,北京
90,320,6,3,北京
110,420,5,3,北京
130,520,3,4,北京
50,80,20,1,成都
70,120,15,2,成都
85,150,12,3,成都
100,190,10,3,成都
120,240,8,4,成都
140,300,5,4,成都
55,150,18,1,上海
70,220,14,2,上海
85,300,10,2,上海
100,380,8,3,上海
120,480,6,3,上海
150,650,4,4,上海
40,60,22,1,武汉
65,95,16,2,武汉
80,130,12,2,武汉
95,170,9,3,武汉
115,220,7,3,武汉
135,280,5,4,武汉
Exemple
import pandas as pd
import matplotlib.pyplot as plt
# -------------------------- Début de configuration de la police chinoise --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows en premier
'SimHei', 'Microsoft YaHei',
# macOS en premier
'PingFang SC', 'Heiti TC',
# Linux d'abord
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corriger le problème d'affichage des signes négatifs sous forme de carrés
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de la configuration de la police chinoise --------------------------
# 1. Lire les données
data = pd.read_csv('house_prices.csv')
print("Les 5 premières lignes des données :")
print(data.head())
# 2. Afficher les informations de base sur les données
print("\nInformations sur les données:")
print(data.info())
# 3. Tracer un nuage de points de la surface et du prix de la maison
plt.figure(figsize=(10, 6))
plt.scatter(data['Area'], data['Price'], alpha=0.5)
plt.title('Surface de la maison vs prix')
plt.xlabel('Superficie (mètres carrés)')
plt.ylabel('Prix (10,000 yuan)')
plt.grid(True)
plt.show()
"Après l'exécution, le graphique de sortie est le suivant :"

Compétence clé 2 : Connaissances mathématiques essentielles
Vous n'avez pas besoin de devenir mathématicien, mais vous devez comprendre la logique de base qui sous-tend les algorithmes.
- Algèbre linéaire: Comprendre les vecteurs, les matrices et la multiplication matricielle. C'est la base pour comprendre comment les données sont représentées et transformées dans un espace multidimensionnel.
- Calcul différentiel et intégral: L'accent est mis sur la compréhension des concepts de dérivées et de dérivées partielles. Ils sont au cœur des algorithmes d'optimisation (tels que la descente de gradient) utilisés pour trouver les meilleurs paramètres d'un modèle.
- Probabilités et statistiques: Comprendre la moyenne, la variance, l'écart type, les distributions de probabilité, la probabilité conditionnelle et le théorème de Bayes. C'est crucial pour évaluer les modèles et comprendre l'incertitude.
Analogie: Imaginez un modèle d'apprentissage automatique comme uneconsole de mixagecomplexe. Les connaissances mathématiques sont le manuel qui vous aide à comprendre comment chaque bouton (paramètre) affecte le son final (résultat de prédiction). Sans le manuel, vous ne pouvez que tâtonner à l'aveugle.
Phase 2 : Premiers pas - Maîtriser les algorithmes classiques
Avec des bases solides, vous pouvez commencer à explorer le cœur de l'apprentissage automatique — les algorithmes. Il est recommandé de commencer par les algorithmes les plus classiques et intuitifs.
Introduction à l'apprentissage supervisé
L'apprentissage supervisé consiste à entraîner des modèles à l'aide de données disposant d'étiquettes existantes.
- Régression linéaire: Prédire des valeurs continues (par ex., prix des maisons). Comprendre sa fonction de coût et le processus d'optimisation par descente de gradient.
- Régression logistique: Résout des problèmes de classification (par ex., déterminer si un e-mail est un spam). Comprendre la fonction sigmoïde et la frontière de décision.
- K plus proches voisins (K-NN): Un algorithme simple de classification/régression basé sur les instances.
- Arbre de décision: Simule le processus de prise de décision humaine, très intuitif et facile à comprendre.
Introduction à l'apprentissage non supervisé
L'apprentissage non supervisé sert à découvrir des structures et des motifs intrinsèques dans les données.
- Regroupement K-Means: Regroupe automatiquement les données en K clusters.
- Analyse en composantes principales (ACP): Utilisée pour la réduction de dimensionnalité et la visualisation, en extrayant les caractéristiques les plus importantes.
Mise à niveau des outils: À ce stade, commencez à utiliser systématiquementscikit-learnla bibliothèque. Elle fournit une API unifiée, vous permettant d'implémenter, comparer et évaluer rapidement divers algorithmes.
Exemple
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, classification_report
# =========================
# 1. Construire des données de test exécutables
# Scénario : si vous réussissez l'examen (1=réussite, 0=échec)
# Caractéristiques : temps d'étude, taux de présence, taux d'achèvement des devoirs
# =========================
X = np.array([
[2, 60, 50],
[3, 65, 55],
[4, 70, 65],
[5, 75, 70],
[6, 80, 75],
[7, 85, 80],
[8, 90, 85],
[9, 92, 88],
[10, 95, 90],
[11, 97, 92],
[1, 50, 40],
[2, 55, 45],
[3, 60, 50],
[4, 65, 55],
[5, 70, 60],
[6, 75, 65],
[7, 80, 70],
[8, 85, 75],
[9, 90, 80],
[10, 95, 85]
])
y = np.array([
0, 0, 0, 0, 1,
1, 1, 1, 1, 1,
0, 0, 0, 0, 0,
1, 1, 1, 1, 1
])
# =========================
# 2. Diviser les données en ensembles d'entraînement et de test
# =========================
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.3, random_state=42
)
# =========================
# 3. Créer et entraîner le modèle
# =========================
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)
# =========================
# 4. Effectuer des prédictions
# =========================
y_pred = model.predict(X_test)
# =========================
# 5. Évaluer la performance du modèle
# =========================
print(f"Précision du modèle : {accuracy_score(y_test, y_pred):.2f}")
print("\nRapport de classification détaillé :")
print(classification_report(y_test, y_pred))
Sortie :
模型准确率:0.83

详细分类报告:
              precision    recall  f1-score   support

           0       0.67      1.00      0.80         2
           1       1.00      0.75      0.86         4

    accuracy                           0.83         6
   macro avg       0.83      0.88      0.83         6
weighted avg       0.89      0.83      0.84         6
Phase 3 : Avancé - Plongez au cœur des domaines clés
Après avoir maîtrisé les algorithmes classiques, vous pouvez vous tourner vers des domaines plus modernes et plus puissants.
Plongée au cœur de l'apprentissage automatique traditionnel
- Apprentissage ensembliste: Apprenez à combiner plusieurs modèles faibles pour construire un modèle fort.
- Forêt aléatoire: Un ensemble de plusieurs arbres de décision, avec une forte résistance au surapprentissage.
- Arbres de boosting de gradient (par ex., XGBoost, LightGBM): Algorithmes très performants, extrêmement populaires dans les compétitions et l'industrie.
- Machine à vecteurs de support (SVM): Comprenez son idée centrale consistant à maximiser la « marge ».
- Évaluation et optimisation des modèles: Plongez au cœur de la validation croisée, du réglage des hyperparamètres (par ex., GridSearchCV) et des méthodes pour résoudre le surapprentissage/sous-apprentissage.
Passez à l'apprentissage profond
Lorsque les données (en particulier les images, le texte et la parole) deviennent complexes, l'apprentissage profond commence à démontrer ses puissantes capacités.
- Bases des réseaux de neurones: Comprendre les neurones, les fonctions d'activation, la propagation avant, la rétropropagation et les fonctions de perte.
- Frameworks d'apprentissage profond: Choisissez
PyTorch(adapté à la recherche, flexible) ouTensorFlow/Keras(environnement de production mature, écosystème complet), et étudiez l'un d'eux en profondeur. - Réseau de neurones convolutif (CNN): la norme pour le traitement des données d'image ; comprendre les rôles des couches de convolution et des couches de pooling.
- Réseau de neurones récurrent (RNN) et réseau de mémoire à long terme et à court terme (LSTM): des outils puissants pour le traitement des données séquentielles (par exemple, texte, séries temporelles).
Exemple
from tensorflow import keras
from tensorflow.keras import layers
model = keras.Sequential([
layers.Dense(64, activation='relu', input_shape=(input_dim,)), # Couche cachée 1
layers.Dropout(0.2), # Couche Dropout, pour éviter le surapprentissage
layers.Dense(32, activation='relu'), # Couche cachée 2
layers.Dense(1, activation='sigmoid') # Couche de sortie, pour la classification binaire
])
model.compile(optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy'])
model.summary() # Afficher la structure du modèle
# Après cela, vous pouvez utiliser model.fit pour l'entraînement
Phase 4 : Application et expansion - Se concentrer sur des directions, résoudre des problèmes concrets
L'apprentissage automatique comporte de nombreuses branches ; à ce stade, vous devez choisir une direction à approfondir en fonction de vos intérêts ou de vos projets de carrière.
Sélection de la direction principale

- Vision par ordinateur (CV): Plongez dans les variantes de CNN (ResNet, YOLO), apprenez la segmentation d'images et la détection d'objets.
- Traitement du langage naturel (NLP): Apprenez des plongements de mots (Word2Vec) à l'architecture Transformer (BERT, GPT), en maîtrisant la classification de texte, l'analyse de sentiments et la traduction automatique.
- Systèmes de recommandation: Apprenez le filtrage collaboratif, la factorisation matricielle et les modèles de recommandation d'apprentissage profond.
- Apprentissage par renforcement: Permet à un agent d'apprendre des politiques optimales en interagissant avec l'environnement ; c'est le cœur de l'IA de jeu et du contrôle de robots.
Ingénierie et déploiement
Apprenez à déployer des modèles entraînés dans des environnements de production et à fournir de vrais services.
- Sauvegarde et chargement du modèle(
pickle,joblib,.h5fichier). - Utiliser Flask/FastAPI pour créer un service API simple。
- Comprendre la conteneurisation Dockeret les concepts de base des services cloud (par exemple, AWS SageMaker, Google AI Platform).
Résumé et recommandations de ressources
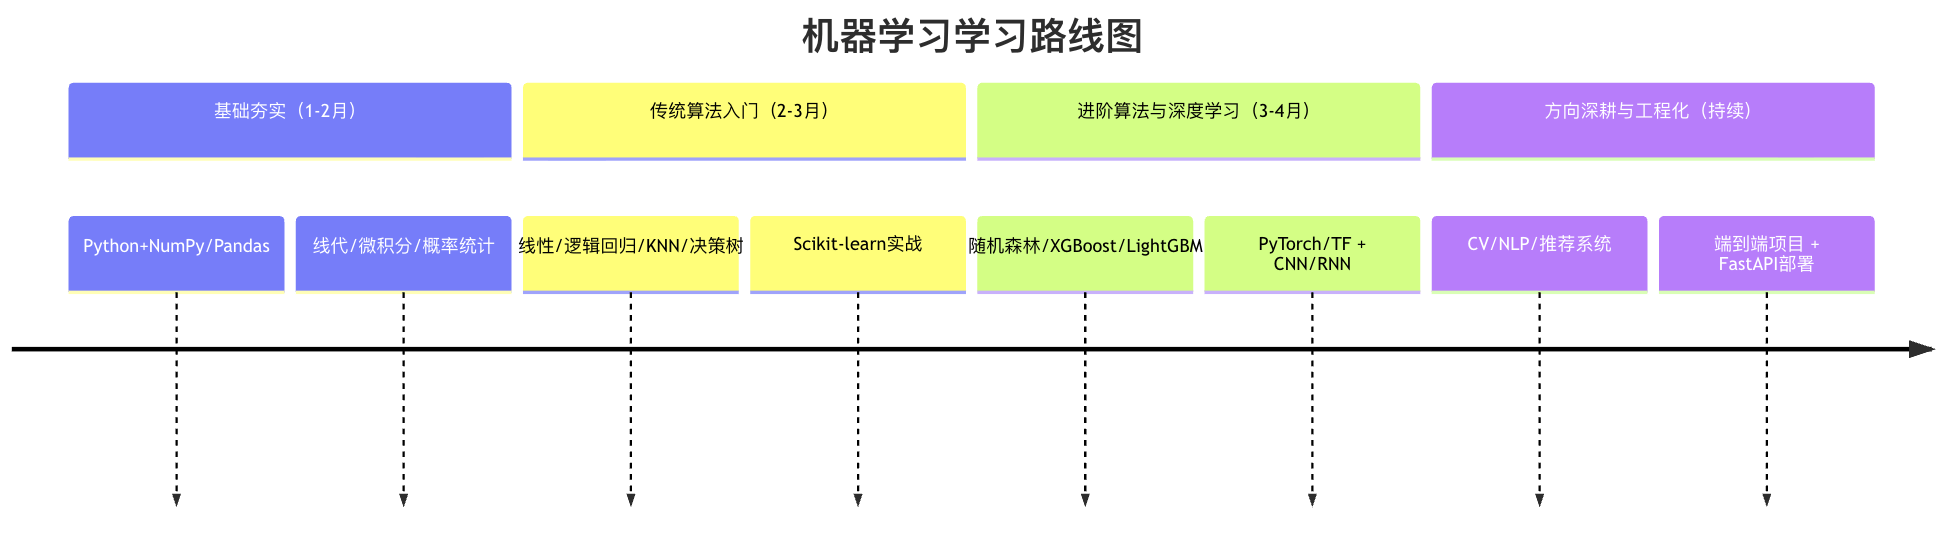
Visualisation du parcours d'apprentissage
La pratique est le seul raccourci
Le conseil le plus important:Apprendre en pratiquant, avec une approche par projets !
- Imiter: Reproduire des projets à partir de tutoriels et d'articles.
- Pratiquer: Participer à des compétitions de niveau débutant sur des plateformes comme Kaggle et Tianchi.
- Créer: Essayez d'utiliser l'apprentissage automatique pour résoudre un petit problème qui vous intéresse personnellement (par exemple, analyser vos données d'exercice, classer automatiquement votre collection de photos).
Recommandations de ressources de qualité
- Cours classiques: « Machine Learning » d'Andrew Ng (Coursera), « Dive into Deep Learning » de Mu Li.
- Plateformes de pratique: Kaggle (compétitions et jeux de données), Colab / Jupyter Notebook (environnement cloud gratuit).
- Consolidation des connaissances: Lire
scikit-learn、PyTorchla documentation officielle, et communiquer sur Stack Overflow et les communautés de forums associées.