Algorithmes d'apprentissage automatique
Les algorithmes d'apprentissage automatique peuvent être divisés en catégories telles que l'apprentissage supervisé, l'apprentissage non supervisé et l'apprentissage par renforcement.
Algorithmes d'apprentissage supervisé:
- Régression linéaire(Linear Regression) : Utilisée pour les tâches de régression, en prédisant des valeurs continues.
- Régression logistique(Logistic Regression) : Utilisée pour les tâches de classification binaire, en prédisant des catégories.
- Machine à vecteurs de support(SVM) : Utilisée pour les tâches de classification, en construisant un hyperplan pour la classification.
- Arbre de décision(Decision Tree) : Une méthode de classification ou de régression qui prend des décisions en fonction d'une structure arborescente.
Algorithmes d'apprentissage non supervisé:
- Regroupement K-means: Regroupe les données par centres de clusters.
- Analyse en composantes principales (ACP): Utilisée pour la réduction de dimensionnalité, en extrayant les composantes principales des données.
Chaque algorithme a ses scénarios d'application. Dans les applications pratiques, vous pouvez choisir l'algorithme d'apprentissage automatique le plus approprié en fonction des caractéristiques des données (comme la présence d'étiquettes, les dimensions des données, etc.).
| Dimension de classification | Catégorie | Définition principale | Algorithmes typiques | Principaux avantages et inconvénients | Scénarios applicables |
|---|---|---|---|---|---|
| Méthode d'apprentissage | Apprentissage supervisé | Apprendre la correspondance entre les entrées et les sorties à l'aide de données étiquetées | Régression logistique, SVM, Arbre de décision, CNN, LSTM | Avantages : grande précision de prédiction ; Inconvénients : dépend de données étiquetées de haute qualité | Classification, régression, reconnaissance d'images, traduction de texte |
| Apprentissage non supervisé | Utiliser des données non étiquetées pour extraire des motifs intrinsèques dans les données | K-Means, PCA, DBSCAN, Autoencodeurs | Avantages : aucun étiquetage requis ; Inconvénients : faible interprétabilité des résultats | Regroupement de données, réduction de dimensionnalité, détection d'anomalies, segmentation des utilisateurs | |
| Apprentissage semi-supervisé | Entraîner avec une petite quantité de données étiquetées et une grande quantité de données non étiquetées | SVM semi-supervisé, algorithmes de propagation d'étiquettes | Avantages : réduit le coût d'étiquetage ; Inconvénients : conception de modèle complexe | Analyse d'imagerie médicale, NLP pour langues de niche | |
| Apprentissage par renforcement | Le modèle optimise sa politique par l'interaction avec l'environnement et les signaux de récompense | Q-Learning, DQN, PPO | Avantages : adapté à la prise de décision dynamique ; Inconvénients : cycles d'entraînement longs | IA de jeu, contrôle de robots, optimisation de politique de recommandation | |
| Objectif de la tâche | Algorithmes de classification | Prédire des étiquettes de classe discrètes | Régression logistique, Forêt aléatoire, CNN | Avantages : adapté aux scénarios de classification ; Inconvénients : sensible au déséquilibre des classes | Détection de spam, classification d'images, diagnostic de maladies |
| Algorithmes de régression | Prédire des sorties numériques continues | Régression linéaire, Régression Ridge, XGBoost | Avantages : produit des valeurs continues ; Inconvénients : sensible aux valeurs aberrantes | Prédiction du prix des logements, prédiction des ventes, prédiction de la température | |
| Algorithmes de clustering | Regrouper des données similaires en une classe sans étiquettes | K-Means, clustering hiérarchique, DBSCAN | Avantages : regroupement automatique ; Inconvénients : l'effet de clustering dépend de la métrique de distance | Segmentation du marché, profilage des utilisateurs, détection d'anomalies | |
| Algorithmes de réduction de dimensionnalité | Réduire les dimensions des caractéristiques tout en conservant les informations essentielles | PCA, t-SNE, LDA | Avantages : réduit le coût de calcul ; Inconvénients : peut perdre certaines informations | Visualisation de données en grande dimension, prétraitement des caractéristiques | |
| Structure du modèle | Modèles linéaires | Supposent une relation linéaire entre l'entrée et la sortie | Régression linéaire, régression logistique, régression ridge | Avantages : forte interprétabilité, entraînement rapide ; Inconvénients : difficile de modéliser des relations non linéaires | Classification/régression simple, construction de modèle de base |
| Modèles arborescents | Construits sur des arbres de décision, gèrent les relations non linéaires | Arbre de décision, Forêt aléatoire, XGBoost, LightGBM | Avantages : aucune normalisation des caractéristiques nécessaire ; Inconvénients : les arbres trop profonds sont sujets au surapprentissage | Classification/régression de qualité industrielle, tâches de niveau compétition | |
| Modèles de réseaux de neurones | Structures de neurones multicouches qui extraient automatiquement des caractéristiques complexes | ANN、CNN、RNN、Transformer | Avantages : s'adapte aux relations complexes ; Inconvénients : nécessite de grandes quantités de données et de puissance de calcul | Reconnaissance d'images, NLP, synthèse vocale | |
| Modèles probabilistes | Basés sur la théorie des probabilités et des statistiques, calculent des distributions de probabilité | Naive Bayes, modèles de Markov cachés | Avantages : fondement théorique solide ; Inconvénients : repose sur des hypothèses fortes | Classification de texte, reconnaissance vocale, étiquetage de séquences |
Algorithmes d'apprentissage supervisé
Régression linéaire
La régression linéaire est un algorithme destiné aux problèmes de régression. Elle prédit une sortie continue en apprenant la relation linéaire entre les caractéristiques d'entrée et les valeurs cibles.
Scénarios d'application :Prédiction des prix immobiliers, des cours boursiers, etc.
L'objectif de la régression linéaire est de trouver une équation linéaire optimale :
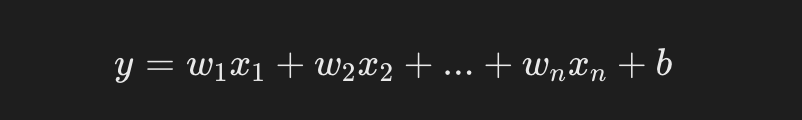
- y est la valeur prédite (valeur cible).
- x1,x2,xnest la caractéristique d'entrée.
- w1,w2,wnsont les poids à apprendre (paramètres du modèle).
- b est le terme de biais.
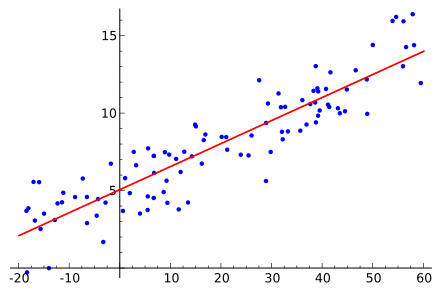
Ensuite, nous utilisons sklearn pour effectuer une simple prédiction des prix immobiliers :
Exemple
from sklearn.model_selection import train_test_split
import pandas as pd
# Supposons que nous ayons un simple jeu de données sur les prix immobiliers
data = {
'area': [50, 60, 80, 100, 120],
'price': [150, 180, 240, 300, 350]
}
df = pd.DataFrame(data)
# Caractéristiques et étiquettes
X = df[['area']]
y = df['price']
# Division des données
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Entraîner un modèle de régression linéaire
model = LinearRegression()
model.fit(X_train, y_train)
# Prédire
y_pred = model.predict(X_test)
print(f"Prix immobilier prédit : {y_pred}")
La sortie est :
预测的房价: [180.8411215]
Régression logistique
La régression logistique est un algorithme pour les problèmes de classification. Malgré la « régression » dans son nom, elle est utilisée pour des problèmes de classification binaire.
La régression logistique prédit une étiquette de classe en apprenant la relation entre les caractéristiques d'entrée et les catégories.
Scénarios d'application :Classification de spam, diagnostic de maladie (présence ou non de la maladie).
La sortie de la régression logistique est une valeur de probabilité, représentant la probabilité qu'un échantillon appartienne à une certaine classe.
On utilise généralement la fonction sigmoïde :
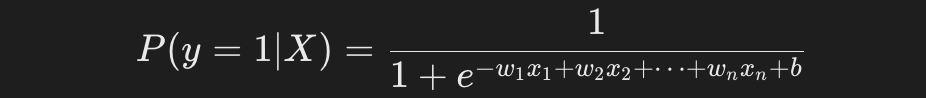
Utiliser la régression logistique pour une tâche de classification binaire :
Exemple
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Charger le jeu de données Iris
iris = load_iris()
X = iris.data
y = iris.target
# Ne prendre que les deux premières classes pour une classification binaire
X = X[y != 2]
y = y[y != 2]
# Division des données
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Entraîner un modèle de régression logistique
model = LogisticRegression()
model.fit(X_train, y_train)
# Prédire
y_pred = model.predict(X_test)
# Évaluer le modèle
print(f"Exactitude de classification : {accuracy_score(y_test, y_pred):.2f}")
La sortie est :
分类准确率: 1.00
Machine à vecteurs de support (SVM)
La machine à vecteurs de support est un algorithme de classification couramment utilisé. Elle construit un hyperplan pour maximiser la marge entre les classes, en minimisant l'erreur de classification.
Scénarios d'application :Classification de texte, reconnaissance faciale, etc.
Utiliser SVM pour la tâche de classification Iris :
Exemple
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Charger le jeu de données Iris
iris = load_iris()
X = iris.data
y = iris.target
# Division des données
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Entraîner le modèle SVM
model = SVC(kernel='linear')
model.fit(X_train, y_train)
# Prédire
y_pred = model.predict(X_test)
# Évaluer le modèle
print(f"Exactitude de classification SVM : {accuracy_score(y_test, y_pred):.2f}")
La sortie est :
SVM 分类准确率: 1.00
Arbre de décision
Un arbre de décision est une méthode de classification et de régression basée sur des structures arborescentes pour la prise de décision. Il détermine à quelle classe appartient un échantillon au moyen d'une série de "conditions de jugement".
Scénarios d'application :Classification des clients, notation de crédit, etc.
Utiliser un arbre de décision pour une tâche de classification :
Exemple
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Charger le jeu de données Iris
iris = load_iris()
X = iris.data
y = iris.target
# Division des données
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Entraîner un modèle d'arbre de décision
model = DecisionTreeClassifier(random_state=42)
model.fit(X_train, y_train)
# Prédiction
y_pred = model.predict(X_test)
# Évaluer le modèle
print(f"Précision de la classification par arbre de décision : {accuracy_score(y_test, y_pred):.2f}")
Le résultat de sortie est:
决策树分类准确率: 1.00
Algorithmes d'apprentissage non supervisé
Regroupement K-means
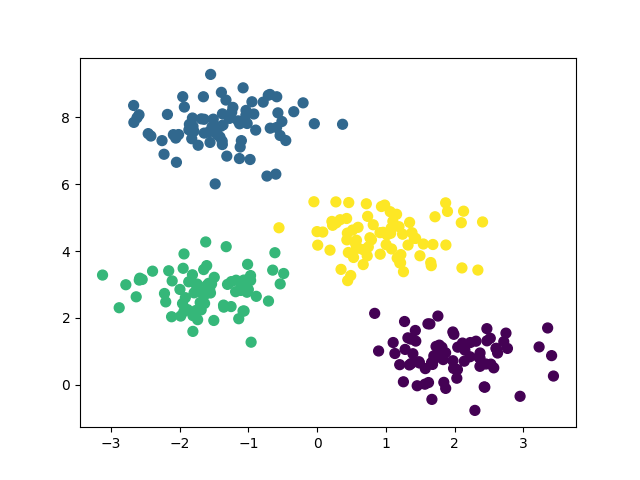
K-means est un algorithme de regroupement basé sur des centroïdes qui ajuste continuellement les centroïdes des groupes afin que les points de données de chaque groupe soient aussi proches que possible du centre du groupe.
Scénarios d'application :Segmentation des clients, analyse de marché, compression d'images.
Utilisation de K-means pour la segmentation des clients :
Exemple
from sklearn.datasets import make_blobs
import matplotlib.pyplot as plt
# Générer un jeu de données 2D simple
X, _ = make_blobs(n_samples=300, centers=4, cluster_std=0.60, random_state=0)
# Entraîner le modèle K-means
model = KMeans(n_clusters=4)
model.fit(X)
# Prédire les résultats du clustering
y_kmeans = model.predict(X)
# Visualiser les résultats du clustering
plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.show()
La figure de sortie est présentée ci-dessous :
Analyse en composantes principales (ACP)
L'ACP est une technique de réduction de dimensionnalité qui transforme les données dans un nouveau système de coordonnées par transformation linéaire, en concentrant la majeure partie de la variance dans les premières composantes principales.
Scénarios d'application :Réduction de dimensionnalité d'images, sélection de caractéristiques, visualisation de données.
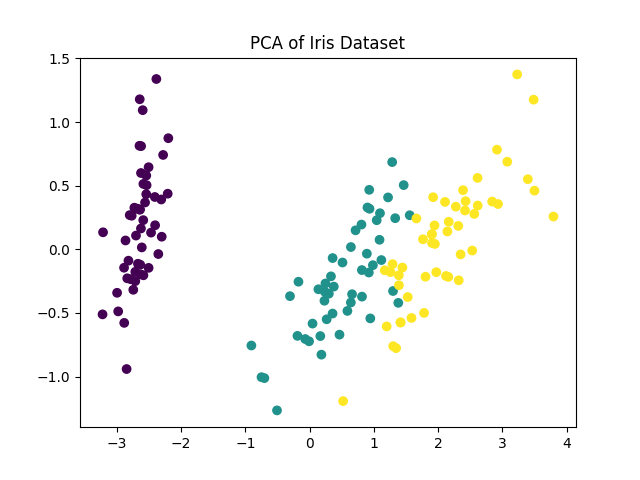
Utilisation de l'ACP pour la réduction de dimensionnalité et la visualisation de données de haute dimension :
Exemple
from sklearn.datasets import load_iris
import matplotlib.pyplot as plt
# Charger le jeu de données Iris
iris = load_iris()
X = iris.data
y = iris.target
# Réduire à 2 dimensions
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)
# Visualiser les résultats
plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y, cmap='viridis')
plt.title('ACP du jeu de données Iris')
plt.show()
La figure de sortie est présentée ci-dessous :
Algorithmes d'apprentissage automatique
| Nom complet en chinois | Nom complet en anglais | Abréviation | Scénarios d'application principaux |
|---|---|---|---|
| Algorithmes d'apprentissage automatique traditionnels | |||
| Arbre de décision | Arbre de décision | DT | Classification, régression, analyse de l'importance des variables |
| Forêt aléatoire | Forêt aléatoire | RF | Classification, régression, détection d'anomalies, sélection de variables |
| Régression logistique | Régression logistique | LR | Tâches de classification binaire, prédiction de probabilité, scoring de crédit |
| Machine à vecteurs de support | Machine à vecteurs de support | SVM | Classification, données de grande dimension à petit échantillon, classification de texte |
| Bayes naïf | Bayes naïf | NB | Classification de texte, détection de spam, analyse de sentiments |
| Arbre de boosting de gradient | Arbre de décision à boosting de gradient | GBDT | Classification, régression, tâches de classement |
| Gradient Boosting extrême | Gradient Boosting extrême | XGBoost | Classification et régression de haute précision, tâches de niveau compétition, prédiction du taux de clics |
| Machine de Gradient Boosting légère | Machine de Gradient Boosting légère | LightGBM | Classification et régression de données à grande échelle, prédiction en temps réel, systèmes de recommandation |
| Algorithme des k plus proches voisins | K plus proches voisins | KNN | Classification et régression simples, systèmes de recommandation, détection d'anomalies |
| Regroupement K-Means | Regroupement K-Means | K-Means | Regroupement de données, segmentation d'utilisateurs, segmentation d'images |
| Analyse en composantes principales | Analyse en composantes principales | PCA | Réduction de dimensionnalité des données, visualisation de données de grande dimension, débruitage des caractéristiques |
| Algorithmes d'apprentissage profond | |||
| Réseau de neurones artificiels | Réseau de neurones artificiels | ANN | Classification et régression simples, validation de modèle de référence |
| Réseau de neurones convolutif | Réseau de neurones convolutif | CNN | Reconnaissance d'images, détection d'objets, analyse vidéo, diagnostic d'images médicales |
| Réseau de neurones récurrent | Réseau de neurones récurrent | RNN | Traitement des données séquentielles, génération de texte, reconnaissance vocale |
| Réseau de mémoire à long terme et à court terme | Mémoire à long terme et à court terme | LSTM | Traduction de textes à longues séquences, synthèse vocale, prédiction de séries temporelles |
| Unité récurrente à portes | Unité récurrente à portes | GRU | Classification de séquences, analyse de sentiments, systèmes de dialogue |
| Réseau antagoniste génératif | Réseau antagoniste génératif | GAN | Génération d'images, transfert de style, augmentation de données, reconstruction par super-résolution |
| Transformer | Transformer | Transformer | Traduction en langage naturel, résumé de texte, tâches multimodales, architecture de base pour les grands modèles |
| Autoencodeur | Autoencodeur | AE | Compression de données, détection d'anomalies, extraction de caractéristiques |
| Autoencodeur variationnel | Autoencodeur variationnel | VAE | Tâches génératives, débruitage de données, génération d'images |
| Réseau de neurones de graphes | Réseau de neurones de graphes | GNN | Analyse de réseaux sociaux, prédiction de structure moléculaire, raisonnement sur graphe de connaissances |