Arbre de décision
L'arbre de décision est un algorithme d'apprentissage automatique couramment utilisé, largement appliqué aux problèmes de classification et de régression.
L'arbre de décision représente le processus de décision au moyen d'une structure arborescente. Chaque nœud interne représente un test sur une caractéristique ou un attribut, chaque branche représente le résultat du test, et chaque nœud feuille représente une classe ou une valeur.
Concepts de base de l'arbre de décision
- Nœud: Chaque point de l'arbre est appelé un nœud. Le nœud racine est le point de départ de l'arbre, les nœuds internes sont des points de décision et les nœuds feuilles sont les résultats finaux de décision.
- Branche: Le chemin d'un nœud à un autre est appelé une branche.
- Fractionnement: Le processus de division d'un jeu de données en plusieurs sous-ensembles en fonction d'une certaine caractéristique.
- Pureté: Mesure si les classes des échantillons d'un sous-ensemble sont cohérentes. Plus la pureté est élevée, plus les échantillons du sous-ensemble sont similaires.
Fonctionnement des arbres de décision
L'arbre de décision construit la structure de l'arbre en fractionnant récursivement le jeu de données en sous-ensembles plus petits. Les étapes spécifiques sont les suivantes :
- Sélectionner la meilleure caractéristique: Sélectionner la meilleure caractéristique pour le fractionnement en fonction de certains critères (tels que le gain d'information, l'indice de Gini, etc.).
- Fractionner le jeu de données: Diviser le jeu de données en plusieurs sous-ensembles en fonction de la caractéristique sélectionnée.
- Construire récursivement des sous-arbres: Répéter le processus ci-dessus pour chaque sous-ensemble jusqu'à ce qu'une condition d'arrêt soit remplie (comme tous les échantillons appartenant à la même classe, atteignant la profondeur maximale, etc.).
- Générer des nœuds feuilles: Lorsque la condition d'arrêt est remplie, générer un nœud feuille et attribuer une classe ou une valeur.
Critères de construction de l'arbre de décision
Lors de la construction d'un arbre de décision, il faut sélectionner la meilleure caractéristique pour la scission. Les critères courants incluent :
1. Gain d'information
Utilisé pour les problèmes de classification, il mesure l'amélioration de la pureté du jeu de données après la sélection d'une caractéristique. La formule de calcul est :
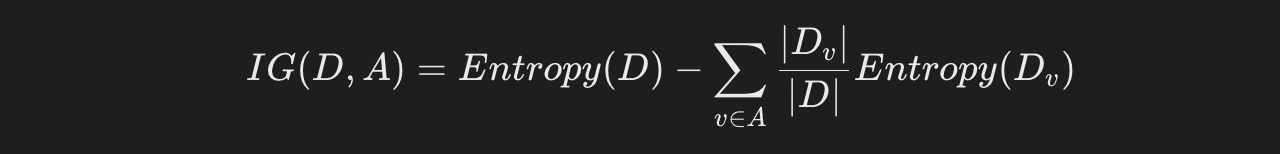
oùEntropieest l'entropie du jeu de données, utilisée pour mesurer l'incertitude des données.
2. Indice de Gini
Également un critère de scission pour les problèmes de classification. La formule de calcul est :
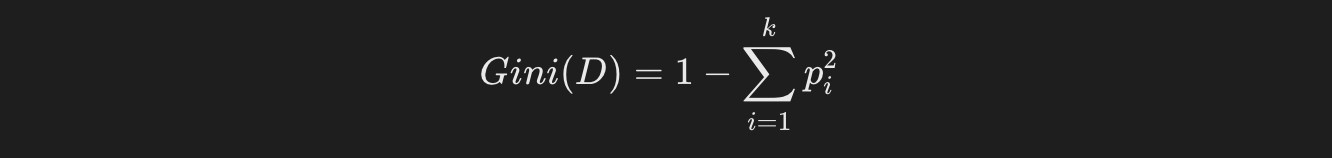
où piest la proportion d'échantillons de la classe i. Plus l'indice de Gini est petit, plus le jeu de données est pur.
3. Erreur quadratique moyenne (MSE)
Utilisé pour les problèmes de régression, il mesure la différence entre les valeurs prédites et les valeurs réelles.
Plus le MSE est petit, meilleure est la performance de prédiction de l'arbre de régression.
Avantages et inconvénients des arbres de décision
Avantages
- Facile à comprendre et à interpréter: La structure d'un arbre de décision est intuitive et facile à comprendre et à interpréter.
- Gérer plusieurs types de données: peut gérer des données numériques et catégorielles.
- Pas besoin de standardisation des données: les arbres de décision ne nécessitent pas de standardisation ni de normalisation des données.
Inconvénients
- Sujet au surapprentissage: les arbres de décision sont sujets au surapprentissage, surtout lorsque le jeu de données est petit ou que la profondeur de l'arbre est grande.
- Sensible au bruit: les arbres de décision sont sensibles aux données bruitées, ce qui peut dégrader les performances du modèle.
- Instable: de petits changements dans les données peuvent conduire à un arbre complètement différent.
Implémenter un arbre de décision avec Python
Ensuite, nous utiliserons la bibliothèque de Pythonscikit-learnbibliothèque pour implémenter un classificateur d'arbre de décision simple.
1. Installer les bibliothèques requises
Tout d'abord, assurez-vous d'avoir installéscikit-learnbibliothèque. Si ce n'est pas le cas, vous pouvez l'installer avec la commande suivante :
pip install scikit-learn
2. Importer les bibliothèques et charger le jeu de données
Nous utiliseronsscikit-learnle jeu de données Iris intégré pour démontrer l'utilisation des arbres de décision.
Exemple
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
# Charger le jeu de données Iris
iris = load_iris()
X = iris.data
y = iris.target
# Diviser le jeu de données en ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
3. Entraîner le modèle d'arbre de décision
Ensuite, nous utilisonsDecisionTreeClassifierpour entraîner le modèle d'arbre de décision.
Exemple
clf = DecisionTreeClassifier()
# Entraîner le modèle
clf.fit(X_train, y_train)
4. Prédiction et évaluation
Utilisez le modèle entraîné pour prédire l'ensemble de test et évaluer la précision du modèle.
Exemple
y_pred = clf.predict(X_test)
# Calculer la précision
accuracy = accuracy_score(y_test, y_pred)
print(f"Exactitude du modèle : {accuracy:.2f}")
Résultat de sortie :
模型准确率: 1.00
5. Visualiser l’arbre de décision
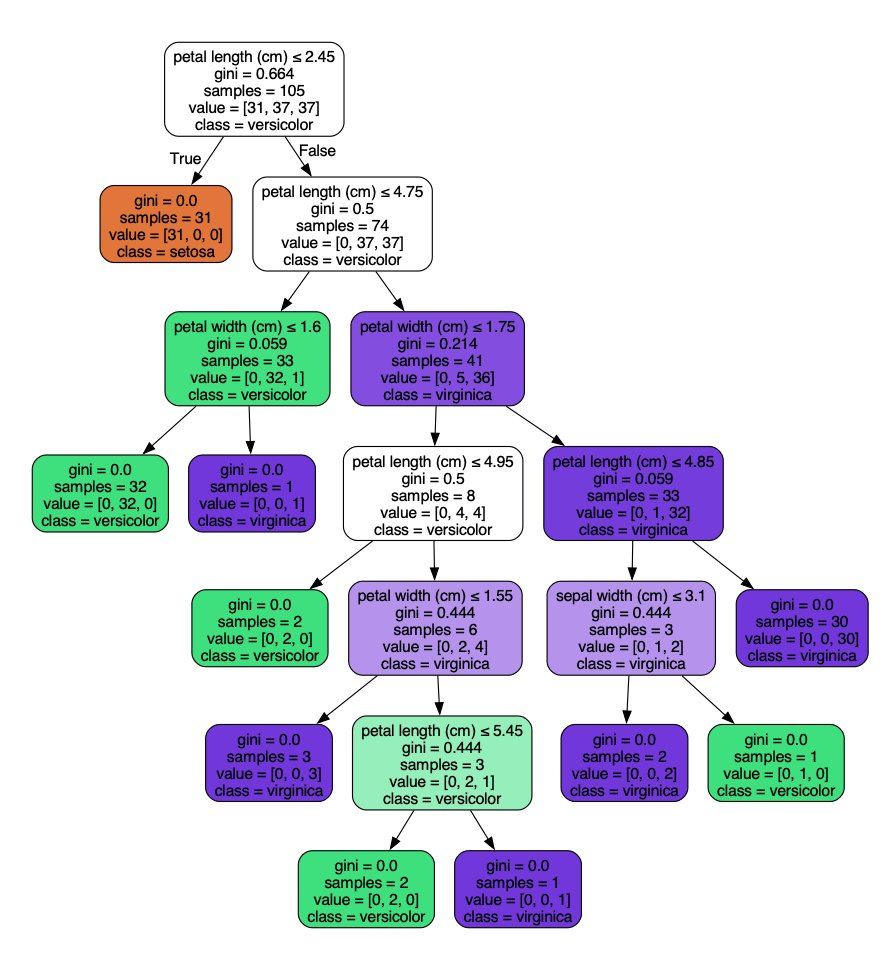
Pour comprendre la structure de l’arbre de décision de manière plus intuitive, nous pouvons utilisergraphvizla bibliothèque pour visualiser l’arbre de décision.
Adresse de téléchargement de Graphviz :https://graphviz.org/download/
- Sous Windows, vous pouvez télécharger le paquet d’installation pour Windows (fichier .msi).
- Sous Linux, vous pouvez installer à l’aide de la commande du gestionnaire de paquets, par exempleapt install graphviz
- Commande d’installation sur macOSbrew install graphviz。
Alternativement, installez à partir des sources en téléchargeant le dernier paquet source (fichier .tar.gz).
tar -zxvf graphviz-<version>.tar.gz
cd graphviz-<version>
./configure
make
sudo make install
Après l’installation, vous pouvez vérifier si Graphviz a été installé avec succès à l’aide de la commande suivante :
dot -V
Si la sortie est similaire à ce qui suit, l’installation a réussi :
dot - graphviz version 12.2.1 (20241206.2353)
Installergraphvizbibliothèque :
Exemple
Ensuite, utilisez le code suivant pour générer la visualisation de l'arbre de décision :
Exemple
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
from sklearn.tree import export_graphviz
import graphviz
# Charger le jeu de données Iris
iris = load_iris()
X = iris.data
y = iris.target
# Diviser le jeu de données en ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Créer un classificateur d'arbre de décision
clf = DecisionTreeClassifier()
# Entraîner le modèle
clf.fit(X_train, y_train)
# Prédire sur l'ensemble de test
y_pred = clf.predict(X_test)
# Calculer la précision
accuracy = accuracy_score(y_test, y_pred)
print(f"Exactitude du modèle : {accuracy:.2f}")
# Exporter l'arbre de décision en fichier dot
dot_data = export_graphviz(clf, out_file=None,
feature_names=iris.feature_names,
class_names=iris.target_names,
filled=True, rounded=True,
special_characters=True)
# Afficher l'arbre de décision à l'aide de graphviz
graph = graphviz.Source(dot_data)
graph.render("iris_decision_tree") # Enregistrer au format PDF
graph.view() # Voir dans le navigateur
L'exécution du code ci-dessus générera un fichier iris_decision_tree.pdf, affiché comme suit :