Apprentissage automatique - Cas de visualisation PCA
Imaginez que vous rangez une pièce encombrée remplie d'objets divers. Pour mieux comprendre l'agencement de la pièce, vous pourriez prendre plusieurs photos sous différents angles (par exemple, de face, de côté, de dessus).
L'analyse en composantes principales (PCA)fait quelque chose de similaire en apprentissage automatique.
PCA est un puissantoutil de réduction de dimensionnalité des donnéesetet de visualisation. Lorsque nos données contiennent des centaines ou des milliers de caractéristiques (dimensions), les données sont comme dans un espace ultra-hautement dimensionnel que les humains ne peuvent pas comprendre intuitivement.
PCA nous aide à trouver les perspectives les plus importantes (c'est-à-dire les composantes principales) dans les données et projette les données sur les deux ou trois dimensions les plus importantes, ce qui nous permet d'observer la structure et la distribution des données de grande dimension à l'aide de diagrammes de dispersion en deux ou trois dimensions.
En termes simples, les objectifs de l'ACP sont :
- Réduction de dimensionnalité :Utiliser moins de caractéristiques pour représenter les données d'origine, ce qui réduit le calcul et l'espace de stockage tout en supprimant le bruit.
- Visualisation :Réduire les données de grande dimension à 2D ou 3D afin que nous puissions observer intuitivement les relations entre les points de données (par exemple, regroupement, séparation).
Principes fondamentaux et flux de travail de l'ACP
L'idée centrale de l'ACP est de trouver les directions dans lesquelles la variance des données est maximisée.
Plus la variance est grande, plus les points projetés sont dispersés dans cette direction, et plus ils contiennent d'informations.
La première direction trouvée est lapremière composante principale (CP1),et la deuxième direction, qui est orthogonale à CP1 et présente la variance la plus élevée suivante, est ladeuxième composante principale (CP2),et ainsi de suite.
Diagramme du flux de travail de l'ACP
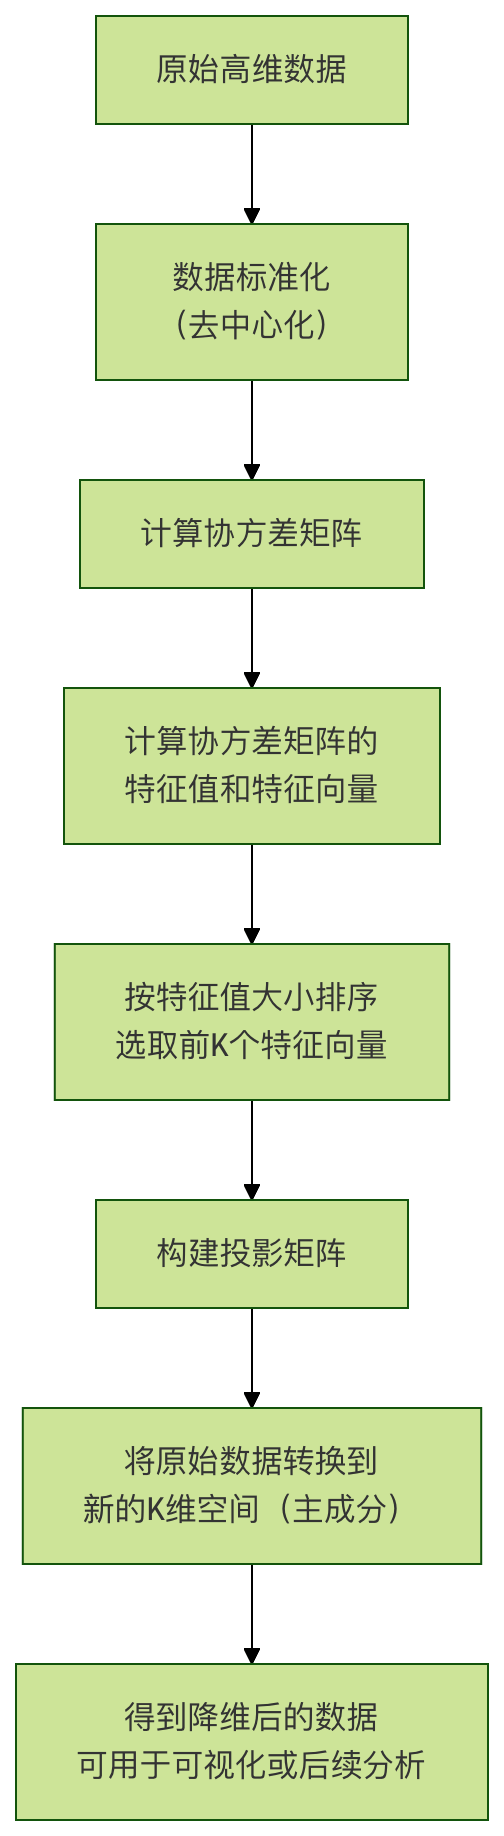
Étapes clés du flux de travail :
Standardisation :Faire en sorte que chaque caractéristique ait une moyenne de 0 et un écart-type de 1, en garantissant que toutes les caractéristiques ont une importance égale lors du calcul.
Matrice de covariance :Calculer les corrélations entre les caractéristiques. L'ACP trouve les directions principales de variation des données en analysant cette matrice.
Valeurs propres et vecteurs propres:
- Vecteurs propres :Ce sont les directions des composantes principales que nous recherchons.
- Valeurs propres :Elles correspondent à la variance des données le long de la direction du vecteur propre. Plus la valeur propre est grande, plus la composante principale correspondante est importante.
Sélection des composantes principales :Nous trions les valeurs propres de la plus grande à la plus petite et sélectionnons les vecteurs propres correspondant aux K plus grandes valeurs propres. K est la dimensionnalité cible vers laquelle nous voulons réduire (par exemple, pour la visualisation, K=2 ou 3).
Transformation des données :Utilisez les K vecteurs propres sélectionnés pour former une matrice de projection, puis multipliez les données d'origine par cette matrice pour obtenir les coordonnées sur les K nouvelles composantes principales, c'est-à-dire les données réduites.
Cas pratique : visualisation du jeu de données Iris
Nous allons utiliser le classiquejeu de données Irispour démontrer l'ACP. Ce jeu de données contient 150 échantillons, chacun avec 4 caractéristiques (longueur des sépales, largeur des sépales, longueur des pétales, largeur des pétales), et appartient à 3 espèces différentes.
Notre objectif est d'utiliser l'ACP pour réduire ces données 4-dimensionnelles à 2 dimensions et de les tracer sur un plan 2D afin de voir si différentes espèces de fleurs peuvent être distinguées.
Préparation de l'environnement et chargement des données
Tout d'abord, assurez-vous d'avoir installé les bibliothèques Python nécessaires :scikit-learn, matplotlib, numpy,pandas。
Exemple
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler
# Définir la police chinoise et le style du graphique (facultatif)
plt.rcParams['font.sans-serif'] = ['SimHei'] # Utilisé pour afficher correctement les libellés chinois
plt.rcParams['axes.unicode_minus'] = False # Utilisé pour afficher correctement les signes négatifs
# Charger le jeu de données Iris
iris = datasets.load_iris()
X = iris.data # Données de caractéristiques, forme (150, 4)
y = iris.target # Étiquettes cibles (espèces), forme (150,)
target_names = iris.target_names # Noms des espèces : ['setosa', 'versicolor', 'virginica']
print(f"Forme du jeu de données : {X.shape}")
print(f"Noms des caractéristiques : {iris.feature_names}")
print(f"Classes cibles : {target_names}")
Sortie :
数据集形状: (150, 4)
特征名称: ['sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)']
目标类别: ['setosa' 'versicolor' 'virginica']
Standardisation des données
Avant d'appliquer l'ACP, la standardisation des données est unecrucialeétape.
Parce que l'ACP est très sensible à l'échelle des caractéristiques. Si une caractéristique a une plage numérique (par exemple, la longueur des pétales mesurée en centimètres, valeurs entre 1-10) beaucoup plus grande qu'une autre caractéristique (par exemple, la largeur des sépales mesurée en millimètres, valeurs entre 0.1-1), alors la caractéristique avec la plage la plus grande dominera la direction des composantes principales, ce qui n'est généralement pas ce que nous voulons.
Exemple
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
print("Après la standardisation, les 5 premiers échantillons :")
print(X_scaled[:5])
Application de l'ACP pour la réduction de dimensionnalité
Nous utilisons lascikit-learndePCAclasse PCA, qui peut facilement effectuer tous les calculs mathématiques.
Exemple
pca = PCA(n_components=2)
# Ajuster le modèle PCA sur les données standardisées et transformer les données
X_pca = pca.fit_transform(X_scaled)
print(f"Forme des données réduites : {X_pca.shape}")
print(f"Coordonnées des 5 premiers échantillons sur PC1 et PC2 :\n{X_pca[:5]}")
# Vérifier le ratio de variance expliquée de chaque composante principale
print(f"Ratio de variance expliquée des composantes principales : {pca.explained_variance_ratio_}")
print(f"Ratio de variance expliquée cumulée des deux premières composantes principales : {sum(pca.explained_variance_ratio_):.4f}")
Explication du code :
n_components=2: Spécifie que nous voulons réduire les données à 2 dimensions.
fit_transform(X_scaled): Cette méthode accomplit deux choses à la fois :
fit: À partir des données d'entrée,X_scaledcalculez les paramètres requis par l'ACP (tels que les directions des composantes principales).transform: Utilisez les paramètres calculés pourX_scaledtransformer les données dans le nouvel espace bidimensionnel.
explained_variance_ratio_: C'est un attribut très important. Il nous indique laproportion de la variance des données d'origine capturée par chaque composante principale.Par exemple, si la sortie est[0.73, 0.23], cela signifie que PC1 conserve 73% des informations des données d'origine, PC2 en conserve 23%, et ensemble elles conservent 96% des informations. Cela nous aide à évaluer la perte d'informations après la réduction de dimensionnalité.
Résultats de visualisation
Maintenant, nous avons les données bidimensionnellesX_pca, et nous pouvons facilement les visualiser avec un nuage de points.
Exemple
plt.figure(figsize=(8, 6))
# Définir différentes couleurs et marqueurs pour chaque espèce
colors = ['navy', 'turquoise', 'darkorange']
lw = 2 # Largeur de ligne
# Parcourir les trois espèces et tracer chacune
for color, i, target_name in zip(colors, [0, 1, 2], target_names):
plt.scatter(X_pca[y == i, 0], # Sélectionner les coordonnées PC1 des échantillons appartenant à l'espèce i
X_pca[y == i, 1], # Sélectionner les coordonnées PC2 des échantillons appartenant à l'espèce i
color=color, alpha=0.8, lw=lw,
label=target_name)
# Ajouter le titre du graphique et les étiquettes des axes
plt.title('Visualisation 2D ACP du jeu de données Iris')
plt.xlabel(f'Première composante principale (PC1) - Ratio de variance expliquée : {pca.explained_variance_ratio_)
plt.ylabel(f'Deuxième composante principale (PC2) - Ratio de variance expliquée : {pca.explained_variance_ratio_)
plt.legend(loc='best', shadow=False, scatterpoints=1)
plt.grid(True, linestyle='--', alpha=0.6)
# Afficher le graphique
plt.tight_layout()
plt.show()
Interprétation des résultats de visualisation :Après avoir exécuté le code ci-dessus, vous obtiendrez un nuage de points en deux dimensions.
- Axe des X (PC1): Représente la direction de variance maximale parmi les 4 caractéristiques d'origine et constitue la dimension la plus importante pour distinguer les données. Comme on peut le voir sur la figure, il sépare bien l'espèceSetosades deux autres espèces.
- Axe des Y (PC2): Représente la direction orthogonale à PC1 avec la deuxième plus grande variance et fournit des informations distinctives supplémentaires. Il aide à mieux distinguerVersicoloretVirginica (Iris de Virginie), bien que les deux se chevauchent partiellement.
- Conclusion: Grâce à l'ACP, nous avons réussi à projeter les données en 4 dimensions sur un plan 2D et à observer clairement le regroupement des trois espèces. Setosa est complètement séparée, tandis que Versicolor et Virginica se chevauchent partiellement dans la projection 2D, ce qui indique que l'utilisation des deux premières composantes principales seulement (conservant environ 95 % des informations) ne suffit pas à distinguer parfaitement les deux dernières espèces, mais leurs principales tendances de distribution sont déjà très évidentes.
Exploration et réflexion approfondies
Comment choisir le nombre de composantes principales (valeur K) ?
Dans les projets réels, nous ne savons peut-être pas à combien de dimensions réduire les données. Une méthode courante consiste à tracer unScree Plot, qui montre le taux de variance expliquée de chaque composante principale.
Exemple
pca_full = PCA()
pca_full.fit(X_scaled)
# Tracer le diagramme des valeurs propres
plt.figure(figsize=(8, 5))
plt.plot(range(1, len(pca_full.explained_variance_ratio_) + 1),
pca_full.explained_variance_ratio_, 'o-', linewidth=2)
plt.title('Taux de variance expliquée ACP - Diagramme des valeurs propres')
plt.xlabel('Indice des composantes principales')
plt.ylabel('Taux de variance expliquée')
plt.grid(True, linestyle='--', alpha=0.6)
plt.xticks(range(1, len(pca_full.explained_variance_ratio_) + 1))
plt.tight_layout()
plt.show()
# Tracer le taux cumulé de variance expliquée
plt.figure(figsize=(8, 5))
plt.plot(range(1, len(pca_full.explained_variance_ratio_) + 1),
np.cumsum(pca_full.explained_variance_ratio_), 's-', linewidth=2, color='red')
plt.title('Taux de variance cumulée expliquée par l’ACP')
plt.xlabel('Nombre de composantes principales')
plt.ylabel('Taux de variance cumulée expliquée')
plt.axhline(y=0.95, color='gray', linestyle='--', label='seuil de 95%') # Seuil courant
plt.legend()
plt.grid(True, linestyle='--', alpha=0.6)
plt.xticks(range(1, len(pca_full.explained_variance_ratio_) + 1))
plt.tight_layout()
plt.show()
Comment choisir la valeur de K ?
- Regardez le point du coude: Dans le graphique des valeurs propres, trouvez le point où la diminution du taux de variance expliquée ralentit soudainement (c'est-à-dire le coude). Les composantes principales qui suivent contribuent moins.
- Fixez un seuil: Dans le graphique de variance cumulée, choisissez la plus petite valeur de K pour que le taux cumulé expliqué atteigne un seuil satisfaisant (comme 95% ou 99%). D’après le graphique cumulé des données iris, les deux premières composantes principales expliquent déjà plus de 95% de la variance, donc K=2 est un bon choix.
Comprendre la signification des composantes principales
Nous pouvons également examiner leschargementsdes composantes principales, c'est-à-dire les poids de contribution de chaque caractéristique d'origine aux composantes principales, ce qui aide à interpréter la signification réelle des composantes principales.
Exemple
pca_components = pca.components_ # La forme est (2, 4)
# Utiliser un DataFrame pour un affichage plus clair
df_components = pd.DataFrame(pca_components,
columns=iris.feature_names,
index=['PC1', 'PC2'])
print("Matrice de chargement des composantes principales (vecteurs propres) :")
print(df_components)
# Peut être visualisé avec une carte thermique
import seaborn as sns
plt.figure(figsize=(8, 4))
sns.heatmap(df_components, annot=True, cmap='RdBu_r', center=0)
plt.title('Carte thermique des chargements des composantes principales')
plt.tight_layout()
plt.show()
Interprétation de la matrice de chargements :
- PourPC1, si la longueur et la largeur des pétales ont des poidscorrectsrelativement importants, tandis que la largeur des sépales a un poidsnégatif relativement importantpondérations, alors PC1 peut principalement représenter la caractéristique globale du contraste entre la taille des pétales et la largeur des sépales.
- PourPC2, le schéma de pondération est différent, et il peut représenter une autre combinaison de caractéristiques. En analysant ces pondérations, nous pouvons attribuer une signification biologique ou commerciale pratique aux composantes principales abstraites.
Résumé et exercices pratiques
Résumé des points clés
- Qu'est-ce que l'ACP: une méthode non supervisée de réduction linéaire de dimensionnalité qui réexprime les données en trouvant les directions orthogonales (composantes principales) de variance maximale des données.
- Étapes clés: standardisation -> calcul de la matrice de covariance -> calcul des valeurs propres et des vecteurs propres -> sélection des composantes principales -> projection des données.
- Concepts importants:
- Composantes principales: nouveaux axes de caractéristiques non corrélés.
- Taux de variance expliquée: une mesure qui évalue l'importance de chaque composante principale.
- Saturations: le pont reliant les caractéristiques d'origine et les composantes principales, utilisé pour expliquer la signification des composantes principales.
- Applications principales: visualisation des données, suppression du bruit et de la redondance, et utilisation comme étape de prétraitement pour d'autres modèles (tels que la classification, la régression) afin d'accélérer l'entraînement.
Travaux pratiques
Pour consolider vos connaissances, veuillez essayer de réaliser les exercices suivants :
Exercice 1 : Explorer différents jeux de donnéesEssayez descikit-learndans d'autres jeux de données (tels quedigitsjeu de données de chiffres manuscrits ouwinejeu de données wine) pour effectuer une visualisation PCA. Observez si les images de dimension réduite peuvent encore conserver la discrimination entre les différentes catégories.
Exemple
from sklearn.datasets import load_wine
wine = load_wine()
# ... Répétez le processus PCA
Exercice 2 : Visualisation 3DRéduisez les données iris à 3 dimensions, et utilisezmpl_toolkits.mplot3dbibliothèque pour tracer un nuage de points 3D. Voyez si le chevauchement entre Versicolor et Virginica diminue après l'ajout d'une dimension.
Exemple
pca3 = PCA(n_components=3)
X_pca3 = pca3.fit_transform(X_scaled)
# ... Créer une figure 3D pour le tracé