Cycle de vie d'un projet d'apprentissage automatique
Un projet d'apprentissage automatique est comme la construction d'une maison ; il nécessite un processus complet, de la conception des plans à la construction et à l'inspection finale. Chaque étape est cruciale et indispensable.
Les six phases clés du flux de travail en apprentissage automatique:
- Définition du problème : clarifier le problème à résoudre
- Collecte des données : acquérir des données pertinentes
- Préparation des données : nettoyer et prétraiter les données
- Entraînement du modèle : sélectionner les algorithmes et entraîner les modèles
- Évaluation du modèle : évaluer les performances du modèle
- Déploiement du modèle : mettre le modèle en service
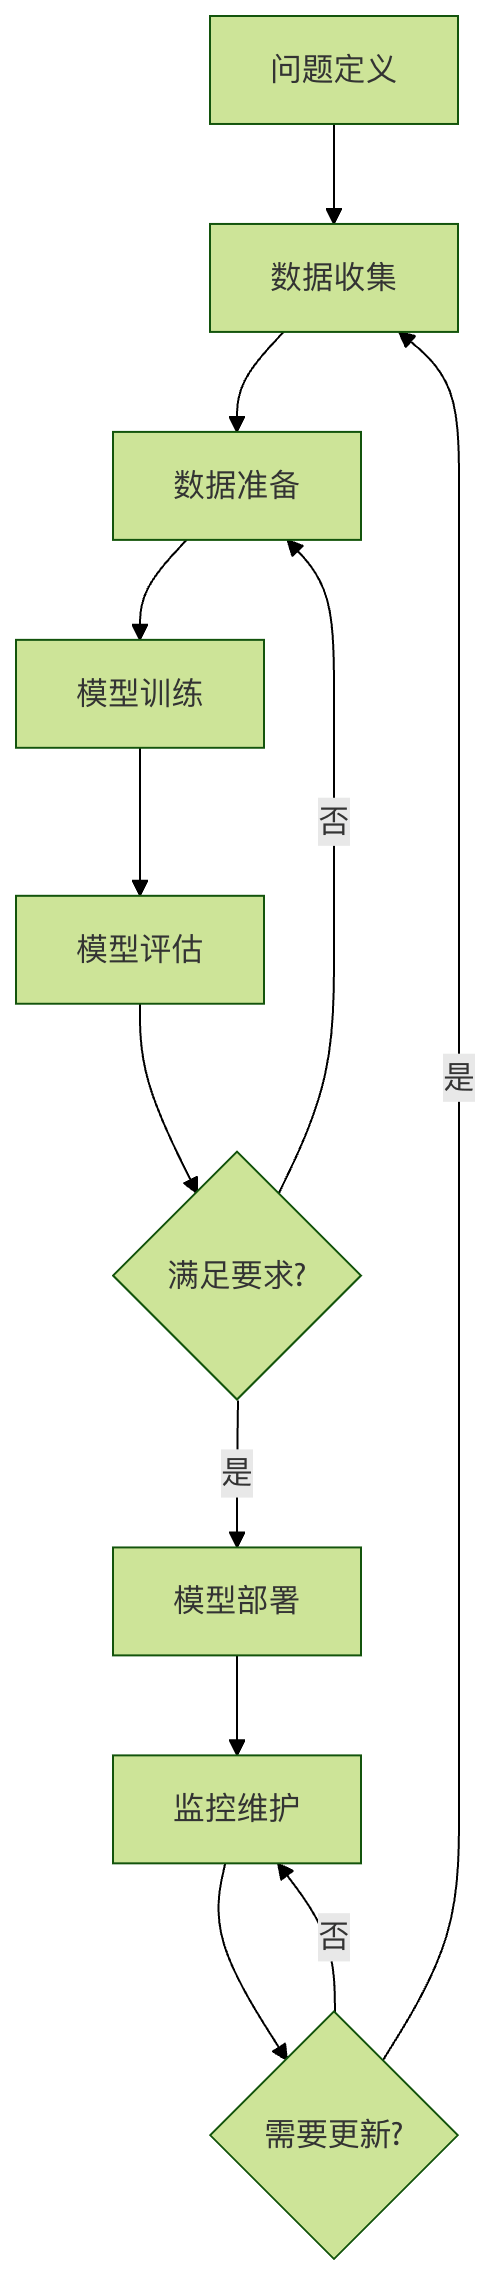
Phase 1 : Définition du problème
Définir le problème métier
La définition du problème est le point de départ le plus important d'un projet de machine learning, tout comme vous devez connaître votre destination avant d'utiliser la navigation.
Questions clés
Quel problème essayons-nous de résoudre ?
- Classification : déterminer si un courriel est un spam
- Régression : prédire les prix des maisons
- Clustering : segmentation des clients
- Détection d'anomalies : détecter la fraude à la carte de crédit
Pourquoi ce problème est-il important ?
- Valeur métier : améliorer l'efficacité, réduire les coûts, augmenter les revenus
- Valeur utilisateur : améliorer l'expérience, fournir des services personnalisés
Quels sont les critères de réussite ?
- Métriques quantitatives : précision supérieure à 90%
- Métriques métier : augmentation du taux de conversion de 20%
Exemple de définition de problème
Exemple
class ProblemDefinition:
def __init__(self):
# Problème métier
self.business_problem = "Le taux de conversion des achats des utilisateurs est faible ; la précision des recommandations doit être améliorée"
# Problème technique
self.technical_problem = "Prédire les produits qu'un utilisateur est susceptible d'acheter en fonction de son comportement"
# Type de problème
self.problem_type = "Système de recommandation (classification + classement)"
# Critères de réussite
self.success_criteria = {
"Amélioration du taux de clics": "15%",
"Amélioration du taux de conversion": "10%",
"Précision des recommandations": "80%"
}
# Contraintes
self.constraints = {
"Temps de réponse": "< 100ms",
"Confidentialité des données": "Conformité aux exigences du RGPD",
"Ressources de calcul": "Configuration serveur existante"
}
def define_features_and_labels(self):
"""Définir les caractéristiques et les étiquettes"""
features = {
"Caractéristiques utilisateur": ["Âge", "Genre", "Historique d'achats", "Comportement de navigation"],
"Caractéristiques du produit": ["Catégorie", "Prix", "Note", "Stock"],
"Caractéristiques contextuelles": ["Temps", "Appareil", "Localisation géographique"]
}
labels = {
"Étiquette principale": "A été cliqué",
"Étiquette secondaire": "A été acheté",
"Étiquette auxiliaire": "Temps de présence"
}
return features, labels
def print_definition(self):
"""Affiche la définition du problème"""
print("=" * 50)
print("Définition du problème d'apprentissage automatique")
print("=" * 50)
print(f"Problème métier : {self.business_problem}")
print(f"Problème technique : {self.technical_problem}")
print(f"Type de problème : {self.problem_type}")
print("\nCritères de réussite : ")
for metric, target in self.success_criteria.items():
print(f" {metric}:{target}")
print("\nContraintes : ")
for constraint, limit in self.constraints.items():
print(f" {constraint}:{limit}")
features, labels = self.define_features_and_labels()
print("\nDéfinitions des caractéristiques : ")
for category, items in features.items():
print(f" {category}:{', '.join(items)}")
print("\nDéfinitions des étiquettes : ")
for label_type, label_name in labels.items():
print(f" {label_type}:{label_name}")
# Exemple d'utilisation
problem = ProblemDefinition()
problem.print_definition()
Sortie :
==================================================
机器学习问题定义
==================================================
业务问题:用户购买转化率低,需要提高推荐精准度
技术问题:基于用户行为预测用户可能购买的商品
问题类型:推荐系统(分类+排序)

成功标准:
  点击率提升:15%
  转化率提升:10%
  推荐准确率:80%

约束条件:
  响应时间:< 100ms
  数据隐私:符合 GDPR 要求
  计算资源:现有服务器配置

特征定义:
  用户特征:年龄, 性别, 购买历史, 浏览行为
  商品特征:类别, 价格, 评分, 库存
  上下文特征:时间, 设备, 地理位置

标签定义:
  主要标签:是否点击
  次要标签:是否购买
  辅助标签:停留时间
Phase 2 : Collecte des données
Sources de données
Les données sont le carburant de l'apprentissage automatique; sans données appropriées, quelle que soit la qualité de l'algorithme, il ne peut pas fonctionner efficacement.
Sources de données courantes
- Données internes: données métier de l'entreprise, données sur le comportement des utilisateurs
- Données externes: jeux de données publics, services de données tiers
- Web scraping: données web, données des médias sociaux
- Données de capteurs: appareils IoT, systèmes de surveillance
Exemple de collecte de données
Exemple
import pandas as pd
import numpy as np
from datetime import datetime, timedelta
class DataCollector:
def __init__(self):
self.collected_data = {}
def collect_user_data(self, n_users=1000):
"""Collecter les données utilisateur"""
np.random.seed(42)
user_data = {
'user_id': range(1, n_users + 1),
'age': np.random.randint(18, 65, n_users),
'gender': np.random.choice(['Male', 'Female'], n_users),
'city': np.random.choice(['Beijing', 'Shanghai', 'Guangzhou', 'Shenzhen'], n_users),
'registration_date': [
datetime.now() - timedelta(days=np.random.randint(1, 365))
for _ in range(n_users)
]
}
self.collected_data['users'] = pd.DataFrame(user_data)
print(f"Enregistrements de données utilisateur collectés : {len(user_data['user_id'])}")
return self.collected_data['users']
def collect_behavior_data(self, n_behaviors=5000):
"""Collecter les données de comportement des utilisateurs"""
np.random.seed(42)
user_ids = np.random.choice(range(1, 1001), n_behaviors)
product_ids = np.random.choice(range(1, 501), n_behaviors)
behavior_data = {
'behavior_id': range(1, n_behaviors + 1),
'user_id': user_ids,
'product_id': product_ids,
'behavior_type': np.random.choice(
['Vue', 'Clic', 'Ajout au panier', 'Achat'], n_behaviors,
p=[0.4, 0.3, 0.2, 0.1]
),
'timestamp': [
datetime.now() - timedelta(minutes=np.random.randint(1, 10080))
for _ in range(n_behaviors)
],
'duration': np.random.exponential(30, n_behaviors) # Temps passé (secondes)
}
self.collected_data['behaviors'] = pd.DataFrame(behavior_data)
print(f"Enregistrements de données comportementales collectés : {len(behavior_data['behavior_id'])}")
return self.collected_data['behaviors']
def collect_product_data(self, n_products=500):
"""Collecte les données produit"""
np.random.seed(42)
categories = ['Électronique', 'Vêtements', 'Alimentation', 'Maison', 'Livres']
product_data = {
'product_id': range(1, n_products + 1),
'category': np.random.choice(categories, n_products),
'price': np.random.uniform(10, 1000, n_products),
'rating': np.random.uniform(3.0, 5.0, n_products),
'stock': np.random.randint(0, 1000, n_products)
}
self.collected_data['products'] = pd.DataFrame(product_data)
print(f"{len(product_data['product_id'])} enregistrements de données produit collectés")
return self.collected_data['products']
def get_data_summary(self):
"""Obtenir le résumé des données"""
print("\nRésumé de la collecte de données : ")
for name, df in self.collected_data.items():
print(f"\n{name} jeu de données : ")
print(f" Dimensions : {df.shape}")
print(f" Colonnes : {list(df.columns)}")
print(f" Valeurs manquantes : {df.isnull().sum().sum()}")
print(f" Données d'exemple :")
print(df.head(2))
# Exemple d'utilisation
collector = DataCollector()
collector.collect_user_data()
collector.collect_behavior_data()
collector.collect_product_data()
collector.get_data_summary()
Phase 3 : Préparation des données
Importance de la préparation des données
La préparation des données représente 60-80% du temps d'un projet d'apprentissage automatique, tout aussi importante que le travail de préparation avant la cuisson.
Principales tâches de la préparation des données
- Nettoyage des données: gérer les valeurs manquantes, les valeurs aberrantes, les valeurs en double
- Ingénierie des caractéristiques: créer de nouvelles caractéristiques, sélectionner les caractéristiques importantes
- Transformation des données: standardisation, normalisation, encodage
- Division des données: ensemble d'entraînement, ensemble de validation, ensemble de test
Exemple de préparation des données
Exemple
import pandas as pd
import numpy as np
from sklearn.preprocessing import StandardScaler, LabelEncoder
from sklearn.model_selection import train_test_split
class DataPreparer:
def __init__(self, data):
self.data = data.copy()
self.processed_data = None
def clean_data(self):
"""Nettoyage des données"""
print("Démarrage du nettoyage des données...")
# 1. Traiter les valeurs manquantes
print(f"Valeurs manquantes avant traitement : {self.data.isnull().sum().sum()}")
# Remplir les colonnes numériques avec la moyenne
numeric_columns = self.data.select_dtypes(include=[np.number]).columns
for col in numeric_columns:
if self.data[col].isnull().sum() > 0:
self.data[col].fillna(self.data[col].mean(), inplace=True)
# Remplir les colonnes catégorielles avec le mode
categorical_columns = self.data.select_dtypes(include=['object']).columns
for col in categorical_columns:
if self.data[col].isnull().sum() > 0:
mode_val = self.data[col].mode()[0]
self.data[col].fillna(mode_val, inplace=True)
print(f"Valeurs manquantes après traitement : {self.data.isnull().sum().sum()}")
# 2. Gérer les valeurs en double
duplicates_before = self.data.duplicated().sum()
self.data.drop_duplicates(inplace=True)
duplicates_after = self.data.duplicated().sum()
print(f"Doublons supprimés : {duplicates_before - duplicates_after} lignes")
# 3. Gérer les valeurs aberrantes (méthode simple : utiliser l'IQR)
for col in numeric_columns:
Q1 = self.data[col].quantile(0.25)
Q3 = self.data[col].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
outliers = ((self.data[col] < lower_bound) |
(self.data[col] > upper_bound)).sum()
if outliers > 0:
# Remplacer les valeurs aberrantes par les valeurs limites
self.data[col] = self.data[col].clip(lower_bound, upper_bound)
print(f"Traitement de {outliers} valeurs aberrantes dans la colonne {col}")
return self.data
def feature_engineering(self):
"""Ingénierie des caractéristiques"""
print("\nDémarrage de l'ingénierie des caractéristiques...")
# 1. Créer de nouvelles caractéristiques (exemple)
if 'price' in self.data.columns and 'rating' in self.data.columns:
# Créer une caractéristique de ratio prix-performance
self.data['price_per_rating'] = self.data['price'] / self.data['rating']
print("Nouvelle caractéristique créée : price_per_rating")
# 2. Sélection de caractéristiques (exemple simple : supprimer les caractéristiques à faible variance)
numeric_columns = self.data.select_dtypes(include=[np.number]).columns
low_variance_features = []
for col in numeric_columns:
if self.data[col].var() < 0.01: # Seuil de variance
low_variance_features.append(col)
if low_variance_features:
self.data.drop(columns=low_variance_features, inplace=True)
print(f"Suppression des caractéristiques à faible variance : {low_variance_features}")
return self.data
def transform_data(self):
"""Transformation des données"""
print("\n"Démarrage de la transformation des données...")
# 1. Encoder les variables catégorielles
categorical_columns = self.data.select_dtypes(include=['object']).columns
label_encoders = {}
for col in categorical_columns:
le = LabelEncoder()
self.data[col] = le.fit_transform(self.data[col])
label_encoders[col] = le
print(f"Encodage de la variable catégorielle : {col}")
# 2. Standardiser les variables numériques
numeric_columns = self.data.select_dtypes(include=[np.number]).columns
scaler = StandardScaler()
if len(numeric_columns) > 0:
self.data[numeric_columns] = scaler.fit_transform(self.data[numeric_columns])
print(f"Standardisation des variables numériques : {list(numeric_columns)}")
return self.data, label_encoders, scaler
def split_data(self, target_column, test_size=0.2, val_size=0.2):
"""Division des données"""
print(f"\n"Démarrage de la division des données (ratio du jeu de test : {test_size}, ratio du jeu de validation : {val_size})...")
X = self.data.drop(columns=[target_column])
y = self.data[target_column]
# D'abord séparer l'ensemble de test
X_temp, X_test, y_temp, y_test = train_test_split(
X, y, test_size=test_size, random_state=42
)
# Ensuite, séparer l'ensemble de validation des données restantes
val_size_adjusted = val_size / (1 - test_size)
X_train, X_val, y_train, y_val = train_test_split(
X_temp, y_temp, test_size=val_size_adjusted, random_state=42
)
print(f"Taille de l'ensemble d'entraînement : {X_train.shape)
print(f"Taille de l'ensemble de validation : {X_val.shape)
print(f"Taille de l'ensemble de test : {X_test.shape)
return {
'X_train': X_train, 'y_train': y_train,
'X_val': X_val, 'y_val': y_val,
'X_test': X_test, 'y_test': y_test
}
def prepare_pipeline(self, target_column):
"""Pipeline complet de préparation des données"""
print("=" * 50)
print("Pipeline de préparation des données")
print("=" * 50)
# 1. Nettoyage des données
self.clean_data()
# 2. Ingénierie des caractéristiques
self.feature_engineering()
# 3. Transformation des données
processed_data, encoders, scaler = self.transform_data()
# 4. Division des données
splits = self.split_data(target_column)
self.processed_data = processed_data
return splits, encoders, scaler
# Créer des données d'exemple et démontrer la préparation des données
np.random.seed(42)
sample_data = pd.DataFrame({
'age': np.random.randint(18, 65, 1000),
'income': np.random.normal(50000, 15000, 1000),
'gender': np.random.choice(['Male', 'Female'], 1000),
'city': np.random.choice(['Beijing', 'Shanghai', 'Guangzhou'], 1000),
'target': np.random.choice([0, 1], 1000)
})
# Ajouter quelques valeurs manquantes et aberrantes
sample_data.loc[np.random.choice(1000, 50), 'income'] = np.nan
sample_data.loc[np.random.choice(1000, 20), 'age'] = np.random.randint(100, 150)
preparer = DataPreparer(sample_data)
splits, encoders, scaler = preparer.prepare_pipeline('target')
Phase 4 : Entraînement du modèle
Stratégie de sélection du modèle
Choisir le bon modèle est la clé du succès, tout comme choisir le bon outil pour le travail.
Considérations sur la sélection du modèle
- Type de problème: classification, régression, regroupement, etc.
- Caractéristiques des données: taille des données, nombre de caractéristiques, type de données
- Exigences de performance: précision, vitesse, interprétabilité
- Contraintes de ressources: ressources de calcul, limites de temps
Exemple d'entraînement de modèle
Exemple
from sklearn.linear_model import LogisticRegression, LinearRegression
from sklearn.ensemble import RandomForestClassifier, RandomForestRegressor
from sklearn.svm import SVC, SVR
from sklearn.metrics import accuracy_score, mean_squared_error, classification_report
class ModelTrainer:
def __init__(self):
self.models = {}
self.trained_models = {}
def register_model(self, name, model, problem_type):
"""Enregistrer le modèle"""
self.models[name] = {
'model': model,
'problem_type': problem_type
}
print(f"Enregistrement du modèle : {name} ({problem_type})")
def train_single_model(self, name, X_train, y_train):
"""Entraîner un seul modèle"""
if name not in self.models:
raise ValueError(f"Le modèle {name} n'est pas enregistré")
model_info = self.models[name]
model = model_info['model']
print(f"\n"Entraînement du modèle : {name}")
model.fit(X_train, y_train)
self.trained_models[name] = model
print(f"Entraînement du modèle {name} terminé")
return model
def train_all_models(self, X_train, y_train):
"""Entraîner tous les modèles enregistrés"""
print("\n"Début de l'entraînement de tous les modèles...")
for name in self.models.keys():
try:
self.train_single_model(name, X_train, y_train)
except Exception as e:
print(f"Erreur lors de l'entraînement du modèle {name} : {e}")
return self.trained_models
def evaluate_models(self, X_test, y_test):
"""Évaluer tous les modèles entraînés"""
print("\n"Résultats de l'évaluation du modèle :")
print("-" * 50)
results = {}
for name, model in self.trained_models.items():
problem_type = self.models[name]['problem_type']
# Prédictions
y_pred = model.predict(X_test)
# Sélectionner les métriques d'évaluation en fonction du type de problème
if problem_type == 'classification':
accuracy = accuracy_score(y_test, y_pred)
results[name] = {'accuracy': accuracy}
print(f"{name}: Exactitude = {accuracy:.4f}")
# Rapport détaillé
print(classification_report(y_test, y_pred))
elif problem_type == 'regression':
mse = mean_squared_error(y_test, y_pred)
rmse = np.sqrt(mse)
results[name] = {'mse': mse, 'rmse': rmse}
print(f"{name}: MSE = {mse:.4f}, RMSE = {rmse:.4f}")
print("-" * 50)
return results
def get_best_model(self, results, metric='accuracy'):
"""Obtenir le meilleur modèle"""
if not results:
return None
best_model_name = max(results.keys(), key=lambda x: results[x].get(metric, 0))
best_score = results[best_model_name][metric]
print(f"\n"Meilleur modèle : {best_model_name} ({metric} = {best_score:.4f})")
return best_model_name, self.trained_models[best_model_name]
# Exemple d'utilisation
trainer = ModelTrainer()
# Enregistrer différents types de modèles
trainer.register_model('Régression logistique', LogisticRegression(random_state=42), 'classification')
trainer.register_model('Forêt aléatoire', RandomForestClassifier(n_estimators=100, random_state=42), 'classification')
trainer.register_model('Machine à vecteurs de support', SVC(random_state=42), 'classification')
# Créer les données d'entraînement
X_train = splits['X_train']
y_train = splits['y_train']
X_test = splits['X_test']
y_test = splits['y_test']
# Entraîner tous les modèles
trained_models = trainer.train_all_models(X_train, y_train)
# Évaluer les modèles
results = trainer.evaluate_models(X_test, y_test)
# Obtenir le meilleur modèle
best_name, best_model = trainer.get_best_model(results)
Phase 5 : Évaluation du modèle
Sélection de la métrique d'évaluation
Choisir la bonne métrique d'évaluation, c'est comme choisir la bonne règle, différentes métriques conviennent à différents scénarios.
Métriques d'évaluation courantes
Problèmes de classification:
- Exactitude : la proportion de prédictions correctes
- Précision : la proportion d'échantillons positifs prédits qui sont réellement positifs
- Rappel : la proportion d'échantillons positifs réels qui sont correctement prédits comme positifs
- Score F1 : la moyenne harmonique de la précision et du rappel
Problèmes de régression:
- Erreur quadratique moyenne (MSE) : la moyenne des différences au carré entre les valeurs prédites et les valeurs réelles
- Racine de l'erreur quadratique moyenne (RMSE) : la racine carrée de la MSE
- Erreur absolue moyenne (MAE) : la moyenne des différences absolues entre les valeurs prédites et les valeurs réelles
- Score R² : la proportion de variance expliquée par le modèle
Exemple d'évaluation de modèle
Exemple
import matplotlib.pyplot as plt
from sklearn.metrics import (
accuracy_score, precision_score, recall_score, f1_score,
confusion_matrix, roc_curve, auc
)
class ModelEvaluator:
def __init__(self):
self.evaluation_results = {}
def evaluate_classification(self, y_true, y_pred, y_prob=None, model_name="Modèle"):
"""Évaluer le modèle de classification"""
results = {}
# Métriques de base
results['accuracy'] = accuracy_score(y_true, y_pred)
results['precision'] = precision_score(y_true, y_pred, average='weighted')
results['recall'] = recall_score(y_true, y_pred, average='weighted')
results['f1'] = f1_score(y_true, y_pred, average='weighted')
print(f"\n"{model_name} Résultats de l'évaluation de la classification :")
print(f"Exactitude : {results['accuracy']:.4f}")
print(f"Précision : {results['precision']:.4f}")
print(f"Rappel : {results['recall']:.4f}")
print(f"Score F1 : {results['f1']:.4f}")
# Matrice de confusion
cm = confusion_matrix(y_true, y_pred)
print(f"\n"Matrice de confusion :")
print(cm)
# Courbe ROC (si les prédictions de probabilité sont disponibles)
if y_prob is not None and len(np.unique(y_true)) == 2:
fpr, tpr, thresholds = roc_curve(y_true, y_prob[:, 1])
roc_auc = auc(fpr, tpr)
results['roc_auc'] = roc_auc
# Tracer la courbe ROC
plt.figure(figsize=(8, 6))
plt.plot(fpr, tpr, color='darkorange', lw=2,
label=f'Courbe ROC (AUC = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('Taux de faux positifs')
plt.ylabel('Taux de vrais positifs')
plt.title(f'Courbe ROC de {model_name}')
plt.legend(loc="lower right")
plt.grid(True)
plt.show()
self.evaluation_results[model_name] = results
return results
def evaluate_regression(self, y_true, y_pred, model_name="Modèle"):
"""Évaluer le modèle de régression"""
results = {}
# Métriques de base
mse = np.mean((y_true - y_pred) ** 2)
rmse = np.sqrt(mse)
mae = np.mean(np.abs(y_true - y_pred))
# Score R²
ss_res = np.sum((y_true - y_pred) ** 2)
ss_tot = np.sum((y_true - np.mean(y_true)) ** 2)
r2 = 1 - (ss_res / ss_tot)
results['mse'] = mse
results['rmse'] = rmse
results['mae'] = mae
results['r2'] = r2
print(f"\n"{model_name} Résultats de l'évaluation de la régression :")
print(f"Erreur quadratique moyenne (MSE) : {mse:.4f}")
print(f"Racine de l'erreur quadratique moyenne (RMSE) : {rmse:.4f}")
print(f"Erreur absolue moyenne (MAE) : {mae:.4f}")
print(f"Score R² : {r2:.4f}")
# Tracer les valeurs prédites par rapport aux valeurs réelles
plt.figure(figsize=(8, 6))
plt.scatter(y_true, y_pred, alpha=0.6)
plt.plot([y_true.min(), y_true.max()], [y_true.min(), y_true.max()],
'r--', lw=2)
plt.xlabel('Valeurs réelles')
plt.ylabel('Valeurs prédites')
plt.title(f'{model_name} Valeurs prédites vs. valeurs réelles')
plt.grid(True)
plt.show()
self.evaluation_results[model_name] = results
return results
def compare_models(self):
"""Comparer tous les modèles évalués"""
if not self.evaluation_results:
print("Aucun résultat comparable d'évaluation de modèle")
return
print("\n"Comparaison des modèles :")
print("-" * 50)
# Créer un tableau de comparaison
comparison_data = []
for model_name, results in self.evaluation_results.items():
row = [model_name]
for metric, value in results.items():
row.append(f"{value:.4f}")
comparison_data.append(row)
# Afficher le tableau
headers = ["Nom du modèle"] + list(self.evaluation_results.values())[0].keys()
print("\t".join(headers))
for row in comparison_data:
print("\t".join(row))
# Exemple d'utilisation
evaluator = ModelEvaluator()
# Évaluer le modèle de classification
y_pred_class = best_model.predict(X_test)
y_prob_class = best_model.predict_proba(X_test)
evaluator.evaluate_classification(y_test, y_pred_class, y_prob_class, "Meilleur modèle de classification")
# Comparer tous les modèles
evaluator.compare_models()
Phase 6 : Déploiement du modèle
Stratégie de déploiement
Le déploiement de modèle est le processus consistant à mettre un modèle en utilisation pratique, tout comme la mise sur le marché d'un produit développé.
Méthodes de déploiement
- Prédiction par lots: traiter périodiquement de grandes quantités de données
- Prédiction en temps réel: service en ligne, réponse instantanée
- Déploiement embarqué: intégrer le modèle dans les systèmes existants
- Déploiement en périphérie: exécuter le modèle sur les appareils
Exemple de déploiement de modèle
Exemple
import pickle
import json
from datetime import datetime
class ModelDeployer:
def __init__(self):
self.deployed_models = {}
self.deployment_logs = []
def save_model(self, model, model_name, filepath=Aucune):
"""Enregistrer le modèle"""
if filepath is None:
filepath = f"{model_name}.pkl"
with open(filepath, 'wb') as f:
pickle.dump(model, f)
print(f"Modèle {model_name} enregistré dans {filepath}")
# Enregistrer le journal de déploiement
log_entry = {
'timestamp': datetime.now().isoformat(),
'action': 'save_model',
'model_name': model_name,
'filepath': filepath
}
self.deployment_logs.append(log_entry)
return filepath
def load_model(self, model_name, filepath):
"""Charger le modèle"""
with open(filepath, 'rb') as f:
model = pickle.load(f)
self.deployed_models[model_name] = model
print(f"Modèle {model_name} chargé depuis {filepath}")
# Enregistrer le journal de déploiement
log_entry = {
'timestamp': datetime.now().isoformat(),
'action': 'load_model',
'model_name': model_name,
'filepath': filepath
}
self.deployment_logs.append(log_entry)
return model
def create_prediction_service(self, model_name, encoders=None, scaler=None):
"""Créer le service de prédiction"""
if model_name not in self.deployed_models:
raise ValueError(f"Le modèle {model_name} n'est pas déployé")
model = self.deployed_models[model_name]
def predict_service(input_data):
"""Fonction de service de prédiction"""
try:
# Prétraitement des données
if encoders:
for col, encoder in encoders.items():
if col in input_data.columns:
input_data[col] = encoder.transform(input_data[col])
if scaler:
numeric_cols = input_data.select_dtypes(include=['number']).columns
input_data[numeric_cols] = scaler.transform(input_data[numeric_cols])
# Prédiction
prediction = model.predict(input_data)
# S'il s'agit d'un modèle de classification, renvoyer également les probabilités
if hasattr(model, 'predict_proba'):
probability = model.predict_proba(input_data)
return {
'prediction': prediction.tolist(),
'probability': probability.tolist(),
'status': 'success',
'timestamp': datetime.now().isoformat()
}
else:
return {
'prediction': prediction.tolist(),
'status': 'success',
'timestamp': datetime.now().isoformat()
}
except Exception as e:
return {
'error': str(e),
'status': 'error',
'timestamp': datetime.now().isoformat()
}
# Enregistrer le journal de création du service
log_entry = {
'timestamp': datetime.now().isoformat(),
'action': 'create_service',
'model_name': model_name
}
self.deployment_logs.append(log_entry)
return predict_service
def monitor_model(self, model_name, input_data, true_labels=Aucune):
"""Surveiller les performances du modèle"""
if model_name not in self.deployed_models:
raise ValueError(f"Le modèle {model_name} n'est pas déployé")
predict_service = self.create_prediction_service(model_name)
# Obtenir les résultats de prédiction
result = predict_service(input_data)
# Informations de surveillance
monitoring_info = {
'timestamp': datetime.now().isoformat(),
'model_name': model_name,
'input_shape': input_data.shape,
'prediction_count': len(result.get('prediction', [])),
'status': result.get('status', 'unknown')
}
# Si les vraies étiquettes sont disponibles, calculer les métriques de performance
if true_labels is not None and 'prediction' in result:
predictions = result['prediction']
if len(predictions) == len(true_labels):
accuracy = accuracy_score(true_labels, predictions)
monitoring_info['accuracy'] = accuracy
print("Informations de surveillance du modèle :")
for key, value in monitoring_info.items():
print(f" {key}: {value}")
return monitoring_info
def get_deployment_logs(self):
"""Obtenir les journaux de déploiement"""
return self.deployment_logs
# Exemple d'utilisation
deployer = ModelDeployer()
# Enregistrer le meilleur modèle
model_path = deployer.save_model(best_model, "best_classification_model")
# Charger le modèle
deployer.load_model("best_classification_model", model_path)
# Créer le service de prédiction
prediction_service = deployer.create_prediction_service(
"best_classification_model", encoders, scaler
)
# Utiliser le service de prédiction
test_input = X_test.head(5)
prediction_result = prediction_service(test_input)
print("\n"Résultats de prédiction :")
print(json.dumps(prediction_result, indent=2, ensure_ascii=False))
# Surveiller le modèle
deployer.monitor_model("best_classification_model", test_input, y_test.head(5).values)
Exemple complet de workflow
Exemple
class MLProjectPipeline:
def __init__(self):
self.data_collector = DataCollector()
self.data_preparer = None
self.model_trainer = ModelTrainer()
self.model_evaluator = ModelEvaluator()
self.model_deployer = ModelDeployer()
def run_complete_pipeline(self, target_column):
"""Exécuter le pipeline complet d'apprentissage automatique"""
print("=" * 60)
print("Flux de travail complet d'un projet d'apprentissage automatique")
print("=" * 60)
# 1. Collecte de données
print("\nÉtape 1 : Collecte de données")
print("-" * 30)
user_data = self.data_collector.collect_user_data(1000)
behavior_data = self.data_collector.collect_behavior_data(5000)
# Fusionner les données (exemple simplifié)
merged_data = pd.merge(user_data, behavior_data, on='user_id', how='inner')
# Créer la variable cible (exemple : achat ou non)
merged_data['purchased'] = (merged_data['behavior_type'] == 'Purchase').astype(int)
# 2. Préparation des données
print("\nÉtape 2 : Préparation des données")
print("-" * 30)
# Sélectionner les colonnes de caractéristiques
feature_columns = ['age', 'gender', 'city', 'duration']
if all(col in merged_data.columns for col in feature_columns):
data_for_ml = merged_data[feature_columns + ['purchased']].copy()
# Gérer les variables catégorielles
data_for_ml['gender'] = data_for_ml['gender'].map({'Male': 0, 'Female': 1})
data_for_ml['city'] = data_for_ml['city'].map({'Beijing': 0, 'Shanghai': 1, 'Guangzhou': 2})
# Préparation des données
self.data_preparer = DataPreparer(data_for_ml)
splits, encoders, scaler = self.data_preparer.prepare_pipeline('purchased')
# 3. Entraînement du modèle
print("\nÉtape 3 : Entraînement du modèle")
print("-" * 30)
# Enregistrer le modèle
self.model_trainer.register_model(
'Régression logistique', LogisticRegression(random_state=42), 'classification'
)
self.model_trainer.register_model(
'Forêt aléatoire', RandomForestClassifier(n_estimators=100, random_state=42), 'classification'
)
# Entraîner le modèle
trained_models = self.model_trainer.train_all_models(
splits['X_train'], splits['y_train']
)
# 4. Évaluation du modèle
print("\nÉtape 4 : Évaluation du modèle")
print("-" * 30)
results = self.model_trainer.evaluate_models(
splits['X_test'], splits['y_test']
)
best_name, best_model = self.model_trainer.get_best_model(results)
# 5. Déploiement du modèle
print("\nÉtape 5 : Déploiement du modèle")
print("-" * 30)
# Enregistrer le modèle
model_path = self.model_deployer.save_model(best_model, "production_model")
# Créer le service de prédiction
prediction_service = self.model_deployer.create_prediction_service(
"production_model"
)
# Test du service de prédiction
test_input = splits['X_test'].head(3)
prediction_result = prediction_service(test_input)
print("\nRésultat du test du service de prédiction :")
print(json.dumps(prediction_result, indent=2, ensure_ascii=False))
print("\n" + "=" * 60)
print("Workflow du projet d'apprentissage automatique terminé !")
print("=" * 60)
return {
'data': data_for_ml,
'splits': splits,
'best_model': best_model,
'best_model_name': best_name,
'evaluation_results': results,
'prediction_service': prediction_service
}
else:
print("Les colonnes de données sont incomplètes, impossible de poursuivre le workflow")
return None
# Exécuter le workflow complet
pipeline = MLProjectPipeline()
project_results = pipeline.run_complete_pipeline('purchased')