Raisonnement probabiliste
Imaginez que vous appreniez à un ami à reconnaître des photos de chats et de chiens. Vous ne diriez pas : « Cette image est à 100 % un chat » ; au lieu de cela, vous pourriez dire : « Cette image a 90 % de chances d'être un chat, parce qu'elle a des oreilles pointues et des moustaches. » Cette expression de vraisemblance est précisémentle cœur de la pensée probabiliste.
Dans le monde réel, les données traitées par les modèles d'apprentissage automatique sont presque toujours remplies d'incertitude: les images peuvent être floues, la parole peut contenir du bruit et le comportement des utilisateurs est difficile à prédire. Les probabilités nous fournissent un langage mathématique rigoureux pour décrire, quantifier et gérer cette incertitude. Elles ne sont pas seulement le fondement de modèles avancés (tels que les réseaux bayésiens et les processus gaussiens), mais aussi la clé pour comprendre les sorties des modèles, évaluer la confiance des prédictions et prendre des décisions robustes.
En bref,la pensée probabiliste est lepont qui transformeles suppositionsen une confiance quantifiable,et c'est une étape importante pour que l'apprentissage automatique passe derègles codées en durversun raisonnement intelligent.
Introduction rapide aux concepts fondamentaux des probabilités
Avant de plonger dans les applications d'apprentissage automatique, nous devons établir quelques concepts fondamentaux de probabilité.
1. Qu'est-ce que la probabilité ?
La probabilitéest une mesure de la vraisemblance qu'un événement se produise, allant de 0 à 1.
P(A) = 0: L'événement Ane peut passe produire.P(A) = 1: L'événement Ase produira certainement.0 < P(A) < 1: L'événement A se produit avec une certaineprobabilité.
En apprentissage automatique, un événement pourrait être : cette image est un chat, l'utilisateur cliquera sur cette publicité demain, le prochain mot est"hello"。
2. Probabilité conditionnelle : Le monde est interconnecté
Probabilité conditionnelle P(A|B)désigne la probabilité que l'événement A se produise, étant donné que l'événement Bs'est déjà produit. C'est un concept crucial en apprentissage automatique.
Une analogie parlante:
P(下雨): La probabilité générale de pluie aujourd'hui (probabilité a priori).P(下雨 | 乌云密布): La probabilité de pluie aujourd'hui, étant donné que "des nuages sombres s'accumulent" a déjà été constaté (probabilité a posteriori). De toute évidence, la valeur de cette dernière probabilité est plus élevée.
Formule:
P(A|B) = P(A 且 B) / P(B), nécessitantP(B) > 0。
3. Théorème de Bayes : Inférer les causes à partir des résultats
Le théorème de Bayes est une élégante application de la probabilité conditionnelle ; il nous apprend à utiliserde nouvelles preuves (données) pour mettre à jour notre croyance en une hypothèse。
Formule:
P(假设 | 数据) = [ P(数据 | 假设) * P(假设) ] / P(数据)
Décomposons cette "formule magique".:
P(假设):Probabilité a priori. Avant de voir la moindre donnée, c'est notre croyance initiale au sujet de l'hypothèse.- Par exemple : avant de recevoir un e-mail, nous pensons que la probabilité qu'un e-mail soit un spam est de 30%.
P(数据 | 假设):Vraisemblance. Si l'hypothèse est vraie, quelle est la probabilité que nous observions le lot de données actuel ?- Par exemple : si un e-mail est effectivement un spam, quelle est la probabilité que des mots comme « gratuit » et « gagnant » y apparaissent ?
P(数据):Évidence. La probabilité globale d'observer les données actuelles, généralement une constante de normalisation.P(假设 | 数据):Probabilité a posteriori. Après avoir observé les données, c'est notre croyance mise à jour au sujet de l'hypothèse.C'est le but que nous recherchons en fin de compte !- Par exemple : après avoir vu que l'e-mail contient des mots comme « gratuit » et « gagnant », la probabilité mise à jour que cet e-mail soit un spam est de 95%.
L'essence du théorème de Bayes: il fournit un cadre systématique qui combine nosconnaissances a priori(P(假设)) avecdes données observées(P(数据|假设)) pour obtenir une compréhensionmise à jour plus précise.(P(假设|数据))。
Partie 2 : Les trois rôles de la probabilité dans l'apprentissage automatique
La pensée probabiliste imprègne chaque étape de l'apprentissage automatique, jouant principalement les trois rôles suivants :
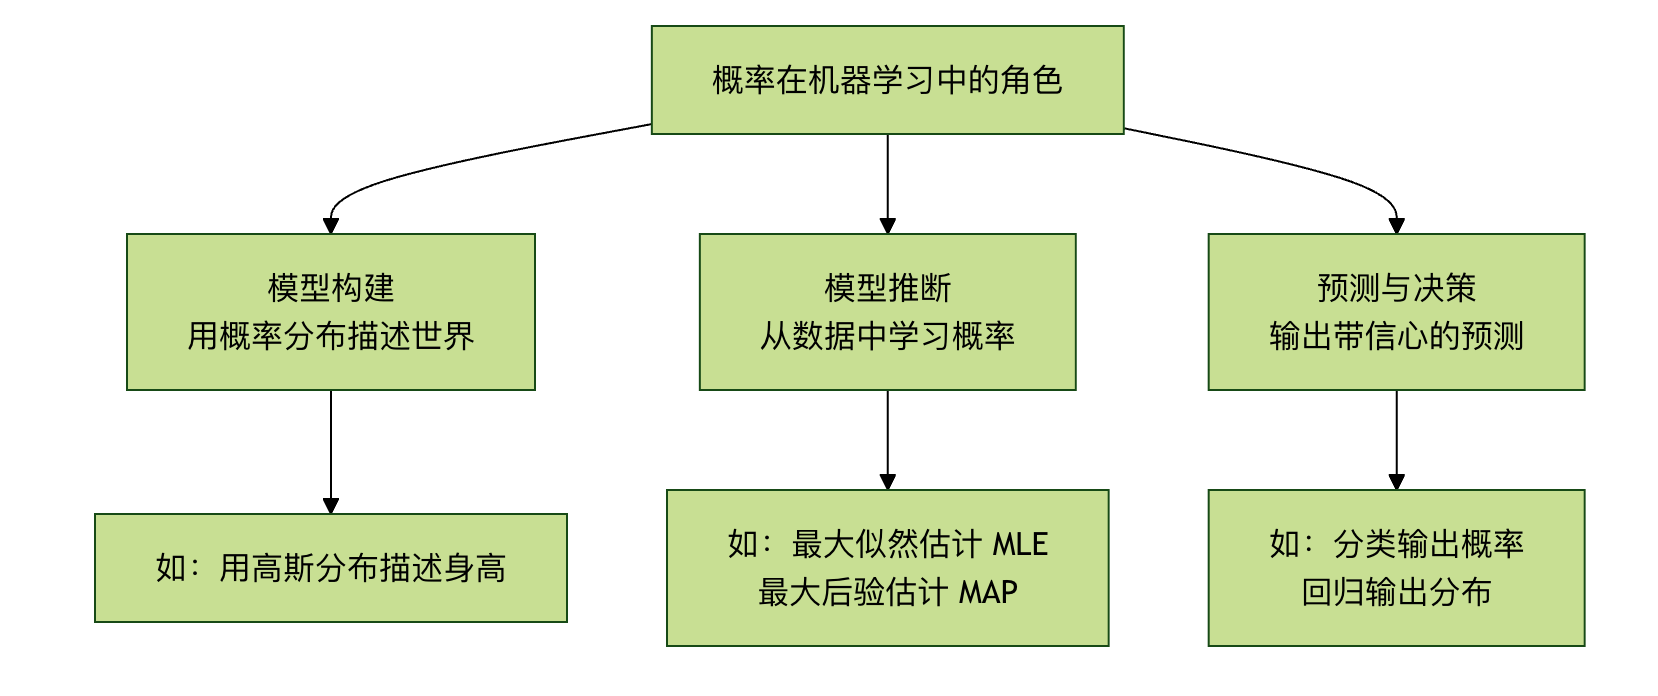
Rôle 1 : Construction du modèle — Décrire le monde avec des probabilités
De nombreux modèles d'apprentissage automatique sont essentiellementdes modèles probabilistes. Nous supposons que les données observées sont générées par une certaine distribution de probabilité sous-jacente.
Exemple 1 : Régression logistiqueIl produit directement une valeur de probabilité. Pour un problème de classification binaire (chat/chien), le modèle de régression logistique ne se contente pas de dire "ceci est un chat" ; à la place, il produitP(类别=猫 | 图像数据)=0.9, ce qui indique que le modèle a 90% de confiance qu'il s'agit d'un chat.
Exemple 2 : Classificateur bayésien naïfIl applique directement le théorème de Bayes pour la classification. Il suppose que les caractéristiques sont indépendantes les unes des autres et calculeP(垃圾邮件 | 词1, 词2...), puis sélectionne la catégorie avec la probabilité la plus élevée.
Exemple
# Supposons que nous ayons estimé les probabilités suivantes à partir des données (vraisemblances et probabilités a priori)
P_word_given_spam= {"free": 0.8, "meeting": 0.1} # La probabilité que "free" apparaisse dans le spam
P_word_given_normal= {"free": 0.1, "meeting": 0.9} # La probabilité que "meeting" apparaisse dans les e-mails normaux
P_garbage= 0.3 # Probabilité a priori : la probabilité qu'un e-mail quelconque soit un spam
P_normal= 0.7 # Probabilité a priori : la probabilité qu'un e-mail quelconque soit normal
# Pour un e-mail contenant "free" et "meeting", calculer la probabilité a posteriori qu'il s'agisse d'un spam (calcul simplifié)
# D'après le théorème de Bayes (ignorer le dénominateur de l'évidence, car il s'annule lors de la comparaison)
score_spam=P_word_given_spam["free"]* P_word_given_spam["meeting"]* P_spam
score_normal=P_word_given_normal["free"]* P_word_given_normal["meeting"]* P_normal
print(f"Score de spam : {score_垃圾:.4f}")
print(fScore d'e-mail normal : {score_normal:.4f})
ifscore_spam>score_normal:
print("Prédiction : Ceci est un e-mail spam.")
else:
print(« Prédiction : Ceci est un e-mail normal. »)
Rôle 2 : Inférence et apprentissage du modèle — Trouver l'explication la plus probable
Comment trouver, à partir des données, le modèle probabiliste le plus susceptible d'avoir généré ces données (c'est-à-dire apprendre les paramètres du modèle) ? Voici deux idées clés :
1. Estimation par maximum de vraisemblance Idée centrale: Trouver les paramètres du modèle qui maximisent laprobabilité d'observer les données actuelles(la vraisemblance).Analogie: Un détective résolvant une affaire. Le détective demande : « Selon quel mobile et quelle méthode serait-il le plus probable de produire toutes les traces de scène de crime que nous voyons actuellement ? » L'EMV consiste exactement à trouver cette hypothèse « la plus probable ».Avantages: Fondée sur les données, s'appuyant complètement sur les données.Inconvénients potentiels: Si la quantité de données est faible, il peut surapprendre ; il ignore les connaissances a priori.
2. Estimation du maximum a posteriori
Idée centrale: En s'appuyant sur le maximum de vraisemblance, elle intègre notreconnaissance a priori des paramètres(P(假设)), et trouve les paramètres qui maximisent la probabilité a posteriori.Analogie: Un détective expérimenté résolvant une affaire. Il n'examine pas seulement les traces de la scène de crime (données), mais combine aussi le mode opératoire connu du suspect (a priori) pour porter un jugement global.Avantages: Elle peut tirer parti des connaissances du domaine, est plus robuste sur de petits ensembles de données et évite le surapprentissage.
| Critère | Nom complet | Objectif d'optimisation | Idée centrale | Analogie parlante |
|---|---|---|---|---|
| EMV | Estimation du maximum de vraisemblance | Maximiser P(données | paramètres) | Guidé par les données : Étant donné les données observées, trouvez les paramètres du modèle les plus susceptibles d'avoir généré ces données. | Détective résolvant une affaire : identifier un suspect uniquement à partir des preuves de la scène de crime |
| MAP | Estimation du maximum a posteriori | Maximiser P(paramètres | données) | A priori + données : Combinez les connaissances a priori et les données observées, calculez la probabilité a posteriori des paramètres et prenez le maximum | Juge décidant d'une affaire : rendre un jugement sur la base des dispositions légales (a priori) et des preuves (données) |
Rôle 3 : Prédiction et prise de décision — Produire des réponses avec confiance
Un bon modèle ne devrait pas seulement donner des prédictions, mais aussi fournirl'incertitude des prédictions。
- Tâches de classification: Produire la probabilité de chaque catégorie (par ex., chat : 0.85, chien : 0.12, lapin : 0.03). Cela contient plus d'informations que de simplement produire « chat ». Nous pouvons prendre des décisions en fonction de seuils de probabilité (par ex., n'adopter que lorsque la probabilité la plus élevée est > 0.8).
- Tâches de régression: Les modèles de régression avancés (tels que la régression probabiliste, la régression linéaire bayésienne) peuvent prédire unedistribution(comme une distribution gaussienne), plutôt qu'une simple estimation ponctuelle. Il vous dira : « Le prix prédit est de 1 million yuan, et il y a 95% de confiance que le vrai prix se situe entre 950,000 et 1,050,000 yuan. »
Partie 3 : Mise en pratique — Résoudre un problème simple avec une pensée probabiliste
Scénario: Un test de maladie simple. Étant donné :
- La prévalence de la maladie dans la population générale (probabilité a priori)
P(病) = 0.001。 - La précision du test : si la personne est réellement malade, la probabilité d’obtenir un résultat positif
P(阳|病) = 0.99(sensibilité). Si la personne n’est pas malade, la probabilité d’obtenir un résultat négatifP(阴|健康) = 0.99(spécificité). - Question: Si une personne obtient un résultat positif, la probabilité qu’elle ait réellement la maladie
P(病|阳)quelle est-elle ?
Le piège de l’intuition: Beaucoup de gens penseraient qu’elle est aussi élevée que 99 %. Utilisons le théorème de Bayes pour calculer.
Exemple
P_disease = 0.001 # P(maladie)
P_positive_given_disease = 0.99 # P(positif|maladie)
P_negative_given_healthy = 0.99 # P(négatif|sain)
# Calculer les probabilités dérivées
P_healthy = 1 - P_disease # P(sain)
P_positive_given_healthy = 1 - P_negative_given_healthy # P(positif|sain) = 1 - spécificité
# Calculer la probabilité totale P(positif)
# P(positif) = P(positif|maladie)*P(maladie) + P(positif|sain)*P(sain)
P_positive = (P_positive_given_disease * P_disease) + (P_positive_given_healthy * P_healthy)
# Appliquer le théorème de Bayes pour calculer P(maladie|positif)
P_disease_given_positive = (P_positive_given_disease * P_disease) / P_positive
print(f"Même si le test est positif, la probabilité a posteriori d'avoir réellement la maladie P(maladie|positif) n'est que de : {P_disease_given_positive:.2%}")
Résultats d'exécution et réflexion:
Vous serez surpris de constater queP(病|阳)il n'est que d'environ9%! En effet, la prévalence de la maladie est très faible (faible probabilité a priori), ce qui entraîne bien plus de faux positifs que de vrais positifs. Cet exemple démontre profondément :
- L'importance des connaissances a priori: Ignorer le taux de base peut conduire à de graves erreurs de jugement.
- La puissance du raisonnement bayésien: elle nous oblige à prendre en compte toutes les informations pertinentes (taux de base, précision du test).
- L'aspect pratique de la pensée probabiliste: elle peut corriger les biais systématiques de notre intuition.
Résumé et pistes futures
Principaux enseignements de la pensée probabiliste:
- Acceptez l'incertitude: le monde est incertain, et la sortie des modèles devrait aussi être probabiliste.
- Bayes est une philosophie de la mise à jour: à travers le
Prior + Data -> Posteriorcadre, réviser continuellement la cognition avec de nouvelles preuves. - Les décisions exigent des probabilités: une bonne prédiction devrait être accompagnée d'un « score de confiance » pour soutenir des décisions à risque maîtrisé.
Si vous voulez aller plus loin:
- Niveau théorique: Étudiezles modèles graphiques probabilistes, qui représentent élégamment des dépendances probabilistes complexes entre variables à l'aide de structures de graphe.
- Niveau algorithmique: Explorezl'inférence variationnelleet lesméthodes de Monte-Carlo par chaînes de Markov, qui sont des outils puissants pour résoudre des modèles bayésiens complexes.
- Niveau applicatif: Recherchezl'optimisation bayésienne(pour le réglage des hyperparamètres),les processus gaussiens(pour la régression et l'optimisation), etmodèles génératifs profonds(tels que les autoencodeurs variationnels (VAE), les modèles de diffusion).