Forêt aléatoire
Imaginez que vous participez à une compétition de connaissances importante. Face à un problème difficile, feriez-vous confiance au jugement d'un seul expert de premier plan, ou au résultat du vote de 100 concurrents compétents ? Dans la plupart des cas, la sagesse collective peut compenser les biais et les limites individuels, ce qui conduit à des décisions plus stables et plus précises.
Dans le monde de l'apprentissage automatique,Random Forestest exactement cettesagesse collective,un représentant remarquable de cette idée. En construisant un grand nombre d'arbres de décision et en les faisant voter ensemble pour faire des prédictions, il est devenu l'un des algorithmes d'apprentissage automatique les plus puissants et les plus populaires.
Qu'est-ce que Random Forest ?
La forêt aléatoireest un algorithme d'apprentissage automatique basé sur l'apprentissage ensembliste. Son idée centrale est très simple :Deux têtes valent mieux qu'une.。
- Forêt: désigne plusieursarbres de décision (Decision Tree)formant un ensemble.
- Aléatoire: désigne les deux types d'aléatoire introduits par l'algorithme lors de la construction de chaque arbre de décision, garantissant que chaque arbre est unique.
Enfin, pour les tâches de classification, la forêt utilisele vote (décision majoritaire)pour donner les résultats ; pour les tâches de régression, elle utilisela moyennepour donner les résultats.
Idée centrale : Bagging et aléatoire
Le succès de la forêt aléatoire repose sur deux piliers :
Bagging(Bootstrap Aggregating):
- Bootstrap (échantillonnage bootstrap): à partir du jeu de données d'entraînement d'origine,avec remise,tirer aléatoirement des échantillons pour générer plusieurs sous-ensembles d'entraînement différents. Cela signifie qu'un même échantillon peut apparaître plusieurs fois dans un sous-ensemble, tandis qu'un autre échantillon peut ne pas apparaître du tout.
- Agrégation: utiliser chaque sous-ensemble pour entraîner indépendamment un arbre de décision, puis agréger les résultats de tous les arbres (vote ou moyenne).
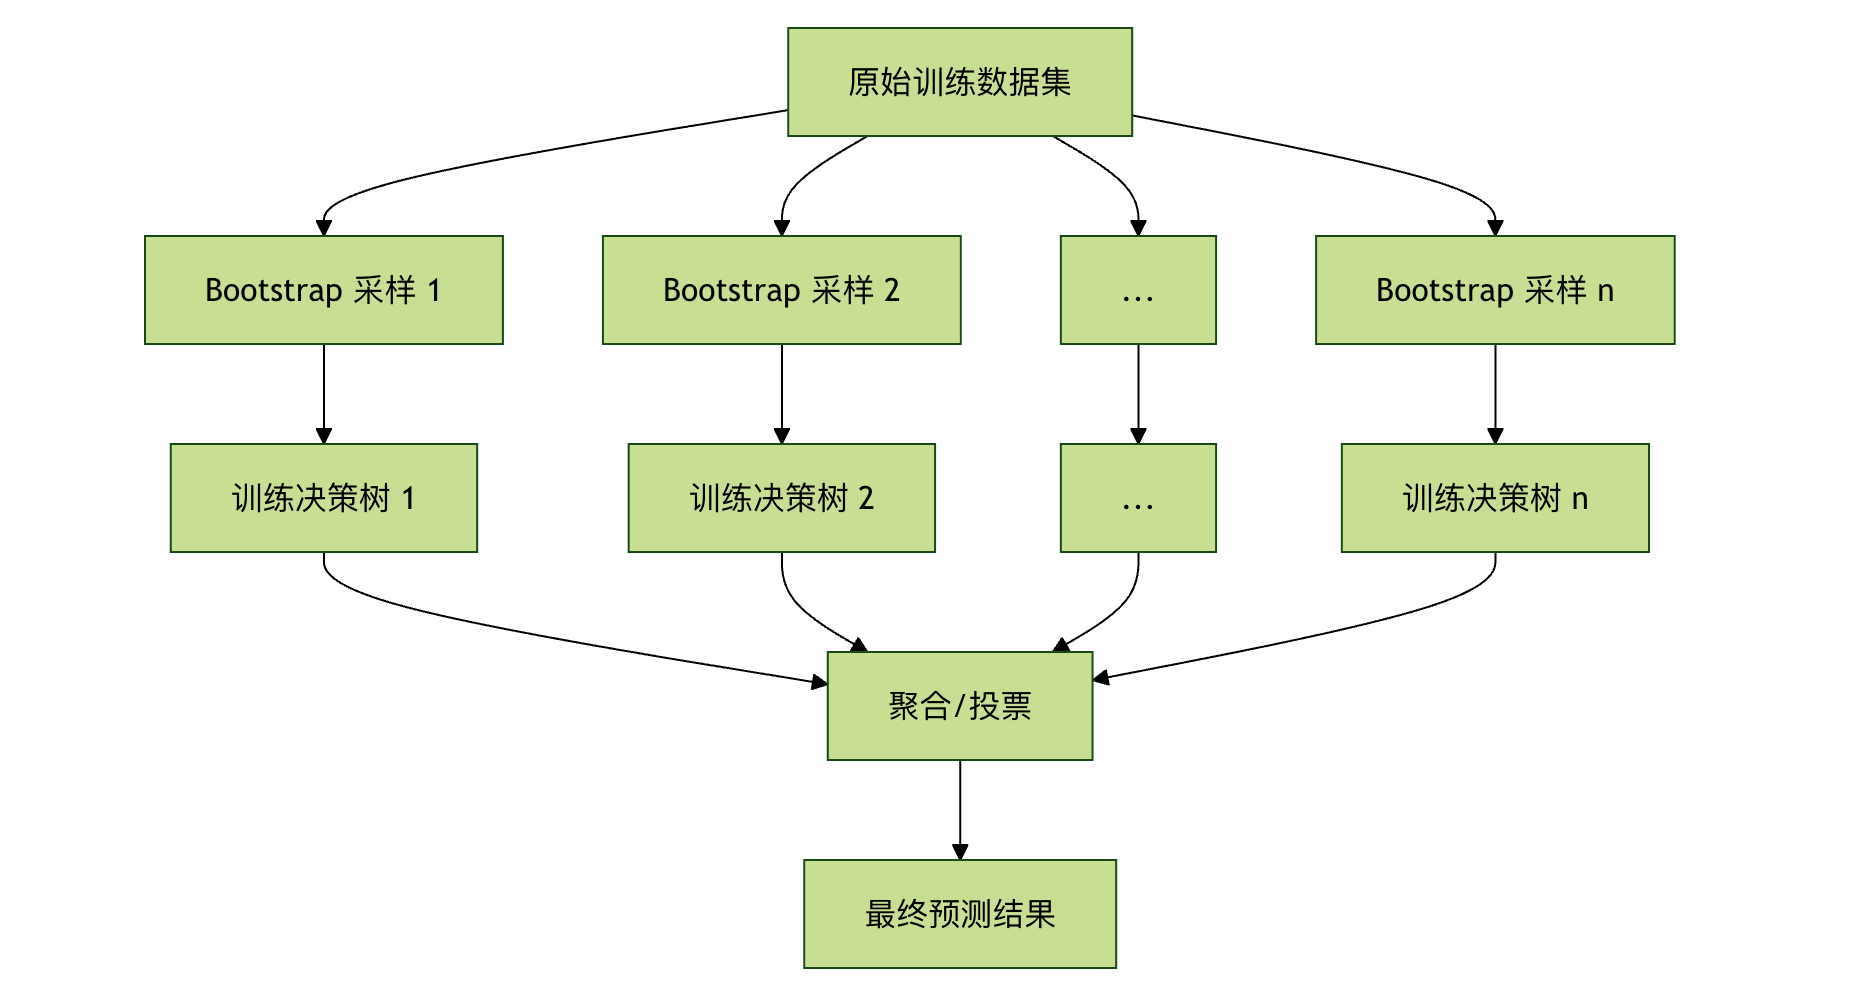
Aléatoire des caractéristiques:
- Lors de la division de chaque nœud de chaque arbre, l'algorithme ne considère pas toutes les caractéristiques, mais sélectionne plutôtaléatoirement un sous-ensemble parmi toutes les caractéristiques, puis sélectionne la caractéristique de division optimale dans ce sous-ensemble.
- Cela renforce encore la diversité entre les arbres, permettant à la forêt de voir différents aspects du problème.
En termes simples, la forêt aléatoire crée uncomité diversifié d'experts。. Même si certains arbres se trompent, les autres arbres corrects peuvent les corriger via le vote, obtenant ainsi des performances plus stables et plus puissantes qu'un seul arbre de décision.
Flux de travail de l'algorithme et paramètres clés
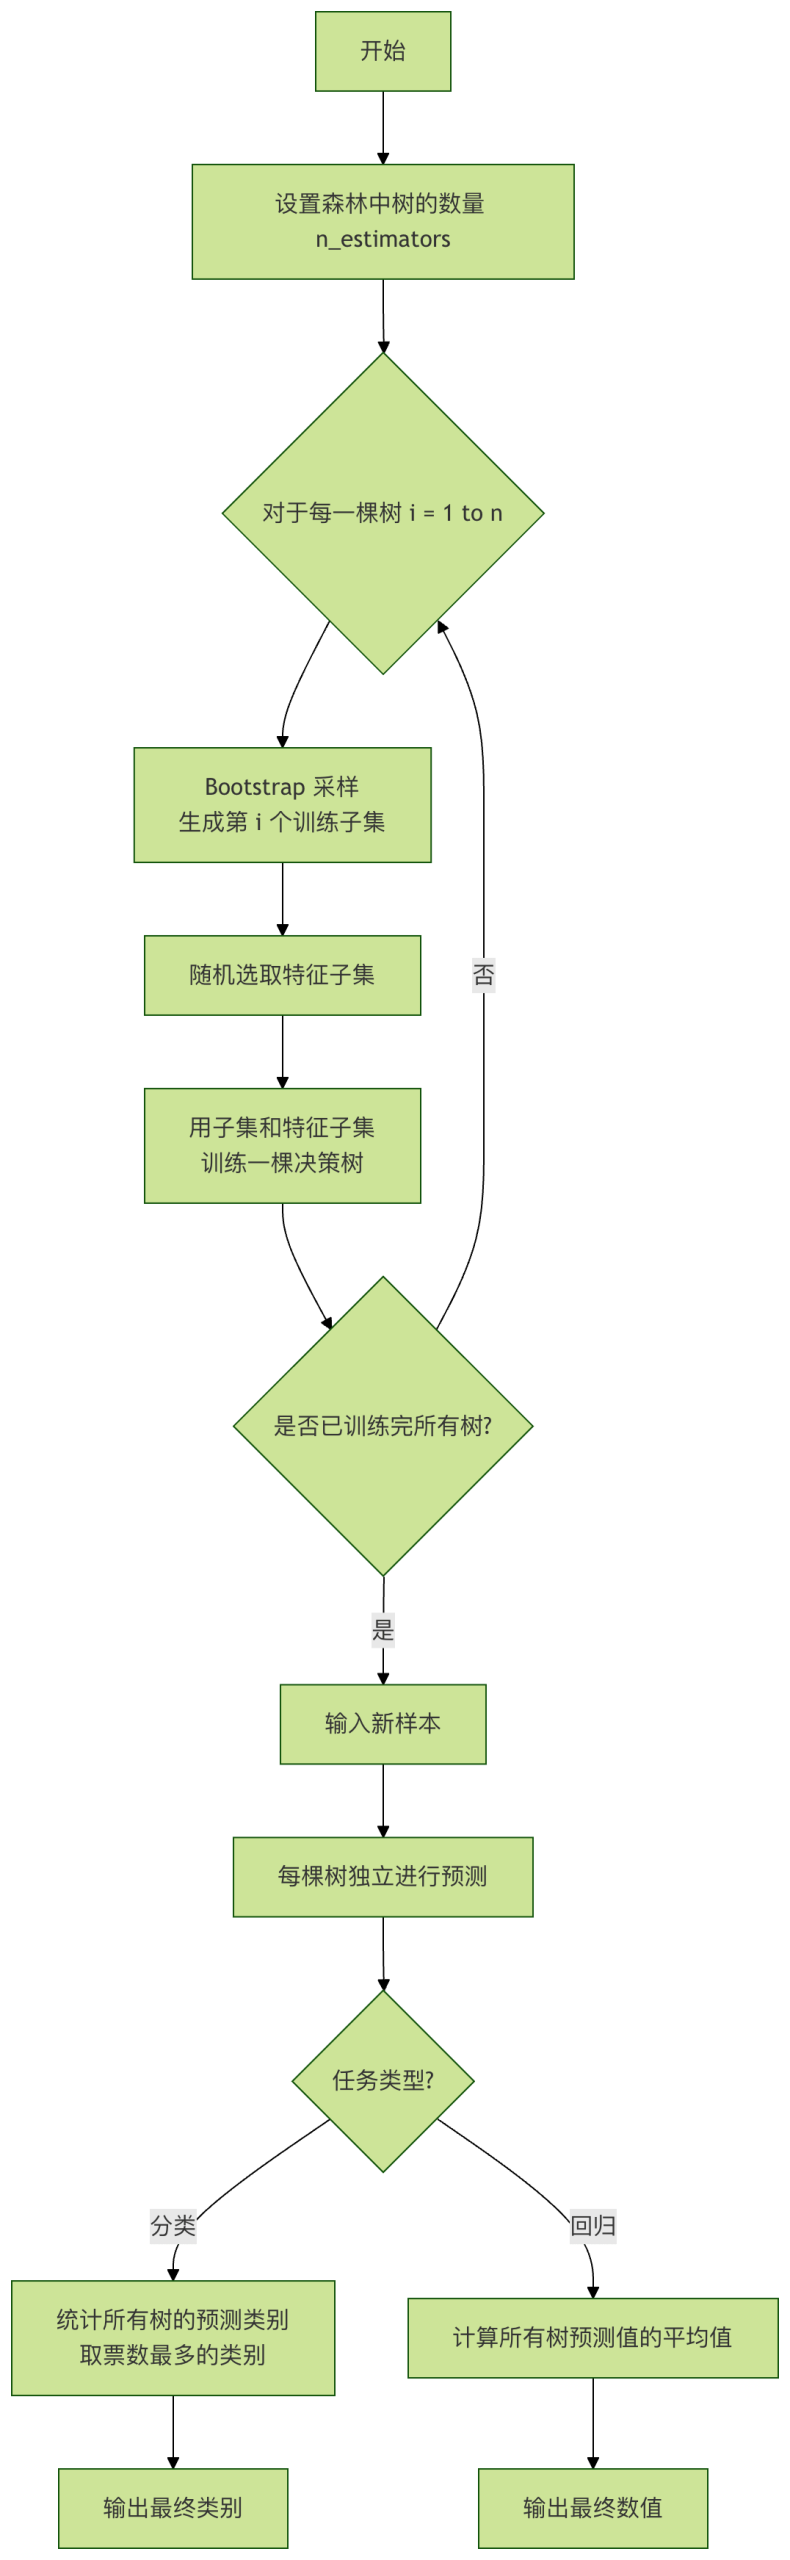
Fonctionnement de la forêt aléatoire
Voyons clairement son processus de fonctionnement à travers un organigramme :
Explication détaillée des hyperparamètres clés
Lors de l'utilisation de lascikit-learnbibliothèque, il est crucial de comprendre les paramètres essentiels suivants :
| Nom du paramètre | Signification | Valeur typique / Impact | Explication simple |
|---|---|---|---|
n_estimators |
Le nombre d'arbres de décision dans la forêt. | La valeur par défaut est 100. Plus la valeur est grande, plus le modèle est généralement stable et plus les performances sont bonnes, mais plus le coût de calcul est élevé. | "Le nombre de membres du comité". Plus il y a de personnes, plus la décision est généralement fiable, mais plus la réunion dure longtemps. |
max_depth |
La profondeur maximale d'un arbre de décision unique. | DefaultNone(aucune limite). Limiter la profondeur peut éviter le surapprentissage et rendre le modèle plus simple. |
"Limiter le temps de parole de chaque personne". Empêche un expert (arbre) de trop réfléchir et d'accorder une attention excessive aux détails des données d'entraînement. |
max_features |
Le nombre de caractéristiques à considérer lors de la recherche de la meilleure division. | Peut être un entier, un flottant, ou'auto'/'sqrt'. C'est le paramètre clé qui introduit le "caractère aléatoire des caractéristiques". |
"Examiner aléatoirement seulement quelques aspects dans chaque discussion". Garantit que chaque arbre analyse le problème sous différents angles, ce qui augmente la diversité. |
min_samples_split |
Le nombre minimum d'échantillons requis pour une division de nœud. | La valeur par défaut est 2. Plus la valeur est grande, plus la croissance de l'arbre est prudente et moins il est susceptible de surapprendre. | "Un groupe doit compter au moins quelques personnes pour poursuivre une discussion de groupe". Évite de créer une nouvelle règle à cause d'un ou deux échantillons. |
min_samples_leaf |
Le nombre minimum d'échantillons requis pour un nœud feuille. | La valeur par défaut est 1. Plus la valeur est grande, plus le modèle est lisse. | "La conclusion finale doit être fondée sur au moins quelques cas". Garantit que chaque conclusion dispose d'un support de données suffisant. |
bootstrap |
Indique s'il faut utiliser l'échantillonnage Bootstrap. | DefaultTrue. Si défini surFalse, alors l'ensemble du jeu de données sera utilisé pour entraîner chaque arbre, mais une certaine part d'aléatoire sera perdue. |
"Autoriser une personne à parler de façon répétée". L'activer est l'essence du Bagging. |
Pratique - Exemples de code
Mettons-le en pratique avec le jeu de données classique de classification Iris.
Exemple 1 : Tâche de classification de base
Exemple
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, classification_report
# 1. Charger les données
iris = load_iris()
X = iris.data # Caractéristiques : longueur du sépale, largeur du sépale, longueur du pétale, largeur du pétale
y = iris.target # Étiquettes : trois espèces d'iris
# 2. Diviser les ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 3. Créer un classifieur Random Forest
# Ici, nous définissons 100 arbres et limitons la profondeur maximale à 5
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# 4. Entraîner le modèle
rf_clf.fit(X_train, y_train)
# 5. Faire des prédictions sur l'ensemble de test
y_pred = rf_clf.predict(X_test)
# 6. Évaluer la performance du modèle
print("Exactitude sur l'ensemble de test :", accuracy_score(y_test, y_pred))
print("\nRapport de classification :")
print(classification_report(y_test, y_pred, target_names=iris.target_names))
Explication du code :
- Importer les bibliothèques:
RandomForestClassifierest le classifieur Random Forest. - Chargement des données: Le jeu de données Iris contient 150 échantillons, 4 caractéristiques et 3 classes.
- Division des données: Utiliser 70% des données pour l'entraînement et 30% pour le test afin de valider la généralisation du modèle à de nouvelles données.
- Instancier le modèle:
random_state=42Garantir des résultats reproductibles à chaque exécution. - Entraîner le modèle:
fitLa méthode construira 100 arbres de décision. - Prédiction et évaluation: Utilisez la forêt entraînée pour prédire sur l'ensemble de test et calculer des métriques telles que l'exactitude.
Sortie :
      setosa       1.00      1.00      1.00        19
  versicolor       1.00      1.00      1.00        13
   virginica       1.00      1.00      1.00        13

    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45
Exemple 2 : Visualisation de l'importance des caractéristiques
Random Forest dispose également d'une fonctionnalité puissante : évaluer la contribution de chaque caractéristique aux prédictions.
Exemple
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, classification_report
import pandas as pd
import matplotlib.pyplot as plt
# -------------------------- Début de configuration de la police chinoise --------------------------
plt.rcParams['font.sans-serif'] = [
# Priorité Windows
'SimHei', 'Microsoft YaHei',
# Priorité macOS
'PingFang SC', 'Heiti TC',
# Priorité Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corriger le problème d'affichage des signes négatifs sous forme de carrés
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de la configuration de la police chinoise --------------------------
# 1. Charger les données
iris = load_iris()
X = iris.data # Caractéristiques : longueur du sépale, largeur du sépale, longueur du pétale, largeur du pétale
y = iris.target # Étiquettes : trois espèces d'iris
# 2. Diviser les ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 3. Créer un classifieur Random Forest
# Ici, nous définissons 100 arbres et limitons la profondeur maximale à 5
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# 4. Entraîner le modèle
rf_clf.fit(X_train, y_train)
# 5. Faire des prédictions sur l'ensemble de test
y_pred = rf_clf.predict(X_test)
# 6. Évaluer la performance du modèle
print("Exactitude sur l'ensemble de test :", accuracy_score(y_test, y_pred))
print("\nRapport de classification :")
# Obtenir l'importance des caractéristiques
feature_importances = rf_clf.feature_importances_
features = iris.feature_names
# Créer un DataFrame pour faciliter la visualisation
importance_df = pd.DataFrame({
'Feature': features,
'Importance': feature_importances
}).sort_values('Importance', ascending=False)
print("Classement de l'importance des caractéristiques :")
print(importance_df)
# Visualisation
plt.figure(figsize=(8, 5))
plt.barh(importance_df['Feature'], importance_df['Importance'])
plt.xlabel('Importance des caractéristiques')
plt.title('Forêt aléatoire - Importance des caractéristiques')
plt.gca().invert_yaxis() # Faire apparaître les caractéristiques les plus importantes en haut
plt.show()
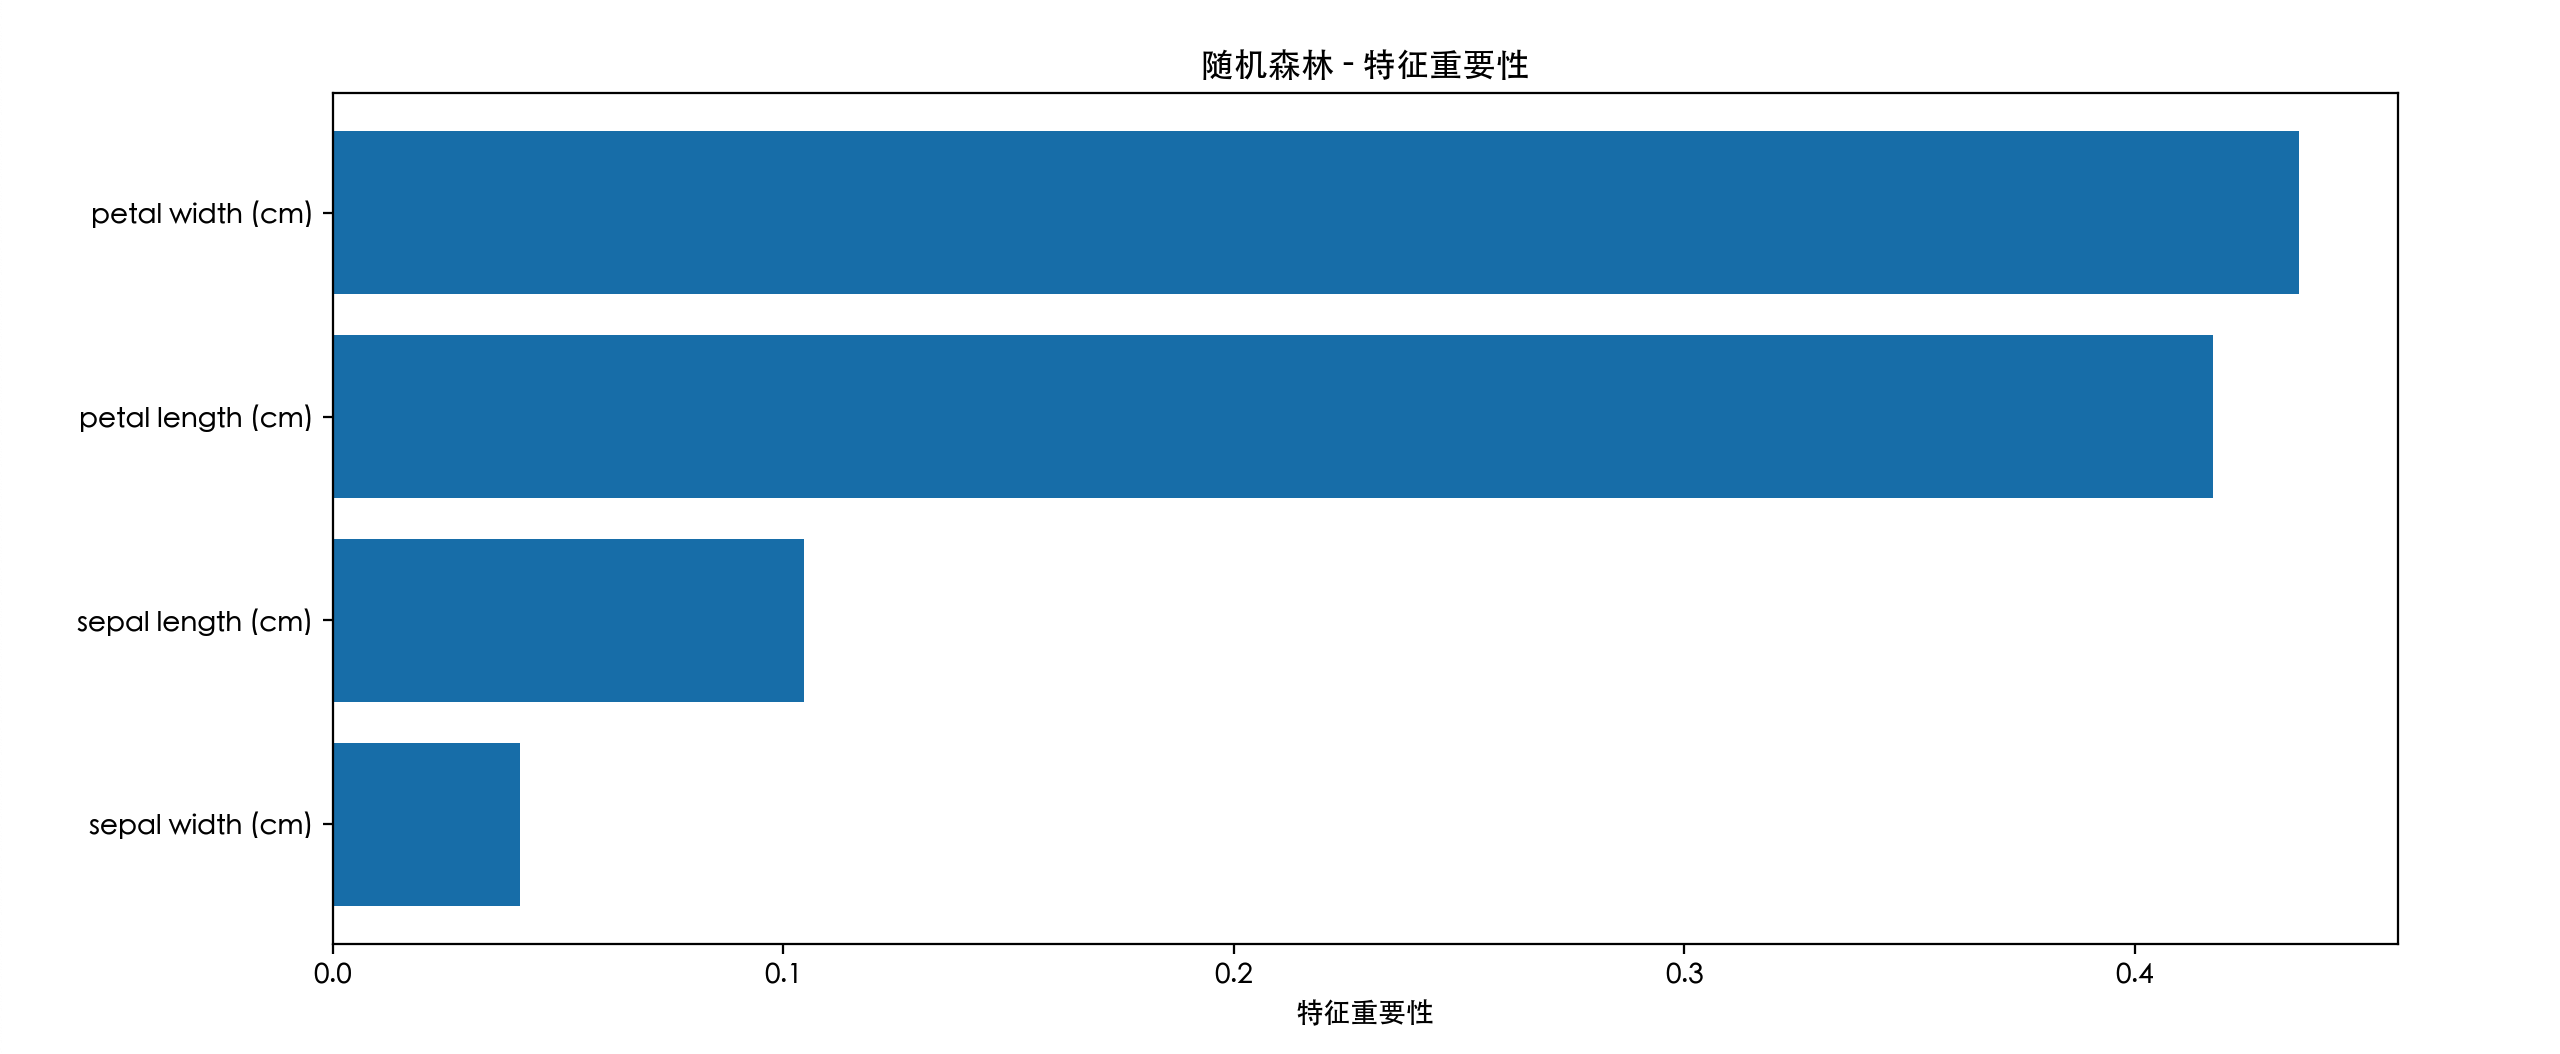
Analyse des résultats:Vous constaterez peut-être que la longueur et la largeur des pétales sont bien plus importantes que les dimensions des sépales. Cela est tout à fait cohérent avec le bon sens botanique ; les caractéristiques des pétales sont en effet la clé pour distinguer les différentes fleurs d'iris.Cette caractéristique est extrêmement précieuse pour la sélection de caractéristiques et la compréhension des données.
Partie 4 : Avantages, inconvénients et scénarios d'application
Avantages
- Haute précision:L'apprentissage d'ensemble peut généralement atteindre des performances de premier ordre sur les données fournies.
- Forte résistance au surapprentissage:Grâce au Bagging et à la sélection aléatoire des caractéristiques, il n'est pas facile de surapprendre même sans élagage.
- Exigences de données souples:Peut gérer des caractéristiques numériques et catégorielles sans nécessiter de mise à l'échelle des caractéristiques (par exemple, la normalisation).
- Fournit l'importance des caractéristiques:L'évaluation intégrée des caractéristiques est un sous-produit précieux.
- Facile à paralléliser:L'entraînement de chaque arbre est indépendant et peut être facilement accéléré en parallèle.
Inconvénients
- Faible interprétabilité du modèle:Une "boîte noire" composée de centaines ou de milliers d'arbres est bien plus difficile à interpréter qu'un seul arbre de décision.
- Lenteur de l'entraînement et de la prédiction:Lorsque le nombre d'arbres est élevé, davantage de ressources informatiques et de temps sont nécessaires.
- Empreinte mémoire importante:Il est nécessaire de stocker toutes les structures d'arbres de la forêt entière.
Scénarios d'application typiques
- Problèmes de classification:Comme la détection de spam, le diagnostic de maladies, la classification d'images.
- Problèmes de régression:Comme la prédiction du prix des maisons, la prévision des ventes.
- Sélection de caractéristiques:Utilisez l'importance des caractéristiques qu'il produit pour filtrer les caractéristiques.
- Gestion des valeurs manquantes:Les forêts aléatoires ont une capacité naturelle à bien gérer les valeurs manquantes.