Дерево решений
Дерево решений — часто используемый алгоритм машинного обучения, широко применяемый для задач классификации и регрессии.
Дерево решений представляет процесс принятия решений в виде древовидной структуры. Каждый внутренний узел представляет проверку признака или атрибута, каждая ветвь представляет результат проверки, а каждый листовой узел представляет класс или значение.
Основные понятия дерева решений
- Узел: Каждая точка в дереве называется узлом. Корневой узел — это начальная точка дерева, внутренние узлы — это точки принятия решений, а листовые узлы — окончательные результаты решения.
- Ветвь: Путь от одного узла к другому называется ветвью.
- Разделение: Процесс разделения набора данных на несколько подмножеств на основе определённого признака.
- Чистота: Измеряет, согласованы ли классы образцов в подмножестве. Чем выше чистота, тем более похожи образцы в подмножестве.
Как работают деревья решений
Дерево решений строит древовидную структуру путём рекурсивного разделения набора данных на меньшие подмножества. Конкретные шаги следующие:
- Выбор лучшего признака: Выберите лучший признак для разделения на основе определённых критериев (таких как прирост информации, индекс Джини и т.д.).
- Разделение набора данных: Разделите набор данных на несколько подмножеств на основе выбранного признака.
- Рекурсивное построение поддеревьев: Повторяйте описанный выше процесс для каждого подмножества, пока не будет достигнуто условие остановки (например, все образцы принадлежат одному классу, достигнута максимальная глубина и т.д.).
- Создание листовых узлов: Когда условие остановки выполнено, создайте листовой узел и присвойте класс или значение.
Критерии построения дерева решений
При построении дерева решений необходимо выбрать лучший признак для разбиения. К распространённым критериям относятся:
1. Прирост информации
Используется для задач классификации; измеряет улучшение чистоты набора данных после выбора признака. Формула расчёта:
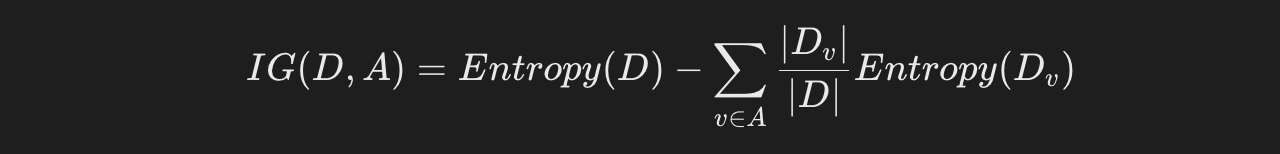
гдеЭнтропия— это энтропия набора данных, используемая для измерения неопределённости данных.
2. Индекс Джини
Также является критерием разбиения для задач классификации. Формула расчёта:
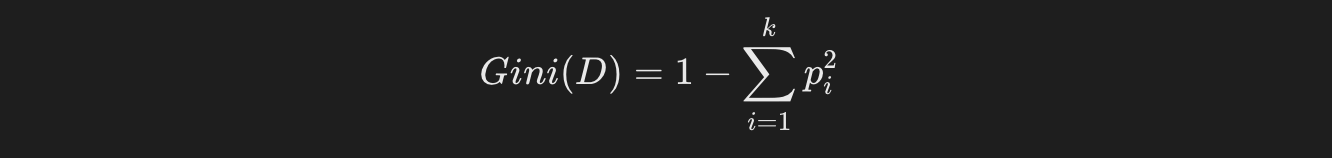
где pi— доля образцов класса i. Чем меньше индекс Джини, тем чище набор данных.
3. Среднеквадратичная ошибка (MSE)
Используется для задач регрессии; измеряет разницу между предсказанными значениями и фактическими значениями.
Чем меньше MSE, тем лучше качество прогнозирования дерева регрессии.
Преимущества и недостатки деревьев решений
Преимущества
- Легко понять и интерпретировать: структура дерева решений интуитивно понятна, её легко понять и интерпретировать.
- Обработка нескольких типов данных: может обрабатывать числовые и категориальные данные.
- Не требуется стандартизация данных: решающие деревья не требуют стандартизации или нормализации данных.
Недостатки
- Склонность к переобучению: решающие деревья склонны к переобучению, особенно когда набор данных мал или глубина дерева велика.
- Чувствительность к шуму: решающие деревья чувствительны к зашумлённым данным, что может ухудшить качество модели.
- Нестабильность: небольшие изменения в данных могут привести к совершенно другому дереву.
Реализация решающего дерева на Python
Далее мы будем использоватьscikit-learnбиблиотека для реализации простого классификатора на основе решающего дерева.
1. Установите необходимые библиотеки
Сначала убедитесь, что у вас установленаscikit-learnбиблиотека. Если нет, вы можете установить её с помощью следующей команды:
pip install scikit-learn
2. Импортируйте библиотеки и загрузите набор данных
Мы будем использоватьscikit-learnвстроенный набор данных Iris для демонстрации использования решающих деревьев.
Пример
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
# Загрузить набор данных Iris
iris = load_iris()
X = iris.data
y = iris.target
# Разделите набор данных на обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
3. Обучение модели дерева решений
Далее мы используемDecisionTreeClassifierдля обучения модели дерева решений.
Пример
clf = DecisionTreeClassifier()
# Обучаем модель
clf.fit(X_train, y_train)
4. Прогнозирование и оценка
Используйте обученную модель для прогнозирования на тестовом наборе и оценки точности модели.
Пример
y_pred = clf.predict(X_test)
# Вычислите точность
accuracy = accuracy_score(y_test, y_pred)
print(f"Точность модели: {accuracy:.2f}")
Результат вывода:
模型准确率: 1.00
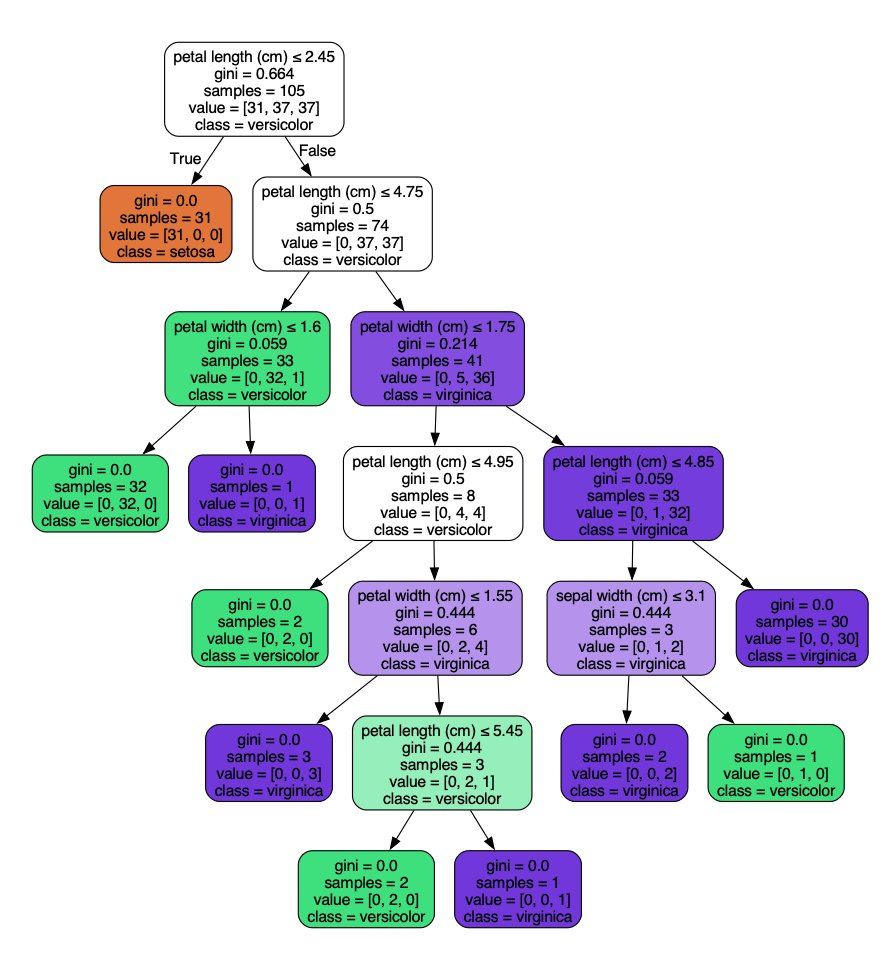
5. Визуализация дерева решений
Чтобы более наглядно понять структуру дерева решений, можно использоватьgraphvizбиблиотеку для визуализации дерева решений.
Адрес для скачивания Graphviz:https://graphviz.org/download/
- В Windows можно скачать установочный пакет для Windows (файл .msi).
- В Linux можно установить с помощью команды менеджера пакетов, напримерapt install graphviz
- Команда установки для macOSbrew install graphviz。
Кроме того, можно установить из исходного кода, скачав последний пакет с исходным кодом (файл .tar.gz).
tar -zxvf graphviz-<version>.tar.gz
cd graphviz-<version>
./configure
make
sudo make install
После установки можно проверить, успешно ли установлен Graphviz, с помощью следующей команды:
dot -V
Если вывод похож на следующий, установка прошла успешно:
dot - graphviz version 12.2.1 (20241206.2353)
Установкаgraphvizбиблиотека:
Пример
Затем используйте следующий код для создания визуализации дерева решений:
Пример
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
from sklearn.tree import export_graphviz
import graphviz
# Загрузить набор данных Iris
iris = load_iris()
X = iris.data
y = iris.target
# Разделите набор данных на обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Создайте классификатор дерева решений
clf = DecisionTreeClassifier()
# Обучаем модель
clf.fit(X_train, y_train)
# Выполните прогноз на тестовом наборе
y_pred = clf.predict(X_test)
# Вычислите точность
accuracy = accuracy_score(y_test, y_pred)
print(f"Точность модели: {accuracy:.2f}")
# Экспортировать дерево решений как dot-файл
dot_data = export_graphviz(clf, out_file=None,
feature_names=iris.feature_names,
class_names=iris.target_names,
filled=True, rounded=True,
special_characters=True)
# Отобразить дерево решений с помощью graphviz
graph = graphviz.Source(dot_data)
graph.render("iris_decision_tree") # Сохранить как PDF-файл
graph.view() # Просмотреть в браузере
Выполнение приведённого выше кода создаст файл iris_decision_tree.pdf, отображаемый следующим образом: