Árbol de decisión (Decision Tree)
El árbol de decisión (Decision Tree) es un algoritmo de aprendizaje automático de uso común, ampliamente aplicado en problemas de clasificación y regresión.
El árbol de decisión representa el proceso de decisión mediante una estructura de árbol. Cada nodo interno representa la prueba de una característica o atributo, cada rama representa el resultado de la prueba y cada nodo hoja representa una clase o valor.
Conceptos básicos del árbol de decisión
- Nodo: Cada punto del árbol se llama nodo. El nodo raíz es el punto de inicio del árbol, los nodos internos son puntos de decisión y los nodos hoja son los resultados finales de la decisión.
- Rama (Branch): El camino de un nodo a otro se llama rama.
- División (Split): Es el proceso de dividir el conjunto de datos en varios subconjuntos según una característica.
- Pureza (Purity): Mide si las categorías de las muestras en un subconjunto son consistentes. Cuanto mayor sea la pureza, más similares son las muestras en el subconjunto.
Cómo funciona el árbol de decisión
El árbol de decisión construye la estructura del árbol dividiendo recursivamente el conjunto de datos en subconjuntos más pequeños. Los pasos específicos son los siguientes:
- Seleccionar la mejor característica: Según algún criterio (como ganancia de información, índice de Gini, etc.), se selecciona la mejor característica para dividir.
- Dividir el conjunto de datos: Dividir el conjunto de datos en varios subconjuntos según la característica seleccionada.
- Construir subárboles de forma recursiva: Repetir el proceso anterior para cada subconjunto hasta que se cumpla una condición de parada (como que todas las muestras pertenezcan a la misma categoría, alcanzar la profundidad máxima, etc.).
- Generar nodos hoja: Cuando se cumple la condición de parada, se generan nodos hoja y se les asigna una categoría o valor.
Estándares de construcción del árbol de decisión
Al construir un árbol de decisión, debemos seleccionar la mejor característica para dividir. Los criterios más comunes son:
1. Ganancia de información (Information Gain)
Se utiliza en problemas de clasificación para medir la mejora de pureza del conjunto de datos después de seleccionar una característica. La fórmula de cálculo es:
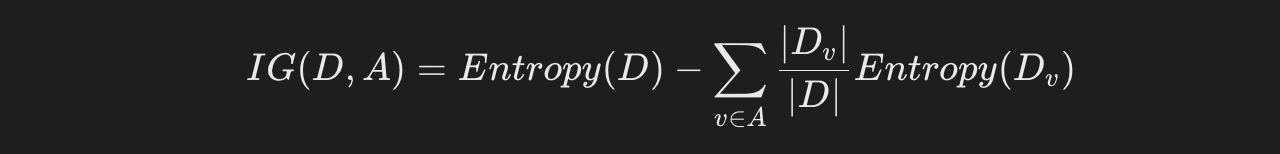
DondeEntropyes la entropía del conjunto de datos, que se utiliza para medir la incertidumbre de los datos.
2. Índice de Gini (Gini Index)
También es un criterio de división para problemas de clasificación. La fórmula de cálculo es:
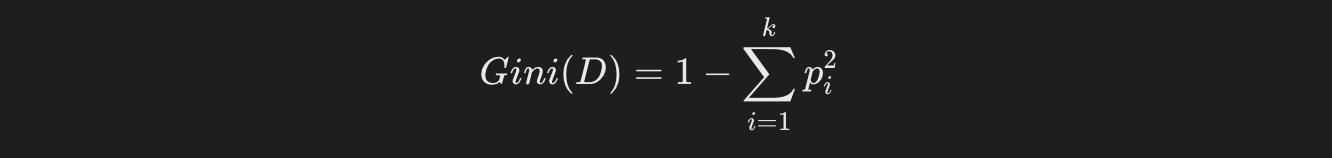
Donde pies la proporción de muestras de la categoría i. Cuanto menor sea el índice de Gini, más puro será el conjunto de datos.
3. Error cuadrático medio (MSE)
Se utiliza en problemas de regresión para medir la diferencia entre los valores predichos y los valores reales.
Cuanto menor sea el MSE, mejor será el efecto de predicción del árbol de regresión.
Ventajas y desventajas del árbol de decisión
Ventajas
- Fácil de entender e interpretar: La estructura del árbol de decisión es intuitiva y fácil de entender e interpretar.
- Manejo de múltiples tipos de datos: Puede manejar datos numéricos y categóricos.
- No requiere estandarización de datos: El árbol de decisión no requiere estandarización ni normalización de los datos.
Desventajas
- Propenso al sobreajuste: El árbol de decisión es propenso al sobreajuste, especialmente cuando el conjunto de datos es pequeño o la profundidad del árbol es grande.
- Sensible al ruido: El árbol de decisión es bastante sensible a los datos ruidosos, lo que puede provocar una disminución del rendimiento del modelo.
- Inestable: Pequeños cambios en los datos pueden dar lugar a un árbol completamente diferente.
Implementar un árbol de decisión con Python
A continuación, utilizaremos la bibliotecascikit-learnde Python para implementar un clasificador de árbol de decisión simple.
1. Instalar las bibliotecas necesarias
Primero, asegúrate de haber instalado la bibliotecascikit-learn. Si no está instalada, puedes instalarla con el siguiente comando:
pip install scikit-learn
2. Importar bibliotecas y cargar el conjunto de datos
Utilizaremosscikit-learnel conjunto de datos de Iris (Iris) incluido en la biblioteca para demostrar el uso del árbol de decisión.
Ejemplo
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
# Cargar el conjunto de datos de Iris
iris = load_iris()
X = iris.data
y = iris.target
# Dividir el conjunto de datos en conjunto de entrenamiento y de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
3. Entrenar el modelo de árbol de decisión
A continuación, usamosDecisionTreeClassifierpara entrenar el modelo de árbol de decisión.
Ejemplo
clf = DecisionTreeClassifier()
# Entrenar el modelo
clf.fit(X_train, y_train)
4. Predicción y evaluación
Usa el modelo entrenado para predecir el conjunto de prueba y evalúa la precisión del modelo.
Ejemplo
y_pred = clf.predict(X_test)
# Calcular la precisión
accuracy = accuracy_score(y_test, y_pred)
print(f"Precisión del modelo: {accuracy:.2f}")
Resultado de salida:
模型准确率: 1.00
5. Visualizar el árbol de decisión
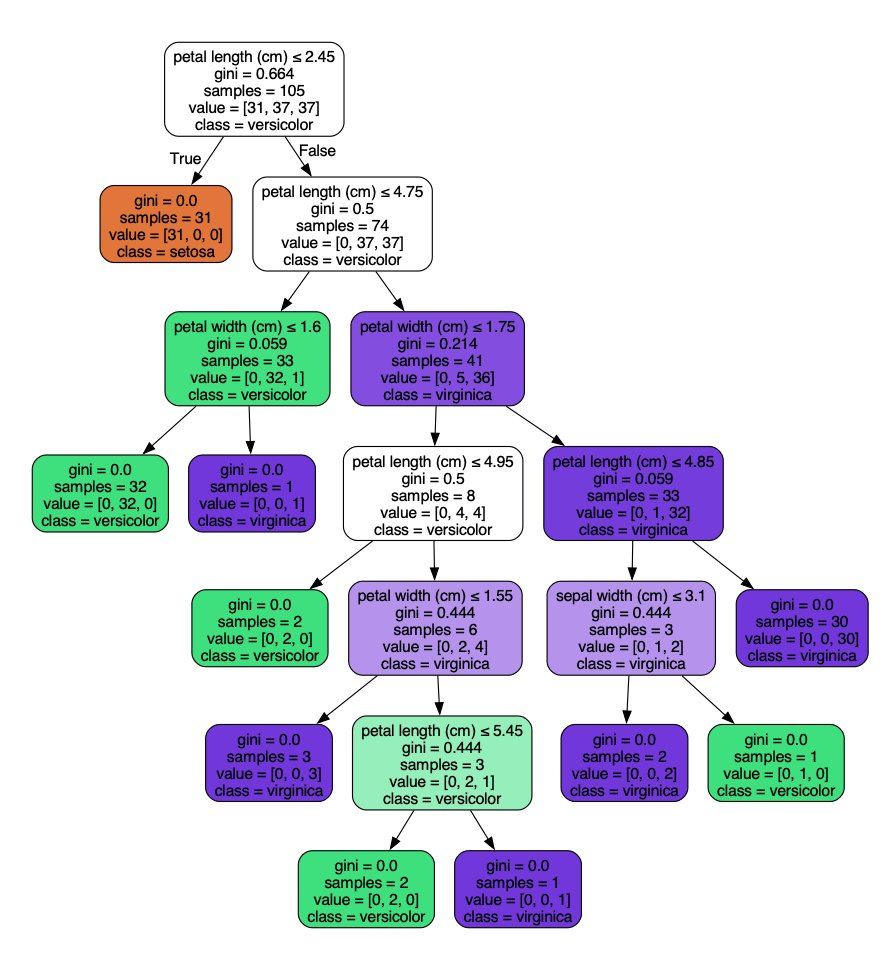
Para comprender la estructura del árbol de decisión de manera más intuitiva, podemos usar la bibliotecagraphvizpara visualizar el árbol de decisión.
Dirección de descarga de Graphviz:https://graphviz.org/download/
- En la plataforma Windows, puedes descargar el paquete de instalación para Windows (archivo .msi).
- En la plataforma Linux, puedes instalarlo con el comando del gestor de paquetes, comoapt install graphviz
- Comando de instalación para la plataforma macOSbrew install graphviz。
También puedes instalarlo desde el código fuente, descargando el paquete de código fuente más reciente (archivo .tar.gz).
tar -zxvf graphviz-<version>.tar.gz
cd graphviz-<version>
./configure
make
sudo make install
Una vez completada la instalación, puedes verificar si Graphviz se instaló correctamente con el siguiente comando:
dot -V
Si la salida es similar al siguiente contenido, la instalación se realizó correctamente:
dot - graphviz version 12.2.1 (20241206.2353)
Instalar lagraphvizbiblioteca:
Ejemplo
Luego, usa el siguiente código para generar la visualización del árbol de decisión:
Ejemplo
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
from sklearn.tree import export_graphviz
import graphviz
# Cargar el conjunto de datos de Iris
iris = load_iris()
X = iris.data
y = iris.target
# Dividir el conjunto de datos en conjunto de entrenamiento y de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Crear el clasificador de árbol de decisión
clf = DecisionTreeClassifier()
# Entrenar el modelo
clf.fit(X_train, y_train)
# Predecir el conjunto de prueba
y_pred = clf.predict(X_test)
# Calcular la precisión
accuracy = accuracy_score(y_test, y_pred)
print(f"Precisión del modelo: {accuracy:.2f}")
# Exportar el árbol de decisión a un archivo dot
dot_data = export_graphviz(clf, out_file=None,
feature_names=iris.feature_names,
class_names=iris.target_names,
filled=True, rounded=True,
special_characters=True)
# Usar Graphviz para renderizar el árbol de decisión
graph = graphviz.Source(dot_data)
graph.render("iris_decision_tree") # Guardar como archivo PDF
graph.view() # Ver en el navegador
Al ejecutar el código anterior, se generará un archivo iris_decision_tree.pdf, que se mostrará de la siguiente manera: