決定木(Decision Tree)
決定木(Decision Tree)は、分類問題や回帰問題に広く使用される一般的な機械学習アルゴリズムです。
決定木はツリー構造を使用して意思決定プロセスを表現します。各内部ノードは特徴量または属性のテストを表し、各ブランチはテスト結果を表し、各リーフノードはクラスまたは値を表します。
決定木の基本概念
- ノード(Node):ツリー内の各点をノードと呼びます。ルートノードはツリーの始点であり、内部ノードは決定点、リーフノードは最終的な決定結果です。
- ブランチ(Branch):あるノードから別のノードへの経路をブランチと呼びます。
- 分割(Split):特定の特徴量に基づいてデータセットを複数のサブセットに分割するプロセスです。
- 純度(Purity):サブセット内のサンプルのクラスが一致しているかを測る指標です。純度が高いほど、サブセット内のサンプルが類似していることを示します。
決定木の動作原理
決定木は、データセットを再帰的に小さなサブセットに分割してツリー構造を構築します。具体的な手順は次のとおりです:
- 最適な特徴量の選択:情報利得やジニ指数などの基準に基づいて、分割に最適な特徴量を選択します。
- データセットの分割:選択した特徴量に基づいてデータセットを複数のサブセットに分割します。
- サブツリーの再帰的構築:すべてのサンプルが同じクラスに属する、最大深さに達するなどの停止条件を満たすまで、各サブセットに対して上記のプロセスを繰り返します。
- リーフノードの生成:停止条件を満たすと、リーフノードを生成してクラスまたは値を割り当てます。
決定木の構築基準
決定木を構築する際、分割に最適な特徴量を選択する必要があります。一般的に使用される基準は次のとおりです:
1. 情報利得(Information Gain)
分類問題で使用され、特定の特徴量を選択した後のデータセットの純度向上を測定します。計算式は次のとおりです:
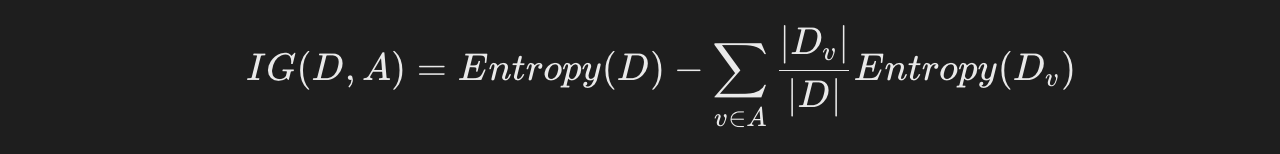
ここでEntropyはデータセットのエントロピーであり、データの不確実性を測定するために使用されます。
2. ジニ指数(Gini Index)
これも分類問題で使用される分割基準であり、計算式は次のとおりです:
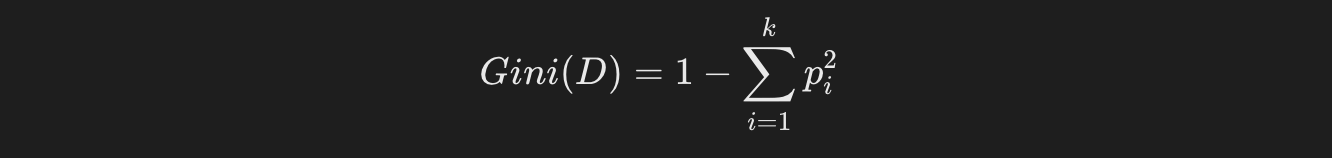
ここで piはクラス i のサンプルの割合です。ジニ指数が小さいほど、データセットがより純粋であることを示します。
3. 平均二乗誤差(MSE)
回帰問題で使用され、予測値と実際の値の差を測定します。
MSEが小さいほど、回帰木の予測精度が高いことを示します。
決定木の長所と短所
長所
- 理解と解釈が容易:決定木の構造は直感的であり、理解と解釈が容易です。
- 多種多様なデータ型の処理:数値型およびカテゴリ型データを処理できます。
- データの標準化が不要:決定木はデータの標準化や正規化処理を必要としません。
短所
- 過学習しやすい:決定木は過学習しやすく、特にデータセットが小さい場合やツリーの深さが大きい場合に顕著です。
- ノイズに敏感:決定木はノイズデータに敏感であり、モデルの性能が低下する可能性があります。
- 不安定:データの小さな変化が、まったく異なるツリーを生成する可能性があります。
Pythonを使用した決定木の実装
次に、Pythonのscikit-learnライブラリを使用して、簡単な決定木分類器を実装します。
1. 必要なライブラリのインストール
まず、あなたがscikit-learnライブラリをインストールしていることを確認してください。インストールされていない場合は、以下のコマンドでインストールできます:
pip install scikit-learn
2. ライブラリのインポートとデータセットの読み込み
私たちはscikit-learnに付属のアヤメ(Iris)データセットを使用して、決定木の使用をデモンストレーションします。
例
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
# アヤメデータセットを読み込む
iris = load_iris()
X = iris.data
y = iris.target
# データセットを訓練用とテスト用に分割する
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
3. 決定木モデルの訓練
次に、DecisionTreeClassifierを使用して決定木モデルを訓練します。
例
clf = DecisionTreeClassifier()
# モデルを訓練
clf.fit(X_train, y_train)
4. 予測と評価
訓練済みモデルを使用してテストセットを予測し、モデルの精度を評価します。
例
y_pred = clf.predict(X_test)
# 精度を計算
accuracy = accuracy_score(y_test, y_pred)
print(f"モデル精度: {accuracy:.2f}")
出力結果:
模型准确率: 1.00
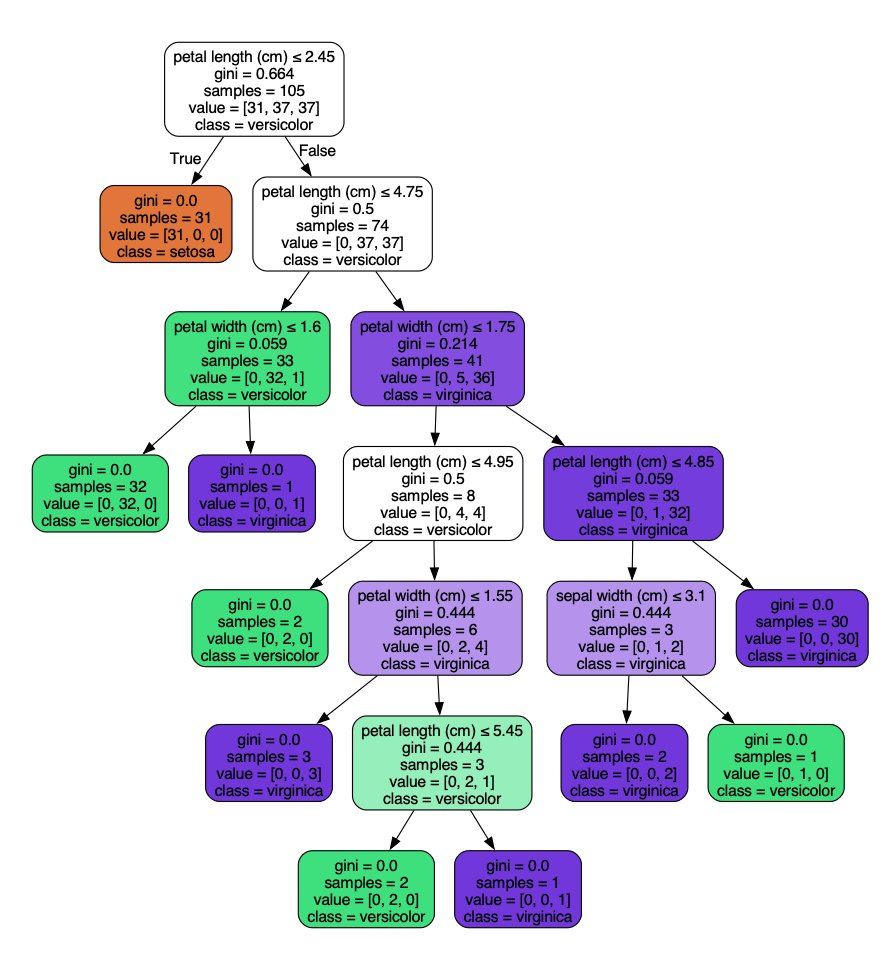
5. 決定木の可視化
決定木の構造をより直感的に理解するために、graphvizライブラリを使用して決定木を可視化できます。
graphviz ダウンロードアドレス:https://graphviz.org/download/
- Windowsプラットフォームでは、Windows用のインストールパッケージ(.msiファイル)をダウンロードできます。
- Linuxプラットフォームでは、インストールパッケージのコマンドでインストールできます。例:apt install graphviz
- macOSプラットフォームのインストールコマンドbrew install graphviz。
ソースコードからインストールすることもできます。最新のソースパッケージ(.tar.gzファイル)をダウンロードしてください。
tar -zxvf graphviz-<version>.tar.gz
cd graphviz-<version>
./configure
make
sudo make install
インストールが完了したら、以下のコマンドでGraphvizが正常にインストールされたかを確認できます:
dot -V
以下のような出力が表示されれば、インストール成功です:
dot - graphviz version 12.2.1 (20241206.2353)
インストールgraphvizライブラリ:
例
次に、以下のコードを使用して決定木の可視化図を生成します:
例
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
from sklearn.tree import export_graphviz
import graphviz
# アヤメデータセットを読み込む
iris = load_iris()
X = iris.data
y = iris.target
# データセットを訓練用とテスト用に分割する
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 決定木分類器を作成
clf = DecisionTreeClassifier()
# モデルを訓練
clf.fit(X_train, y_train)
# テストセットを予測
y_pred = clf.predict(X_test)
# 精度を計算
accuracy = accuracy_score(y_test, y_pred)
print(f"モデル精度: {accuracy:.2f}")
# 決定木をdotファイルとしてエクスポート
dot_data = export_graphviz(clf, out_file=None,
feature_names=iris.feature_names,
class_names=iris.target_names,
filled=True, rounded=True,
special_characters=True)
# graphvizを使用して決定木をレンダリング
graph = graphviz.Source(dot_data)
graph.render("iris_decision_tree") # PDFファイルとして保存
graph.view() # ブラウザで表示
上記のコードを実行すると、iris_decision_tree.pdf ファイルが生成され、次のように表示されます: