Случайный лес
Представьте, что вы участвуете в важном интеллектуальном соревновании. Столкнувшись со сложной задачей, вы бы доверились суждению одного лучшего эксперта или результату голосования 100 компетентных участников? В большинстве случаев коллективная мудрость может компенсировать индивидуальные предубеждения и ограничения, что приводит к более стабильным и точным решениям.
В мире машинного обучения,Случайный лес— это именно этаколлективная мудрость, выдающийся представитель этой идеи. Благодаря построению большого количества деревьев решений и их совместному голосованию при прогнозировании он стал одним из самых мощных и популярных алгоритмов машинного обучения.
Что такое случайный лес?
Случайный лес— это алгоритм машинного обучения, основанный на ансамблевом обучении. Его основная идея очень проста:Одна голова хорошо, а две лучше.。
- Лес: относится к множествудеревьев решений (Decision Tree)образующих набор.
- Случайность: относится к двум типам случайности, вводимым алгоритмом при построении каждого дерева решений, что гарантирует уникальность каждого дерева.
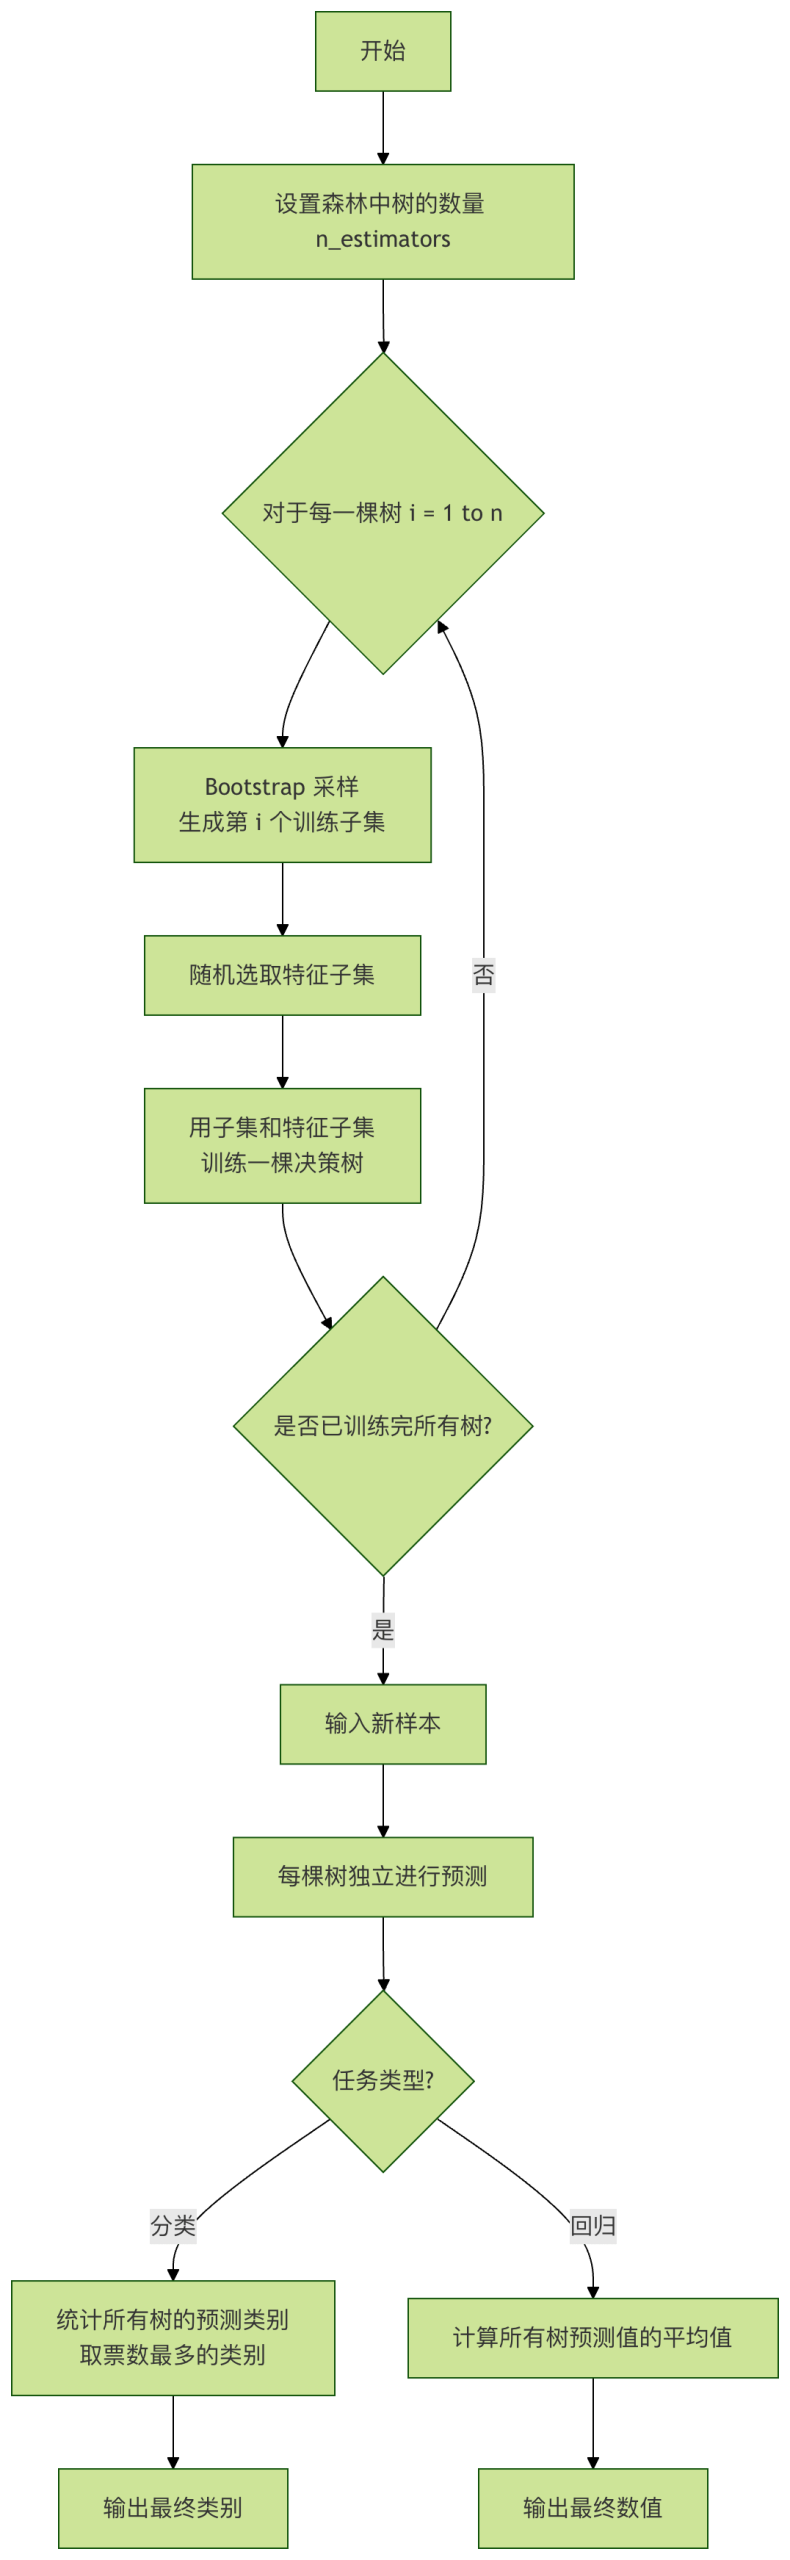
Наконец, для задач классификации лес используетголосование (решение большинством)для выдачи результатов; для задач регрессии он используетусреднениедля выдачи результатов.
Основная идея: бэггинг и случайность
Успех случайного леса основывается на двух краеугольных камнях:
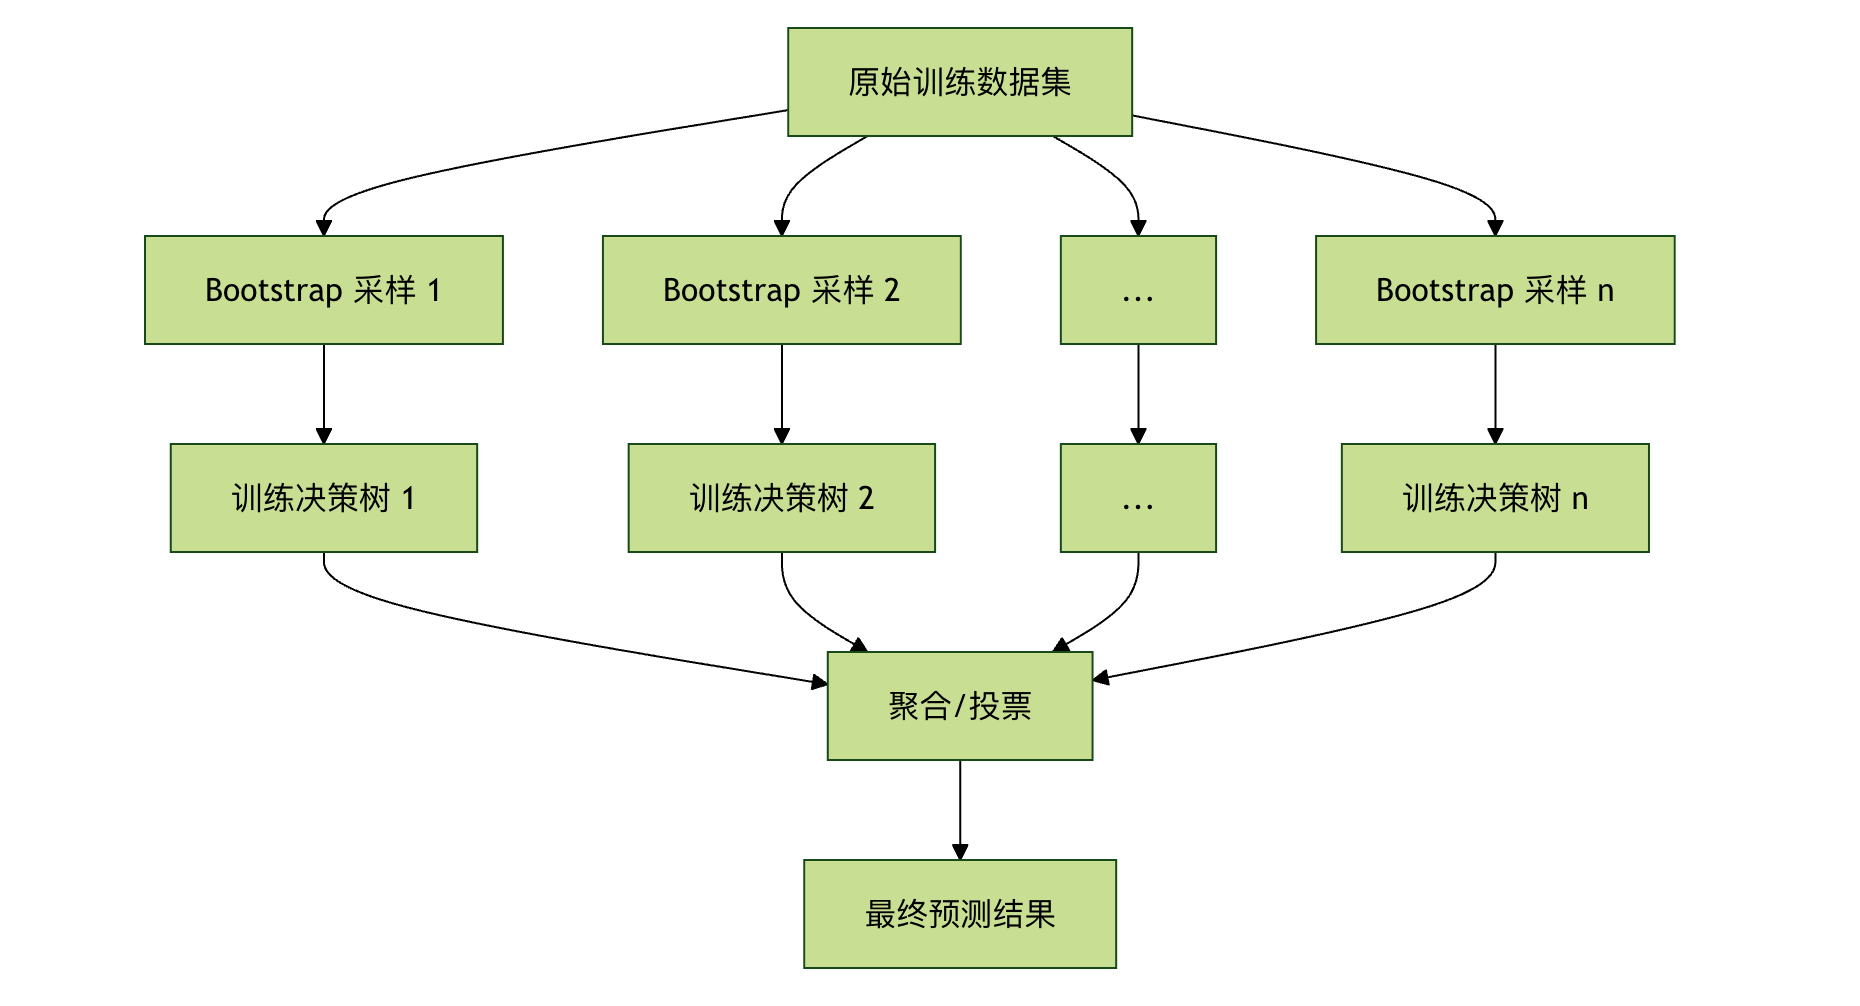
Бэггинг(бутстрэп-агрегирование):
- Бутстрэп (Bootstrap Sampling): Из исходного обучающего набора данных,с возвращением,случайным образом извлекаются образцы для создания нескольких различных обучающих подмножеств. Это означает, что один и тот же образец может появиться несколько раз в одном подмножестве, а другой образец может не появиться вовсе.
- Агрегирование: Используйте каждое подмножество для независимого обучения дерева решений, а затем агрегируйте результаты всех деревьев (голосование или усреднение).
Случайность признаков:
- При разбиении каждого узла каждого дерева алгоритм не рассматривает все признаки, а вместо этогослучайно выбирает подмножество из всех признаков, а затем выбирает оптимальный признак для разбиения из этого подмножества.
- Это дополнительно повышает разнообразие между деревьями, позволяя лесу видеть разные аспекты задачи.
Проще говоря, случайный лес создаёт разнообразныйкомитет экспертов。Даже если некоторые деревья ошибаются, другие правильные деревья могут исправить их с помощью голосования, достигая таким образом более стабильной и мощной производительности, чем одно дерево решений.
Рабочий процесс алгоритма и ключевые параметры
Как работает случайный лес
Давайте наглядно рассмотрим процесс его работы с помощью блок-схемы:
Подробное объяснение ключевых гиперпараметров
При использованииscikit-learnбиблиотека, крайне важно понимать следующие основные параметры:
| Название параметра | Значение | Типичное значение / влияние | Простое объяснение |
|---|---|---|---|
n_estimators |
Количество решающих деревьев в лесу. | По умолчанию — 100. Чем больше значение, тем обычно стабильнее модель и тем лучше её качество, но тем выше вычислительные затраты. | «Количество членов комитета». Чем больше людей, тем обычно надёжнее решение, но тем дольше длится совещание. |
max_depth |
Максимальная глубина одного решающего дерева. | DefaultNone(без ограничения). Ограничение глубины может предотвратить переобучение и сделать модель проще. |
«Ограничьте время выступления каждого человека». Не даёт эксперту (дереву) слишком долго задумываться и уделять чрезмерное внимание деталям обучающих данных. |
max_features |
Количество признаков, рассматриваемых при поиске лучшего разбиения. | Может быть целым числом, числом с плавающей точкой или'auto'/'sqrt'. Это ключевой параметр, который вносит «случайность признаков». |
«Случайно рассматривать лишь несколько аспектов в каждом обсуждении». Обеспечивает анализ задачи каждым деревом под разными углами, увеличивая разнообразие. |
min_samples_split |
Минимальное количество выборок, необходимое для разбиения узла. | По умолчанию 2. Чем больше значение, тем консервативнее рост дерева и тем меньше вероятность переобучения. | «В группе должно быть как минимум несколько человек, чтобы продолжить групповое обсуждение». Позволяет избежать создания нового правила из-за одной-двух выборок. |
min_samples_leaf |
Минимальное количество выборок, необходимое для листового узла. | По умолчанию 1. Чем больше значение, тем более гладкой получается модель. | «Окончательный вывод должен основываться как минимум на нескольких случаях». Обеспечивает достаточную поддержку данных для каждого вывода. |
bootstrap |
Использовать ли Bootstrap-выборку. | DefaultTrue. Если установлено вFalse, тогда весь набор данных будет использоваться для обучения каждого дерева, но часть случайности будет потеряна. |
"Разрешать ли одному человеку выступать повторно". Включение этого — суть Bagging. |
Практическое занятие — примеры кода
Давайте применим это на практике с классическим набором данных Iris для классификации.
Пример 1: базовая задача классификации
Пример
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, classification_report
# 1. Загрузить данные
iris = load_iris()
X = iris.data # Признаки: длина чашелистика, ширина чашелистика, длина лепестка, ширина лепестка
y = iris.target # Метки: три вида ириса
# 2. Разделение на обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 3. Создание классификатора Random Forest
# Здесь мы задаем 100 деревьев и ограничиваем максимальную глубину до 5
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# 4. Обучение модели
rf_clf.fit(X_train, y_train)
# 5. Сделайте предсказания на тестовом наборе
y_pred = rf_clf.predict(X_test)
# 6. Оцените качество модели
print("Точность на тестовом наборе:", accuracy_score(y_test, y_pred))
print("\nОтчёт по классификации:")
print(classification_report(y_test, y_pred, target_names=iris.target_names))
Пояснение кода:
- Импорт библиотек:
RandomForestClassifierявляется классификатором Random Forest. - Загрузка данных: Набор данных Iris содержит 150 образцов, 4 признака и 3 класса.
- Разделение данных: Используйте 70% данных для обучения и 30% для тестирования, чтобы проверить обобщающую способность модели на новых данных.
- Создание экземпляра модели:
random_state=42Обеспечьте воспроизводимость результатов при каждом запуске. - Обучение модели:
fitМетод построит 100 решающих деревьев. - Прогнозирование и оценка: используйте обученный лес для прогнозирования на тестовом наборе и расчёта таких метрик, как точность.
Вывод:
      setosa       1.00      1.00      1.00        19
  versicolor       1.00      1.00      1.00        13
   virginica       1.00      1.00      1.00        13

    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45
Пример 2: Просмотр важности признаков
Случайный лес также обладает мощной возможностью: оценка вклада каждого признака в прогнозы.
Пример
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, classification_report
import pandas as pd
import matplotlib.pyplot as plt
# -------------------------- Начало настройки китайского шрифта --------------------------
plt.rcParams['font.sans-serif'] = [
# Приоритет Windows
'SimHei', 'Microsoft YaHei',
# Приоритет macOS
'PingFang SC', 'Heiti TC',
# Приоритет Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Исправление проблемы отображения отрицательных знаков в виде квадратов
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Конец настройки китайского шрифта --------------------------
# 1. Загрузить данные
iris = load_iris()
X = iris.data # Признаки: длина чашелистика, ширина чашелистика, длина лепестка, ширина лепестка
y = iris.target # Метки: три вида ириса
# 2. Разделение на обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 3. Создание классификатора Random Forest
# Здесь мы задаем 100 деревьев и ограничиваем максимальную глубину до 5
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# 4. Обучение модели
rf_clf.fit(X_train, y_train)
# 5. Сделайте предсказания на тестовом наборе
y_pred = rf_clf.predict(X_test)
# 6. Оцените качество модели
print("Точность на тестовом наборе:", accuracy_score(y_test, y_pred))
print("\nОтчёт по классификации:")
# Получите важность признаков
feature_importances = rf_clf.feature_importances_
features = iris.feature_names
# Создание DataFrame для удобного просмотра
importance_df = pd.DataFrame({
'Feature': features,
'Importance': feature_importances
}).sort_values('Importance', ascending=False)
print("Рейтинг важности признаков:")
print(importance_df)
# Визуализация
plt.figure(figsize=(8, 5))
plt.barh(importance_df['Feature'], importance_df['Importance'])
plt.xlabel('Важность признаков')
plt.title('Случайный лес - Важность признаков')
plt.gca().invert_yaxis() # Сделать так, чтобы наиболее важные признаки отображались сверху
plt.show()

Анализ вывода:Вы можете обнаружить, что длина и ширина лепестка гораздо важнее размеров чашелистика. Это полностью согласуется с ботаническим здравым смыслом; признаки лепестка действительно являются ключом к различению разных цветков ириса.Этот признак чрезвычайно ценен для отбора признаков и понимания данных.
Часть 4: Преимущества, недостатки и сценарии применения
Преимущества
- Высокая точность:Ансамблевое обучение обычно позволяет достичь производительности высшего уровня на заданных данных.
- Сильная устойчивость к переобучению:Благодаря бэггингу и случайному отбору признаков модель не склонна к переобучению даже без обрезки.
- Нетребовательность к данным:Может обрабатывать числовые и категориальные признаки без необходимости масштабирования признаков (например, нормализации).
- Предоставляет оценку важности признаков:Встроенная оценка признаков является ценным побочным результатом.
- Легко распараллеливается:Обучение каждого дерева независимо и может быть легко ускорено за счёт параллелизма.
Недостатки
- Плохая интерпретируемость модели:«Чёрный ящик», состоящий из сотен или тысяч деревьев, гораздо труднее интерпретировать, чем одно решающее дерево.
- Низкая скорость обучения и предсказания:Когда количество деревьев велико, требуется больше вычислительных ресурсов и времени.
- Большой объём занимаемой памяти:Необходимо хранить все древовидные структуры всего леса.
Типичные сценарии применения
- Задачи классификации:Например, обнаружение спама, диагностика заболеваний, классификация изображений.
- Задачи регрессии:Например, предсказание цен на жильё, прогнозирование продаж.
- Отбор признаков:Используйте важность признаков, которую он выводит, для фильтрации признаков.
- Обработка пропущенных значений:Случайные леса естественным образом хорошо справляются с пропущенными значениями.