Жизненный цикл проекта машинного обучения
Проект машинного обучения похож на строительство дома; он требует полного процесса от проектных чертежей до строительства и финальной проверки. Каждый шаг критически важен и незаменим.
Шесть основных этапов рабочего процесса машинного обучения:
- Постановка задачи: определить, какую проблему нужно решить
- Сбор данных: получить соответствующие данные
- Подготовка данных: очистка и предварительная обработка данных
- Обучение модели: выбрать алгоритмы и обучить модели
- Оценка модели: оценить качество модели
- Развертывание модели: ввести модель в эксплуатацию
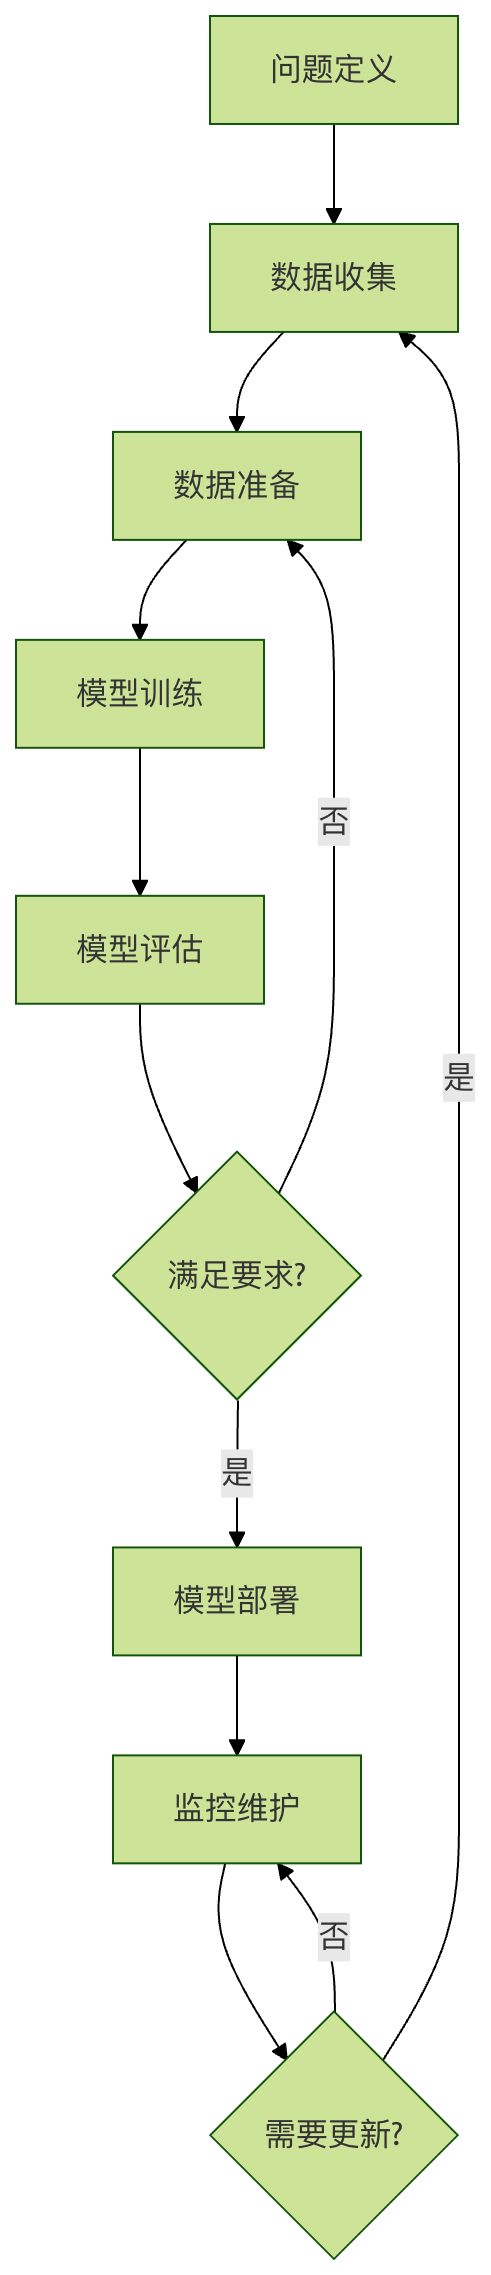
Этап 1: Постановка задачи
Определите бизнес-задачу
Постановка задачи — самая важная отправная точка проекта машинного обучения, так же как перед использованием навигации нужно знать пункт назначения.
Ключевые вопросы
Какую проблему мы пытаемся решить?
- Классификация: определить, является ли электронное письмо спамом
- Регрессия: прогнозировать цены на жилье
- Кластеризация: сегментация клиентов
- Обнаружение аномалий: выявить мошенничество с кредитными картами
Почему эта проблема важна?
- Бизнес-ценность: повысить эффективность, снизить затраты, увеличить выручку
- Ценность для пользователя: улучшить опыт, предоставлять персонализированные услуги
Каковы критерии успеха?
- Количественные метрики: точность выше 90%
- Бизнес-метрики: рост конверсии на 20%
Пример постановки задачи
Пример
class ProblemDefinition:
def __init__(self):
# Бизнес-задача
self.business_problem = "Коэффициент конверсии покупок пользователей низкий; необходимо повысить точность рекомендаций"
# Техническая задача
self.technical_problem = "Предсказывать товары, которые пользователь с большой вероятностью купит, на основе поведения пользователя"
# Тип задачи
self.problem_type = "Система рекомендаций (классификация + ранжирование)"
# Критерии успеха
self.success_criteria = {
"Улучшение показателя кликабельности": "15%",
"Улучшение коэффициента конверсии": "10%",
"Точность рекомендаций": "80%"
}
# Ограничения
self.constraints = {
"Время отклика": "< 100ms",
"Конфиденциальность данных": "Соответствие требованиям GDPR",
"Вычислительные ресурсы": "Существующая конфигурация сервера"
}
def define_features_and_labels(self):
"""Определение признаков и меток"""
features = {
"Признаки пользователя": ["Возраст", "Пол", "История покупок", "Поведение при просмотре"],
"Характеристики товара": ["Категория", "Цена", "Рейтинг", "Наличие"],
"Контекстные признаки": ["Время", "Устройство", "Географическое местоположение"]
}
labels = {
"Основная метка": "Был ли клик",
"Вторичная метка": "Была ли покупка",
"Вспомогательная метка": "Время пребывания"
}
return features, labels
def print_definition(self):
"""Вывод определения задачи"""
print("=" * 50)
print("Определение задачи машинного обучения")
print("=" * 50)
print(f"Бизнес-задача: {self.business_problem}")
print(f"Техническая задача: {self.technical_problem}")
print(f"Тип задачи: {self.problem_type}")
print("\nКритерии успеха: ")
for metric, target in self.success_criteria.items():
print(f" {metric}:{target}")
print("\nОграничения: ")
for constraint, limit in self.constraints.items():
print(f" {constraint}:{limit}")
features, labels = self.define_features_and_labels()
print("\nОпределения признаков: ")
for category, items in features.items():
print(f" {category}:{', '.join(items)}")
print("\nОпределения меток: ")
for label_type, label_name in labels.items():
print(f" {label_type}:{label_name}")
# Пример использования
problem = ProblemDefinition()
problem.print_definition()
Вывод:
==================================================
机器学习问题定义
==================================================
业务问题:用户购买转化率低,需要提高推荐精准度
技术问题:基于用户行为预测用户可能购买的商品
问题类型:推荐系统(分类+排序)

成功标准:
  点击率提升:15%
  转化率提升:10%
  推荐准确率:80%

约束条件:
  响应时间:< 100ms
  数据隐私:符合 GDPR 要求
  计算资源:现有服务器配置

特征定义:
  用户特征:年龄, 性别, 购买历史, 浏览行为
  商品特征:类别, 价格, 评分, 库存
  上下文特征:时间, 设备, 地理位置

标签定义:
  主要标签:是否点击
  次要标签:是否购买
  辅助标签:停留时间
Этап 2: Сбор данных
Источники данных
Данные — это топливо машинного обучения; без подходящих данных, каким бы хорошим ни был алгоритм, он не сможет эффективно работать.
Распространённые источники данных
- Внутренние данные: бизнес-данные компании, данные о поведении пользователей
- Внешние данные: публичные наборы данных, сторонние сервисы данных
- Веб-скрейпинг: веб-данные, данные социальных сетей
- Данные датчиков: устройства IoT, системы мониторинга
Пример сбора данных
Пример
import pandas as pd
import numpy as np
from datetime import datetime, timedelta
class DataCollector:
def __init__(self):
self.collected_data = {}
def collect_user_data(self, n_users=1000):
"""Собрать данные пользователя"""
np.random.seed(42)
user_data = {
'user_id': range(1, n_users + 1),
'age': np.random.randint(18, 65, n_users),
'gender': np.random.choice(['Male', 'Female'], n_users),
'city': np.random.choice(['Beijing', 'Shanghai', 'Гуанчжоу', 'Шэньчжэнь'], n_users),
'registration_date': [
datetime.now() - timedelta(days=np.random.randint(1, 365))
for _ in range(n_users)
]
}
self.collected_data['users'] = pd.DataFrame(user_data)
print(f"Собрано {len(user_data['user_id'])} записей данных пользователей")
return self.collected_data['users']
def collect_behavior_data(self, n_behaviors=5000):
"""Сбор данных о поведении пользователей"""
np.random.seed(42)
user_ids = np.random.choice(range(1, 1001), n_behaviors)
product_ids = np.random.choice(range(1, 501), n_behaviors)
behavior_data = {
'behavior_id': range(1, n_behaviors + 1),
'user_id': user_ids,
'product_id': product_ids,
'behavior_type': np.random.choice(
['View', 'Click', 'Add to cart', 'Purchase'], n_behaviors,
p=[0.4, 0.3, 0.2, 0.1]
),
'timestamp': [
datetime.now() - timedelta(minutes=np.random.randint(1, 10080))
for _ in range(n_behaviors)
],
'duration': np.random.exponential(30, n_behaviors) # Время нахождения (секунды)
}
self.collected_data['behaviors'] = pd.DataFrame(behavior_data)
print(f"Собрано {len(behavior_data['behavior_id'])} записей данных о поведении")
return self.collected_data['behaviors']
def collect_product_data(self, n_products=500):
"""Собрать данные о продуктах"""
np.random.seed(42)
categories = ['Электроника', 'Одежда', 'Продукты', 'Дом', 'Книги']
product_data = {
'product_id': range(1, n_products + 1),
'category': np.random.choice(categories, n_products),
'price': np.random.uniform(10, 1000, n_products),
'rating': np.random.uniform(3.0, 5.0, n_products),
'stock': np.random.randint(0, 1000, n_products)
}
self.collected_data['products'] = pd.DataFrame(product_data)
print(f"Собрано {len(product_data['product_id'])} записей данных о товарах")
return self.collected_data['products']
def get_data_summary(self):
"""Получить сводку данных"""
print("\nСводка по сбору данных: ")
for name, df in self.collected_data.items():
print(f"\nнабор данных {name}: ")
print(f" Размер: {df.shape}")
print(f" Столбцы: {list(df.columns)}")
print(f" Пропущенные значения: {df.isnull().sum().sum()}")
print(f" Пример данных:")
print(df.head(2))
# Пример использования
collector = DataCollector()
collector.collect_user_data()
collector.collect_behavior_data()
collector.collect_product_data()
collector.get_data_summary()
Этап 3: Подготовка данных
Важность подготовки данных
Подготовка данных занимает 60-80% времени в проекте машинного обучения, и она так же важна, как подготовительная работа перед готовкой.
Основные задачи подготовки данных
- Очистка данных: обработка пропущенных значений, выбросов, дублирующихся значений
- Конструирование признаков: создание новых признаков, отбор важных признаков
- Преобразование данных: стандартизация, нормализация, кодирование
- Разделение данных: обучающий набор, валидационный набор, тестовый набор
Пример подготовки данных
Пример
import pandas as pd
import numpy as np
from sklearn.preprocessing import StandardScaler, LabelEncoder
from sklearn.model_selection import train_test_split
class DataPreparer:
def __init__(self, data):
self.data = data.copy()
self.processed_data = None
def clean_data(self):
"""Очистка данных"""
print("Начало очистки данных...")
# 1. Обработка пропущенных значений
print(f"Пропущенные значения до обработки: {self.data.isnull().sum().sum()}")
# 用均值填充数值列
numeric_columns = self.data.select_dtypes(include=[np.number]).columns
for col in numeric_columns:
if self.data[col].isnull().sum() > 0:
self.data[col].fillna(self.data[col].mean(), inplace=True)
# 用众数填充分类列
categorical_columns = self.data.select_dtypes(include=['object']).columns
for col in categorical_columns:
if self.data[col].isnull().sum() > 0:
mode_val = self.data[col].mode()[0]
self.data[col].fillna(mode_val, inplace=True)
print(f"Пропущенные значения после обработки: {self.data.isnull().sum().sum()}")
# 2. Обработка дубликатов
duplicates_before = self.data.duplicated().sum()
self.data.drop_duplicates(inplace=True)
duplicates_after = self.data.duplicated().sum()
print(f"Удалено дубликатов: {duplicates_before - duplicates_after} строк")
# 3. Обработка выбросов (простой метод: использовать IQR)
for col in numeric_columns:
Q1 = self.data[col].quantile(0.25)
Q3 = self.data[col].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
outliers = ((self.data[col] < lower_bound) |
(self.data[col] > upper_bound)).sum()
if outliers > 0:
# Заменить выбросы граничными значениями
self.data[col] = self.data[col].clip(lower_bound, upper_bound)
print(f"Обработано {outliers} выбросов в столбце {col}")
return self.data
def feature_engineering(self):
"""Конструирование признаков"""
print("\nНачинаем конструирование признаков...")
# 1. Создание новых признаков (пример)
if 'price' in self.data.columns and 'rating' in self.data.columns:
# Создать признак соотношения цены и производительности
self.data['price_per_rating'] = self.data['price'] / self.data['rating']
print("Создан новый признак: price_per_rating")
# 2. Отбор признаков (простой пример: удаление признаков с низкой дисперсией)
numeric_columns = self.data.select_dtypes(include=[np.number]).columns
low_variance_features = []
for col in numeric_columns:
if self.data[col].var() < 0.01: # Порог дисперсии
low_variance_features.append(col)
if low_variance_features:
self.data.drop(columns=low_variance_features, inplace=True)
print(f"Удаление признаков с низкой дисперсией: {low_variance_features}")
return self.data
def transform_data(self):
"""Преобразование данных"""
print("\n"Начало преобразования данных...")
# 1. Кодирование категориальных переменных
categorical_columns = self.data.select_dtypes(include=['object']).columns
label_encoders = {}
for col in categorical_columns:
le = LabelEncoder()
self.data[col] = le.fit_transform(self.data[col])
label_encoders[col] = le
print(f"Кодирование категориальной переменной: {col}")
# 2. Стандартизация числовых переменных
numeric_columns = self.data.select_dtypes(include=[np.number]).columns
scaler = StandardScaler()
if len(numeric_columns) > 0:
self.data[numeric_columns] = scaler.fit_transform(self.data[numeric_columns])
print(f"Стандартизация числовых переменных: {list(numeric_columns)}")
return self.data, label_encoders, scaler
def split_data(self, target_column, test_size=0.2, val_size=0.2):
"""Разделение данных"""
print(f"\n"Начало разделения данных (доля тестового набора: {test_size}, доля валидационного набора: {val_size})...")
X = self.data.drop(columns=[target_column])
y = self.data[target_column]
# Sivulliq misiliinirmut katit avittaq
X_temp, X_test, y_temp, y_test = train_test_split(
X, y, test_size=test_size, random_state=42
)
# Taava uqaqtumut katit suli data avittaq
val_size_adjusted = val_size / (1 - test_size)
X_train, X_val, y_train, y_val = train_test_split(
X_temp, y_temp, test_size=val_size_adjusted, random_state=42
)
print(f"Ilinniaqtitsinirmut katit angini: {X_train.shape)
print(f"Uqaqtumut katit angini: {X_val.shape)
print(f"Размер тестовой выборки: {X_test.shape)
return {
'X_train': X_train, 'y_train': y_train,
'X_val': X_val, 'y_val': y_val,
'X_test': X_test, 'y_test': y_test
}
def prepare_pipeline(self, target_column):
"""Полный конвейер подготовки данных"""
print("=" * 50)
print("Конвейер подготовки данных")
print("=" * 50)
# 1. Очистка данных
self.clean_data()
# 2. Инженерия признаков
self.feature_engineering()
# 3. Преобразование данных
processed_data, encoders, scaler = self.transform_data()
# 4. Разделение данных
splits = self.split_data(target_column)
self.processed_data = processed_data
return splits, encoders, scaler
# Создать образец данных и продемонстрировать подготовку данных
np.random.seed(42)
sample_data = pd.DataFrame({
'age': np.random.randint(18, 65, 1000),
'income': np.random.normal(50000, 15000, 1000),
'gender': np.random.choice(['Male', 'Female'], 1000),
'city': np.random.choice(['Beijing', 'Shanghai', 'Guangzhou'], 1000),
'target': np.random.choice([0, 1], 1000)
})
# Добавить несколько пропущенных значений и выбросов
sample_data.loc[np.random.choice(1000, 50), 'income'] = np.nan
sample_data.loc[np.random.choice(1000, 20), 'age'] = np.random.randint(100, 150)
preparer = DataPreparer(sample_data)
splits, encoders, scaler = preparer.prepare_pipeline('target')
Этап 4: Обучение модели
Стратегия выбора модели
Выбор правильной модели — ключ к успеху, так же как выбор правильного инструмента для работы.
Аспекты выбора модели
- Тип задачи: классификация, регрессия, кластеризация и т. д.
- Характеристики данных: размер данных, количество признаков, тип данных
- Требования к производительности: точность, скорость, интерпретируемость
- Ограничения ресурсов: вычислительные ресурсы, ограничения по времени
Пример обучения модели
Пример
from sklearn.linear_model import LogisticRegression, LinearRegression
from sklearn.ensemble import RandomForestClassifier, RandomForestRegressor
from sklearn.svm import SVC, SVR
from sklearn.metrics import accuracy_score, mean_squared_error, classification_report
class ModelTrainer:
def __init__(self):
self.models = {}
self.trained_models = {}
def register_model(self, name, model, problem_type):
"""Зарегистрировать модель"""
self.models[name] = {
'model': model,
'problem_type': problem_type
}
print(f"Регистрация модели: {name} ({problem_type})")
def train_single_model(self, name, X_train, y_train):
"""Обучение одной модели"""
if name not in self.models:
raise ValueError(f"Модель {name} не зарегистрирована")
model_info = self.models[name]
model = model_info['model']
print(f"\n"Обучение модели: {name}")
model.fit(X_train, y_train)
self.trained_models[name] = model
print(f"Обучение модели {name} завершено")
return model
def train_all_models(self, X_train, y_train):
"""Обучение всех зарегистрированных моделей"""
print("\n"Начало обучения всех моделей...")
for name in self.models.keys():
try:
self.train_single_model(name, X_train, y_train)
except Exception as e:
print(f"Ошибка при обучении модели {name}: {e}")
return self.trained_models
def evaluate_models(self, X_test, y_test):
"""Оценка всех обученных моделей"""
print("\n"Результаты оценки моделей:")
print("-" * 50)
results = {}
for name, model in self.trained_models.items():
problem_type = self.models[name]['problem_type']
# Прогнозы
y_pred = model.predict(X_test)
# Выбор метрик оценки в зависимости от типа задачи
if problem_type == 'classification':
accuracy = accuracy_score(y_test, y_pred)
results[name] = {'accuracy': accuracy}
print(f"{name}: Точность = {accuracy:.4f}")
# Подробный отчёт
print(classification_report(y_test, y_pred))
elif problem_type == 'regression':
mse = mean_squared_error(y_test, y_pred)
rmse = np.sqrt(mse)
results[name] = {'mse': mse, 'rmse': rmse}
print(f"{name}: MSE = {mse:.4f}, RMSE = {rmse:.4f}")
print("-" * 50)
return results
def get_best_model(self, results, metric='accuracy'):
"""Получить лучшую модель"""
if not results:
return None
best_model_name = max(results.keys(), key=lambda x: results[x].get(metric, 0))
best_score = results[best_model_name][metric]
print(f"\n"Лучшая модель: {best_model_name} ({metric} = {best_score:.4f})")
return best_model_name, self.trained_models[best_model_name]
# Пример использования
trainer = ModelTrainer()
# Зарегистрируйте различные типы моделей
trainer.register_model('Логистическая регрессия', LogisticRegression(random_state=42), 'classification')
trainer.register_model('Случайный лес', RandomForestClassifier(n_estimators=100, random_state=42), 'classification')
trainer.register_model('Машина опорных векторов', SVC(random_state=42), 'classification')
# Создать обучающие данные
X_train = splits['X_train']
y_train = splits['y_train']
X_test = splits['X_test']
y_test = splits['y_test']
# Обучить все модели
trained_models = trainer.train_all_models(X_train, y_train)
# Оценить модели
results = trainer.evaluate_models(X_test, y_test)
# Получить лучшую модель
best_name, best_model = trainer.get_best_model(results)
Этап 5: Оценка модели
Выбор метрики оценки
Выбор правильной метрики оценки похож на выбор правильной линейки, разные метрики подходят для разных сценариев.
Распространённые метрики оценки
Задачи классификации:
- Доля правильных ответов (Accuracy): доля правильных предсказаний
- Точность (Precision): доля предсказанных положительных примеров, которые действительно положительны
- Полнота (Recall): доля фактических положительных примеров, правильно предсказанных как положительные
- F1-мера: среднее гармоническое точности и полноты
Задачи регрессии:
- Среднеквадратичная ошибка (MSE): среднее значение квадратов разностей между предсказанными и истинными значениями
- Корень из среднеквадратичной ошибки (RMSE): квадратный корень из MSE
- Средняя абсолютная ошибка (MAE): среднее абсолютных разностей между предсказанными и истинными значениями
- Оценка R²: доля дисперсии, объяснённой моделью
Пример оценки модели
Пример
import matplotlib.pyplot as plt
from sklearn.metrics import (
accuracy_score, precision_score, recall_score, f1_score,
confusion_matrix, roc_curve, auc
)
class ModelEvaluator:
def __init__(self):
self.evaluation_results = {}
def evaluate_classification(self, y_true, y_pred, y_prob=None, model_name="Model"):
"""Оценить модель классификации"""
results = {}
# Базовые метрики
results['accuracy'] = accuracy_score(y_true, y_pred)
results['precision'] = precision_score(y_true, y_pred, average='weighted')
results['recall'] = recall_score(y_true, y_pred, average='weighted')
results['f1'] = f1_score(y_true, y_pred, average='weighted')
print(f"\n"{model_name} Результаты оценки классификации:")
print(f"Точность: {results['accuracy']:.4f}")
print(f"Точность: {results['precision']:.4f}")
print(f"Полнота: {results['recall']:.4f}")
print(f"F1-мера: {results['f1']:.4f}")
# Матрица ошибок
cm = confusion_matrix(y_true, y_pred)
print(f"\n"Матрица ошибок:")
print(cm)
# ROC-кривая (если доступны вероятностные предсказания)
if y_prob is not None and len(np.unique(y_true)) == 2:
fpr, tpr, thresholds = roc_curve(y_true, y_prob[:, 1])
roc_auc = auc(fpr, tpr)
results['roc_auc'] = roc_auc
# Построение ROC-кривой
plt.figure(figsize=(8, 6))
plt.plot(fpr, tpr, color='darkorange', lw=2,
label=f'ROC-кривая (AUC = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('Доля ложноположительных результатов')
plt.ylabel('Доля истинно положительных результатов')
plt.title(f'{model_name} ROC-кривая')
plt.legend(loc="lower right")
plt.grid(True)
plt.show()
self.evaluation_results[model_name] = results
return results
def evaluate_regression(self, y_true, y_pred, model_name="Модель"):
"""Оценка регрессионной модели"""
results = {}
# Базовые метрики
mse = np.mean((y_true - y_pred) ** 2)
rmse = np.sqrt(mse)
mae = np.mean(np.abs(y_true - y_pred))
# Оценка R²
ss_res = np.sum((y_true - y_pred) ** 2)
ss_tot = np.sum((y_true - np.mean(y_true)) ** 2)
r2 = 1 - (ss_res / ss_tot)
results['mse'] = mse
results['rmse'] = rmse
results['mae'] = mae
results['r2'] = r2
print(f"\n"{model_name} Результаты оценки регрессии:")
print(f"Среднеквадратичная ошибка (MSE): {mse:.4f}")
print(f"Среднеквадратичная ошибка (RMSE): {rmse:.4f}")
print(f"Средняя абсолютная ошибка (MAE): {mae:.4f}")
print(f"Оценка R²: {r2:.4f}")
# График предсказанных и фактических значений
plt.figure(figsize=(8, 6))
plt.scatter(y_true, y_pred, alpha=0.6)
plt.plot([y_true.min(), y_true.max()], [y_true.min(), y_true.max()],
'r--', lw=2)
plt.xlabel('Фактические значения')
plt.ylabel('Предсказанные значения')
plt.title(f'{model_name}: предсказанные против фактических значений')
plt.grid(True)
plt.show()
self.evaluation_results[model_name] = results
return results
def compare_models(self):
"""Сравнить все оценённые модели"""
if not self.evaluation_results:
print("Нет сопоставимых результатов оценки моделей")
return
print("\n"Сравнение моделей:")
print("-" * 50)
# Создать таблицу сравнения
comparison_data = []
for model_name, results in self.evaluation_results.items():
row = [model_name]
for metric, value in results.items():
row.append(f"{value:.4f}")
comparison_data.append(row)
# Вывести таблицу
headers = ["Название модели"] + list(self.evaluation_results.values())[0].keys()
print("\t".join(headers))
for row in comparison_data:
print("\t".join(row))
# Пример использования
evaluator = ModelEvaluator()
# Оценка модели классификации
y_pred_class = best_model.predict(X_test)
y_prob_class = best_model.predict_proba(X_test)
evaluator.evaluate_classification(y_test, y_pred_class, y_prob_class, "Лучшая модель классификации")
# Сравнение всех моделей
evaluator.compare_models()
Этап 6: Развертывание модели
Стратегия развертывания
Развёртывание модели — это процесс ввода модели в практическое использование, подобно выводу разработанного продукта на рынок.
Методы развертывания
- Пакетное прогнозирование: периодическая обработка больших объёмов данных
- Прогнозирование в реальном времени: онлайн-сервис, мгновенный ответ
- Встраиваемое развёртывание: интеграция модели в существующие системы
- Периферийное развёртывание: запуск модели на устройствах
Пример развёртывания модели
Пример
import pickle
import json
from datetime import datetime
class ModelDeployer:
def __init__(self):
self.deployed_models = {}
self.deployment_logs = []
def save_model(self, model, model_name, filepath=Отсутствует):
"""Сохранение модели"""
if filepath is None:
filepath = f"{model_name}.pkl"
with open(filepath, 'wb') as f:
pickle.dump(model, f)
print(f"Модель {model_name} сохранена в {filepath}")
# Записать журнал развёртывания
log_entry = {
'timestamp': datetime.now().isoformat(),
'action': 'save_model',
'model_name': model_name,
'filepath': filepath
}
self.deployment_logs.append(log_entry)
return filepath
def load_model(self, model_name, filepath):
"""Загрузить модель"""
with open(filepath, 'rb') as f:
model = pickle.load(f)
self.deployed_models[model_name] = model
print(f"Модель {model_name} загружена из {filepath}")
# Записать журнал развёртывания
log_entry = {
'timestamp': datetime.now().isoformat(),
'action': 'load_model',
'model_name': model_name,
'filepath': filepath
}
self.deployment_logs.append(log_entry)
return model
def create_prediction_service(self, model_name, encoders=None, scaler=None):
"""Создать сервис прогнозирования"""
if model_name not in self.deployed_models:
raise ValueError(f"Модель {model_name} не развернута")
model = self.deployed_models[model_name]
def predict_service(input_data):
"""Функция сервиса прогнозирования"""
try:
# Предварительная обработка данных
if encoders:
for col, encoder in encoders.items():
if col in input_data.columns:
input_data[col] = encoder.transform(input_data[col])
if scaler:
numeric_cols = input_data.select_dtypes(include=['number']).columns
input_data[numeric_cols] = scaler.transform(input_data[numeric_cols])
# Предсказание
prediction = model.predict(input_data)
# Если это модель классификации, также возвращать вероятности
if hasattr(model, 'predict_proba'):
probability = model.predict_proba(input_data)
return {
'prediction': prediction.tolist(),
'probability': probability.tolist(),
'status': 'success',
'timestamp': datetime.now().isoformat()
}
else:
return {
'prediction': prediction.tolist(),
'status': 'success',
'timestamp': datetime.now().isoformat()
}
except Exception as e:
return {
'error': str(e),
'status': 'error',
'timestamp': datetime.now().isoformat()
}
# Записать лог создания сервиса
log_entry = {
'timestamp': datetime.now().isoformat(),
'action': 'create_service',
'model_name': model_name
}
self.deployment_logs.append(log_entry)
return predict_service
def monitor_model(self, model_name, input_data, true_labels=Отсутствует):
"""Мониторинг производительности модели"""
if model_name not in self.deployed_models:
raise ValueError(f"Модель {model_name} не развернута")
predict_service = self.create_prediction_service(model_name)
# Получить результаты прогноза
result = predict_service(input_data)
# Информация мониторинга
monitoring_info = {
'timestamp': datetime.now().isoformat(),
'model_name': model_name,
'input_shape': input_data.shape,
'prediction_count': len(result.get('prediction', [])),
'status': result.get('status', 'unknown')
}
# Если истинные метки доступны, вычислить метрики производительности
if true_labels is not None and 'prediction' in result:
predictions = result['prediction']
if len(predictions) == len(true_labels):
accuracy = accuracy_score(true_labels, predictions)
monitoring_info['accuracy'] = accuracy
print("Информация о мониторинге модели:")
for key, value in monitoring_info.items():
print(f" {key}: {value}")
return monitoring_info
def get_deployment_logs(self):
"""Получить журналы развертывания"""
return self.deployment_logs
# Пример использования
deployer = ModelDeployer()
# Сохранить лучшую модель
model_path = deployer.save_model(best_model, "best_classification_model")
# Загрузить модель
deployer.load_model("best_classification_model", model_path)
# Создать сервис предсказаний
prediction_service = deployer.create_prediction_service(
"best_classification_model", encoders, scaler
)
# Использовать сервис предсказаний
test_input = X_test.head(5)
prediction_result = prediction_service(test_input)
print("\n"Результаты предсказания:")
print(json.dumps(prediction_result, indent=2, ensure_ascii=False))
# Мониторинг модели
deployer.monitor_model("best_classification_model", test_input, y_test.head(5).values)
Пример полного рабочего процесса
Пример
class MLProjectPipeline:
def __init__(self):
self.data_collector = DataCollector()
self.data_preparer = None
self.model_trainer = ModelTrainer()
self.model_evaluator = ModelEvaluator()
self.model_deployer = ModelDeployer()
def run_complete_pipeline(self, target_column):
"""Запустить полный конвейер машинного обучения"""
print("=" * 60)
print("Полный рабочий процесс проекта машинного обучения")
print("=" * 60)
# 1. Сбор данных
print("\nШаг 1: Сбор данных")
print("-" * 30)
user_data = self.data_collector.collect_user_data(1000)
behavior_data = self.data_collector.collect_behavior_data(5000)
# Объединить данные (упрощённый пример)
merged_data = pd.merge(user_data, behavior_data, on='user_id', how='inner')
# Создать целевую переменную (пример: совершит ли покупку)
merged_data['purchased'] = (merged_data['behavior_type'] == 'Purchase').astype⟦⟧int(int)
# 2. Подготовка данных
print("\nШаг 2: Подготовка данных")
print("-" * 30)
# Выбор столбцов признаков
feature_columns = ['age', 'gender', 'purchase', 'duration']
if all(col in merged_data.columns for col in feature_columns):
data_for_ml = merged_data[feature_columns + ['purchased']].copy()
# Обработка категориальных переменных
data_for_ml['gender'] = data_for_ml['].map({'Male': 0, 'Female': 1})
data_for_ml['city'] = data_for_ml['city'].map({'Beijing': 0, 'Shanghai': 1, 'Guangzhou': 2})
# Подготовка данных
self.data_preparer = DataPreparer(data_for_ml)
splits, encoders, scaler = self.data_preparer.prepare_pipeline('purchased')
# 3. Обучение модели
print("\nШаг 3: Обучение модели")
print("-" * 30)
# Регистрация модели
self.model_trainer.register_model(
'Logistic Regression', LogisticRegression(random_state=42), 'classification'
)
self.model_trainer.register_model(
'Random Forest', RandomForestClassifier(n_estimators=100, random_state=42), 'classification'
)
# Обучите модель
trained_models = self.model_trainer.train_all_models(
splits['X_train'], splits['y_train']
)
# 4. Оценка модели
print("\nШаг 4: Оценка модели")
print("-" * 30)
results = self.model_trainer.evaluate_models(
splits['X_test'], splits['y_test']
)
best_name, best_model = self.model_trainer.get_best_model(results)
# 5. Развертывание модели
print("\nШаг 5: Развертывание модели")
print("-" * 30)
# Сохранить модель
model_path = self.model_deployer.save_model(best_model, "production_model")
# Создать сервис предсказаний
prediction_service = self.model_deployer.create_prediction_service(
"production_model"
)
# Тестирование сервиса предсказаний
test_input = splits['X_test'].head(3)
prediction_result = prediction_service(test_input)
print("\nРезультат тестирования сервиса предсказаний:")
print(json.dumps(prediction_result, indent=2, ensure_ascii=False))
print("\n" + "=" * 60)
print("Рабочий процесс проекта машинного обучения завершён!")
print("=" * 60)
return {
'data': data_for_ml,
'splits': splits,
'best_model': best_model,
'best_model_name': best_name,
'evaluation_results': results,
'prediction_service': prediction_service
}
else:
print("Столбцы данных неполны, невозможно продолжить рабочий процесс")
return None
# Запуск полного рабочего процесса
pipeline = MLProjectPipeline()
project_results = pipeline.run_complete_pipeline('purchased')