Вероятностное мышление
Представьте, что вы учите друга распознавать фотографии кошек и собак. Вы не сказали бы: «Это изображение на 100% кошка»; вместо этого вы могли бы сказать: «Это изображение, вероятно, на 90% кошка, потому что у неё острые уши и усы». Это выражение вероятности — именносуть вероятностного мышления.
В реальном мире данные, обрабатываемые моделями машинного обучения, почти всегда полнынеопределённости: изображения могут быть размытыми, речь может содержать шум, а поведение пользователей трудно предсказать. Вероятность даёт нам строгий математический язык для описания, количественной оценки и обработки этой неопределённости. Она является не только основой продвинутых моделей (таких как байесовские сети и гауссовские процессы), но и ключом к пониманию выходных данных модели, оценке уверенности предсказаний и принятию устойчивых решений.
Короче говоря,вероятностное мышление — этомост, который превращаетдогадкив измеримую уверенность,, и это важный шаг для машинного обучения, позволяющий перейти отжёстко заданных правилкинтеллектуальному рассуждению.
Краткое введение в основные понятия теории вероятностей
Прежде чем углубляться в применения машинного обучения, нам нужно определить несколько фундаментальных понятий теории вероятностей.
1. Что такое вероятность?
Вероятность— это мера правдоподобия наступления события, принимающая значения от 0 до 1.
P(A) = 0: Событие Aне можетпроизойти.P(A) = 1: Событие Aобязательнопроизойдёт.0 < P(A) < 1: Событие A происходит свероятностью.
В машинном обучении событием может быть: это изображение — кошка, пользователь завтра кликнет по этой рекламе, следующее слово —«привет»。
2. Условная вероятность: мир взаимосвязан
Условная вероятность P(A|B)обозначает вероятность наступления события A при условии, что событие Bуже произошло. Это ключевое понятие в машинном обучении.
Понятная аналогия:
P(下雨): Общая вероятность дождя сегодня (априорная вероятность).P(下雨 | 乌云密布): Вероятность дождя сегодня при условии, что уже было замечено «сгущение тёмных туч» (апостериорная вероятность). Очевидно, последнее значение вероятности выше.
Формула:
P(A|B) = P(A 且 B) / P(B), что требуетP(B) > 0。
3. Теорема Байеса: вывод причин по исходам
Теорема Байеса — это изящное применение условной вероятности; она учит нас использоватьновые свидетельства (данные) для обновления нашего убеждения в гипотезе。
Формула:
P(假设 | 数据) = [ P(数据 | 假设) * P(假设) ] / P(数据)
Давайте разберём эту «магическую формулу».:
P(假设):Априорная вероятность. До просмотра каких-либо данных это наше первоначальное убеждение о гипотезе.- Например: до получения письма мы считаем, что вероятность того, что любое письмо является спамом, равна 30%.
P(数据 | 假设):Правдоподобие. Если гипотеза верна, какова вероятность того, что мы наблюдаем текущий набор данных?- Например: если письмо действительно является спамом, какова вероятность того, что в нём появятся такие слова, как «free» и «winning»?
P(数据):Свидетельство. Общая вероятность наблюдения текущих данных, обычно нормировочная константа.P(假设 | 数据):Апостериорная вероятность. После наблюдения данных это наше обновлённое убеждение о гипотезе.Это цель, к которой мы в конечном счёте стремимся!- Например: после того как мы увидели, что письмо содержит такие слова, как «free» и «winning», обновлённая вероятность того, что это письмо является спамом, равна 95%.
Суть теоремы Байеса: она обеспечивает систематическую основу, которая объединяет нашиаприорные знания(P(假设)) снаблюдаемыми данными(P(数据|假设)) чтобы получить более точноеобновлённое понимание.(P(假设|数据))。
Часть 2: Три роли вероятности в машинном обучении
Вероятностное мышление пронизывает каждый этап машинного обучения, играя в основном следующие три роли:
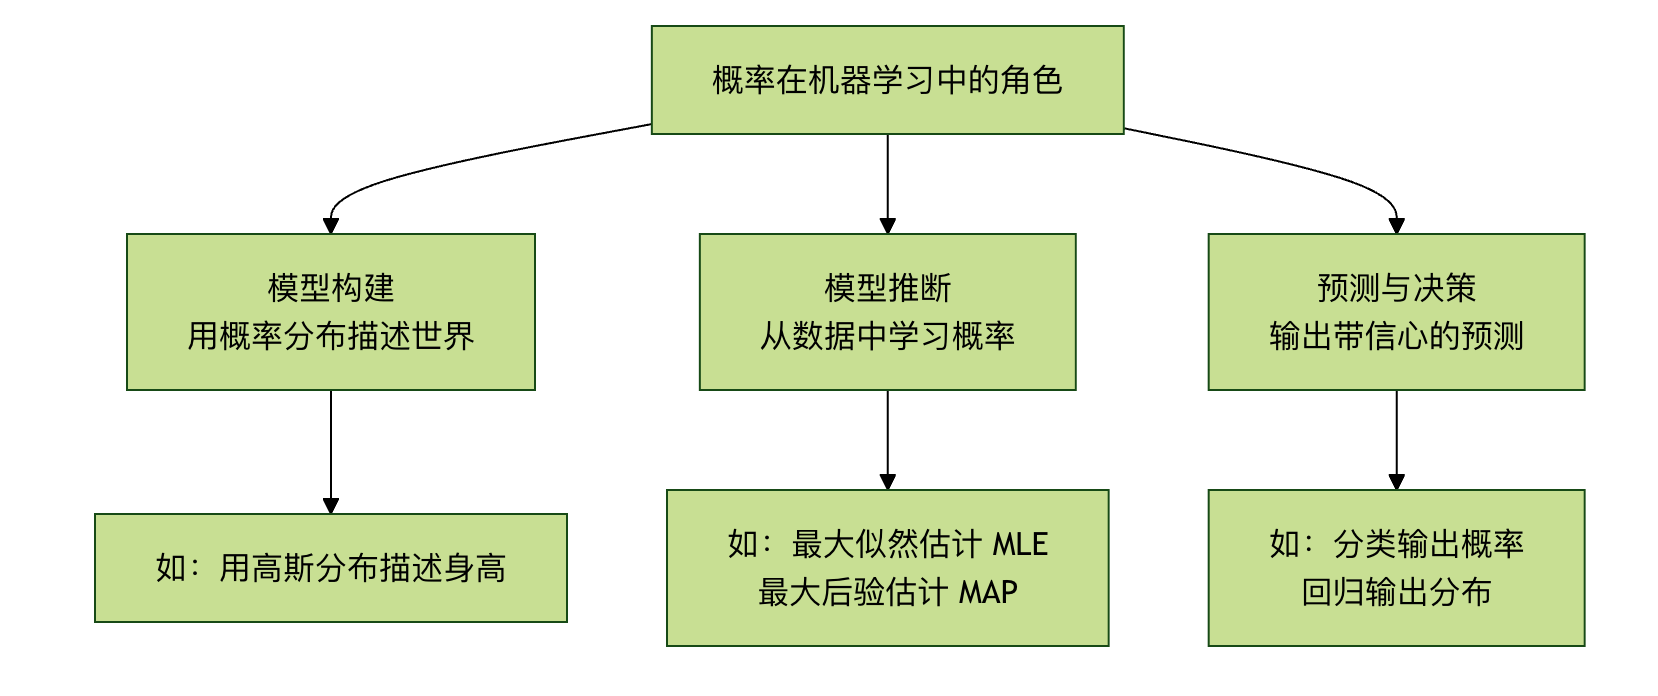
Роль 1: Построение модели — описание мира с помощью вероятностей
Многие модели машинного обучения по сути являютсявероятностными моделями. Мы предполагаем, что наблюдаемые данные порождаются некоторым лежащим в основе вероятностным распределением.
Пример 1: Логистическая регрессияОна напрямую выдаёт значение вероятности. Для задачи бинарной классификации (кошка/собака) модель логистической регрессии не просто говорит «это кошка»; вместо этого она выдаётP(类别=猫 | 图像数据)=0.9, показывая, что модель на 90% уверена, что это кошка.
Пример 2: Наивный байесовский классификаторОн напрямую применяет теорему Байеса для классификации. Он предполагает, что признаки независимы друг от друга, и вычисляетP(垃圾邮件 | 词1, 词2...), затем выбирает категорию с более высокой вероятностью.
Пример
# Предположим, мы оценили следующие вероятности по данным (правдоподобия и априорные вероятности)
P_word_given_spam= {"free": 0.8, "meeting": 0.1} # Вероятность появления "free" в спаме
P_word_given_normal= {"free": 0.1, "meeting": 0.9} # Вероятность появления "meeting" в обычных письмах
P_garbage= 0.3 # Априорная вероятность: вероятность того, что любое электронное письмо — спам
P_normal= 0.7 # Априорная вероятность: вероятность того, что любое электронное письмо — нормальное
# Для электронного письма, содержащего "free" и "meeting", вычислите апостериорную вероятность того, что это спам (упрощённый расчёт)
# Согласно теореме Байеса (игнорируйте знаменатель свидетельства, так как он сокращается при сравнении)
score_spam=P_word_given_spam["free"]* P_word_given_spam["meeting"]* P_spam
score_normal=P_word_given_normal["free"]* P_word_given_normal["meeting"]* P_normal
print(f"Оценка спама: {score_垃圾:.4f}")
print(fОценка нормального письма: {score_normal:.4f})
ifscore_spam>score_normal:
print("Предсказание: это спам-письмо.")
else:
print("Предсказание: это обычное письмо.")
Роль 2: Вывод и обучение модели — поиск наиболее вероятного объяснения
Как по данным найти вероятностную модель, которая с наибольшей вероятностью породила эти данные (т. е. обучить параметры модели)? Вот две ключевые идеи:
1. Оценка максимального правдоподобия Основная идея: найти параметры модели, которые делаютвероятность наблюдения текущих данных(правдоподобие) максимальной.Аналогия: Детектив, раскрывающий дело. Детектив спрашивает: «При каком мотиве и способе наиболее вероятно получить все следы на месте преступления, которые мы сейчас видим?» MLE — это именно поиск этой «наиболее вероятной» гипотезы.Преимущества: основано на данных, полностью опирается на данные.Потенциальные недостатки: при малом объёме данных может возникнуть переобучение; игнорируются априорные знания.
2. Оценка максимальной апостериорной вероятности
Основная идея: основываясь на максимальном правдоподобии, она учитывает нашиаприорные знания о параметрах(P(假设)), и находит параметры, максимизирующие апостериорную вероятность.Аналогия: Опытный детектив, раскрывающий дело. Он не только изучает следы на месте преступления (данные), но и сочетает известный образ действий подозреваемого (априорные сведения), чтобы сделать всестороннее суждение.Преимущества: позволяет использовать знания предметной области, работает более устойчиво на малых наборах данных и предотвращает переобучение.
| Критерий | Полное название | Цель оптимизации | Основная идея | Яркая аналогия |
|---|---|---|---|---|
| MLE | Оценка максимального правдоподобия | Максимизировать P(data | parameters) | На основе данных: по наблюдаемым данным найдите параметры модели, которые с наибольшей вероятностью сгенерировали эти данные. | Детектив, раскрывающий дело: определение подозреваемого исключительно на основе улик с места преступления |
| MAP | Оценка максимальной апостериорной вероятности | Максимизировать P(параметры | данные) | Априорные знания + данные: объедините априорные знания и наблюдаемые данные, вычислите апостериорную вероятность параметров и возьмите максимум | Судья, решающий дело: вынесение решения на основе правовых норм (априорные знания) и доказательств (данные) |
Роль 3: Прогнозирование и принятие решений — вывод ответов с уверенностью
A good model should not only give predictions, but also provideнеопределённость прогнозов。
- Classification tasks: выведите вероятность каждой категории (например, cat: 0.85, dog: 0.12, rabbit: 0.03). Это содержит больше информации, чем простой вывод "cat". Мы можем принимать решения на основе порогов вероятности (например, принимать решение только тогда, когда наибольшая вероятность > 0.8).
- Regression tasks: Продвинутые модели регрессии (такие как вероятностная регрессия, байесовская линейная регрессия) могут предсказыватьраспределение(например, гауссово распределение), а не просто точечную оценку. Модель сообщит вам: "Предсказанная цена составляет 1 миллион юаней, и есть 95%-я уверенность, что истинная цена находится между 950,000 и 1,050,000 юаней."
Часть 3: Практика — решение простой задачи с помощью вероятностного мышления
Сценарий: Простой тест на заболевание. Дано:
- Распространённость заболевания в общей популяции (априорная вероятность)
P(病) = 0.001。 - Точность теста: если человек действительно болен, вероятность положительного результата теста
P(阳|病) = 0.99(чувствительность). Если человек не болен, вероятность отрицательного результата тестаP(阴|健康) = 0.99(специфичность). - Вопрос: Если у человека положительный результат теста, вероятность того, что он действительно болен
P(病|阳)чему равна?
Ловушка интуиции: Многие люди подумали бы, что она составляет целых 99%. Давайте воспользуемся теоремой Байеса, чтобы вычислить.
Пример
P_disease = 0.001 # P(disease)
P_positive_given_disease = 0.99 # P(positive|disease)
P_negative_given_healthy = 0.99 # P(negative|healthy)
# Вычислить производные вероятности
P_healthy = 1 - P_disease # P(healthy)
P_positive_given_healthy = 1 - P_negative_given_healthy # P(positive|healthy) = 1 - специфичность
# Вычислить полную вероятность P(positive)
# P(positive) = P(positive|disease)*P(disease) + P(positive|healthy)*P(healthy)
P_positive = (P_positive_given_disease * P_disease) + (P_positive_given_healthy * P_healthy)
# Применить теорему Байеса для вычисления P(disease|positive)
P_disease_given_positive = (P_positive_given_disease * P_disease) / P_positive
print(f"Даже если тест положительный, апостериорная вероятность того, что болезнь действительно есть, P(disease|positive), составляет всего: {P_disease_given_positive:.2%}")
Результаты выполнения и размышления:
Вы будете удивлены, обнаружив, чтоP(病|阳)это составляет всего около9%! Это потому, что распространённость заболевания очень низкая (низкая априорная вероятность), что приводит к гораздо большему числу ложноположительных результатов, чем истинно положительных. Этот пример наглядно демонстрирует:
- Важность априорных знаний: Игнорирование базовой частоты может привести к серьёзным ошибкам.
- Сила байесовского рассуждения: оно заставляет нас учитывать всю релевантную информацию (базовую частоту, точность теста).
- Практичность вероятностного мышления: оно может исправлять систематические искажения в нашей интуиции.
Итоги и дальнейшие направления
Ключевые выводы из вероятностного мышления:
- Примите неопределённость: мир неопределён, и вывод моделей также должен быть вероятностным.
- Байес — это философия обновления: С помощью
Prior + Data -> Posteriorфреймворка постоянно пересматривайте представления с учётом новых свидетельств. - Решения требуют вероятности: Хороший прогноз должен сопровождаться «оценкой уверенности», чтобы поддерживать решения с контролируемым риском.
Если вы хотите углубиться:
- Теоретический уровень: Изучитевероятностные графические модели, которые элегантно представляют сложные вероятностные зависимости между переменными с помощью графовых структур.
- Алгоритмический уровень: Исследуйтевариационный выводиметоды Монте-Карло с марковскими цепями, которые являются мощными инструментами для решения сложных байесовских моделей.
- Прикладной уровень: Исследуйтебайесовскую оптимизацию(для настройки гиперпараметров),гауссовские процессы(для регрессии и оптимизации), иглубокие генеративные модели(такие как вариационные автоэнкодеры (VAE), диффузионные модели).