Limpieza de datos
En el aprendizaje automático, a menudo escuchamos la frase: "Basura entra, basura sale", que ilustra vívidamente el impacto decisivo de la calidad de los datos en el rendimiento del modelo.
Imagina que eres un chef preparando un delicioso platillo. Aunque tu habilidad culinaria sea excelente, si los ingredientes no están frescos, tienen arena o están incompletos, el plato final sin duda se verá muy afectado.
En el aprendizaje automático,los datos brutosson nuestro "ingrediente", yla limpieza de datoses ese crucial proceso de "preparación de ingredientes". Su objetivo es identificar, corregir o eliminar errores, inconsistencias, duplicados e incompletitudes en los datos, preparando ingredientes limpios y de alta calidad para la posterior "cocción" del modelo.
Este artículo te guiará sistemáticamente a través de los conceptos centrales y los métodos comunes de la limpieza de datos, y mediante ejemplos de código claros, te permitirá dominar esta habilidad esencial para los científicos de datos.
1. ¿Por qué es tan importante la limpieza de datos?
Antes de profundizar en los detalles técnicos, comprendamos por qué la limpieza de datos es un paso indispensable en el flujo de trabajo del aprendizaje automático.
1.1 Mejora el rendimiento y la precisión del modelo
Los datos sucios (como valores atípicos o incorrectos) pueden inducir al modelo a aprender patrones erróneos. Los datos limpios permiten que el modelo capture con mayor precisión los patrones reales de los datos, logrando así predicciones más fiables.
1.2 Garantiza la confiabilidad de los resultados del análisis
Ya sea un análisis exploratorio de datos o una decisión comercial final, las conclusiones basadas en datos erróneos son peligrosas. La limpieza de datos asegura que los cimientos del análisis sean sólidos y fiables.
1.3 Mejora la estabilidad del algoritmo
Muchos algoritmos de aprendizaje automático son muy sensibles a la calidad de los datos. Por ejemplo, los algoritmos basados en distancia (como KNN y SVM) se ven gravemente afectados por los valores atípicos, mientras que los valores faltantes pueden hacer que toda la muestra sea inutilizable.
1.4 Ahorra recursos computacionales y tiempo
Eliminar datos irrelevantes y duplicados puede reducir el tamaño del conjunto de datos, disminuyendo así el costo computacional y el tiempo de entrenamiento del modelo.
Para comprender de manera más intuitiva la posición de la limpieza de datos en el flujo completo del aprendizaje automático, consulta el siguiente diagrama de flujo:
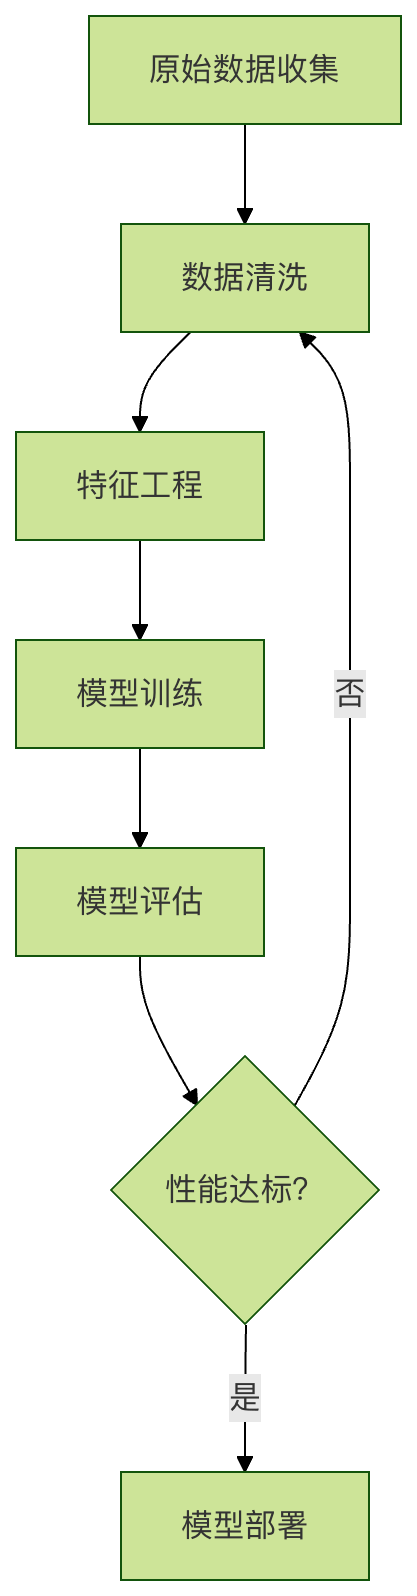
Como se puede ver en la figura anterior, la limpieza de datos es el primer paso del preprocesamiento, y cuando el rendimiento del modelo es insatisfactorio, a menudo debemos volver a este paso para revisar y mejorar la calidad de los datos.
2. Problemas de datos comunes y estrategias de limpieza
La limpieza de datos generalmente aborda varias categorías de problemas comunes. Podemos comprenderlo rápidamente mediante una tabla simple:
| Tipo de problema | Descripción | Impacto potencial | Estrategias de limpieza comunes |
|---|---|---|---|
| Valores faltantes | Ciertos campos en los registros de datos están vacíos (NaN, NULL). | Provoca descarte de muestras, pérdida de información y errores de cálculo. | Eliminar, rellenar (media/mediana/moda/predicción). |
| Valores atípicos | Valores extremos que se desvían claramente de la mayoría de los datos. | Distorsionan los resultados estadísticos y afectan el rendimiento del modelo. | Identificar (IQR, Z-Score) y luego eliminar o corregir. |
| Valores duplicados | Registros idénticos en el conjunto de datos. | Hacen que el modelo se sesgue hacia muestras duplicadas, afectando la capacidad de generalización. | Identificar y eliminar duplicados. |
| Inconsistencias | Formatos, unidades o codificaciones de datos no uniformes (por ejemplo, "男", "Male", "M"). | Provocan errores de agrupación y análisis. | Estandarización, normalización, mapeo y transformación. |
| Valores incorrectos | Valores claramente ilógicos (por ejemplo, edad de -1 o 300 años). | Generan resultados de análisis sin sentido. | Corregir según la lógica de negocio o tratar como faltante. |
A continuación, usaremos la biblioteca de Pythonpandasynumpypara demostrar cómo resolver estos problemas mediante código concreto.
3. Práctica: Uso de Python para la limpieza de datos
Supongamos que tenemos un conjunto de datos llamadocustomer_data.csvde clientes, que contiene algunos problemas típicos de calidad de datos.
3.1 Preparación del entorno y carga de datos
Primero, asegúrate de tener instaladas las bibliotecas necesarias y luego carga los datos.
Ejemplo
import pandas as pd
import numpy as np
# Cargar el conjunto de datos
df = pd.read_csv('customer_data.csv') # Reemplaza con la ruta de tu archivo
# Ver la información básica de los datos y las primeras filas
print("Forma del conjunto de datos (filas, columnas):", df.shape)
print("\nPrimeras 5 filas de los datos:")
print(df.head())
print("\nInformación básica de los datos:")
print(df.info())
print("\nDescripción estadística de los datos:")
print(df.describe())
3.2 Manejo de valores faltantes
Descubrir los valores faltantes es el primer paso.pandasproporciona métodos convenientes.
Ejemplo
print("Número de valores faltantes por columna:")
print(df.isnull().sum())
# 2. Manejo de valores faltantes - Método 1: Eliminar
# Eliminar cualquier fila que contenga valores faltantes (adecuado cuando hay pocos valores faltantes)
df_dropped = df.dropna()
print(f"\nDespués de eliminar los valores faltantes, forma de los datos: {df_dropped.shape}")
# 3. Manejo de valores faltantes - Método 2: Rellenar
# El método más común es rellenar según las características de la columna
df_filled = df.copy()
# Para columnas numéricas (como 'Edad'), rellenar con la mediana (más robusta que la media frente a valores atípicos)
if 'Edad' in df_filled.columns:
df_filled['Edad'].fillna(df_filled['Edad'].median(), inplace=True)
# Para columnas categóricas (como 'Ciudad'), rellenar con la moda (el valor más frecuente)
if 'Ciudad' in df_filled.columns:
df_filled['Ciudad'].fillna(df_filled['Ciudad'].mode()[0], inplace=True)
# Para columnas que pueden cambiar con el tiempo (como 'Último monto de compra'), a veces rellenar con 0 tiene más sentido comercial
if 'Último monto de compra' in df_filled.columns:
df_filled['Último monto de compra'].fillna(0, inplace=True)
print("\nDespués de rellenar los valores faltantes, número de valores faltantes por columna:")
print(df_filled.isnull().sum())
3.3 Identificación y manejo de valores atípicos
El manejo de valores atípicos debe hacerse con cautela, ya que a veces representan eventos especiales importantes.
Ejemplo
if 'Ingreso anual' in df_filled.columns:
# Método 1: Identificar usando el método del rango intercuartílico (IQR)
Q1 = df_filled['Ingreso anual'].quantile(0.25)
Q3 = df_filled['Ingreso anual'].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
# Encontrar valores atípicos
outliers = df_filled[(df_filled['Ingreso anual'] < lower_bound) | (df_filled['Ingreso anual'] > upper_bound)]
print(f"\nNúmero de valores atípicos en 'Ingreso anual' encontrados con el método IQR: {len(outliers)}")
# Manejo de valores atípicos: aquí se elige truncar con los valores de los límites superior e inferior (Winsorization)
df_filled['Ingreso anual'] = np.where(df_filled['Ingreso anual'] > upper_bound, upper_bound,
np.where(df_filled['Ingreso anual'] < lower_bound, lower_bound, df_filled['Ingreso anual']))
print("Se ha realizado el truncamiento de los valores atípicos de 'Ingreso anual'.")
3.4 Manejo de valores duplicados
Los registros duplicados aumentan la carga computacional y pueden introducir sesgos.
Ejemplo
duplicate_rows = df_filled.duplicated()
print(f"\nNúmero de filas completamente duplicadas encontradas: {duplicate_rows.sum()}")
# Eliminar estas filas duplicadas, conservando solo la primera aparición
df_cleaned = df_filled.drop_duplicates()
print(f"Después de eliminar los valores duplicados, forma de los datos: {df_cleaned.shape}")
3.5 Manejo de inconsistencias
Asegurar la uniformidad de los formatos y valores de los datos.
Ejemplo
if 'Ciudad' in df_cleaned.columns:
df_cleaned['Ciudad'] = df_cleaned['Ciudad'].str.title()
# 2. Mapear valores unificados: por ejemplo, unificar la información de género en 'Masculino' y 'Femenino'
if 'Género' in df_cleaned.columns:
gender_mapping = {'male': 'Masculino', 'female': 'Femenino', 'M': 'Masculino', 'F': 'Femenino'}
df_cleaned['Género'] = df_cleaned['Género'].replace(gender_mapping)
# También se puede usar la función .map(), pero .replace() es más flexible, los valores no especificados se mantienen sin cambios
# 3. Convertir tipos de datos: asegurar que las columnas numéricas sean de tipo numérico
if 'Edad' in df_cleaned.columns:
df_cleaned['Edad'] = pd.to_numeric(df_cleaned['Edad'], errors='coerce') # errors='coerce' convierte los errores a NaN
# Después de la conversión, se puede volver a rellenar con la mediana los nuevos NaN generados por la conversión.
df_cleaned['Edad'].fillna(df_cleaned['Edad'].median(), inplace=True)
print("\n¡Limpieza de datos completada! Ver las primeras 5 filas de los datos limpios:")
print(df_cleaned.head())
4. Resumen y mejores prácticas
A través de los pasos anteriores, hemos completado una ronda básica de limpieza de datos. Recuerda, la limpieza de datos no es un paso único, sino un proceso iterativo. A continuación, algunas mejores prácticas:
- Primero explorar, luego limpiar: Antes de comenzar a limpiar, asegúrate de usar
df.describe()、df.info(), visualización (como histogramas, diagramas de caja) y otros medios para comprender bien tus datos. - Respalda los datos originales: Conserva siempre una copia de los datos originales y sin modificar. Todas las operaciones de limpieza deben realizarse sobre la copia.
- Registra los pasos de limpieza: Documenta tu lógica de limpieza (por ejemplo, por qué usar la mediana para rellenar, cómo determinar los límites de los valores atípicos). Esto es crucial para la reproducibilidad del proyecto y la colaboración en equipo.
- Integra la lógica de negocio: La limpieza de datos no es una operación puramente matemática. Por ejemplo, "edad=0" es un error en datos demográficos, pero puede ser razonable en datos de productos para bebés. Mantén siempre la comunicación con expertos del dominio.
- Itera: Después de la limpieza, se entra en la fase de modelado. Si el rendimiento del modelo no es bueno, se debe revisar la calidad de los datos y posiblemente ajustar la estrategia de limpieza.
La limpieza de datos puede ocupar60%-80%el tiempo de un proyecto de ciencia de datos, aunque es tediosa, es la piedra angular para construir modelos de aprendizaje automático potentes y fiables.
Otras extensiones