Introducción al aprendizaje automático
El aprendizaje automático (Machine Learning) es una rama de la inteligencia artificial (IA) que permite a los sistemas informáticos aprender y mejorar automáticamente su rendimiento utilizando datos y algoritmos.
El aprendizaje automático es un campo en constante evolución que está cambiando nuestra forma de interactuar con la tecnología y proporciona nuevas herramientas y métodos para resolver problemas complejos.
El aprendizaje automático es una técnica que permite a las computadoras aprender a través de los datos y se utiliza ampliamente en todos los sectores.
Imagina que le estás enseñando a un niño a reconocer diferentes animales. No necesitas decirle reglas complejas como "todos los gatos tienen dos orejas, cuatro patas, bigotes...", sino mostrarle muchas fotos de gatos y decirle "esto es un gato". Poco a poco, el niño podrá reconocer por sí mismo gatos que nunca antes había visto.
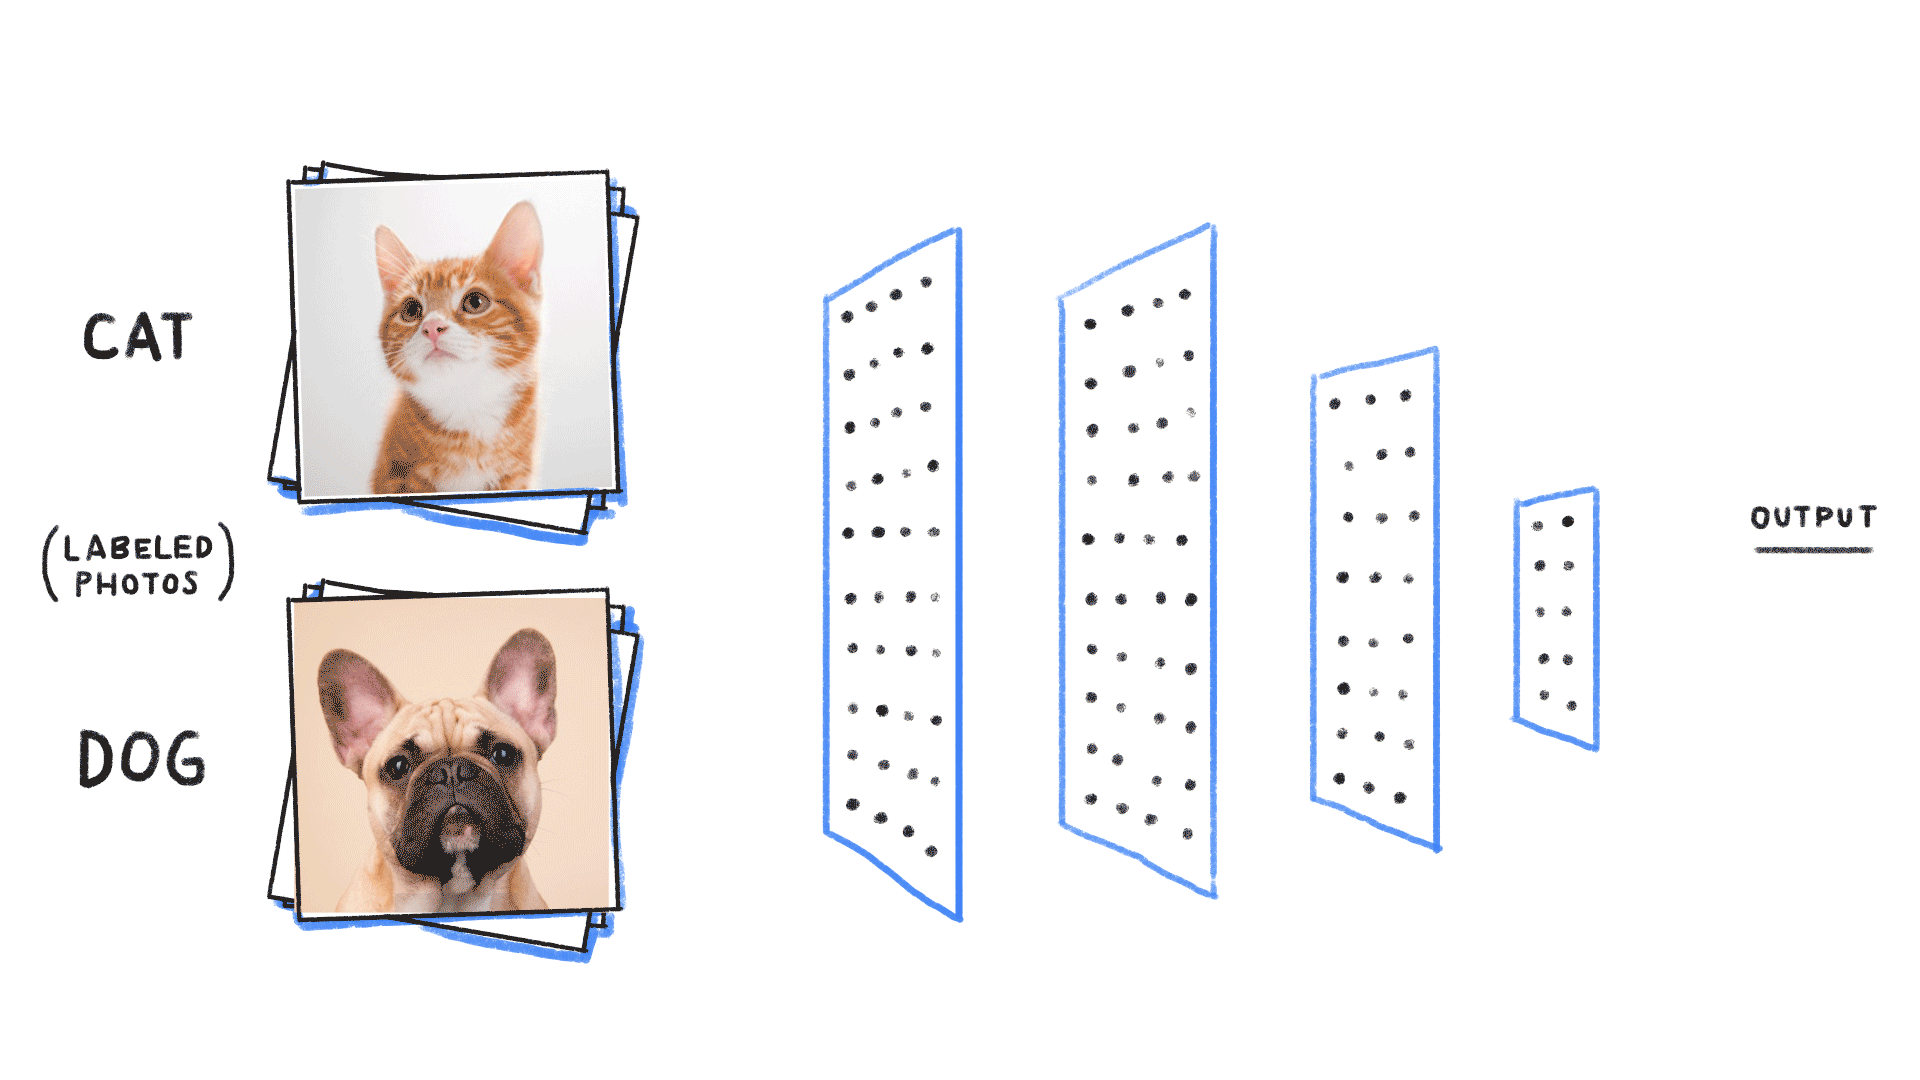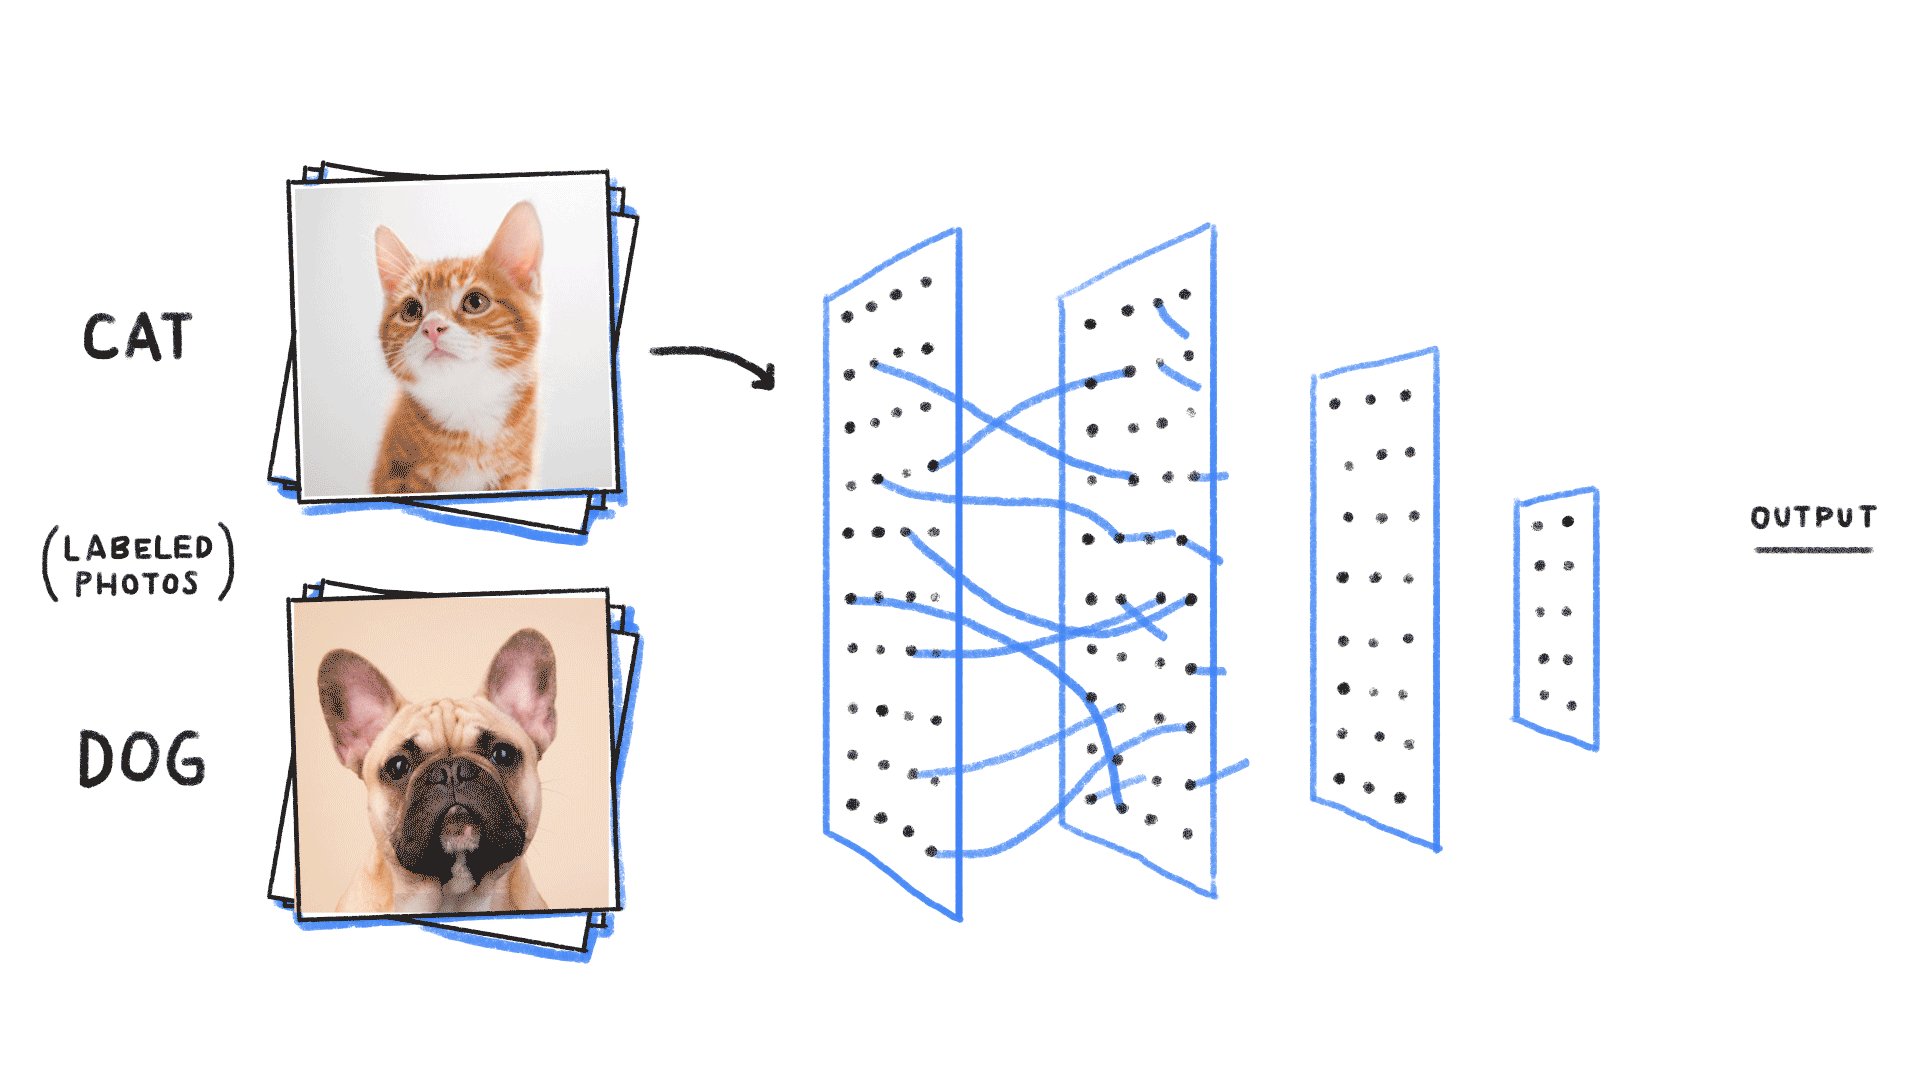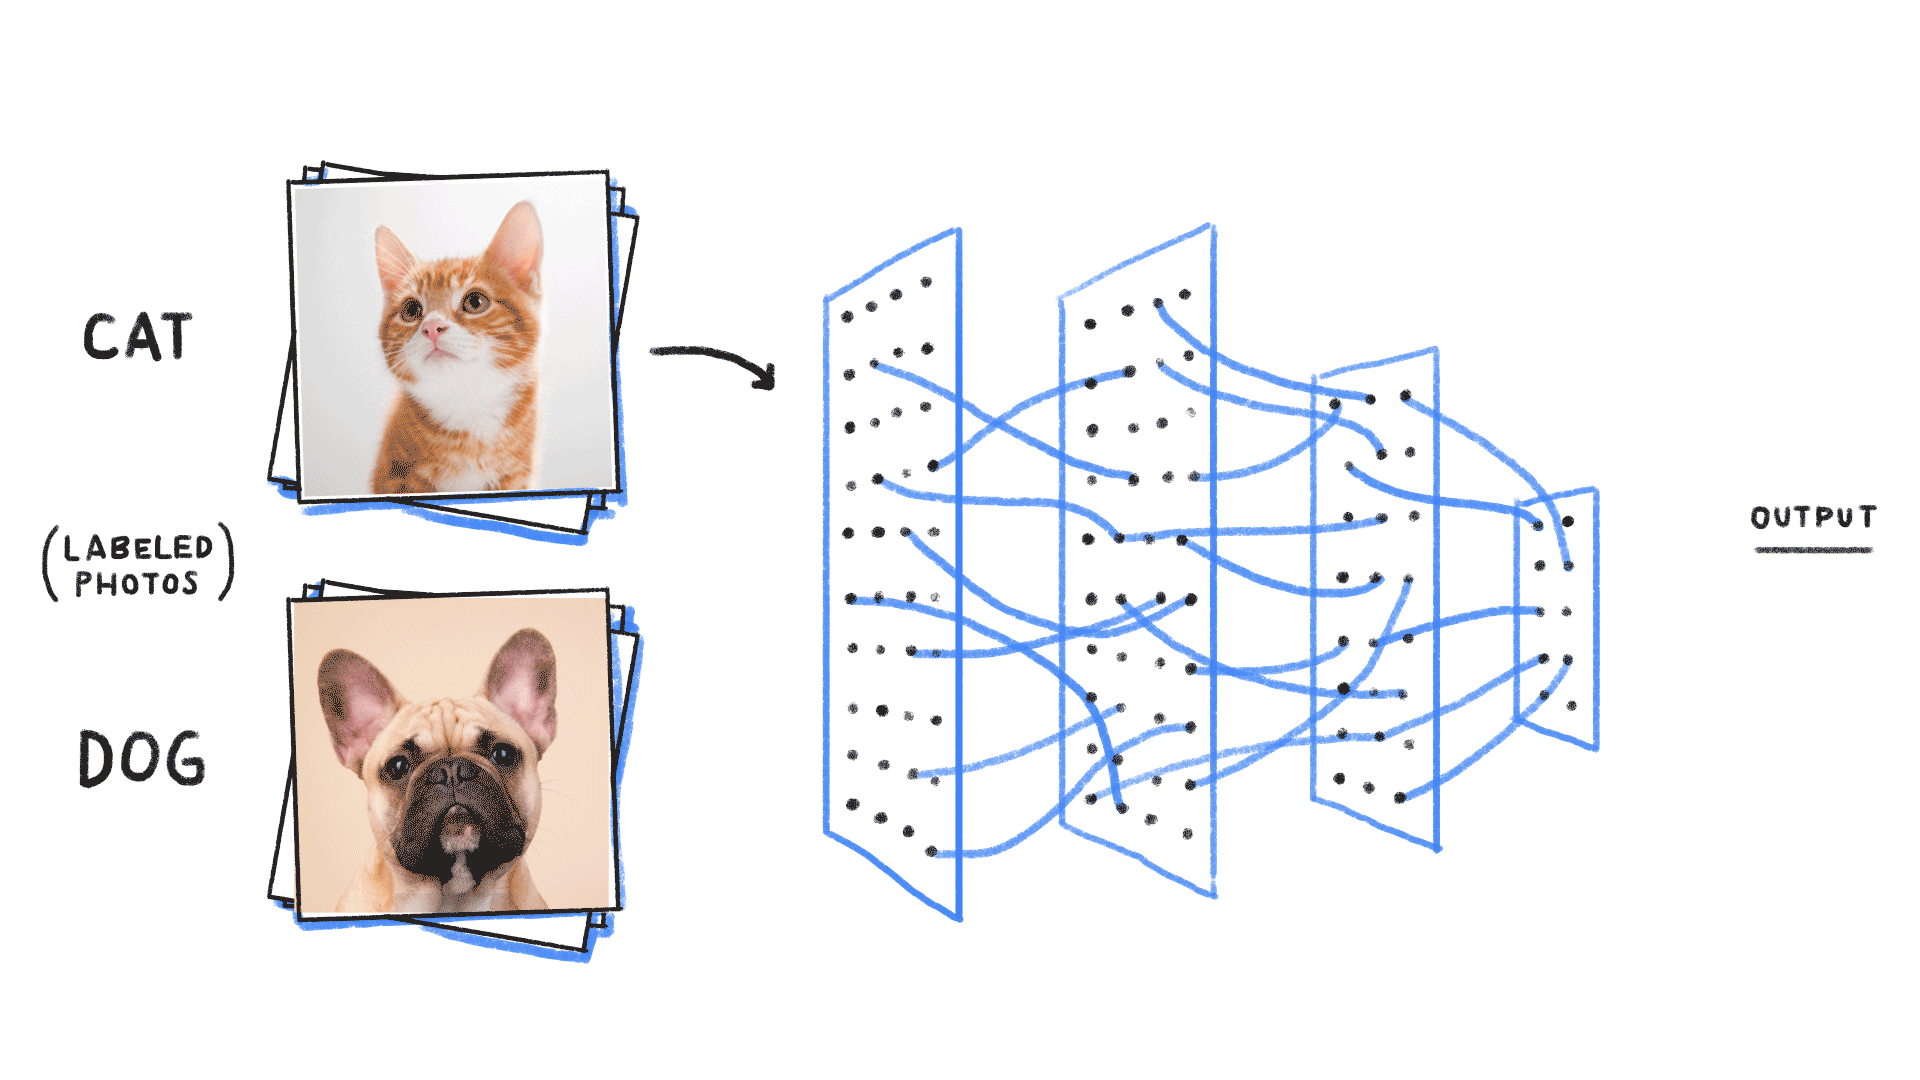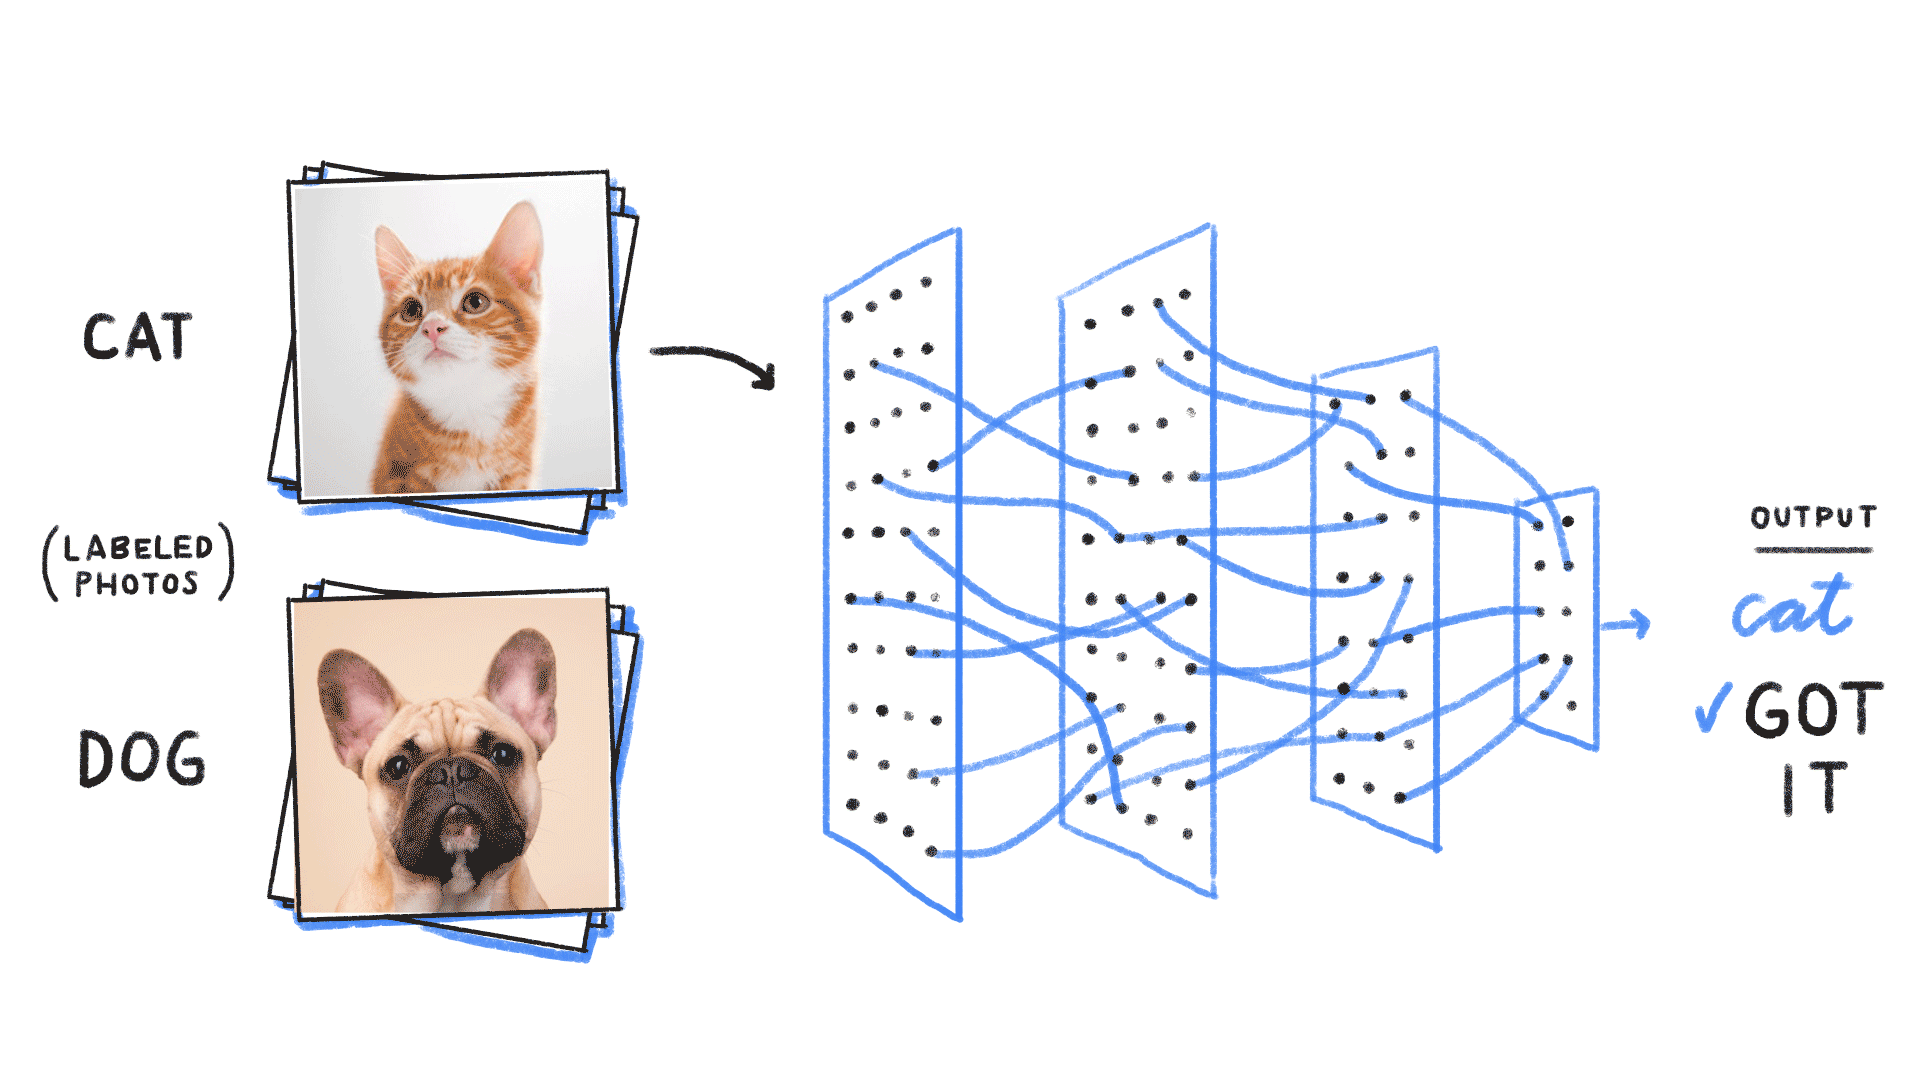
El aprendizaje automático es un método para que las computadoras aprendan de esta manera: no escribimos reglas complejas directamente, sino que dejamos que la computadora encuentre automáticamente patrones y regularidades a partir de grandes cantidades de datos.
¿Cómo funciona el aprendizaje automático?
El aprendizaje automático permite a las computadoras tomar decisiones y hacer predicciones aprendiendo patrones y regularidades a partir de grandes volúmenes de datos.
- Primero, se recopilan y preparan los datos, y luego se selecciona un algoritmo adecuado para entrenar el modelo.
- Después, el modelo optimiza continuamente sus parámetros para minimizar los errores de predicción, hasta que pueda predecir con precisión nuevos datos.
- Finalmente, el modelo se implementa en aplicaciones reales, realiza predicciones o toma decisiones en tiempo real y se actualiza según los nuevos datos.
El aprendizaje automático es un proceso iterativo que puede requerir ajustar varias veces los parámetros del modelo y la selección de características para mejorar su rendimiento.
La siguiente imagen muestra el flujo básico del aprendizaje automático:

-
Labeled Data (Datos etiquetados):: El área azul de la figura muestra los datos etiquetados, que incluyen diferentes formas geométricas (como hexágonos, cuadrados y triángulos).
-
Model Training (Entrenamiento del modelo):: En esta etapa, el algoritmo de aprendizaje automático analiza las características de los datos y aprende a predecir las etiquetas según dichas características.
-
Test Data (Datos de prueba):: El área verde oscuro de la figura muestra los datos de prueba, que incluyen un cuadrado y un triángulo.
-
Prediction (Predicción):: El modelo usa las reglas aprendidas de los datos de entrenamiento para predecir las etiquetas de los datos de prueba. En la figura, el modelo predice el cuadrado y el triángulo de los datos de prueba.
-
Evaluation (Evaluación):: Los resultados de la predicción se comparan con las etiquetas reales de los datos de prueba para evaluar la precisión del modelo.
El flujo de trabajo del aprendizaje automático puede dividirse aproximadamente en los siguientes pasos:
1. Recopilación de datos
- Recopilar datos: Es el primer paso de un proyecto de aprendizaje automático e implica reunir datos relevantes. Los datos pueden provenir de bases de datos, archivos, redes o flujos de datos en tiempo real.
- Tipos de datos: Pueden ser datos estructurados (como datos tabulares) o no estructurados (como texto, imágenes y video).
2. Preprocesamiento de datos
- Limpieza de datos: Manejar valores faltantes, valores atípicos, errores y datos duplicados.
- Ingeniería de características: Seleccionar las características más relevantes que ayuden al modelo a aprender, lo que puede incluir crear nuevas características o transformar las existentes.
- Estandarización / normalización de datos: Ajustar la escala de los datos para que estén dentro del mismo rango, lo que ayuda al rendimiento de ciertos algoritmos.
3. Selección del modelo
- Determinar el tipo de problema: Elegir el modelo de aprendizaje automático adecuado según la naturaleza del problema (clasificación, regresión, agrupamiento, etc.).
- Seleccionar el algoritmo: Con base en el tipo de problema y las características de los datos, elegir uno o más algoritmos para experimentar.
4. Entrenamiento del modelo
- Dividir el conjunto de datos: Dividir los datos en conjunto de entrenamiento, conjunto de validación y conjunto de prueba.
- Entrenamiento: Utilizar los datos del conjunto de entrenamiento para entrenar el modelo y ajustar sus parámetros con el fin de minimizar la función de pérdida.
- Validación: Utilizar el conjunto de validación para ajustar los parámetros del modelo y evitar el sobreajuste.
5. Evaluación del modelo
- Métricas de rendimiento: Usar el conjunto de prueba para evaluar el rendimiento del modelo. Las métricas comunes incluyen exactitud, recall, puntuación F1, etc.
- Validación cruzada: Una técnica para evaluar la capacidad de generalización del modelo, dividiendo los datos en múltiples subconjuntos para entrenar y validar.
6. Optimización del modelo
- Ajuste de hiperparámetros: Los hiperparámetros son parámetros establecidos antes del proceso de aprendizaje, como la tasa de aprendizaje o la profundidad del árbol. Se pueden ajustar mediante métodos como la búsqueda en cuadrícula, la búsqueda aleatoria o la optimización bayesiana.
- Selección de características: Puede ser necesario reevaluar y seleccionar las características para mejorar el rendimiento del modelo.
7. Implementación del modelo
- Integración en la aplicación: Integrar el modelo entrenado en aplicaciones reales, como sitios web, aplicaciones móviles o software.
- Monitoreo y mantenimiento: Monitorear continuamente el rendimiento del modelo y actualizarlo según los nuevos datos.
8. Bucle de retroalimentación
- Aprendizaje continuo: Los modelos de aprendizaje automático pueden diseñarse para aprender automáticamente de nuevos datos con el tiempo y adaptarse a los cambios.
Detalles técnicos
- Función de pérdida: Una función que mide la diferencia entre las predicciones del modelo y los resultados reales. El objetivo del entrenamiento del modelo es minimizar esta función.
- Algoritmo de optimización: Como el descenso de gradiente, se utiliza para encontrar los valores de los parámetros que minimizan la función de pérdida.
- Regularización: Una técnica que evita el sobreajuste del modelo añadiendo un término de penalización.
El flujo de trabajo del aprendizaje automático es iterativo y puede requerir múltiples ajustes y optimizaciones para alcanzar el mejor rendimiento. Además, con la acumulación de datos y el desarrollo de algoritmos, los modelos de aprendizaje automático pueden volverse más precisos y eficientes.
Tipos de aprendizaje automático
El aprendizaje automático se divide principalmente en los siguientes tres tipos:
1. Aprendizaje supervisado (Supervised Learning)
- Definición:El aprendizaje supervisado consiste en entrenar con datos etiquetados. El modelo aprende la relación entre los datos de entrada y las etiquetas para hacer predicciones o clasificaciones.
- Aplicaciones:Clasificación (como la detección de correo no deseado), regresión (como la predicción de precios de viviendas).
- Ejemplos:Regresión lineal, árboles de decisión, máquinas de vectores de soporte (SVM).
2. Aprendizaje no supervisado (Unsupervised Learning)
- Definición:El aprendizaje no supervisado utiliza datos sin etiquetar. El modelo intenta descubrir estructuras o patrones latentes en los datos.
- Aplicaciones:Agrupamiento (como la segmentación de clientes), reducción de dimensionalidad (como la visualización de datos).
- Ejemplos:Agrupamiento K-means, análisis de componentes principales (PCA).
3. Aprendizaje por refuerzo (Reinforcement Learning)
- Definición:El aprendizaje por refuerzo interactúa con el entorno: el agente aprende la mejor estrategia mediante prueba y error para maximizar la recompensa a largo plazo. Después de cada acción, el sistema recibe una recompensa o un castigo para guiar la mejora del comportamiento.
- Aplicaciones:IA para juegos (como AlphaGo), conducción autónoma, control de robots.
- Ejemplos:Q-learning, redes Q profundas (DQN).
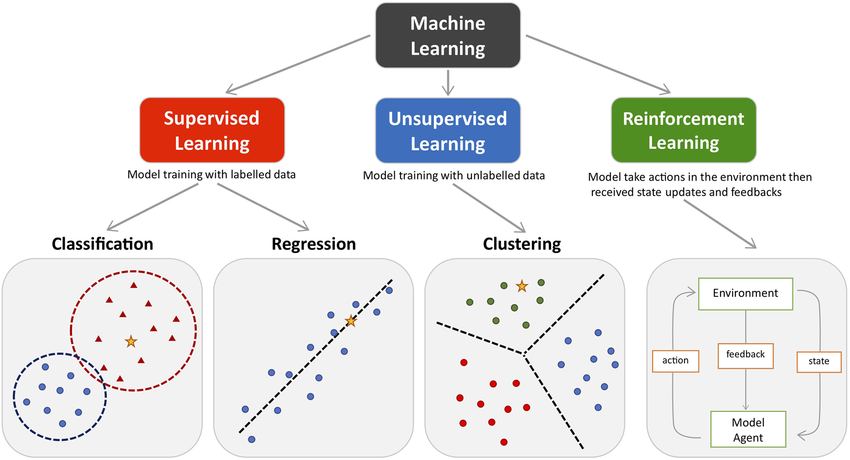
Estos tres tipos de aprendizaje automático tienen sus propios escenarios de aplicación y ventajas: el aprendizaje supervisado es adecuado para datos con etiquetas claras, el aprendizaje no supervisado es adecuado para explorar la estructura interna de los datos, y el aprendizaje por refuerzo es adecuado para escenarios donde se necesita aprender la estrategia óptima mediante prueba y error.
Áreas de aplicación del aprendizaje automático
Sistemas de recomendación:Por ejemplo, Douyin recomienda videos que pueden interesarte, Taobao recomienda productos que podrías comprar, y NetEase Cloud Music recomienda música que te gusta.
Procesamiento del lenguaje natural (NLP):El aprendizaje automático tiene aplicaciones en el reconocimiento de voz, la traducción automática, el análisis de sentimientos, los chatbots, etc. Por ejemplo, Google Translate, Siri y los asistentes virtuales de atención al cliente.
Visión por computadora:El aprendizaje automático tiene amplias aplicaciones en el reconocimiento de imágenes, la detección de objetos, el reconocimiento facial, la conducción autónoma, etc. Por ejemplo, los automóviles autónomos identifican obstáculos a su alrededor mediante cámaras y sensores, y reconocen peatones y otros vehículos.
Análisis financiero:El aprendizaje automático tiene aplicaciones importantes en áreas financieras como la predicción del mercado de valores, la calificación crediticia y la detección de fraudes. Por ejemplo, los bancos utilizan el aprendizaje automático para detectar comportamientos fraudulentos en las transacciones con tarjetas de crédito.
Salud y medicina:El aprendizaje automático ayuda a los médicos a diagnosticar enfermedades, descubrir efectos secundarios de medicamentos, predecir la evolución de enfermedades, etc. Por ejemplo, el sistema Watson de IBM ayuda a los médicos a analizar los datos de los historiales de los pacientes y proporciona sugerencias de diagnóstico y tratamiento.
Juegos y entretenimiento:El aprendizaje automático no solo se utiliza para oponentes inteligentes en juegos, sino que también se aplica en el diseño de juegos, ajuste dinámico de dificultad, entre otros aspectos. Por ejemplo, AlphaGo utilizó técnicas de aprendizaje profundo para derrotar al campeón mundial de Go.
El futuro del aprendizaje automático
Con el crecimiento explosivo de la cantidad de datos y el aumento de la capacidad de cómputo, las aplicaciones del aprendizaje automático seguirán expandiéndose, brindando sistemas más inteligentes y eficientes. Por ejemplo:
Aprendizaje por refuerzo:Permite que las computadoras resuelvan problemas complejos mediante prueba y error sin una guía explícita. Por ejemplo, AlphaGo y la IA del juego Dota 2 utilizan aprendizaje por refuerzo.
Aprendizaje autosupervisado:Los modelos de aprendizaje automático actuales generalmente requieren grandes cantidades de datos etiquetados para entrenarse, mientras que el aprendizaje autosupervisado puede aprender representaciones más efectivas a partir de datos sin etiquetas.
Aprendizaje profundo:El aprendizaje profundo es una rama del aprendizaje automático que se centra principalmente en la aplicación de redes neuronales. Ya ha logrado avances revolucionarios en reconocimiento de imágenes, procesamiento de lenguaje natural, entre otros campos. En el futuro, el aprendizaje profundo seguirá impulsando el desarrollo de la inteligencia artificial.
Gracias al aprendizaje automático, podemos crear sistemas más inteligentes, automatizar tareas tediosas y mejorar diversos aspectos de nuestra vida diaria. Con el avance de la tecnología, el aprendizaje automático se convertirá en uno de los motores fundamentales de todas las industrias en el futuro.
Otras extensiones