Cómo funciona el aprendizaje automático
El concepto central del aprendizaje automático (Machine Learning, ML) es permitir que las computadorasaprendan de los datose infieran patrones o reglas a partir de ellos, sin depender de reglas o códigos escritos explícitamente.
En términos simples, el flujo de trabajo del aprendizaje automático es permitir que las máquinas mejoren automáticamente su capacidad de toma de decisiones y predicción mediante datos históricos.
El flujo de trabajo del aprendizaje automático se puede simplificar en los siguientes pasos:
- Recopilar datos: preparar datos que contengan características y etiquetas.
- Seleccionar modelo: elegir el algoritmo de aprendizaje automático adecuado según la tarea.
- Entrenar modelo: hacer que el modelo aprenda patrones a partir de los datos y minimice el error.
- Evaluación y validación: evaluar el rendimiento del modelo con el conjunto de prueba y optimizarlo.
- Desplegar el modelo: aplicar el modelo entrenado en escenarios reales para realizar predicciones.
- Mejora continua: a medida que se generan nuevos datos, el modelo debe actualizarse y optimizarse periódicamente.
Este proceso permite que las computadoras aprendan automáticamente de la experiencia y realicen predicciones cada vez más precisas en diversas tareas.
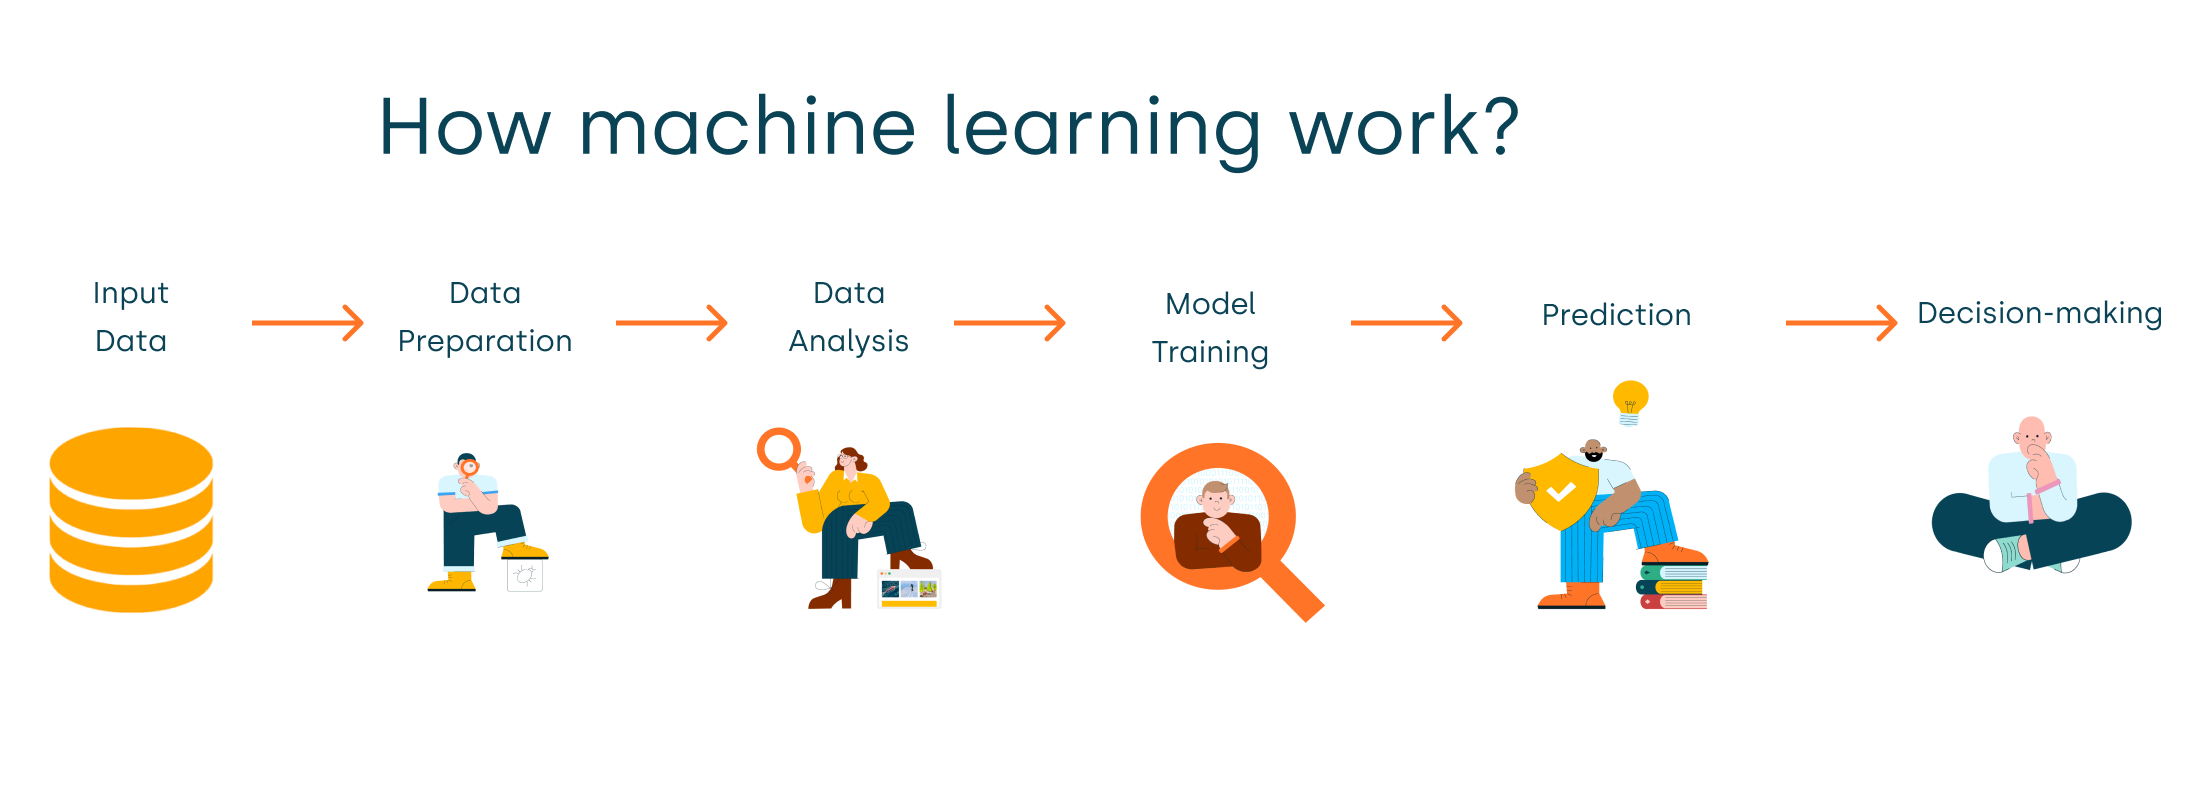
Podemos entender cómo funciona el aprendizaje automático desde los siguientes aspectos:
1. Entrada de datos: los datos son la base del aprendizaje
El primer paso del aprendizaje automático es la recopilación de datos. Sin datos, el modelo de aprendizaje automático no puede entrenarse. Los datos generalmente incluyen "características de entrada" y "etiquetas":
-
Características de entrada (Features):Esta es la información que el modelo utiliza para hacer predicciones o clasificaciones. Por ejemplo, en el problema de predicción del precio de la vivienda, las características de entrada pueden ser el área de la casa, la ubicación geográfica, el número de dormitorios, etc.
-
Etiquetas (Labels):La etiqueta es el resultado que queremos predecir o clasificar, generalmente un número o una categoría. Por ejemplo, en el problema de predicción del precio de la vivienda, la etiqueta es el precio de la casa.
El objetivo del modelo de aprendizaje automático es encontrar la relación entre las características de entrada y las etiquetas a partir de los datos, y hacer predicciones basadas en estas relaciones.
2. Selección de modelo: elegir el algoritmo de aprendizaje adecuado
Los modelos de aprendizaje automático (también llamados algoritmos) son herramientas que ayudan a las computadoras a aprender de los datos y hacer predicciones. Según la naturaleza de los datos y la tarea, los modelos comunes de aprendizaje automático incluyen:
-
Modelos de aprendizaje supervisado:Dados datos etiquetados, el modelo hace predicciones aprendiendo la relación entre las entradas y las etiquetas. Por ejemplo,Regresión lineal、Regresión logística、Máquinas de vectores de soporte (SVM)yÁrboles de decisión。
-
Modelos de aprendizaje no supervisado:Sin datos etiquetados, el modelo aprende explorando la estructura o los patrones en los datos. Por ejemplo,Agrupamiento K-means (K-means clustering)、Análisis de componentes principales (PCA)。
-
Modelos de aprendizaje por refuerzo:El modelo aprende el comportamiento óptimo a través de recompensas y castigos mientras interactúa con el entorno. Por ejemplo,Q-learning、Aprendizaje por refuerzo profundo(Deep Q-Networks, DQN)。
3. Proceso de entrenamiento: hacer que el modelo aprenda de los datos
En la fase de entrenamiento, el modelo "aprende" la relación entre las entradas y las etiquetas a partir de datos históricos, generalmente optimizando los parámetros del modelo mediante la minimización de una función de pérdida (Loss Function). El proceso de entrenamiento se puede resumir en los siguientes pasos:
-
Estado inicial:El modelo comienza con valores aleatorios. Por ejemplo, los pesos de una red neuronal se inicializan aleatoriamente.
-
Calcular la predicción:Para cada entrada, el modelo hace una predicción. Esto se logra pasando los datos de entrada al modelo y calculando la salida.
-
Calcular el error (pérdida):El error es la diferencia entre la salida predicha por el modelo y la etiqueta real. Por ejemplo, para problemas de regresión, el error se puede medir mediante el error cuadrático medio (MSE).
-
Optimizar el modelo:Mediante algoritmos de optimización como la retropropagación (en redes neuronales) o el descenso de gradiente, se ajustan continuamente los parámetros del modelo (como los pesos de la red neuronal) para minimizar el error. Este proceso se llamaentrenamiento, hasta que el modelo pueda hacer predicciones relativamente precisas sobre los datos de entrenamiento.
4. Validación y evaluación: probar el rendimiento del modelo
Una vez completado el proceso de entrenamiento, necesitamos evaluar el rendimiento del modelo. Para evitar que el modelo se sobreajuste a los datos de entrenamiento, dividimos los datos enconjunto de entrenamientoyconjunto de prueba, donde:
- Conjunto de entrenamiento:La parte de los datos utilizada para entrenar el modelo.
- Conjunto de prueba:La parte de los datos utilizada para evaluar el rendimiento del modelo, que generalmente no participa en el proceso de entrenamiento.
Las métricas de evaluación comunes incluyen:
- Exactitud (Accuracy):La proporción de clasificaciones correctas en un problema de clasificación.
- Error cuadrático medio (MSE):En problemas de regresión, el promedio de los cuadrados de las diferencias entre los valores predichos y los valores reales.
- Precisión (Precision) y recall (Recall):Se utilizan en problemas de clasificación binaria, especialmente cuando las clases están desbalanceadas.
- Puntuación F1 (F1-score):Es la media armónica de la precisión y el recall, que considera de manera integral el rendimiento del clasificador.
5. Optimización y ajuste: mejorar la precisión del modelo
Si el rendimiento del modelo en el conjunto de prueba no es satisfactorio, puede ser necesario una mayor optimización. Esto generalmente incluye:
-
Ajustar los hiperparámetros (Hyperparameters):Por ejemplo, la tasa de aprendizaje, el coeficiente de regularización, la profundidad del árbol, etc. Estos hiperparámetros afectan la capacidad de aprendizaje del modelo.
-
Selección y combinación de modelos:Probar diferentes modelos o combinaciones de modelos (como métodos de aprendizaje por conjuntos, por ejemplo, Random Forest, XGBoost, etc.) para mejorar la precisión.
-
Aumento de datos (Data Augmentation):Expandir el conjunto de datos de entrenamiento, por ejemplo, aplicando rotaciones, volteos, etc. a las imágenes, para ayudar al modelo a mejorar su capacidad de generalización.
6. Despliegue del modelo y predicción: aplicación práctica
Una vez que el modelo tiene un buen rendimiento en los datos de entrenamiento y prueba, se puede desplegar en aplicaciones reales:
-
Despliegue del modelo:Incrustar el modelo entrenado en sistemas como aplicaciones, sitios web, servidores, etc., para que los usuarios lo utilicen.
-
Predicción en tiempo real:En el entorno real, los nuevos datos se ingresan al modelo, y el modelo realiza predicciones o clasificaciones en tiempo real según los patrones aprendidos anteriormente.
7. Aprendizaje continuo y actualización del modelo:
Los sistemas de aprendizaje automático generalmente no se completan de una sola vez. En aplicaciones prácticas, con el tiempo, se generan continuamente nuevos datos; por lo tanto, el modelo debe actualizarse y reentrenarse periódicamente para mantener su capacidad de predicción. Esto se puede lograr medianteaprendizaje en línea、aprendizaje por transferenciay otros métodos.
Otras extensiones