Tutorial de aprendizaje automático
El aprendizaje automático (Machine Learning) es una rama de la inteligencia artificial (IA) que permite a los sistemas informáticos aprender y mejorar automáticamente su rendimiento utilizando datos y algoritmos.
El aprendizaje automático permite que las máquinas tomen decisiones y hagan predicciones a través de la experiencia (datos).
El aprendizaje automático se ha aplicado ampliamente en muchos campos, incluidos sistemas de recomendación, reconocimiento de imágenes, reconocimiento de voz, análisis financiero, entre otros.
Por ejemplo, mediante el aprendizaje automático, un automóvil puede aprender a reconocer señales de tráfico, peatones y obstáculos para lograr la conducción autónoma.
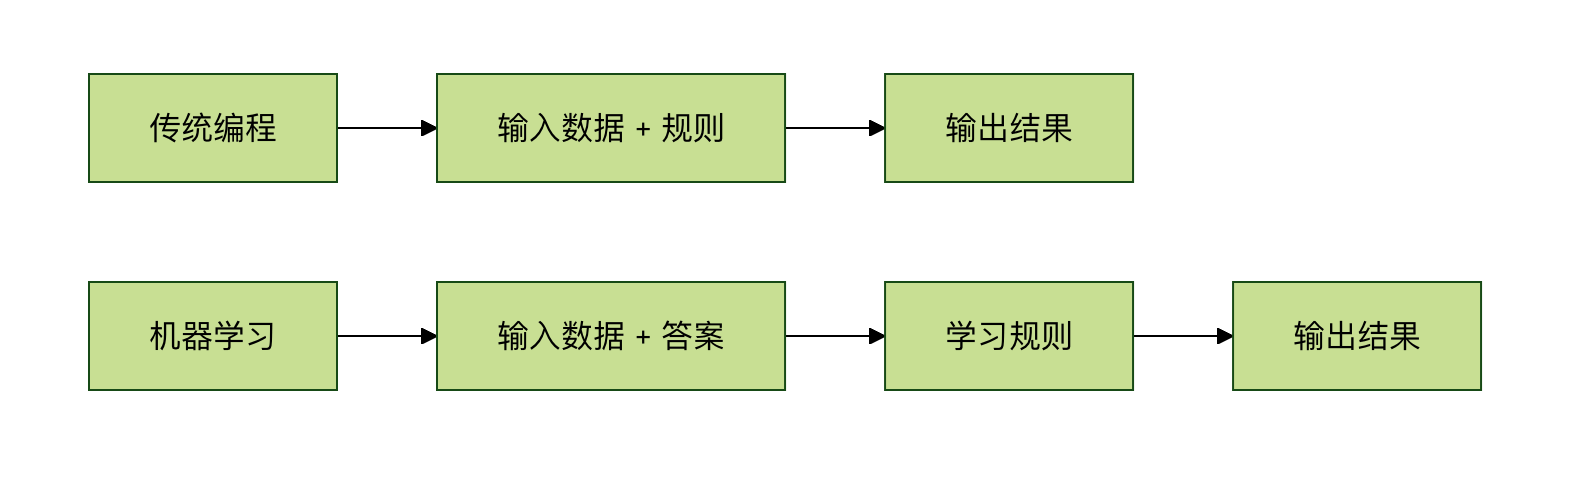
Diferencias entre el aprendizaje automático y la programación tradicional
| Programación tradicional | Aprendizaje automático |
|---|---|
| El programador escribe reglas explícitas | La computadora aprende las reglas a partir de los datos |
| Adecuado para situaciones con problemas claros y reglas bien definidas | Adecuado para situaciones complejas donde las reglas son difíciles de definir |
| Ejemplo: escribir un programa de calculadora | Ejemplo: escribir un programa para detectar correo no deseado (spam) |
Los tres elementos clave del aprendizaje automático
El aprendizaje automático incluye tres elementos básicos:
1. Datos
Los datos son el combustible del aprendizaje automático; cuantos más y de mayor calidad sean los datos, generalmente mejor puede aprender el modelo.
- Datos de entrenamiento: los datos que se utilizan para enseñar al modelo
- Datos de prueba: los datos que se utilizan para evaluar el efecto de aprendizaje del modelo
- Datos reales: los nuevos datos que el modelo encuentra en aplicaciones reales
2. Algoritmo
El algoritmo es el método de aprendizaje del machine learning; diferentes algoritmos son adecuados para diferentes tipos de problemas.
- Aprendizaje supervisado: aprendizaje con respuestas estándar
- Aprendizaje no supervisado: sin respuestas estándar, encuentra patrones por sí mismo
- Aprendizaje por refuerzo: aprender a través de prueba y error y recompensas
3. Modelo
El modelo es el resultado del aprendizaje, como el conocimiento que adquiere un estudiante.
- Proceso de entrenamiento: el algoritmo aprende patrones de los datos
- Proceso de inferencia: usar los patrones aprendidos para hacer predicciones
Ejemplo
A continuación, entendamos el flujo básico del aprendizaje automático con un ejemplo sencillo.
Usaremos Python para crear un modelo simple de regresión lineal para predecir precios de viviendas.
Ejemplo
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
import seaborn as sns
# Establecer el estilo del gráfico para que se vea mejor
sns.set_style("whitegrid")
# -------------------------- Configurar fuente china start --------------------------
plt.rcParams['font.sans-serif'] = [
# Prioridad para Windows
'SimHei', 'Microsoft YaHei',
# Prioridad para macOS
'PingFang SC', 'Heiti TC',
# Prioridad para Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que el signo negativo se muestre como un recuadro
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Configurar fuente china end --------------------------
# 1. Preparar los datos
# Supongamos que tenemos datos de área de vivienda y su precio correspondiente
# Área de la vivienda (metros cuadrados)
house_sizes = np.array([50, 60, 70, 80, 90, 100, 110, 120]).reshape(-1, 1)
# Precio de la vivienda (diez mil yuanes)
house_prices = np.array([150, 180, 210, 240, 270, 300, 330, 360])
# 2. Crear y entrenar el modelo
# Crear el modelo de regresión lineal
model = LinearRegression()
# Entrenar el modelo con los datos (aprender la relación entre el área y el precio)
model.fit(house_sizes, house_prices)
# 3. Usar el modelo para hacer predicciones
# Predecir el precio de una vivienda de 85 metros cuadrados
predicted_price = model.predict([[85]])
print(f"Precio previsto de la vivienda de 85 metros cuadrados: {predicted_price)
# 4. Visualizar los resultados
plt.scatter(house_sizes, house_prices, color='blue', label='Datos reales')
plt.plot(house_sizes, model.predict(house_sizes), color='red', label='Línea de predicción')
plt.scatter([85], predicted_price, color='green', s=100, label='Punto de predicción')
plt.xlabel('Área de la vivienda (metros cuadrados)')
plt.ylabel('Precio de la vivienda (diez mil yuanes)')
plt.title('Prueba de aprendizaje automático de EJEMPLO -- Relación entre el área y el precio de la vivienda')
plt.legend()
plt.grid(True)
plt.show()
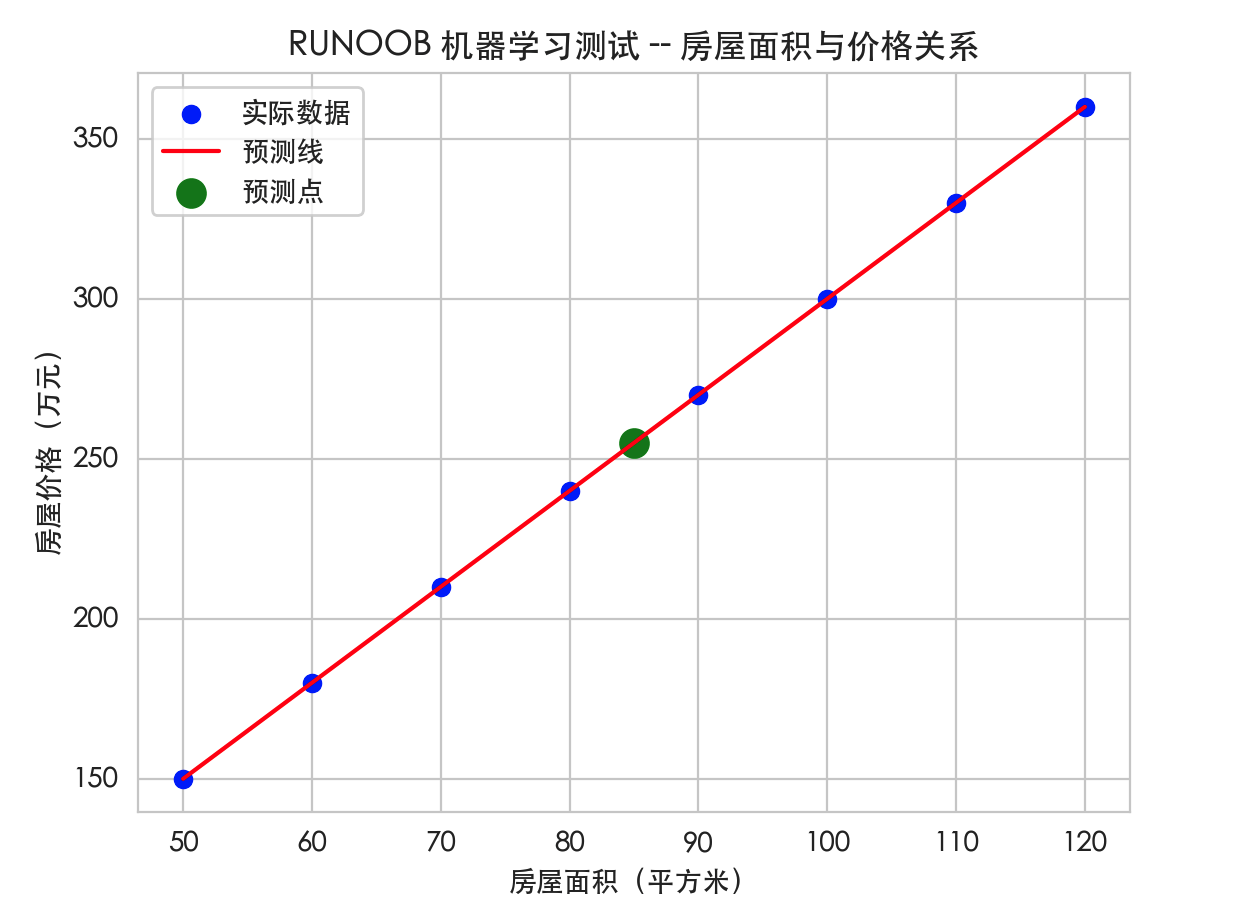
Resultado de la ejecución:
85 平方米的房屋预测价格:255.00 万元
Este ejemplo muestra el flujo básico del aprendizaje automático:
- Preparar los datos (área y precio de la vivienda)
- Seleccionar el algoritmo (regresión lineal)
- Entrenar el modelo (hacer que la computadora aprenda la relación entre el área y el precio)
- Usar el modelo para predecir (predecir el precio de un área nueva)
El gráfico de salida es el siguiente: