機械学習の仕組み
機械学習(Machine Learning, ML)の核心的な考え方は、コンピュータがデータを通じて学習し、そこから規則やパターンを推測できるようにすることであり、明示的に記述されたルールやコードに依存しません。
簡単に言うと、機械学習のワークフローは、機械が履歴データを通じて意思決定と予測能力を自動的に改善することです。
機械学習のワークフローは、以下のいくつかのステップに簡略化できます:
- データ収集:特徴量とラベルを含むデータを準備します。
- モデル選択:タスクに応じて適切な機械学習アルゴリズムを選択します。
- モデルのトレーニング:モデルにデータを通じてパターンを学習させ、誤差を最小化します。
- 評価と検証:テストセットを通じてモデルの性能を評価し、最適化を行います。
- モデルのデプロイ:トレーニング済みのモデルを実際のシーンに適用して予測を行います。
- 継続的な改善:新しいデータが生成されるにつれて、モデルは定期的に更新と最適化が必要です。
このプロセスにより、コンピュータは経験から自動的に学習し、さまざまなタスクでますます正確な予測を行うことができます。
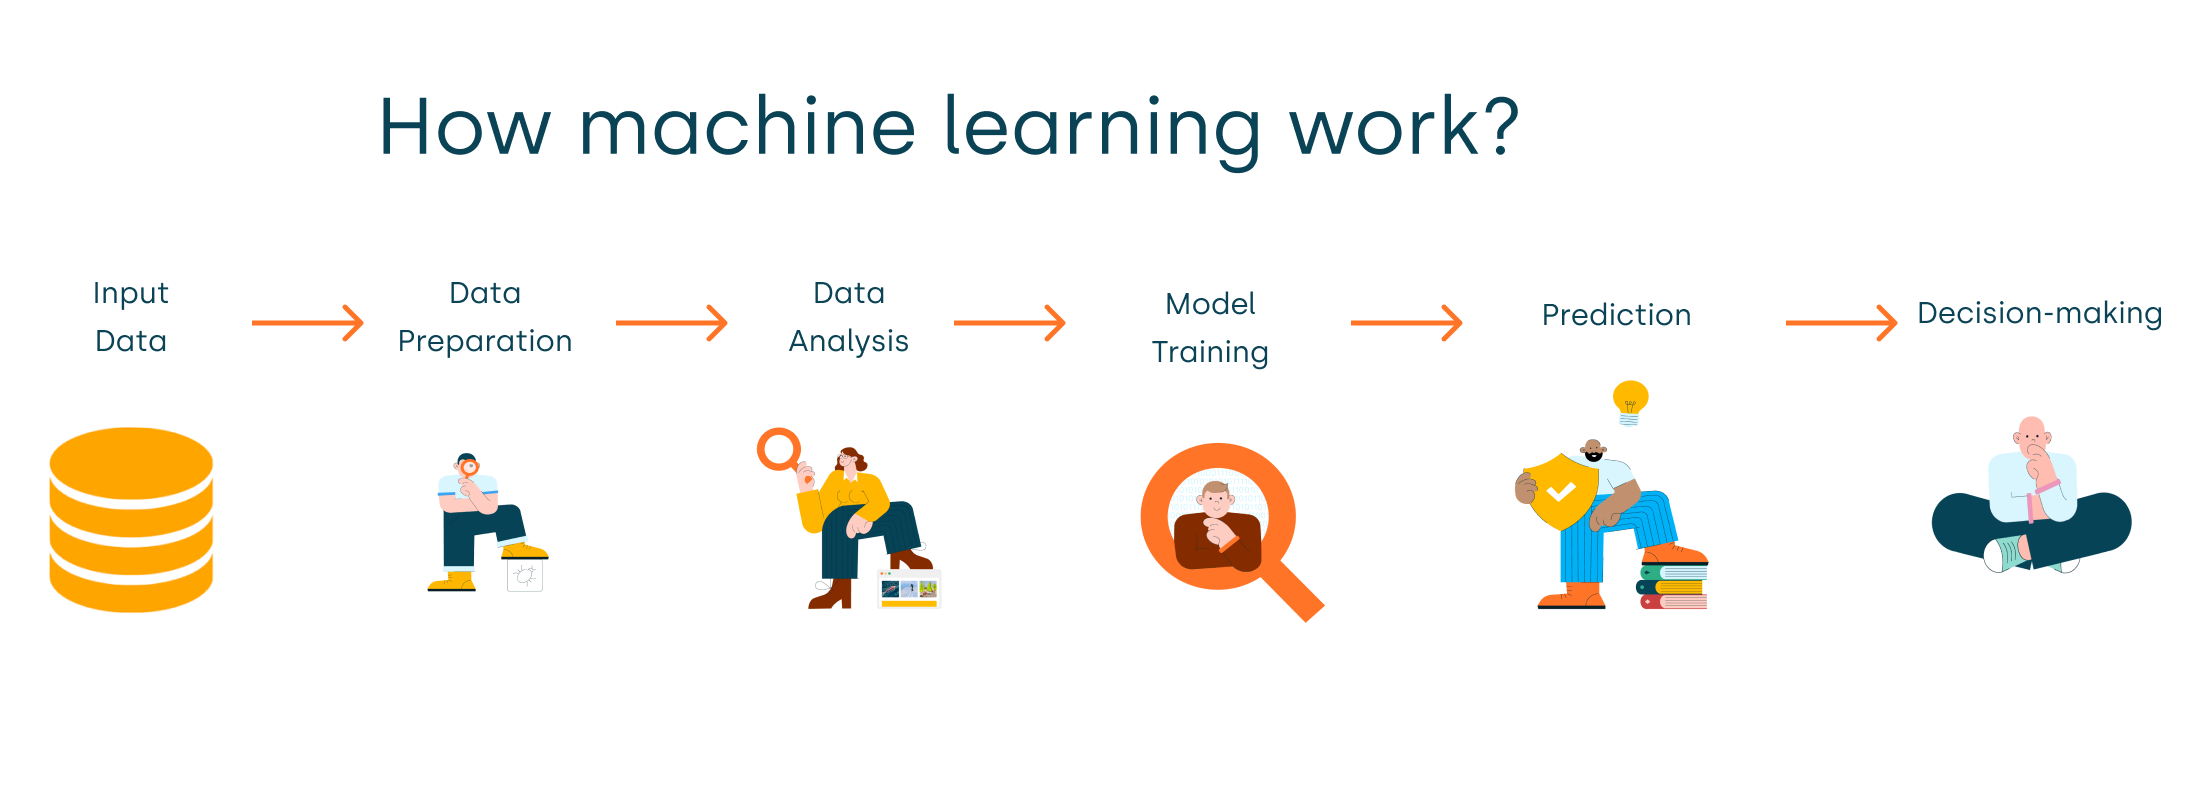
機械学習がどのように機能するかは、以下のいくつかの側面から理解できます:
1. データ入力:データは学習の基盤
機械学習の最初のステップはデータ収集です。データがなければ、機械学習モデルはトレーニングできません。データには通常、「入力特徴量」と「ラベル」が含まれます:
-
入力特徴量(Features):これらはモデルが予測や分類を行うために使用する情報です。例えば、住宅価格予測の問題では、入力特徴量は家の面積、地理的な位置、寝室の数などです。
-
ラベル(Labels):ラベルは予測または分類したい結果であり、通常は数値またはカテゴリです。例えば、住宅価格予測の問題では、ラベルは家の価格です。
機械学習モデルの目標は、データから入力特徴量とラベルの関係を見つけ出し、これらの関係に基づいて予測を行うことです。
2. モデル選択:適切な学習アルゴリズムを選択
機械学習モデル(アルゴリズムとも呼ばれます)は、コンピュータがデータを学習し予測を行うためのツールです。データの性質やタスクの違いに応じて、一般的な機械学習モデルには以下のものがあります:
-
教師あり学習モデル:ラベル付きのデータが与えられると、モデルは入力とラベルの関係を学習して予測を行います。例えば、線形回帰、ロジスティック回帰、サポートベクターマシン(SVM)と決定木。
-
教師なし学習モデル:ラベルのないデータでは、モデルはデータ内の構造やパターンを探索して学習します。例えば、K-meansクラスタリング、主成分分析(PCA)。
-
強化学習モデル:モデルは環境との相互作用の中で、報酬と罰を通じて最適な行動を学習します。例えば、Q-learning、深層強化学習(Deep Q-Networks, DQN)。
3. トレーニングプロセス:モデルにデータから学習させる
トレーニング段階では、モデルは履歴データを通じて入力とラベルの関係を「学習」し、通常は損失関数(Loss Function)を最小化することでモデルのパラメータを最適化します。トレーニングプロセスは以下のステップに要約できます:
-
初期状態:モデルはランダムな値から始まります。例えば、ニューラルネットワークの重みはランダムに初期化されます。
-
予測の計算:各入力に対して、モデルは予測を行います。これは入力データをモデルに渡し、出力を計算することで行われます。
-
誤差(損失)の計算:誤差とは、モデルが予測した出力と実際のラベルの間の差です。例えば、回帰問題では、誤差は平均二乗誤差(MSE)で測定できます。
-
モデルの最適化:バックプロパゲーション(ニューラルネットワークの場合)や勾配降下法などの最適化アルゴリズムを通じて、モデルのパラメータ(ニューラルネットワークの重みなど)を継続的に調整し、誤差を最小化します。このプロセスがトレーニングであり、モデルがトレーニングデータ上で比較的正確な予測を行えるようになるまで続けられます。
4. 検証と評価:モデルの性能をテスト
トレーニングプロセスが完了したら、モデルの性能を評価する必要があります。モデルがトレーニングデータに過学習するのを防ぐため、データをトレーニングセットとテストセットに分けます。それぞれ:
- トレーニングセット:モデルのトレーニングに使用するデータの一部です。
- テストセット:モデルの性能評価に使用するデータの一部で、通常はトレーニングプロセスには参加しません。
一般的な評価指標には以下のものがあります:
- 正解率(Accuracy):分類問題において正しく分類された割合です。
- 平均二乗誤差(MSE):回帰問題において、予測値と実際の値の差の二乗の平均値です。
- 適合率(Precision)と再現率(Recall):二値分類問題、特にクラスの不均衡がある場合に使用されます。
- F1スコア:適合率と再現率の調和平均であり、分類器のパフォーマンスを総合的に評価します。
5. 最適化と調整:モデルの精度を向上
テストセットでのモデルのパフォーマンスが不十分な場合、さらなる最適化が必要になることがあります。これには通常、以下のものが含まれます:
-
ハイパーパラメータ(Hyperparameters)の調整:例えば、学習率、正則化係数、木の深さなどです。これらのハイパーパラメータはモデルの学習能力に影響を与えます。
-
モデルの選択と融合:異なるモデルやモデル融合(ランダムフォレスト、XGBoost などのアンサンブル学習方法)を試して、精度を向上させます。
-
データ拡張:トレーニングデータセットを拡張します。例えば、画像の回転や反転などの操作を行い、モデルの汎化能力を向上させます。
6. モデルデプロイと予測:実際の応用
モデルがトレーニングデータとテストデータで良好なパフォーマンスを発揮したら、モデルを実際のアプリケーションにデプロイできます:
-
モデルのデプロイ:トレーニング済みのモデルをアプリケーション、ウェブサイト、サーバーなどのシステムに組み込み、ユーザーが利用できるようにします。
-
リアルタイム予測:実際の環境では、新しいデータがモデルに入力され、モデルは以前に学習したパターンに基づいてリアルタイムで予測または分類を行います。
7. 継続的学習とモデル更新:
機械学習システムは通常、一度きりで完成するものではありません。実際のアプリケーションでは、時間の経過とともに新しいデータが継続的に生成されるため、モデルは予測能力を維持するために定期的な更新と再トレーニングが必要です。これはオンライン学習、転移学習などの方法で実現できます。
その他の拡張