PyTorch Erstes neuronales Netzwerk
In diesem Kapitel stellen wir vor, wie man PyTorch verwendet, um ein einfaches Feedforward-Neuronales Netz zu implementieren, um eine binäre Klassifizierungsaufgabe durchzuführen.
Das folgende Beispiel zeigt, wie man PyTorch verwendet, um ein einfaches neuronales Netz für binäres Klassifizierungstraining zu implementieren.
Die Netzwerkstruktur umfasst eine Eingabeschicht, eine verborgene Schicht und eine Ausgabeschicht und verwendet die ReLU-Aktivierungsfunktion und die Sigmoid-Aktivierungsfunktion.
Es verwendet die Verlustfunktion des mittleren quadratischen Fehlers und den Optimierer für stochastischen Gradientenabstieg.
Der Trainingsprozess passt die Modellparameter schrittweise durch Vorwärtspropagation, Verlustberechnung, Rückwärtspropagation und Parameteraktualisierungen an.
Beispiel
import torch
import torch.nn as nn
# Größe der Eingabeschicht, Größe der verborgenen Schicht, Größe der Ausgabeschicht und Batch-Größe definieren
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
# Dummy-Eingabedaten und Zieldaten erstellen
x = torch.randn(batch_size, n_in) # Eingabedaten zufällig generieren
y = torch.tensor([[1.0], [0.0], [0.0],
[1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]]) # Ziel-Ausgabedaten
# Ein sequenzielles Modell mit linearen Schichten, ReLU-Aktivierungsfunktion und Sigmoid-Aktivierungsfunktion erstellen
model = nn.Sequential(
nn.Linear(n_in, n_h), # Lineare Transformation von der Eingabeschicht zur verborgenen Schicht
nn.ReLU(), # ReLU-Aktivierungsfunktion für die verborgene Schicht
nn.Linear(n_h, n_out), # Lineare Transformation von der verborgenen Schicht zur Ausgabeschicht
nn.Sigmoid() # Sigmoid-Aktivierungsfunktion für die Ausgabeschicht
)
# Verlustfunktion des mittleren quadratischen Fehlers und Optimierer für stochastisches Gradientenverfahren definieren
criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # Die Lernrate beträgt 0.01
# Gradientenabstiegsalgorithmus für das Modelltraining ausführen
for epoch in range(50): # 50-mal iterieren
y_pred = model(x) # Vorwärtspropagation, vorhergesagte Werte berechnen
loss = criterion(y_pred, y) # Verlust berechnen
print('epoch: ', epoch, 'loss: ', loss.item()) # Verlustwert ausgeben
optimizer.zero_grad() # Gradienten zurücksetzen
loss.backward() # Rückwärtspropagation, Gradienten berechnen
optimizer.step() # Modellparameter aktualisieren
Das Ausgabeergebnis ist ähnlich wie das folgende:
epoch:  0 loss:  0.2591968774795532
epoch:  1 loss:  0.25902628898620605
epoch:  2 loss:  0.25885599851608276
epoch:  3 loss:  0.25868603587150574
epoch:  4 loss:  0.25851646065711975
...
Netzwerkparameter definieren:
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
n_in: Die Größe der Eingabeschicht beträgt 10, das heißt, jeder Datenpunkt hat 10 Merkmale.n_h: Die Größe der verborgenen Schicht beträgt 5, das heißt, die verborgene Schicht enthält 5 Neuronen.n_out: Die Größe der Ausgabeschicht beträgt 1, d. h. sie gibt einen Skalar aus, der das Ergebnis der binären Klassifikation (0 oder 1) repräsentiert.batch_size: Jeder Batch enthält 10 Samples.
Eingabedaten und Zieldaten generieren:
x = torch.randn(batch_size, n_in)  # 随机生成输入数据
y = torch.tensor([[1.0], [0.0], [0.0],
                 [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])  # 目标输出数据
x: Zufälliges Erzeugen einer Form von(10, 10)Eingabedatenmatrix, die 10 Samples repräsentiert, jedes Sample hat 10 Merkmale.y: Zielausgabedaten (Labels), die die Klassenbezeichnung (0 oder 1) für jedes Eingabe-Sample darstellen, sind ein 10×1-Tensor.
Neuronales Netzwerkmodell definieren:
model = nn.Sequential(
   nn.Linear(n_in, n_h),  # 输入层到隐藏层的线性变换
   nn.ReLU(),            # 隐藏层的ReLU激活函数
   nn.Linear(n_h, n_out),  # 隐藏层到输出层的线性变换
   nn.Sigmoid()           # 输出层的Sigmoid激活函数
)
nn.SequentialWird verwendet, um Netzwerkschichten nacheinander zu definieren.
nn.Linear(n_in, n_h): Definiert die lineare Transformation von der Eingabeschicht zur verborgenen Schicht, mit 10 Eingabemerkmalen und 5 Neuronen in der verborgenen Schicht.nn.ReLU(): Fügt die ReLU-Aktivierungsfunktion nach der verborgenen Schicht hinzu, um die Nichtlinearität zu erhöhen.nn.Linear(n_h, n_out): Definiert die lineare Transformation von der verborgenen Schicht zur Ausgabeschicht, mit 1 Ausgabeneuron.nn.Sigmoid(): Die Ausgabeschicht verwendet die Sigmoid-Aktivierungsfunktion, um das Ergebnis für die binäre Klassifikation auf einen Wert zwischen 0 und 1 abzubilden.
Verlustfunktion und Optimierer definieren:
criterion = torch.nn.MSELoss()  # 使用均方误差损失函数
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)  # 使用随机梯度下降优化器,学习率为 0.01
Trainingsschleife:
for epoch in range(50):  # 训练50轮
   y_pred = model(x)  # 前向传播,计算预测值
   loss = criterion(y_pred, y)  # 计算损失
   print('epoch: ', epoch, 'loss: ', loss.item())  # 打印损失值

   optimizer.zero_grad()  # 清零梯度
   loss.backward()  # 反向传播,计算梯度
   optimizer.step()  # 更新模型参数
for epoch in range(50): Führe 50 Trainingsiterationen durch.y_pred = model(x): Führe Vorwärtspropagation durch, wobei die aktuellen Modellparameter verwendet werden, um die Eingabedaten zu berechnenx's vorhergesagte Werte.loss = criterion(y_pred, y): Berechne die vorhergesagten Werte und Zielwerteyden Verlust dazwischen.optimizer.zero_grad(): Setze die Gradientenwerte aus der vorherigen Trainingsrunde zurück.loss.backward(): Rückwärtspropagation: Berechne den Gradienten der Verlustfunktion bezüglich der Modellparameter.optimizer.step(): Aktualisiere die Modellparameter basierend auf den berechneten Gradienten.
Visualisierungscode:
Beispiel
import torch.nn as nn
import matplotlib.pyplot as plt
# Größe der Eingabeschicht, Größe der verborgenen Schicht, Größe der Ausgabeschicht und Batch-Größe definieren
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
# Dummy-Eingabedaten und Zieldaten erstellen
x = torch.randn(batch_size, n_in) # Eingabedaten zufällig generieren
y = torch.tensor([[1.0], [0.0], [0.0],
[1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]]) # Ziel-Ausgabedaten
# Ein sequenzielles Modell mit linearen Schichten, ReLU-Aktivierungsfunktion und Sigmoid-Aktivierungsfunktion erstellen
model = nn.Sequential(
nn.Linear(n_in, n_h), # Lineare Transformation von der Eingabeschicht zur verborgenen Schicht
nn.ReLU(), # ReLU-Aktivierungsfunktion für die verborgene Schicht
nn.Linear(n_h, n_out), # Lineare Transformation von der verborgenen Schicht zur Ausgabeschicht
nn.Sigmoid() # Sigmoid-Aktivierungsfunktion für die Ausgabeschicht
)
# Verlustfunktion des mittleren quadratischen Fehlers und Optimierer für stochastisches Gradientenverfahren definieren
criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # Die Lernrate beträgt 0.01
# Wird verwendet, um den Verlustwert für jede Epoche zu speichern
losses = []
# Gradientenabstiegsalgorithmus für das Modelltraining ausführen
for epoch in range(50): # 50-mal iterieren
y_pred = model(x) # Vorwärtspropagation, vorhergesagte Werte berechnen
loss = criterion(y_pred, y) # Verlust berechnen
losses.append(loss.item()) # Verlustwert aufzeichnen
print(f'Epoche [{epoch+1}/50], Verlust: {loss.item():.4f}') # Verlustwert ausgeben
optimizer.zero_grad() # Gradienten zurücksetzen
loss.backward() # Rückwärtspropagation, Gradienten berechnen
optimizer.step() # Modellparameter aktualisieren
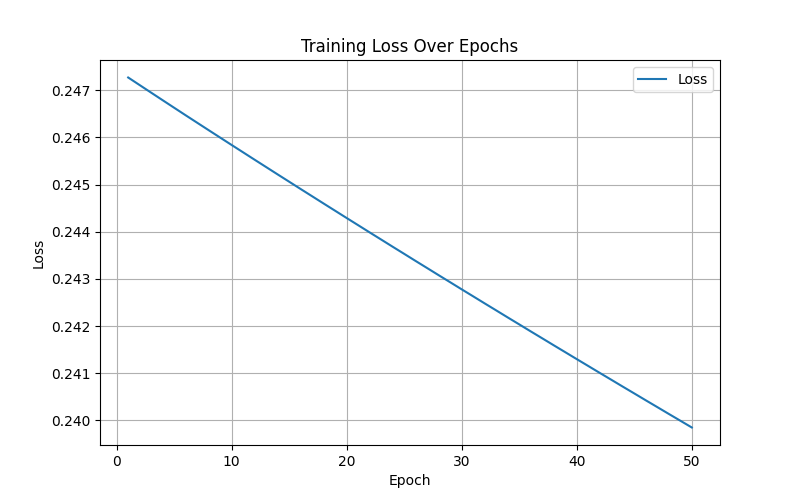
# Verlustkurve visualisieren
plt.figure(figsize=(8, 5))
plt.plot(range(1, 51), losses, label='Verlust')
plt.xlabel('Epoche')
plt.ylabel('Verlust')
plt.title('Trainingsverlust über Epochen')
plt.legend()
plt.grid()
plt.show()
# Vergleich der vorhergesagten Ergebnisse mit den tatsächlichen Zielwerten visualisieren
y_pred_final = model(x).detach().numpy() # Endgültige vorhergesagte Werte
y_actual = y.numpy() # Tatsächliche Werte
plt.figure(figsize=(8, 5))
plt.plot(range(1, batch_size + 1), y_actual, 'o-', label='Tatsächlich', color='blue')
plt.plot(range(1, batch_size + 1), y_pred_final, 'x--', label='Vorhergesagt', color='red')
plt.xlabel('Stichprobenindex')
plt.ylabel('Wert')
plt.title('Tatsächliche vs. vorhergesagte Werte')
plt.legend()
plt.grid()
plt.show()
Wird folgendermaßen angezeigt:
Ein weiteres Beispiel
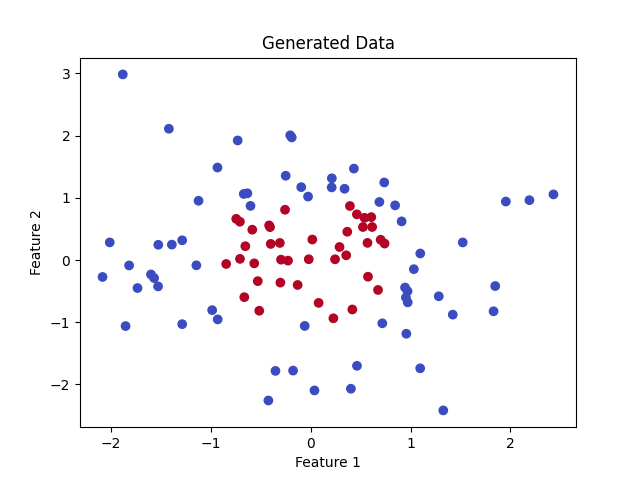
Wir nehmen an, dass ein zweidimensionaler Datensatz vorliegt, und das Ziel ist, die Punkte anhand ihrer Positionen in zwei Kategorien zu klassifizieren (z. B. rote und blaue Punkte).
Das folgende Beispiel zeigt, wie man ein neuronales Netz verwendet, um eine einfache binäre Klassifikationsaufgabe zu lösen, und legt damit die Grundlage für komplexere Aufgaben. Mit der modularen Schnittstelle von PyTorch sind Aufbau, Training und Visualisierung neuronaler Netze sehr intuitiv.
1. Datenvorbereitung
Zuerst erzeugen wir einige einfache zweidimensionale Daten:
Beispiel
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
# Einige Zufallsdaten generieren
n_samples = 100
data = torch.randn(n_samples, 2) # 100 zweidimensionale Datenpunkte erzeugen
labels = (data[:, 0]**2 + data[:, 1]**2 < 1).float().unsqueeze(1) # Punkt innerhalb des Kreises ist 1, außerhalb des Kreises ist 0
# Daten visualisieren
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm')
plt.title("Generierte Daten")
plt.xlabel("Merkmal 1")
plt.ylabel("Merkmal 2")
plt.show()
Datenbeschreibung:
dataDie Eingabe ist ein zweidimensionaler Punkt; jeder Punkt hat zwei Merkmale.labelsDie Zielklassifikation ist 1, wenn der Punkt innerhalb des kreisförmigen Bereichs liegt, andernfalls 0.
Wird folgendermaßen angezeigt:
2. Neuronales Netz definieren
Verwenden Sie PyTorch, um ein einfaches vorwärtsgerichtetes neuronales Netz zu erstellen.
Das vorwärtsgerichtete neuronale Netz verwendet eine verborgene Schicht und erfasst nichtlineare Muster in den Daten durch einfache lineare Transformationen und Aktivierungsfunktionen.
Beispiel
def __init__(self):
super(SimpleNN, self).__init__()
# Schichten des neuronalen Netzes definieren
self.fc1 = nn.Linear(2, 4) # Eingabeschicht hat 2 Merkmale, verborgene Schicht hat 4 Neuronen
self.fc2 = nn.Linear(4, 1) # Verborgene Schicht hat 1 Neuron als Ausgabe (für binäre Klassifikation)
self.sigmoid = nn.Sigmoid() # Aktivierungsfunktion für binäre Klassifikation
def forward(self, x):
x = torch.relu(self.fc1(x)) # ReLU-Aktivierungsfunktion verwenden
x = self.sigmoid(self.fc2(x)) # Ausgabeschicht verwendet Sigmoid-Aktivierungsfunktion
return x
# Modell instanziieren
model = SimpleNN()
3. Verlustfunktion und Optimierer definieren
Beispiel
criterion = nn.BCELoss() # Binärer Kreuzentropieverlust
optimizer = optim.SGD(model.parameters(), lr=0.1) # Stochastischen Gradientenabstiegsoptimierer verwenden
4. Modell trainieren
Trainiere das Modell mit Daten, sodass es lernt zu klassifizieren.
Beispiel
epochs = 100
for epoch in range(epochs):
# Vorwärtspropagierung
outputs = model(data)
loss = criterion(outputs, labels)
# Rückwärtspropagierung
optimizer.zero_grad()
loss.backward()
optimizer.step()
# Verlust alle 10 Epochen ausgeben
if (epoch + 1) % 10 == 0:
print(f'Epoche [{epoch + 1}/{epochs}], Verlust: {loss.item():.4f}')
5. Modell testen und Ergebnisse visualisieren
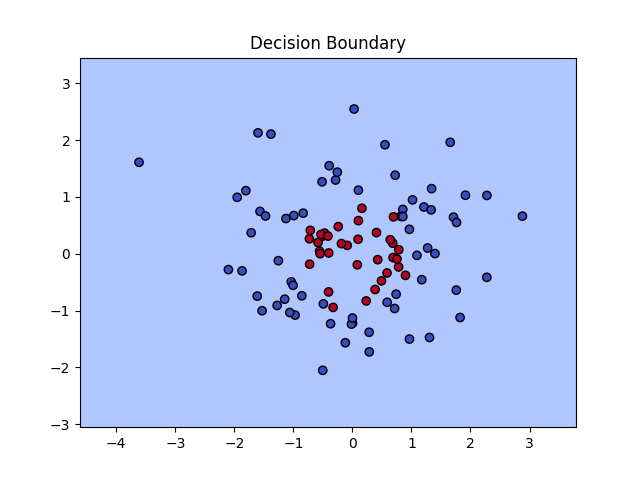
Wir testen das Modell und zeichnen die Entscheidungsgrenze auf dem Bild.
Beispiel
def plot_decision_boundary(model, data):
x_min, x_max = data[:, 0].min() - 1, data[:, 0].max() + 1
y_min, y_max = data[:, 1].min() - 1, data[:, 1].max() + 1
xx, yy = torch.meshgrid(torch.arange(x_min, x_max, 0.1), torch.arange(y_min, y_max, 0.1), indexing='ij')
grid = torch.cat([xx.reshape(-1, 1), yy.reshape(-1, 1)], dim=1)
predictions = model(grid).detach().numpy().reshape(xx.shape)
plt.contourf(xx, yy, predictions, levels=[0, 0.5, 1], cmap='coolwarm', alpha=0.7)
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm', edgecolors='k')
plt.title("Entscheidungsgrenze")
plt.show()
plot_decision_boundary(model, data)
6. Vollständiger Code
Der vollständige Code sieht wie folgt aus:
Beispiel
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
# Einige Zufallsdaten generieren
n_samples = 100
data = torch.randn(n_samples, 2) # 100 zweidimensionale Datenpunkte erzeugen
labels = (data[:, 0]**2 + data[:, 1]**2 < 1).float().unsqueeze(1) # Punkt innerhalb des Kreises ist 1, außerhalb des Kreises ist 0
# Daten visualisieren
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm')
plt.title("Generierte Daten")
plt.xlabel("Merkmal 1")
plt.ylabel("Merkmal 2")
plt.show()
# Feedforward-Neuronales Netz definieren
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
# Schichten des neuronalen Netzes definieren
self.fc1 = nn.Linear(2, 4) # Eingabeschicht hat 2 Merkmale, verborgene Schicht hat 4 Neuronen
self.fc2 = nn.Linear(4, 1) # Verborgene Schicht hat 1 Neuron als Ausgabe (für binäre Klassifikation)
self.sigmoid = nn.Sigmoid() # Aktivierungsfunktion für binäre Klassifikation
def forward(self, x):
x = torch.relu(self.fc1(x)) # ReLU-Aktivierungsfunktion verwenden
x = self.sigmoid(self.fc2(x)) # Ausgabeschicht verwendet Sigmoid-Aktivierungsfunktion
return x
# Modell instanziieren
model = SimpleNN()
# Verlustfunktion und Optimierer definieren
criterion = nn.BCELoss() # Binärer Kreuzentropieverlust
optimizer = optim.SGD(model.parameters(), lr=0.1) # Stochastischen Gradientenabstiegsoptimierer verwenden
# Trainieren
epochs = 100
for epoch in range(epochs):
# Vorwärtspropagation
outputs = model(data)
loss = criterion(outputs, labels)
# Rückwärtspropagation
optimizer.zero_grad()
loss.backward()
optimizer.step()
# Verlust alle 10 Epochen ausgeben
if (epoch + 1) % 10 == 0:
print(f'Epoche [{epoch + 1}/{epochs}], Verlust: {loss.item():.4f}')
# Entscheidungsgrenze visualisieren
def plot_decision_boundary(model, data):
x_min, x_max = data[:, 0].min() - 1, data[:, 0].max() + 1
y_min, y_max = data[:, 1].min() - 1, data[:, 1].max() + 1
xx, yy = torch.meshgrid(torch.arange(x_min, x_max, 0.1), torch.arange(y_min, y_max, 0.1), indexing='ij')
grid = torch.cat([xx.reshape(-1, 1), yy.reshape(-1, 1)], dim=1)
predictions = model(grid).detach().numpy().reshape(xx.shape)
plt.contourf(xx, yy, predictions, levels=[0, 0.5, 1], cmap='coolwarm', alpha=0.7)
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm', edgecolors='k')
plt.title("Entscheidungsgrenze")
plt.show()
plot_decision_boundary(model, data)
Verlustausgabe während des Trainings:
Epoch [10/100], Loss: 0.5247
Epoch [20/100], Loss: 0.3142
...
Epoch [100/100], Loss: 0.0957
Die Abbildung zeigt die ursprünglichen Datenpunkte (rot und blau) sowie die vom Modell erlernte Klassifikationsgrenze.