PyTorch primera red neuronal
En este capítulo presentaremos cómo implementar una red neuronal de alimentación hacia adelante simple con PyTorch para realizar una tarea de clasificación binaria.
El siguiente ejemplo muestra cómo utilizar PyTorch para implementar una red neuronal simple y entrenarla en una tarea de clasificación binaria.
La estructura de la red incluye una capa de entrada, una capa oculta y una capa de salida, utilizando las funciones de activación ReLU y Sigmoid.
Se utilizan la función de pérdida de error cuadrático medio y el optimizador de descenso de gradiente estocástico.
El proceso de entrenamiento ajusta gradualmente los parámetros del modelo mediante propagación hacia adelante, cálculo de pérdida, propagación hacia atrás y actualización de parámetros.
Ejemplo
import torch
import torch.nn as nn
# Definir el tamaño de la capa de entrada, el tamaño de la capa oculta, el tamaño de la capa de salida y el tamaño del lote
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
# Crear datos de entrada y datos objetivo ficticios
x = torch.randn(batch_size, n_in) # Generar datos de entrada aleatorios
y = torch.tensor([[1.0], [0.0], [0.0],
[1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]]) # Datos de salida objetivo
# Crear un modelo secuencial que incluya una capa lineal, la función de activación ReLU y la función de activación Sigmoid
model = nn.Sequential(
nn.Linear(n_in, n_h), # Transformación lineal de la capa de entrada a la capa oculta
nn.ReLU(), # Función de activación ReLU de la capa oculta
nn.Linear(n_h, n_out), # Transformación lineal de la capa oculta a la capa de salida
nn.Sigmoid() # Función de activación Sigmoid de la capa de salida
)
# Definir la función de pérdida de error cuadrático medio y el optimizador de descenso de gradiente estocástico
criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # Tasa de aprendizaje 0.01
# Ejecutar el algoritmo de descenso de gradiente para entrenar el modelo
for epoch in range(50): # Iterar 50 veces
y_pred = model(x) # Propagación hacia adelante, calcular el valor de predicción
loss = criterion(y_pred, y) # Calcular la pérdida
print('epoch: ', epoch, 'loss: ', loss.item()) # Imprimir el valor de pérdida
optimizer.zero_grad() # Poner a cero los gradientes
loss.backward() # Propagación hacia atrás, calcular gradientes
optimizer.step() # Actualizar los parámetros del modelo
El resultado de salida es similar al siguiente:
epoch:  0 loss:  0.2591968774795532
epoch:  1 loss:  0.25902628898620605
epoch:  2 loss:  0.25885599851608276
epoch:  3 loss:  0.25868603587150574
epoch:  4 loss:  0.25851646065711975
...
Definir los parámetros de la red:
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
n_inTamaño de la capa de entrada: 10, es decir, cada punto de datos tiene 10 características.n_hTamaño de la capa oculta: 5, es decir, la capa oculta contiene 5 neuronas.n_outTamaño de la capa de salida: 1, es decir, se emite un escalar que representa el resultado de clasificación binaria (0 o 1).batch_sizeTamaño del lote: cada lote contiene 10 muestras.
Generar datos de entrada y datos objetivo:
x = torch.randn(batch_size, n_in)  # 随机生成输入数据
y = torch.tensor([[1.0], [0.0], [0.0],
                 [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])  # 目标输出数据
x: se genera aleatoriamente una matriz de datos de entrada de forma(10, 10), que representa 10 muestras, cada una con 10 características.y: datos de salida objetivo (etiquetas), que representan la etiqueta de clase de cada muestra de entrada (0 o 1), es un tensor de 10×1.
Definir el modelo de red neuronal:
model = nn.Sequential(
   nn.Linear(n_in, n_h),  # 输入层到隐藏层的线性变换
   nn.ReLU(),            # 隐藏层的ReLU激活函数
   nn.Linear(n_h, n_out),  # 隐藏层到输出层的线性变换
   nn.Sigmoid()           # 输出层的Sigmoid激活函数
)
nn.SequentialSe utiliza para definir las capas de la red en orden.
nn.Linear(n_in, n_h): define la transformación lineal de la capa de entrada a la capa oculta, con 10 características de entrada y 5 neuronas en la capa oculta.nn.ReLU(): agrega la función de activación ReLU después de la capa oculta para aumentar la no linealidad.nn.Linear(n_h, n_out): define la transformación lineal de la capa oculta a la capa de salida, con 1 neurona de salida.nn.Sigmoid(): la capa de salida usa la función de activación Sigmoid para mapear el resultado a un rango entre 0 y 1, utilizada en tareas de clasificación binaria.
Definir la función de pérdida y el optimizador:
criterion = torch.nn.MSELoss()  # 使用均方误差损失函数
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)  # 使用随机梯度下降优化器,学习率为 0.01
Bucle de entrenamiento:
for epoch in range(50):  # 训练50轮
   y_pred = model(x)  # 前向传播,计算预测值
   loss = criterion(y_pred, y)  # 计算损失
   print('epoch: ', epoch, 'loss: ', loss.item())  # 打印损失值

   optimizer.zero_grad()  # 清零梯度
   loss.backward()  # 反向传播,计算梯度
   optimizer.step()  # 更新模型参数
for epoch in range(50): realiza 50 iteraciones de entrenamiento.y_pred = model(x): realiza la propagación hacia adelante, usando los parámetros actuales del modelo para calcular la predicciónxde los datos de entrada.loss = criterion(y_pred, y): calcular el valor de predicción y el valor objetivo,yla pérdida entre ellos.optimizer.zero_grad(): limpiar los valores de gradiente de la ronda de entrenamiento anterior.loss.backward(): propagación hacia atrás, calcular el gradiente de la función de pérdida con respecto a los parámetros del modelo.optimizer.step(): actualizar los parámetros del modelo según el gradiente calculado.
Código de visualización:
Ejemplo
import torch.nn as nn
import matplotlib.pyplot as plt
# Definir el tamaño de la capa de entrada, el tamaño de la capa oculta, el tamaño de la capa de salida y el tamaño del lote
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
# Crear datos de entrada y datos objetivo ficticios
x = torch.randn(batch_size, n_in) # Generar datos de entrada aleatorios
y = torch.tensor([[1.0], [0.0], [0.0],
[1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]]) # Datos de salida objetivo
# Crear un modelo secuencial que incluya una capa lineal, la función de activación ReLU y la función de activación Sigmoid
model = nn.Sequential(
nn.Linear(n_in, n_h), # Transformación lineal de la capa de entrada a la capa oculta
nn.ReLU(), # Función de activación ReLU de la capa oculta
nn.Linear(n_h, n_out), # Transformación lineal de la capa oculta a la capa de salida
nn.Sigmoid() # Función de activación Sigmoid de la capa de salida
)
# Definir la función de pérdida de error cuadrático medio y el optimizador de descenso de gradiente estocástico
criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # Tasa de aprendizaje 0.01
# Se utiliza para almacenar el valor de pérdida de cada ronda
losses = []
# Ejecutar el algoritmo de descenso de gradiente para entrenar el modelo
for epoch in range(50): # Iterar 50 veces
y_pred = model(x) # Propagación hacia adelante, calcular el valor de predicción
loss = criterion(y_pred, y) # Calcular la pérdida
losses.append(loss.item()) # Registrar el valor de pérdida
print(f'Epoch [{epoch+1}/50], Loss: {loss.item():.4f}') # Imprimir el valor de pérdida
optimizer.zero_grad() # Poner a cero los gradientes
loss.backward() # Propagación hacia atrás, calcular gradientes
optimizer.step() # Actualizar los parámetros del modelo
# Visualizar la curva de cambio de pérdida
plt.figure(figsize=(8, 5))
plt.plot(range(1, 51), losses, label='Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.title('Training Loss Over Epochs')
plt.legend()
plt.grid()
plt.show()
# Visualizar la comparación entre los resultados de predicción y los valores objetivo reales
y_pred_final = model(x).detach().numpy() # Valor de predicción final
y_actual = y.numpy() # Valor real
plt.figure(figsize=(8, 5))
plt.plot(range(1, batch_size + 1), y_actual, 'o-', label='Actual', color='blue')
plt.plot(range(1, batch_size + 1), y_pred_final, 'x--', label='Predicted', color='red')
plt.xlabel('Sample Index')
plt.ylabel('Value')
plt.title('Actual vs Predicted Values')
plt.legend()
plt.grid()
plt.show()
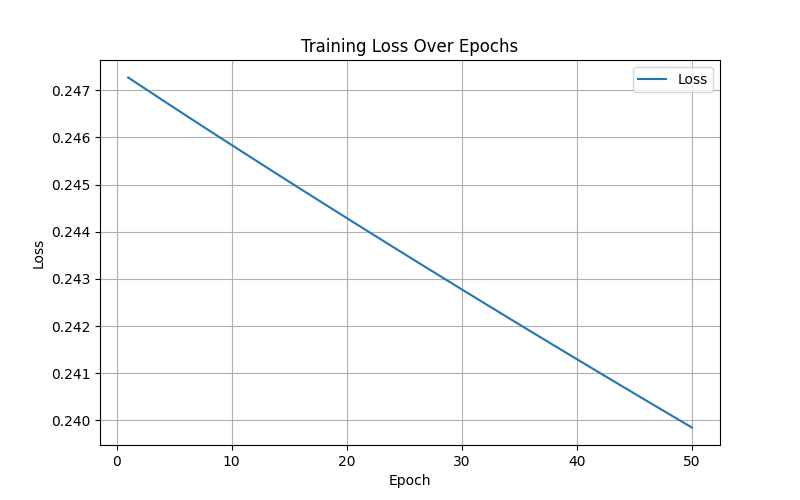
Se muestra como sigue:
Otro ejemplo
Supongamos que tenemos un conjunto de datos bidimensional y el objetivo es clasificar los puntos en dos categorías según su posición (por ejemplo, puntos rojos y azules).
El siguiente ejemplo muestra cómo usar una red neuronal para completar una tarea simple de clasificación binaria, lo que sienta las bases para tareas más complejas. Gracias a la interfaz modular de PyTorch, la construcción, el entrenamiento y la visualización de redes neuronales son muy intuitivos.
1. Preparación de datos
Primero, generamos algunos datos bidimensionales simples:
Ejemplo
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
# Generar algunos datos aleatorios
n_samples = 100
data = torch.randn(n_samples, 2) # Generar 100 puntos de datos bidimensionales
labels = (data[:, 0]**2 + data[:, 1]**2 < 1).float().unsqueeze(1) # El punto dentro del círculo es 1, fuera del círculo es 0
# Visualizar los datos
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm')
plt.title("Generated Data")
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")
plt.show()
Descripción de los datos:
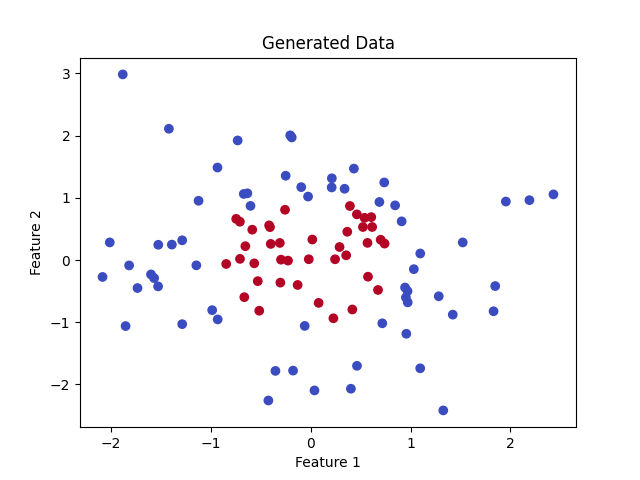
dataSon los puntos bidimensionales de entrada, cada punto tiene dos características.labelses la clasificación objetivo, el punto es 1 si está dentro de la región circular, de lo contrario es 0.
Se muestra a continuación:
2. Definir la red neuronal
Usa PyTorch para crear una red neuronal de alimentación hacia adelante simple.
La red neuronal de alimentación hacia adelante utiliza una capa oculta y captura los patrones no lineales de los datos mediante transformaciones lineales simples y funciones de activación.
Ejemplo
def __init__(self):
super(SimpleNN, self).__init__()
# Definir las capas de la red neuronal
self.fc1 = nn.Linear(2, 4) # La capa de entrada tiene 2 características, la capa oculta tiene 4 neuronas
self.fc2 = nn.Linear(4, 1) # La capa oculta sale a 1 neurona (para clasificación binaria)
self.sigmoid = nn.Sigmoid() # Función de activación para clasificación binaria
def forward(self, x):
x = torch.relu(self.fc1(x)) # Usar la función de activación ReLU
x = self.sigmoid(self.fc2(x)) # La capa de salida usa la función de activación Sigmoid
return x
# Instanciar el modelo
model = SimpleNN()
3. Definir la función de pérdida y el optimizador
Ejemplo
criterion = nn.BCELoss() # Pérdida de entropía cruzada binaria
optimizer = optim.SGD(model.parameters(), lr=0.1) # Usar el optimizador de descenso de gradiente estocástico
4. Entrenar el modelo
Entrena el modelo con los datos para que aprenda a clasificar.
Ejemplo
epochs = 100
for epoch in range(epochs):
# Propagación hacia adelante
outputs = model(data)
loss = criterion(outputs, labels)
# Propagación hacia atrás
optimizer.zero_grad()
loss.backward()
optimizer.step()
# Imprimir la pérdida cada 10 iteraciones
if (epoch + 1) % 10 == 0:
print(f'Epoch [{epoch + 1}/{epochs}], Loss: {loss.item():.4f}')
5. Probar el modelo y visualizar los resultados
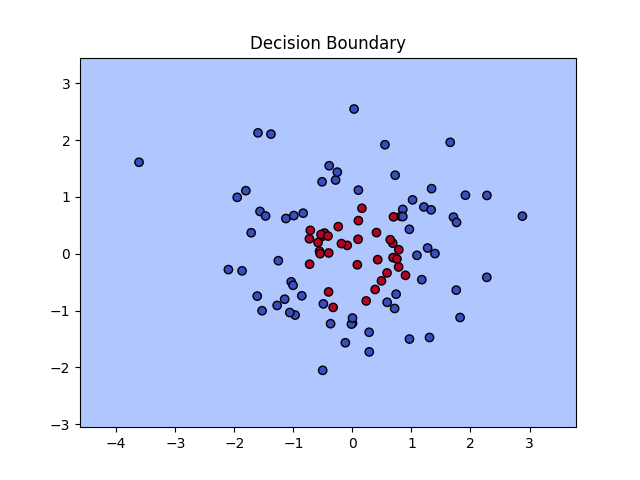
Probamos el modelo y dibujamos la frontera de decisión en la imagen.
Ejemplo
def plot_decision_boundary(model, data):
x_min, x_max = data[:, 0].min() - 1, data[:, 0].max() + 1
y_min, y_max = data[:, 1].min() - 1, data[:, 1].max() + 1
xx, yy = torch.meshgrid(torch.arange(x_min, x_max, 0.1), torch.arange(y_min, y_max, 0.1), indexing='ij')
grid = torch.cat([xx.reshape(-1, 1), yy.reshape(-1, 1)], dim=1)
predictions = model(grid).detach().numpy().reshape(xx.shape)
plt.contourf(xx, yy, predictions, levels=[0, 0.5, 1], cmap='coolwarm', alpha=0.7)
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm', edgecolors='k')
plt.title("Decision Boundary")
plt.show()
plot_decision_boundary(model, data)
6. Código completo
El código completo es el siguiente:
Ejemplo
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
# Generar algunos datos aleatorios
n_samples = 100
data = torch.randn(n_samples, 2) # Generar 100 puntos de datos bidimensionales
labels = (data[:, 0]**2 + data[:, 1]**2 < 1).float().unsqueeze(1) # El punto dentro del círculo es 1, fuera del círculo es 0
# Visualizar los datos
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm')
plt.title("Generated Data")
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")
plt.show()
# Definir la red neuronal de alimentación hacia adelante
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
# Definir las capas de la red neuronal
self.fc1 = nn.Linear(2, 4) # La capa de entrada tiene 2 características, la capa oculta tiene 4 neuronas
self.fc2 = nn.Linear(4, 1) # La capa oculta sale a 1 neurona (para clasificación binaria)
self.sigmoid = nn.Sigmoid() # Función de activación para clasificación binaria
def forward(self, x):
x = torch.relu(self.fc1(x)) # Usar la función de activación ReLU
x = self.sigmoid(self.fc2(x)) # La capa de salida usa la función de activación Sigmoid
return x
# Instanciar el modelo
model = SimpleNN()
# Definir la función de pérdida y el optimizador
criterion = nn.BCELoss() # Pérdida de entropía cruzada binaria
optimizer = optim.SGD(model.parameters(), lr=0.1) # Usar el optimizador de descenso de gradiente estocástico
# Entrenamiento
epochs = 100
for epoch in range(epochs):
# Propagación hacia adelante
outputs = model(data)
loss = criterion(outputs, labels)
# Propagación hacia atrás
optimizer.zero_grad()
loss.backward()
optimizer.step()
# Imprimir la pérdida cada 10 épocas
if (epoch + 1) % 10 == 0:
print(f'Epoch [{epoch + 1}/{epochs}], Loss: {loss.item():.4f}')
# Visualizar el límite de decisión
def plot_decision_boundary(model, data):
x_min, x_max = data[:, 0].min() - 1, data[:, 0].max() + 1
y_min, y_max = data[:, 1].min() - 1, data[:, 1].max() + 1
xx, yy = torch.meshgrid(torch.arange(x_min, x_max, 0.1), torch.arange(y_min, y_max, 0.1), indexing='ij')
grid = torch.cat([xx.reshape(-1, 1), yy.reshape(-1, 1)], dim=1)
predictions = model(grid).detach().numpy().reshape(xx.shape)
plt.contourf(xx, yy, predictions, levels=[0, 0.5, 1], cmap='coolwarm', alpha=0.7)
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm', edgecolors='k')
plt.title("Decision Boundary")
plt.show()
plot_decision_boundary(model, data)
Salida de pérdida durante el entrenamiento:
Epoch [10/100], Loss: 0.5247
Epoch [20/100], Loss: 0.3142
...
Epoch [100/100], Loss: 0.0957
La figura muestra los puntos de datos originales (rojo y azul), así como el límite de clasificación aprendido por el modelo.