Первая нейронная сеть PyTorch
В этой главе мы расскажем, как использовать PyTorch для реализации простой нейронной сети прямого распространения для выполнения задачи бинарной классификации.
В следующем примере показано, как использовать PyTorch для реализации простой нейронной сети для обучения бинарной классификации.
Структура сети включает входной слой, скрытый слой и выходной слой и использует функцию активации ReLU и функцию активации Sigmoid.
Используется функция потерь среднеквадратичной ошибки и оптимизатор стохастического градиентного спуска.
Процесс обучения постепенно корректирует параметры модели посредством прямого распространения, вычисления потерь, обратного распространения и обновления параметров.
Пример
import torch
import torch.nn as nn
# Определение размера входного слоя, размера скрытого слоя, размера выходного слоя и размера пакета
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
# Создать фиктивные входные данные и целевые данные
x = torch.randn(batch_size, n_in) # Сгенерировать входные данные случайным образом
y = torch.tensor([[1.0], [0.0], [0.0],
[1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]]) # Целевые выходные данные
# Создать последовательную модель с линейными слоями, функцией активации ReLU и функцией активации Sigmoid
model = nn.Sequential(
nn.Linear(n_in, n_h), # Линейное преобразование из входного слоя в скрытый слой
nn.ReLU(), # Функция активации ReLU для скрытого слоя
nn.Linear(n_h, n_out), # Линейное преобразование из скрытого слоя в выходной слой
nn.Sigmoid() # Функция активации Sigmoid для выходного слоя
)
# Определить функцию потерь среднеквадратичной ошибки и оптимизатор стохастического градиентного спуска
criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # Скорость обучения равна 0.01
# Выполнить алгоритм градиентного спуска для обучения модели
for epoch in range(50): # Повторить 50 раз
y_pred = model(x) # Прямое распространение, вычислить предсказанные значения
loss = criterion(y_pred, y) # Вычислить потерю
print('эпоха: ', epoch, 'потеря: ', loss.item()) # Вывести значение потерь
optimizer.zero_grad() # Очистить градиенты
loss.backward() # Обратное распространение, вычислить градиенты
optimizer.step() # Обновить параметры модели
Результат вывода аналогичен следующему:
epoch:  0 loss:  0.2591968774795532
epoch:  1 loss:  0.25902628898620605
epoch:  2 loss:  0.25885599851608276
epoch:  3 loss:  0.25868603587150574
epoch:  4 loss:  0.25851646065711975
...
Определите параметры сети:
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
n_in: Размер входного слоя равен 10, то есть каждая точка данных имеет 10 признаков.n_h: Размер скрытого слоя равен 5, то есть скрытый слой содержит 5 нейронов.n_out: Размер выходного слоя равен 1, то есть он выводит скаляр, представляющий результат бинарной классификации (0 или 1).batch_size: Каждый батч содержит 10 образцов.
Сгенерировать входные данные и целевые данные:
x = torch.randn(batch_size, n_in)  # 随机生成输入数据
y = torch.tensor([[1.0], [0.0], [0.0],
                 [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])  # 目标输出数据
x: Случайным образом сгенерировать форму(10, 10)матрицы входных данных, представляющей 10 образцов, каждый из которых имеет 10 признаков.y: Целевые выходные данные (метки), представляющие метку класса (0 или 1) для каждого входного образца, — это тензор 10×1.
Определить модель нейронной сети:
model = nn.Sequential(
   nn.Linear(n_in, n_h),  # 输入层到隐藏层的线性变换
   nn.ReLU(),            # 隐藏层的ReLU激活函数
   nn.Linear(n_h, n_out),  # 隐藏层到输出层的线性变换
   nn.Sigmoid()           # 输出层的Sigmoid激活函数
)
nn.SequentialИспользуется для последовательного определения слоёв сети.
nn.Linear(n_in, n_h): Определяет линейное преобразование из входного слоя в скрытый слой, с 10 входными признаками и 5 нейронами в скрытом слое.nn.ReLU(): Добавляет функцию активации ReLU после скрытого слоя для увеличения нелинейности.nn.Linear(n_h, n_out): Определяет линейное преобразование из скрытого слоя в выходной слой, с 1 выходным нейроном.nn.Sigmoid(): Выходной слой использует функцию активации Sigmoid для отображения результата в диапазон от 0 до 1 для бинарной классификации.
Определить функцию потерь и оптимизатор:
criterion = torch.nn.MSELoss()  # 使用均方误差损失函数
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)  # 使用随机梯度下降优化器,学习率为 0.01
Цикл обучения:
for epoch in range(50):  # 训练50轮
   y_pred = model(x)  # 前向传播,计算预测值
   loss = criterion(y_pred, y)  # 计算损失
   print('epoch: ', epoch, 'loss: ', loss.item())  # 打印损失值

   optimizer.zero_grad()  # 清零梯度
   loss.backward()  # 反向传播,计算梯度
   optimizer.step()  # 更新模型参数
for epoch in range(50): Выполните 50 итераций обучения.y_pred = model(x): Выполните прямое распространение, используя текущие параметры модели для вычисления входных данныхx.loss = criterion(y_pred, y): Вычислите предсказанные значения и целевые значенияyпотерю между ними.optimizer.zero_grad(): Очистите значения градиента от предыдущего раунда обучения.loss.backward(): Обратное распространение, вычислите градиент функции потерь по параметрам модели.optimizer.step(): Обновите параметры модели на основе вычисленных градиентов.
Код визуализации:
Пример
import torch.nn as nn
import matplotlib.pyplot as plt
# Определение размера входного слоя, размера скрытого слоя, размера выходного слоя и размера пакета
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
# Создать фиктивные входные данные и целевые данные
x = torch.randn(batch_size, n_in) # Сгенерировать входные данные случайным образом
y = torch.tensor([[1.0], [0.0], [0.0],
[1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]]) # Целевые выходные данные
# Создать последовательную модель с линейными слоями, функцией активации ReLU и функцией активации Sigmoid
model = nn.Sequential(
nn.Linear(n_in, n_h), # Линейное преобразование из входного слоя в скрытый слой
nn.ReLU(), # Функция активации ReLU для скрытого слоя
nn.Linear(n_h, n_out), # Линейное преобразование из скрытого слоя в выходной слой
nn.Sigmoid() # Функция активации Sigmoid для выходного слоя
)
# Определить функцию потерь среднеквадратичной ошибки и оптимизатор стохастического градиентного спуска
criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # Скорость обучения равна 0.01
# Используется для хранения значения потерь для каждой эпохи
losses = []
# Выполнить алгоритм градиентного спуска для обучения модели
for epoch in range(50): # Повторить 50 раз
y_pred = model(x) # Прямое распространение, вычислить предсказанные значения
loss = criterion(y_pred, y) # Вычислить потерю
losses.append(loss.item()) # Записать значение потерь
print(f'Эпоха [{epoch+1}/50], Потеря: {loss.item():.4f}') # Вывести значение потери
optimizer.zero_grad() # Очистить градиенты
loss.backward() # Обратное распространение, вычислить градиенты
optimizer.step() # Обновить параметры модели
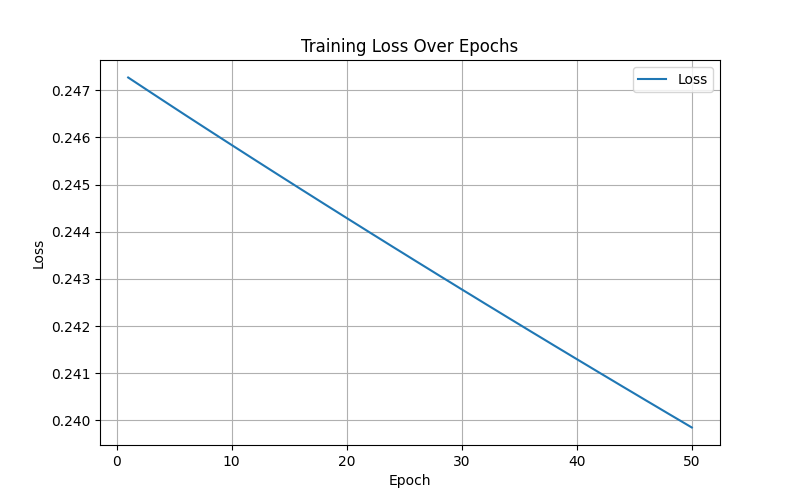
# Визуализировать кривую потерь
plt.figure(figsize=(8, 5))
plt.plot(range(1, 51), losses, label='Потеря')
plt.xlabel('Эпоха')
plt.ylabel('Потери')
plt.title('Потери при обучении по эпохам')
plt.legend()
plt.grid()
plt.show()
# Визуализировать сравнение предсказанных результатов с фактическими целевыми значениями
y_pred_final = model(x).detach().numpy() # Итоговые предсказанные значения
y_actual = y.numpy() # Фактические значения
plt.figure(figsize=(8, 5))
plt.plot(range(1, batch_size + 1), y_actual, 'o-', label='Фактическое', color='blue')
plt.plot(range(1, batch_size + 1), y_pred_final, 'x--', label='Предсказано', color='red')
plt.xlabel('Индекс образца')
plt.ylabel('Значение')
plt.title('Фактические и предсказанные значения')
plt.legend()
plt.grid()
plt.show()
Отображается следующим образом:
Другой пример
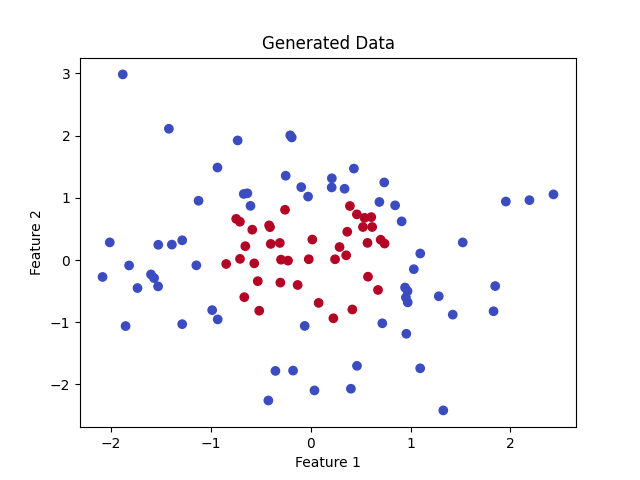
Предположим, имеется двумерный набор данных, и цель — классифицировать точки на две категории на основе их расположения (например, красные и синие точки).
Следующий пример демонстрирует, как использовать нейронную сеть для выполнения простой задачи бинарной классификации, закладывая основу для более сложных задач. Благодаря модульному интерфейсу PyTorch построение, обучение и визуализация нейронных сетей очень интуитивны.
1. Подготовка данных
Сначала сгенерируем некоторые простые двумерные данные:
Пример
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
# Сгенерировать случайные данные
n_samples = 100
data = torch.randn(n_samples, 2) # Сгенерировать 100 двумерных точек данных
labels = (data[:, 0]**2 + data[:, 1]**2 < 1).float().unsqueeze(1) # Точка внутри круга равна 1, вне круга — 0
# Визуализировать данные
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm')
plt.title("Сгенерированные данные")
plt.xlabel("Признак 1")
plt.ylabel("Признак 2")
plt.show()
Описание данных:
dataВходные данные — двумерная точка, каждая точка имеет две характеристики.labelsЦелевая классификация: 1, если точка находится внутри круговой области, иначе 0.
Отображается следующим образом:
2. Определение нейронной сети
Используйте PyTorch, чтобы создать простую нейронную сеть прямого распространения.
Нейронная сеть прямого распространения использует один скрытый слой, улавливая нелинейные закономерности в данных с помощью простых линейных преобразований и функций активации.
Пример
def __init__(self):
super(SimpleNN, self).__init__()
# Определение слоёв нейронной сети
self.fc1 = nn.Linear(2, 4) # Входной слой имеет 2 признака, скрытый слой имеет 4 нейрона
self.fc2 = nn.Linear(4, 1) # Скрытый слой выводит на 1 нейрон (для бинарной классификации)
self.sigmoid = nn.Sigmoid() # Функция активации для бинарной классификации
def forward(self, x):
x = torch.relu(self.fc1(x)) # Используйте функцию активации ReLU
x = self.sigmoid(self.fc2(x)) # Выходной слой использует функцию активации Sigmoid
return x
# Создать экземпляр модели
model = SimpleNN()
3. Определите функцию потерь и оптимизатор
Пример
criterion = nn.BCELoss() # Потеря бинарной кросс-энтропии
optimizer = optim.SGD(model.parameters(), lr=0.1) # Используйте оптимизатор стохастического градиентного спуска
4. Обучите модель
Обучите модель на данных, чтобы она научилась классифицировать.
Пример
epochs = 100
for epoch in range(epochs):
# Прямое распространение
outputs = model(data)
loss = criterion(outputs, labels)
# Обратное распространение
optimizer.zero_grad()
loss.backward()
optimizer.step()
# Выводить потери каждые 10 эпох
if (epoch + 1) % 10 == 0:
print(f'Эпоха [{epoch + 1}/{epochs}], Потери: {loss.item():.4f}')
5. Протестируйте модель и визуализируйте результаты
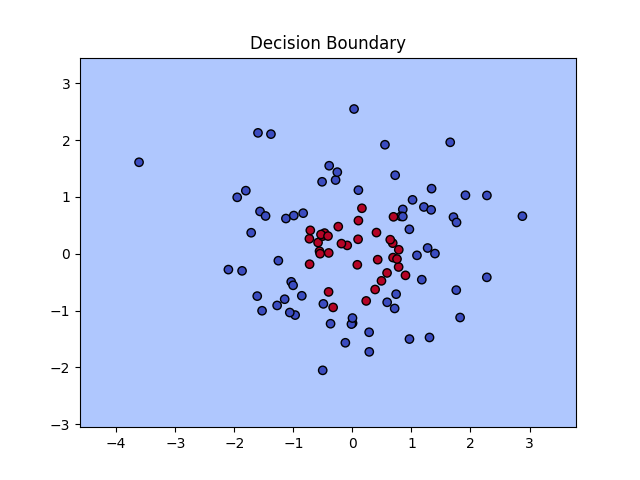
Мы тестируем модель и строим границу решения на изображении.
Пример
def plot_decision_boundary(model, data):
x_min, x_max = data[:, 0].min() - 1, data[:, 0].max() + 1
y_min, y_max = data[:, 1].min() - 1, data[:, 1].max() + 1
xx, yy = torch.meshgrid(torch.arange(x_min, x_max, 0.1), torch.arange(y_min, y_max, 0.1), indexing='ij')
grid = torch.cat([xx.reshape(-1, 1), yy.reshape(-1, 1)], dim=1)
predictions = model(grid).detach().numpy().reshape(xx.shape)
plt.contourf(xx, yy, predictions, levels=[0, 0.5, 1], cmap='coolwarm', alpha=0.7)
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm', edgecolors='k')
plt.title("Граница решения")
plt.show()
plot_decision_boundary(model, data)
6. Полный код
Полный код приведён ниже:
Пример
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
# Сгенерировать случайные данные
n_samples = 100
data = torch.randn(n_samples, 2) # Сгенерировать 100 двумерных точек данных
labels = (data[:, 0]**2 + data[:, 1]**2 < 1).float().unsqueeze(1) # Точка внутри круга равна 1, вне круга — 0
# Визуализировать данные
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm')
plt.title("Сгенерированные данные")
plt.xlabel("Признак 1")
plt.ylabel("Признак 2")
plt.show()
# Определяем нейронную сеть прямого распространения
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
# Определение слоёв нейронной сети
self.fc1 = nn.Linear(2, 4) # Входной слой имеет 2 признака, скрытый слой имеет 4 нейрона
self.fc2 = nn.Linear(4, 1) # Скрытый слой выводит на 1 нейрон (для бинарной классификации)
self.sigmoid = nn.Sigmoid() # Функция активации для бинарной классификации
def forward(self, x):
x = torch.relu(self.fc1(x)) # Используйте функцию активации ReLU
x = self.sigmoid(self.fc2(x)) # Выходной слой использует функцию активации Sigmoid
return x
# Создать экземпляр модели
model = SimpleNN()
# Определяем функцию потерь и оптимизатор
criterion = nn.BCELoss() # Потеря бинарной кросс-энтропии
optimizer = optim.SGD(model.parameters(), lr=0.1) # Используйте оптимизатор стохастического градиентного спуска
# Обучить
epochs = 100
for epoch in range(epochs):
# Прямое распространение
outputs = model(data)
loss = criterion(outputs, labels)
# Обратное распространение
optimizer.zero_grad()
loss.backward()
optimizer.step()
# Выводить потери каждые 10 эпох
if (epoch + 1) % 10 == 0:
print(f'Эпоха [{epoch + 1}/{epochs}], Потери: {loss.item():.4f}')
# Визуализация границы решения
def plot_decision_boundary(model, data):
x_min, x_max = data[:, 0].min() - 1, data[:, 0].max() + 1
y_min, y_max = data[:, 1].min() - 1, data[:, 1].max() + 1
xx, yy = torch.meshgrid(torch.arange(x_min, x_max, 0.1), torch.arange(y_min, y_max, 0.1), indexing='ij')
grid = torch.cat([xx.reshape(-1, 1), yy.reshape(-1, 1)], dim=1)
predictions = model(grid).detach().numpy().reshape(xx.shape)
plt.contourf(xx, yy, predictions, levels=[0, 0.5, 1], cmap='coolwarm', alpha=0.7)
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm', edgecolors='k')
plt.title("Граница решения")
plt.show()
plot_decision_boundary(model, data)
Вывод функции потерь во время обучения:
Epoch [10/100], Loss: 0.5247
Epoch [20/100], Loss: 0.3142
...
Epoch [100/100], Loss: 0.0957
На рисунке показаны исходные точки данных (красные и синие), а также граница классификации, изученная моделью.