PyTorch 最初のニューラルネットワーク
この章では、PyTorchを使用して簡単なフィードフォワードニューラルネットワークを実装し、二値分類タスクを実行する方法を紹介します。
以下の例では、PyTorchを使用して簡単なニューラルネットワークを実装し、二値分類タスクのトレーニングを行う方法を示します。
ネットワーク構造は入力層、隠れ層、出力層で構成され、ReLU活性化関数とSigmoid活性化関数を使用しています。
平均二乗誤差損失関数と確率的勾配降下法オプティマイザを採用しています。
トレーニングプロセスは、順伝播、損失計算、逆伝播、パラメータ更新を通じてモデルパラメータを段階的に調整します。
例
import torch
import torch.nn as nn
# 入力層サイズ、隠れ層サイズ、出力層サイズ、バッチサイズを定義
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
# ダミー入力データとターゲットデータを作成
x = torch.randn(batch_size, n_in) # 入力データをランダムに生成
y = torch.tensor([[1.0], [0.0], [0.0],
[1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]]) # ターゲット出力データ
# 線形層、ReLU活性化関数、Sigmoid活性化関数を含むシーケンシャルモデルを作成
model = nn.Sequential(
nn.Linear(n_in, n_h), # 入力層から隠れ層への線形変換
nn.ReLU(), # 隠れ層のReLU活性化関数
nn.Linear(n_h, n_out), # 隠れ層から出力層への線形変換
nn.Sigmoid() # 出力層のSigmoid活性化関数
)
# 平均二乗誤差損失関数と確率的勾配降下法オプティマイザを定義
criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # 学習率は0.01
# 勾配降下アルゴリズムを実行してモデルをトレーニング
for epoch in range(50): # 50回反復
y_pred = model(x) # 順伝播、予測値を計算
loss = criterion(y_pred, y) # 損失を計算
print('epoch: ', epoch, 'loss: ', loss.item()) # 損失値を出力
optimizer.zero_grad() # 勾配をゼロにリセット
loss.backward() # 逆伝播、勾配を計算
optimizer.step() # モデルパラメータを更新
出力結果は次のようになります:
epoch:  0 loss:  0.2591968774795532
epoch:  1 loss:  0.25902628898620605
epoch:  2 loss:  0.25885599851608276
epoch:  3 loss:  0.25868603587150574
epoch:  4 loss:  0.25851646065711975
...
ネットワークパラメータの定義:
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
n_in:入力層サイズは10、つまり各データポイントには10個の特徴があります。n_h:隠れ層サイズは5、つまり隠れ層には5個のニューロンが含まれます。n_out:出力層サイズは1、つまりスカラーを1つ出力し、二値分類の結果(0または1)を表します。batch_size:各バッチには10個のサンプルが含まれます。
入力データとターゲットデータの生成:
x = torch.randn(batch_size, n_in)  # 随机生成输入数据
y = torch.tensor([[1.0], [0.0], [0.0],
                 [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])  # 目标输出数据
x:形状が(10, 10)の入力データ行列をランダムに生成します。これは10個のサンプルを表し、各サンプルには10個の特徴があります。y:ターゲット出力データ(ラベル)は、各入力サンプルのクラスラベル(0または1)を表し、10×1のテンソルです。
ニューラルネットワークモデルの定義:
model = nn.Sequential(
   nn.Linear(n_in, n_h),  # 输入层到隐藏层的线性变换
   nn.ReLU(),            # 隐藏层的ReLU激活函数
   nn.Linear(n_h, n_out),  # 隐藏层到输出层的线性变换
   nn.Sigmoid()           # 输出层的Sigmoid激活函数
)
nn.Sequentialネットワーク層を順番に定義するために使用します。
nn.Linear(n_in, n_h):入力層から隠れ層への線形変換を定義します。入力特徴は10個、隠れ層には5個のニューロンがあります。nn.ReLU():隠れ層の後にReLU活性化関数を追加し、非線形性を高めます。nn.Linear(n_h, n_out):隠れ層から出力層への線形変換を定義し、出力は1個のニューロンです。nn.Sigmoid():出力層ではSigmoid活性化関数を使用し、結果を0から1の間にマッピングして、二値分類タスクに使用します。
損失関数とオプティマイザの定義:
criterion = torch.nn.MSELoss()  # 使用均方误差损失函数
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)  # 使用随机梯度下降优化器,学习率为 0.01
トレーニングループ:
for epoch in range(50):  # 训练50轮
   y_pred = model(x)  # 前向传播,计算预测值
   loss = criterion(y_pred, y)  # 计算损失
   print('epoch: ', epoch, 'loss: ', loss.item())  # 打印损失值

   optimizer.zero_grad()  # 清零梯度
   loss.backward()  # 反向传播,计算梯度
   optimizer.step()  # 更新模型参数
for epoch in range(50):50回のトレーニング反復を実行します。y_pred = model(x):順伝播を実行し、現在のモデルパラメータを使用して入力データxの予測値を計算します。loss = criterion(y_pred, y):予測値とターゲット値yの間の損失を計算します。optimizer.zero_grad():前回のトレーニング時の勾配値をクリアします。loss.backward():逆伝播を実行し、損失関数のモデルパラメータに関する勾配を計算します。optimizer.step():計算された勾配に基づいてモデルパラメータを更新します。
可視化コード:
例
import torch.nn as nn
import matplotlib.pyplot as plt
# 入力層サイズ、隠れ層サイズ、出力層サイズ、バッチサイズを定義
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
# ダミー入力データとターゲットデータを作成
x = torch.randn(batch_size, n_in) # 入力データをランダムに生成
y = torch.tensor([[1.0], [0.0], [0.0],
[1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]]) # ターゲット出力データ
# 線形層、ReLU活性化関数、Sigmoid活性化関数を含むシーケンシャルモデルを作成
model = nn.Sequential(
nn.Linear(n_in, n_h), # 入力層から隠れ層への線形変換
nn.ReLU(), # 隠れ層のReLU活性化関数
nn.Linear(n_h, n_out), # 隠れ層から出力層への線形変換
nn.Sigmoid() # 出力層のSigmoid活性化関数
)
# 平均二乗誤差損失関数と確率的勾配降下法オプティマイザを定義
criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # 学習率は0.01
# 各エポックの損失値を保存するために使用
losses = []
# 勾配降下アルゴリズムを実行してモデルをトレーニング
for epoch in range(50): # 50回反復
y_pred = model(x) # 順伝播、予測値を計算
loss = criterion(y_pred, y) # 損失を計算
losses.append(loss.item()) # 損失値を記録
print(f'Epoch [{epoch+1}/50], Loss: {loss.item():.4f}') # 損失値を出力
optimizer.zero_grad() # 勾配をゼロにリセット
loss.backward() # 逆伝播、勾配を計算
optimizer.step() # モデルパラメータを更新
# 損失変化曲線を可視化
plt.figure(figsize=(8, 5))
plt.plot(range(1, 51), losses, label='Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.title('Training Loss Over Epochs')
plt.legend()
plt.grid()
plt.show()
# 予測結果と実際のターゲット値の比較を可視化
y_pred_final = model(x).detach().numpy() # 最終予測値
y_actual = y.numpy() # 実際の値
plt.figure(figsize=(8, 5))
plt.plot(range(1, batch_size + 1), y_actual, 'o-', label='Actual', color='blue')
plt.plot(range(1, batch_size + 1), y_pred_final, 'x--', label='Predicted', color='red')
plt.xlabel('Sample Index')
plt.ylabel('Value')
plt.title('Actual vs Predicted Values')
plt.legend()
plt.grid()
plt.show()
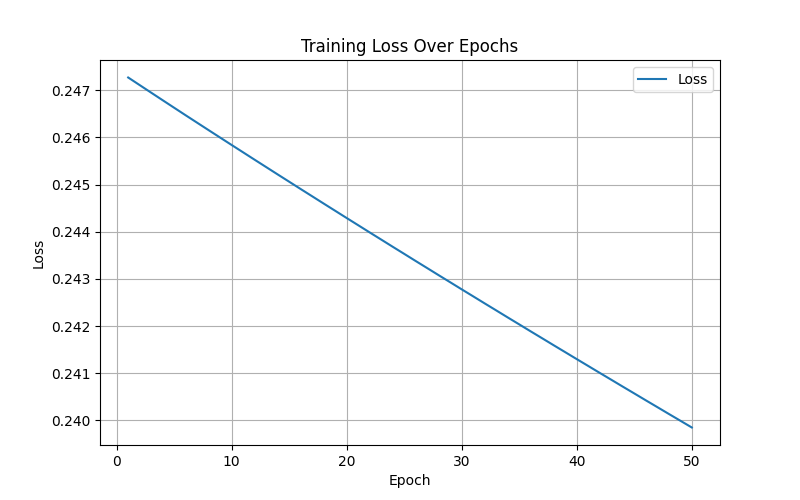
表示は次のようになります:
もう一つの例
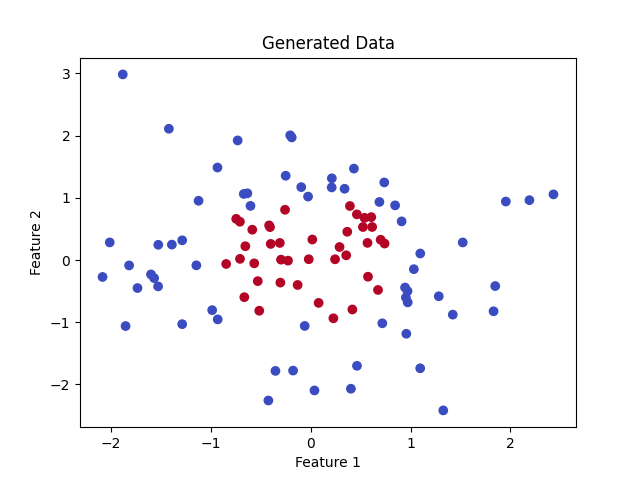
2次元のデータセットがあると仮定します。目的は、点の位置に基づいてそれらを2つのクラス(例えば、赤と青の点)に分類することです。
以下の例は、ニューラルネットワークを使用して簡単な二値分類タスクを完了する方法を示しています。より複雑なタスクの基礎を築きます。PyTorchのモジュール式インターフェースにより、ニューラルネットワークの構築、トレーニング、可視化は非常に直感的です。
1、データ準備
まず、簡単な2次元データを生成します:
例
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
# ランダムデータを生成
n_samples = 100
data = torch.randn(n_samples, 2) # 100個の2次元データポイントを生成
labels = (data[:, 0]**2 + data[:, 1]**2 < 1).float().unsqueeze(1) # 点が円の内側なら1、外側なら0
# データを可視化
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm')
plt.title("Generated Data")
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")
plt.show()
データの説明:
dataは入力の2次元点で、各点には2つの特徴があります。labelsはターゲット分類で、点が円形領域内なら1、そうでなければ0です。
表示は次のようになります:
2、ニューラルネットワークの定義
PyTorchを使用して、簡単なフィードフォワードニューラルネットワークを作成します。
フィードフォワードニューラルネットワークは1つの隠れ層を使用し、単純な線形変換と活性化関数を通じてデータの非線形パターンを捉えます。
例
def __init__(self):
super(SimpleNN, self).__init__()
# ニューラルネットワークの層を定義
self.fc1 = nn.Linear(2, 4) # 入力層には2つの特徴、隠れ層には4つのニューロン
self.fc2 = nn.Linear(4, 1) # 隠れ層から1つのニューロンに出力(二値分類用)
self.sigmoid = nn.Sigmoid() # 二値分類の活性化関数
def forward(self, x):
x = torch.relu(self.fc1(x)) # ReLU活性化関数を使用
x = self.sigmoid(self.fc2(x)) # 出力層ではSigmoid活性化関数を使用
return x
# モデルをインスタンス化
model = SimpleNN()
3、損失関数とオプティマイザの定義
例
criterion = nn.BCELoss() # バイナリ交差エントロピー損失
optimizer = optim.SGD(model.parameters(), lr=0.1) # 確率的勾配降下法オプティマイザを使用
4、モデルのトレーニング
データを使ってモデルをトレーニングし、分類を学習させます。
例
epochs = 100
for epoch in range(epochs):
# 順伝播
outputs = model(data)
loss = criterion(outputs, labels)
# 逆伝播
optimizer.zero_grad()
loss.backward()
optimizer.step()
# 10エポックごとに損失を出力
if (epoch + 1) % 10 == 0:
print(f'Epoch [{epoch + 1}/{epochs}], Loss: {loss.item():.4f}')
5、モデルのテストと結果の可視化
モデルをテストし、画像上に決定境界を描画します。
例
def plot_decision_boundary(model, data):
x_min, x_max = data[:, 0].min() - 1, data[:, 0].max() + 1
y_min, y_max = data[:, 1].min() - 1, data[:, 1].max() + 1
xx, yy = torch.meshgrid(torch.arange(x_min, x_max, 0.1), torch.arange(y_min, y_max, 0.1), indexing='ij')
grid = torch.cat([xx.reshape(-1, 1), yy.reshape(-1, 1)], dim=1)
predictions = model(grid).detach().numpy().reshape(xx.shape)
plt.contourf(xx, yy, predictions, levels=[0, 0.5, 1], cmap='coolwarm', alpha=0.7)
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm', edgecolors='k')
plt.title("Decision Boundary")
plt.show()
plot_decision_boundary(model, data)
6、完全なコード
完全なコードは次のとおりです:
例
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
# ランダムデータを生成
n_samples = 100
data = torch.randn(n_samples, 2) # 100個の2次元データポイントを生成
labels = (data[:, 0]**2 + data[:, 1]**2 < 1).float().unsqueeze(1) # 点が円の内側なら1、外側なら0
# データを可視化
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm')
plt.title("Generated Data")
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")
plt.show()
# フィードフォワードニューラルネットワークを定義
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
# ニューラルネットワークの層を定義
self.fc1 = nn.Linear(2, 4) # 入力層には2つの特徴、隠れ層には4つのニューロン
self.fc2 = nn.Linear(4, 1) # 隠れ層から1つのニューロンに出力(二値分類用)
self.sigmoid = nn.Sigmoid() # 二値分類の活性化関数
def forward(self, x):
x = torch.relu(self.fc1(x)) # ReLU活性化関数を使用
x = self.sigmoid(self.fc2(x)) # 出力層ではSigmoid活性化関数を使用
return x
# モデルをインスタンス化
model = SimpleNN()
# 損失関数とオプティマイザを定義
criterion = nn.BCELoss() # バイナリ交差エントロピー損失
optimizer = optim.SGD(model.parameters(), lr=0.1) # 確率的勾配降下法オプティマイザを使用
# トレーニング
epochs = 100
for epoch in range(epochs):
# 順伝播
outputs = model(data)
loss = criterion(outputs, labels)
# 逆伝播
optimizer.zero_grad()
loss.backward()
optimizer.step()
# 10エポックごとに損失を出力
if (epoch + 1) % 10 == 0:
print(f'Epoch [{epoch + 1}/{epochs}], Loss: {loss.item():.4f}')
# 決定境界の可視化
def plot_decision_boundary(model, data):
x_min, x_max = data[:, 0].min() - 1, data[:, 0].max() + 1
y_min, y_max = data[:, 1].min() - 1, data[:, 1].max() + 1
xx, yy = torch.meshgrid(torch.arange(x_min, x_max, 0.1), torch.arange(y_min, y_max, 0.1), indexing='ij')
grid = torch.cat([xx.reshape(-1, 1), yy.reshape(-1, 1)], dim=1)
predictions = model(grid).detach().numpy().reshape(xx.shape)
plt.contourf(xx, yy, predictions, levels=[0, 0.5, 1], cmap='coolwarm', alpha=0.7)
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm', edgecolors='k')
plt.title("Decision Boundary")
plt.show()
plot_decision_boundary(model, data)
トレーニング時の損失出力:
Epoch [10/100], Loss: 0.5247
Epoch [20/100], Loss: 0.3142
...
Epoch [100/100], Loss: 0.0957
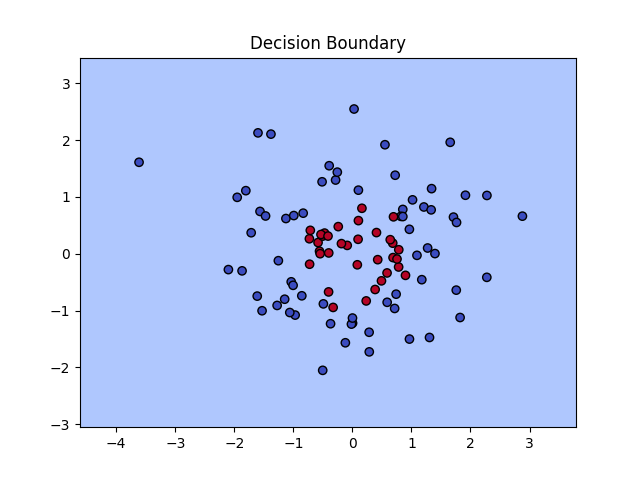
図には元のデータポイント(赤と青)と、モデルが学習した分類境界が表示されています。