PyTorch Dataset
Bei Deep-Learning-Aufgaben sind das Laden und Verarbeiten von Daten ein entscheidender Teil.
PyTorch bietet leistungsstarke Werkzeuge zum Laden und Verarbeiten von Daten, zu denen hauptsächlich Folgende gehören:
torch.utils.data.Dataset: Eine abstrakte Klasse für Datasets, die angepasst und implementiert werden muss__len__(Datensatzgröße) und__getitem__(Samples per Index abrufen).torch.utils.data.TensorDataset: Ein tensor-basiertes Dataset, geeignet für die Verarbeitung von Daten-Label-Paaren, unterstützt direkt Batching und Iteration.torch.utils.data.DataLoader: Ein Iterator, der Dataset umschließt und Batching, Daten-Shuffling, Multithread-Laden usw. bereitstellt, um die Dateneingabe für das Modelltraining zu erleichtern.torchvision.datasets.ImageFolder: Lädt Bilddaten aus Ordnern, jeder Unterordner repräsentiert eine Klasse, geeignet für Bildklassifizierungsaufgaben.
In PyTorch integrierte Datasets
PyTorch stellt über das Modul torchvision.datasets viele häufig verwendete Datasets bereit, zum Beispiel:
- MNIST: Datensatz mit handschriftlichen Ziffernbildern, verwendet für Bildklassifizierungsaufgaben.
- CIFAR: Ein Datensatz mit 60,000 32x32-Farbbildern in 10 Klassen, verwendet für Bildklassifizierungsaufgaben.
- COCO: Ein groß angelegter Datensatz für allgemeine Objekterkennung, Segmentierung und Keypoint-Erkennung, mit über 330k Bildern und 2.5M Objektinstanzen.
- ImageNet: Enthält über 14 Millionen Bilder, verwendet für Aufgaben wie Bildklassifizierung und Objekterkennung.
- STL-10: Ein Datensatz mit 100k 96x96-Farbbildern, verwendet für Bildklassifizierungsaufgaben.
- Cityscapes: Enthält 5,000 fein annotierte Bilder von Stadtstraßenszenen, verwendet für semantische Segmentierungsaufgaben.
- SQUAD: Ein Datensatz, der für Aufgaben des maschinellen Leseverständnisses verwendet wird.
Die oben genannten Datensätze können über Funktionen im Modul torchvision.datasets geladen werden, und andere Datensätze können auch über benutzerdefinierte Methoden geladen werden.
torchvision und torchtext
- torchvision: Eine Grafikbibliothek, die APIs und Datensatzschnittstellen für die Verarbeitung von Bilddaten bereitstellt, einschließlich Funktionen zum Laden von Datensätzen und gängigen Bildtransformationen.
- torchtext: Ein Toolkit für die Verarbeitung natürlicher Sprache, das Werkzeuge für die Verarbeitung und Modellierung von Textdaten bereitstellt, einschließlich Datenvorverarbeitung und Datenlademethoden.
torch.utils.data.Dataset
Dataset ist eine Klasse in PyTorch zur Abstraktion von Datensätzen.
Um einen benutzerdefinierten Datensatz zu erstellen, müssen Sie von torch.utils.data.Dataset erben und die folgenden beiden Methoden überschreiben:
__len__: Gibt die Größe des Datensatzes zurück.__getitem__: Ruft ein Datenbeispiel und dessen Label anhand des Index ab.
Beispiel
from torch.utils.data import Dataset
# Benutzerdefinierter Datensatz
class MyDataset(Dataset):
def __init__(self, data, labels):
# Dateninitialisierung
self.data = data
self.labels = labels
def __len__(self):
# Datensatzgröße zurückgeben
return len(self.data)
def __getitem__(self, idx):
# Daten und Label per Index zurückgeben
sample = self.data[idx]
label = self.labels[idx]
return sample, label
# Beispieldaten generieren
data = torch.randn(100, 5) # 100 Stichproben, jede mit 5 Merkmalen
labels = torch.randint(0, 2, (100,)) # 100 Labels, Werte sind 0 oder 1
# Datensatz instanziieren
dataset = MyDataset(data, labels)
# Testdatensatz
print("Datensatzgröße:", len(dataset))
print("Beispiel 0:", dataset[0])
Das Ausgabeergebnis ist wie folgt:
数据集大小: 100
第 0 个样本: (tensor([-0.2006,  0.7304, -1.3911, -0.4408,  1.1447]), tensor(0))
torch.utils.data.DataLoader
DataLoader ist ein von PyTorch bereitgestellter Datenlader, der zum Laden von Datensätzen in Batches verwendet wird.
Es bietet die folgenden Funktionen:
- Batch-Laden: Durch Setzen von
batch_size。 - Datenmischen: Durch Setzen von
shuffle=True。 - Multithread-Beschleunigung: Durch Setzen von
num_workers。 - Iterativer Zugriff: Bequemer Zugriff auf Daten Batch für Batch.
Beispiel
from torch.utils.data import Dataset
from torch.utils.data import DataLoader
# Benutzerdefinierter Datensatz
class MyDataset(Dataset):
def __init__(self, data, labels):
# Dateninitialisierung
self.data = data
self.labels = labels
def __len__(self):
# Datensatzgröße zurückgeben
return len(self.data)
def __getitem__(self, idx):
# Daten und Label per Index zurückgeben
sample = self.data[idx]
label = self.labels[idx]
return sample, label
# Beispieldaten generieren
data = torch.randn(100, 5) # 100 Stichproben, jede mit 5 Merkmalen
labels = torch.randint(0, 2, (100,)) # 100 Labels, Werte sind 0 oder 1
# Datensatz instanziieren
dataset = MyDataset(data, labels)
# DataLoader instanziieren
dataloader = DataLoader(dataset, batch_size=10, shuffle=True, num_workers=0)
# Über DataLoader iterieren
for batch_idx, (batch_data, batch_labels) in enumerate(dataloader):
print(f"Batch {batch_idx + 1}")
print("Daten:", batch_data)
print("Labels:", batch_labels)
if batch_idx == 2: # Nur die ersten 3 Batches anzeigen
break
Das Ausgabeergebnis ist wie folgt:
批次 1
数据: tensor([[ 0.4689,  0.6666, -1.0234,  0.8948,  0.4503],
        [ 0.0273, -0.4684, -0.7762,  0.7963,  0.2168],
        [ 1.0677, -0.3502, -0.9594, -1.1318, -0.2196],
        [-1.4989,  0.0267,  1.0405, -0.7284,  0.2335],
        [-0.5887, -0.4934,  1.6283,  1.4638,  0.0157],
        [-1.1047, -0.6550, -0.0381,  0.3617, -1.2792],
        [ 0.3592, -0.8264,  0.0231, -1.5508,  0.6833],
        [-0.6835,  0.6979,  0.9048, -0.4756,  0.3003],
        [ 1.1562, -0.4516, -1.2415,  0.2859,  0.5837],
        [ 0.7937,  1.5316, -0.6139,  0.7999,  0.5506]])
标签: tensor([0, 1, 1, 1, 1, 0, 1, 1, 0, 0])
批次 2
数据: tensor([[-0.0388, -0.3658,  0.8993, -1.5027,  1.0738],
        [-0.6182,  1.0684, -2.3049,  0.8338,  0.1363],
        [-0.5289,  0.1661, -0.0349,  0.2112,  1.4745],
        [-0.3304, -1.2114, -0.2982, -0.3006,  0.5252],
        [-1.4394, -0.3732,  1.0281,  0.5754,  1.0081],
        [ 0.8714, -0.1945, -0.2451, -0.2879, -2.0520],
        [ 0.0235,  0.4360,  0.1233,  0.0504,  0.5908],
        [ 0.5927,  0.1785, -0.9052, -0.9012,  0.8914],
        [ 0.4693,  0.5533, -0.1903,  0.0267,  0.4077],
        [-1.1683,  1.6699, -0.4846, -0.7404,  0.3370]])
标签: tensor([1, 1, 0, 1, 0, 1, 1, 0, 1, 1])
批次 3
数据: tensor([[ 0.2103, -0.7839,  1.4899,  2.2749, -0.7548],
        [-1.2836,  1.0025, -1.1162, -0.4261,  1.0690],
        [-0.7969,  1.0418, -0.7405,  0.8766,  0.2347],
        [-1.1071,  1.8560, -1.2979, -0.8364, -0.2925],
        [-1.0488,  0.4802, -0.6453,  0.2009,  0.5693],
        [ 0.8883,  0.4619, -0.2087,  0.2189, -0.3708],
        [-1.4578,  0.3629,  1.8282,  0.5353, -1.1783],
        [-1.2813,  0.5129, -0.4598, -0.2131, -1.2804],
        [ 1.7831,  1.1730, -0.2305, -0.6550,  0.1197],
        [-0.9384, -0.0483,  1.9626,  0.3342,  0.1700]])
标签: tensor([0, 0, 0, 1, 0, 1, 1, 1, 0, 1])
Integrierte Datensätze verwenden
PyTorch bietet in torchvision mehrere häufig verwendete Datensätze, die besonders für Bildaufgaben geeignet sind.
MNIST-Datensatz laden:
Beispiel
import torchvision.transforms as transforms
from torch.utils.data import DataLoader
# Datenvorverarbeitung definieren
transform = transforms.Compose([
transforms.ToTensor(), # In Tensor umwandeln
transforms.Normalize((0.5,), (0.5,)) # Standardisieren
])
# Trainingsdatensatz laden
train_dataset = torchvision.datasets.MNIST(
root='./data', train=True, transform=transform, download=True)
# DataLoader zum Laden von Daten verwenden
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
# Einen Batch von Daten anzeigen
data_iter = iter(train_loader)
images, labels = next(data_iter)
print(f"Batch-Bildgröße: {images.shape}") # Ausgabeform ist [batch_size, 1, 28, 28]
print(f"Batch-Beschriftungen: {labels}")
Das Ausgabeergebnis ist:
批次图像大小: torch.Size([32, 1, 28, 28])
批次标签: tensor([0, 4, 9, 8, 1, 3, 8, 1, 7, 2, 1, 1, 1, 2, 6, 3, 9, 7, 6, 9, 4, 9, 7, 1,
        3, 7, 3, 0, 7, 7, 6, 7])
Benutzerdefinierte Anwendung von Dataset und DataLoader
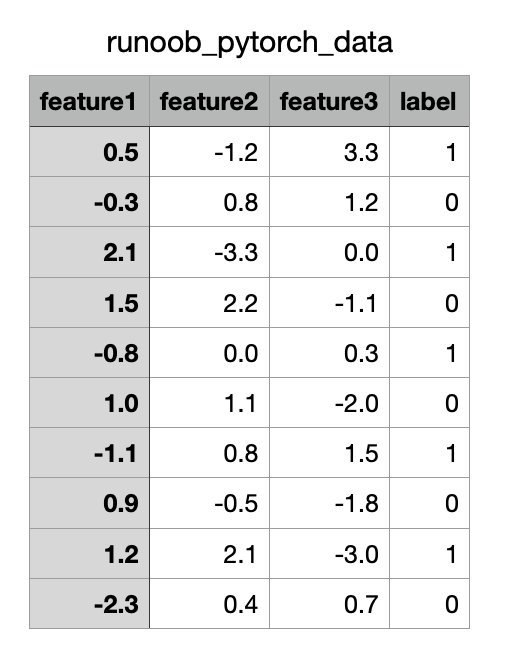
Das Folgende ist ein Beispiel für die Verwendung einer CSV-Datei als Datenquelle und das Lesen von Daten über ein benutzerdefiniertes Dataset und DataLoader.
Der CSV-Dateiinhalt ist wie folgt (herunterladenexample_pytorch_data.csv):
Beispiel
import pandas as pd
from torch.utils.data import Dataset, DataLoader
# Benutzerdefinierter CSV-Datensatz
class CSVDataset(Dataset):
def __init__(self, file_path):
# CSV-Datei einlesen
self.data = pd.read_csv(file_path)
def __len__(self):
# Datensatzgröße zurückgeben
return len(self.data)
def __getitem__(self, idx):
# Verwende .iloc, um explizit positionsbasierte Indizierung zu verwenden
row = self.data.iloc[idx]
# Merkmale und Labels trennen
features = torch.tensor(row.iloc[:-1].to_numpy(), dtype=torch.float32) # Merkmale
label = torch.tensor(row.iloc[-1], dtype=torch.float32) # Labels
return features, label
# Datensatz und DataLoader instanziieren
dataset = CSVDataset("example_pytorch_data.csv")
dataloader = DataLoader(dataset, batch_size=4, shuffle=True)
# Über DataLoader iterieren
for features, label in dataloader:
print("Merkmale:", features)
print("Labels:", label)
break
Das Ausgabeergebnis ist:
特征: tensor([[ 1.2000,  2.1000, -3.0000],
        [ 1.0000,  1.1000, -2.0000],
        [ 0.5000, -1.2000,  3.3000],
        [-0.3000,  0.8000,  1.2000]])
标签: tensor([1., 0., 1., 0.])
tianqixin@Mac-mini example-test % python3 test.py
特征: tensor([[ 1.5000,  2.2000, -1.1000],
        [ 2.1000, -3.3000,  0.0000],
        [-2.3000,  0.4000,  0.7000],
        [-0.3000,  0.8000,  1.2000]])
标签: tensor([0., 1., 0., 0.])
Andere Erweiterungen