Transformer-Modell
Transformer ist ein Deep-Learning-Modell, das auf dem Attention-Mechanismus basiert und erstmals von Vaswani et al. in ihrem Paper von 2017 "Attention is All You Need" vorgeschlagen wurde.
Es hat den Bereich der Verarbeitung natürlicher Sprache (NLP) revolutioniert und sich nach und nach auf fast alle KI-Bereiche wie Computer Vision ausgeweitet.
Die Kernidee des Transformers besteht darin, die traditionelle wortweise Verarbeitungsmethode (RNN) vollständig aufzugeben und stattdessen den Aufmerksamkeitsmechanismus zu nutzen, damit das Modell den gesamten Satz auf einmal liest und dabei die Beziehung zwischen jedem Wort und anderen Wörtern bestimmt, wodurch ein schnelleres Training und eine stärkere Verständnisfähigkeit erreicht werden.
Warum brauchen wir Transformer?
Vor dem Aufkommen des Transformers stützte sich der NLP-Bereich hauptsächlich auf Modelle der RNN-Reihe (Recurrent Neural Network) (wie LSTM, GRU), die Text sequenziell verarbeiten und zwei entscheidende Schwächen haben.
Grenzen von RNN
RNN verarbeitet Text wie ein Mensch, der „Wort für Wort liest“, was folgende Probleme mit sich bringt:
- Verschwindender Gradient:Bei der Verarbeitung von langem Text „vergisst“ das Modell frühere Informationen. Zum Beispiel hat es in „Ich habe mir gestern ein Buch über Quantenphysik aus der Bibliothek ausgeliehen“ bis es „Buch“ erreicht, längst vergessen, dass „Ich“ das Subjekt ist, was es extrem schwierig macht, Abhängigkeiten über große Entfernungen zu erfassen.
- Keine Parallelität:RNN muss jedes Wort sequenziell verarbeiten und kann die parallele Rechenleistung von GPUs nicht nutzen, wodurch das Training auf extrem langem Text sehr langsam wird.
Die Lösung des Transformers
Durch den Selbstaufmerksamkeitsmechanismus verarbeitet das Modell alle Wörter gleichzeitig und berechnet dynamisch die Stärke der Verbindung zwischen jedem Wortpaar, wodurch die beiden oben genannten Probleme vollständig gelöst werden.
Vergleichsdiagramm RNN vs. TransformerVergleich der sequenziellen RNN-Verarbeitung vs. paralleler Transformer-Verarbeitung + globaler Aufmerksamkeit
Transformer-Gesamtarchitektur
Der Transformer besteht aus zwei Hauptteilen: einem Encoder und einem Decoder, die jeweils aus mehreren Schichten identischer Module gestapelt sind.
Analogie: Der Encoder ist wie ein „Leser“, der einen chinesischen Eingabesatz als eine Menge semantisch reichhaltiger Vektoren versteht; der Decoder ist wie ein „Übersetzer“, der diese Vektoren heranzieht und die englische Ausgabe Wort für Wort erzeugt.
Nachfolgend ist das Transformer-Architekturdiagramm dargestellt, wobei sich der Encoder links und der Decoder rechts befindet.
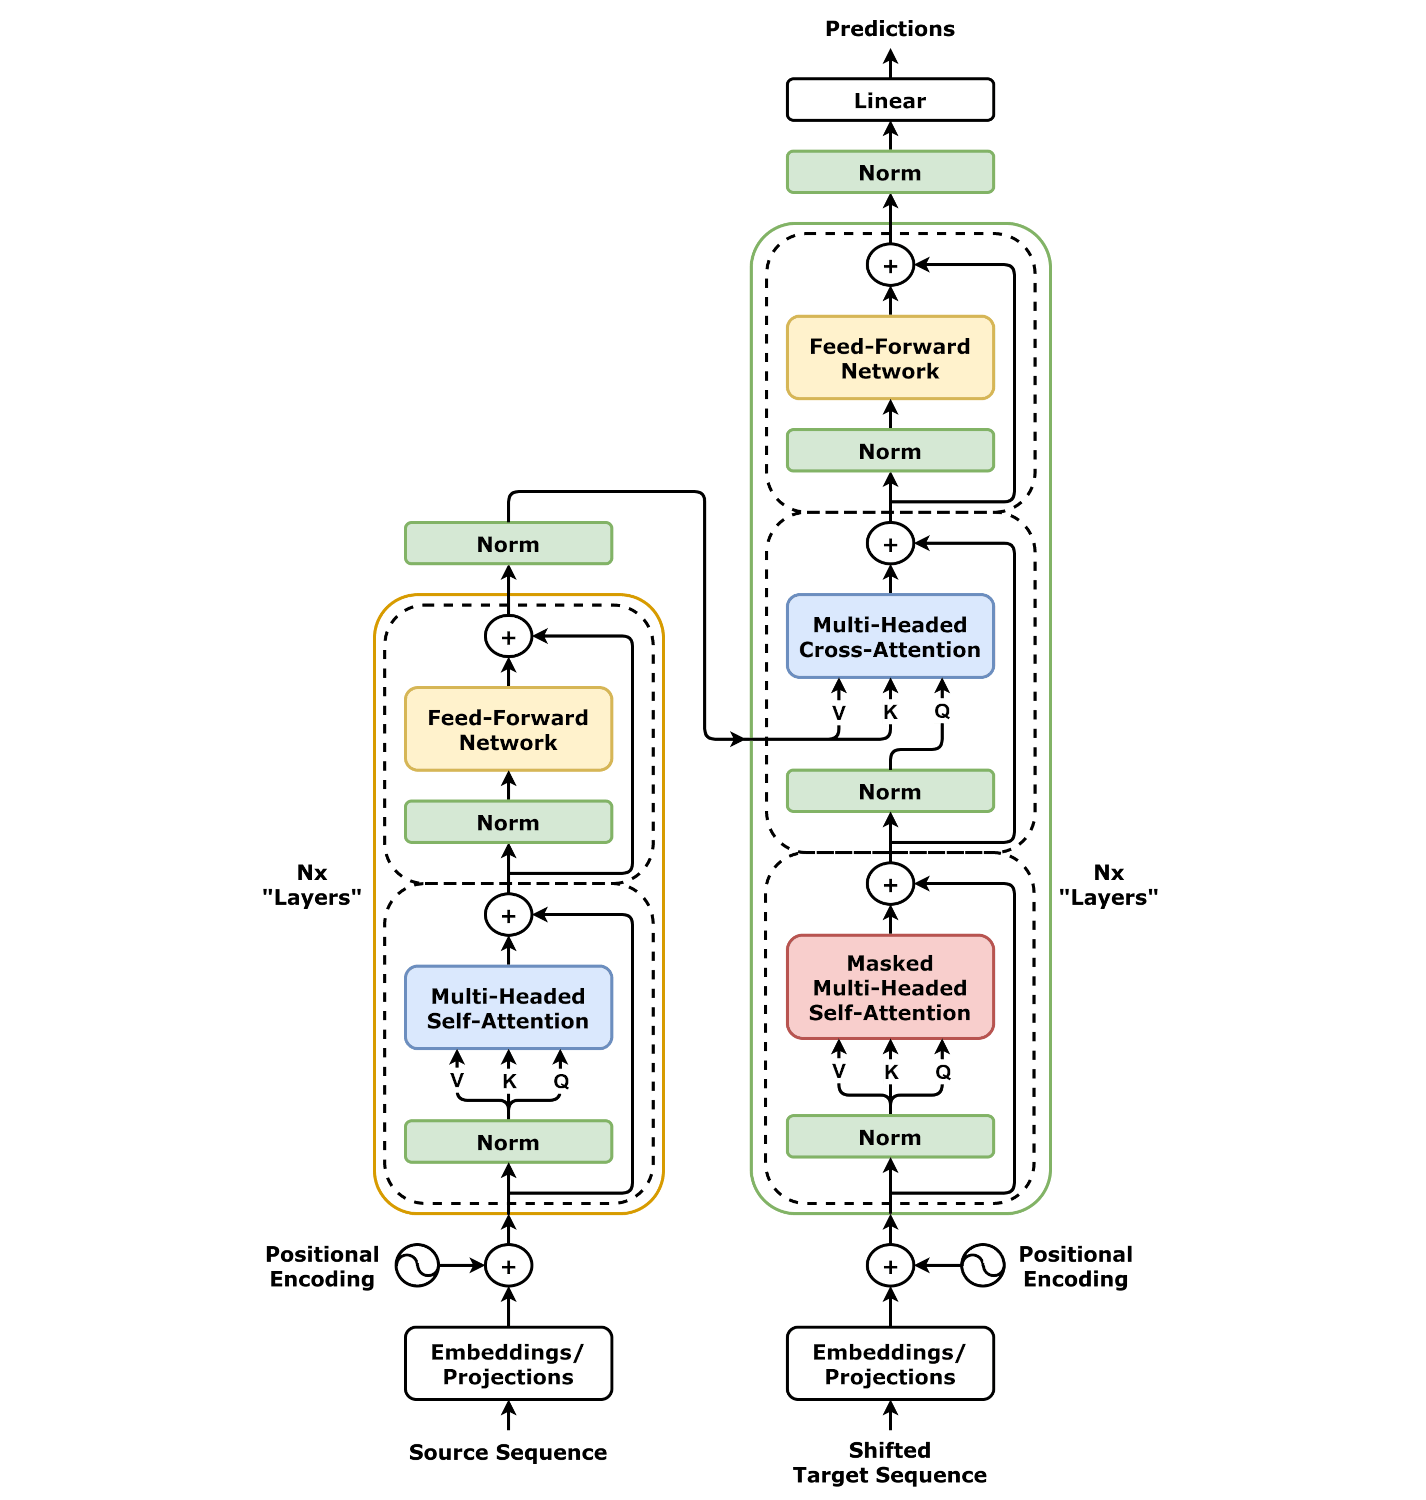
Vollständige Architektur von Transformer-Encoder + Decoder (orange Pfeile zeigen den Informationsfluss der Cross-Attention an)
Das Transformer-Modell besteht aus zwei Teilen, einem Encoder und einem Decoder, die jeweils aus mehreren gestapelten identischen Modulen bestehen.
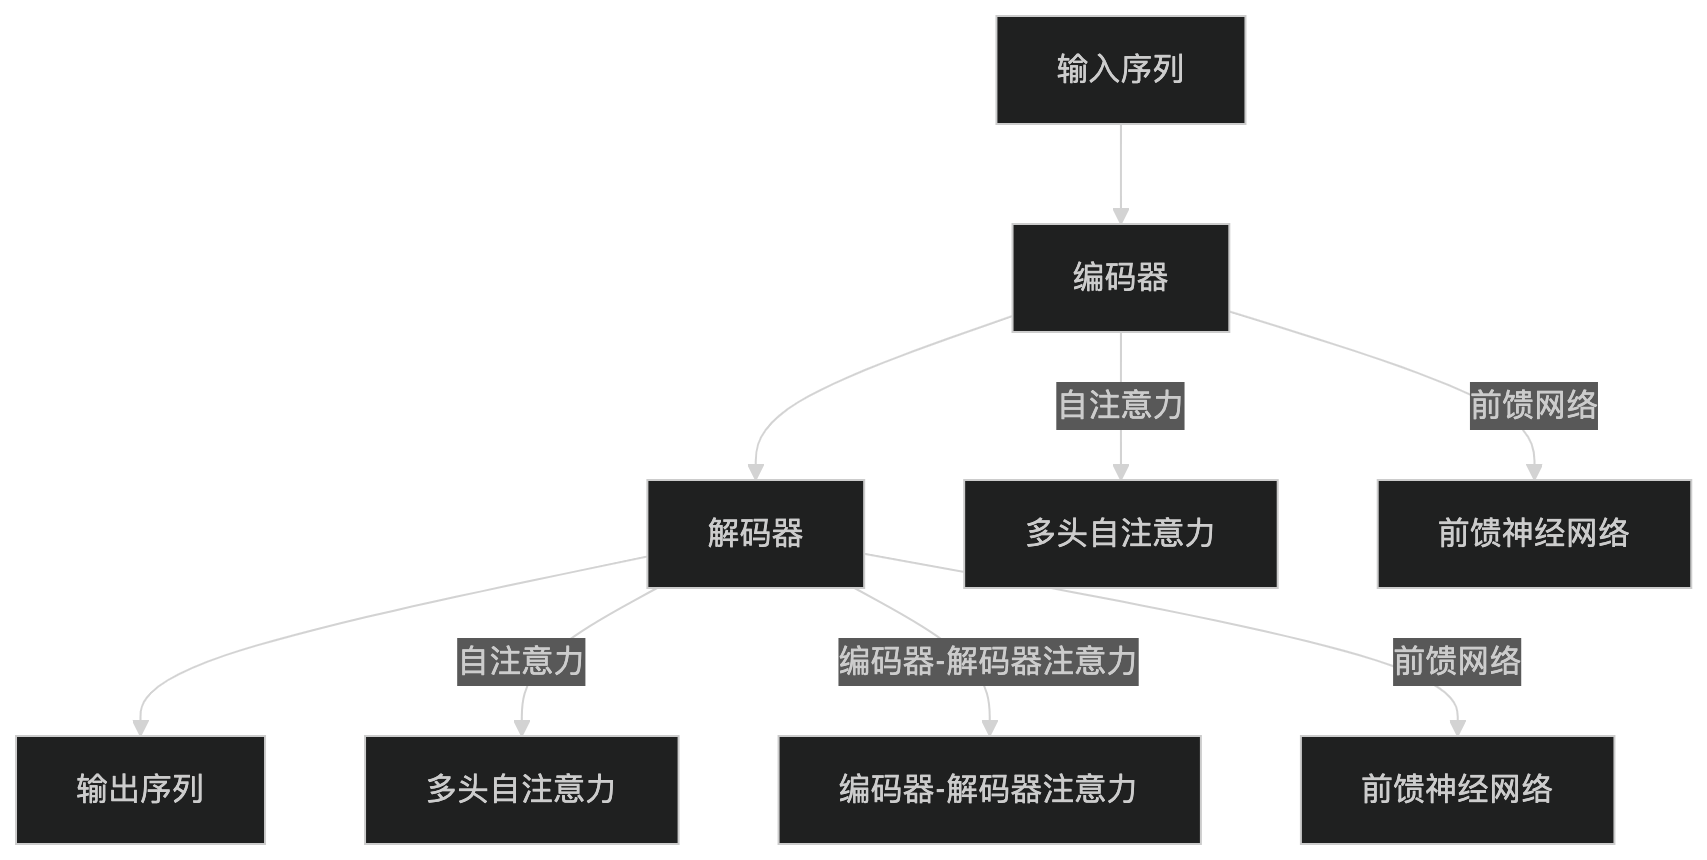
Encoder
Der Encoder ist aus N identischen Modulen gestapelt, und jede Schicht enthält zwei Unterschichten:
- Multi-Head-Self-Attention-Mechanismus:Berechnet die Relevanz jedes Wortes zu anderen Wörtern in der Eingabesequenz.
- Feed-Forward-Neuronales Netz:Führt für jedes Wort eine unabhängige nichtlineare Transformation durch.
Auf jede Unterschicht folgt eine Residual-Verbindung und eine Layer-Normalisierung.
Decoder
Der Decoder ist ebenfalls aus N identischen Modulen gestapelt, und jede Schicht enthält drei Unterschichten:
- Maskierter Multi-Head-Self-Attention-Mechanismus:Berechnet die Relevanz jedes Wortes zu vorangehenden Wörtern in der Ausgabesequenz (unter Verwendung von Masken, um das Durchsickern zukünftiger Informationen zu verhindern).
- Encoder-Decoder-Attention-Mechanismus:Berechnet die Relevanz zwischen der Ausgabesequenz und der Eingabesequenz.
- Feed-Forward-Neuronales Netz:Führt für jedes Wort eine unabhängige nichtlineare Transformation durch.
Ebenso folgen auf jede Teilschicht eine Residualverbindung und eine Layer-Normalisierung.
Vor dem Aufkommen des Transformer-Modells waren die vorherrschenden Modelle im NLP RNN-basierte Architekturen wie Long Short-Term Memory-Netzwerke (LSTM) und Gated Recurrent Units (GRU). Diese Modelle erfassen Abhängigkeiten in Sequenzen, indem sie Eingabedaten sequenziell verarbeiten, weisen jedoch die folgenden Probleme auf:
Vanishing-Gradient-Problem: Abhängigkeiten über große Entfernungen sind schwer zu erfassen.
Einschränkung der sequenziellen Berechnung: Sie kann die parallele Rechenleistung moderner Hardware nicht vollständig nutzen, was zu einer geringen Trainingseffizienz führt.
Transformer löst diese Probleme durch die Einführung des Self-Attention-Mechanismus, wodurch das Modell die gesamte Eingabesequenz gleichzeitig verarbeiten und jeder Position in der Sequenz dynamisch unterschiedliche Gewichte zuweisen kann.
Kern: Self-Attention-Mechanismus
Der Self-Attention-Mechanismus ist die wichtigste Komponente des Transformers. Er beantwortet die Frage: "Wenn ich dieses Wort verarbeite, auf welche anderen Wörter im Satz sollte ich mich konzentrieren?"
Was sind Q, K, V?
Der Vektor jedes Wortes wird linear in drei Rollen transformiert: Query, Key und Value.
Q-K-V-DiagrammDer Ursprung von Q, K, V und der Attention-Berechnungsprozess
Verwende eine Suchmaschinen-Analogie, um Q/K/V zu verstehen:
Q (Query) = das Schlüsselwort, das Sie in das Suchfeld eingeben, und steht für "Was möchte ich nachschlagen?"
K (Key) = der Titel-Tag jeder Webseite, der für "Welche Wörter kann ich abgleichen?" steht
V (Value) = der tatsächliche Inhalt jeder Webseite, der für "Welche Informationen kann ich bereitstellen?" steht
Attention-Gewichte = die Ähnlichkeit zwischen Q und jedem K; das Endergebnis = eine gewichtete Summe aller V unter Verwendung der Gewichte.
Attention-Formel
\[ \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V \]
wobei:
- \(Q\)ist die Query-Matrix,\(K\)ist die Key-Matrix,\(V\)ist die Value-Matrix.
- \(d_k\)ist die Dimension der Vektoren, die verwendet wird, um das Skalarprodukt zu skalieren und eine Gradientenexplosion zu verhindern.
- softmax wandelt die Rohwerte in eine Wahrscheinlichkeitsverteilung zwischen 0 und 1 um (wobei die Gewichte sich zu 1 summieren)
Multi-Head Attention
Eine einzelne Attention-Perspektive ist begrenzt, so als würde man ein Problem nur aus einem einzigen Blickwinkel betrachten.
Multi-Head-Attention teilt die Eingabe in h Teilräume auf; jeder "Head" lernt unabhängig ein anderes Attention-Muster, und die Ergebnisse werden am Ende konkateniert.

Positionale Codierung
Transformer verarbeitet alle Wörter gleichzeitig und hat von Natur aus kein "Gefühl für Reihenfolge" — "Katze frisst Fisch" und "Fisch frisst Katze" würden gleich behandelt.
Positionskodierung ist wie das Hinzufügen einer "Sitzplatznummer" zu jedem Wort, die dem Modell die Position jedes Wortes im Satz mitteilt.
Da der Transformer keine expliziten Sequenzinformationen hat (wie Zeitschritte in RNN), wird die Positionskodierung verwendet, um jedem Wort in der Eingabesequenz Positionsinformationen hinzuzufügen. Typischerweise werden Sinus- und Kosinusfunktionen verwendet, um Positionskodierungen zu erzeugen:Analogie: So wie man auf einem Prüfungsbogen "Frage 1, Frage 2" markiert, lässt die Positionskodierung den Transformer wissen, dass "Ich" das 1. Wort ist, "liebe" das 2. Wort.
\[ PE_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right) \] \[ PE_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right) \]
wobei:
\(pos\) ist die Position des Wortes und \(i\) ist der Dimensionsindex.
Visualisierung der PositionskodierungDie Positionskodierung wird zu Wort-Embeddings hinzugefügt, um dem Modell Positionsinformationen zuzuführen.
Encoder-Decoder-Architektur
Das Transformer-Modell besteht aus zwei Teilen: einem Encoder und einem Decoder:
- Encoder:Wandelt die Eingabesequenz in eine Reihe versteckter Repräsentationen um. Jede Encoder-Schicht enthält einen Self-Attention-Mechanismus und ein Feed-Forward-Neuronales Netz.
- Decoder:Erzeugt die Zielsequenz basierend auf der Ausgabe des Encoders. Jede Decoder-Schicht enthält zwei Attention-Mechanismen (Self-Attention und Encoder-Decoder-Attention) und ein Feed-Forward-Neuronales Netz.
Residualverbindung und Layer-Normalisierung
Nach den Ausgaben jeder Teilschicht (Self-Attention, Feed-Forward-Netzwerk) werden zwei Operationen durchgeführt: Residual-Verbindung und Layer-Normalisierung, die helfen, das Training in tiefen Netzwerken zu stabilisieren.
Diagramm der Residual-VerbindungResidual-Verbindungen ermöglichen es Gradienten, "kurzzuschließen", und die Layer-Normalisierung stabilisiert das Training.
- Residual-Verbindung:Addiert die Eingabe der Teilschicht direkt zu ihrer Ausgabe (output = F(x) + x), vermeidet verschwindende Gradienten in tiefen Netzwerken und ermöglicht dem Modell, die Transformation einer Schicht "selektiv zu ignorieren".
- Layer-Normalisierung:Normalisiert die Aktivierungen jeder Schicht, wodurch das Training stabiler und die Konvergenz schneller wird.
Vorteile von Transformer
Im Vergleich zu traditionellen RNN-Architekturen hat der Transformer die folgenden bemerkenswerten Vorteile:
Parallele Berechnung
Verarbeitet die gesamte Sequenz auf einmal, nutzt die GPU-Parallelität voll aus, wobei die Trainingsgeschwindigkeit die von RNN weit übersteigt.
Langreichweitige Abhängigkeiten
Der Self-Attention-Mechanismus hält den "Kommunikationsabstand" zwischen zwei beliebigen Wörtern bei 1, nicht mehr durch die Sequenzlänge eingeschränkt.
Starke Skalierbarkeit
Das Stapeln weiterer Schichten und das Vergrößern der Dimensionen können die Leistung verbessern, wodurch leistungsstarke Modelle wie BERT und GPT entstehen.
Anwendungen von Transformer
Die Transformer-Architektur wird in verschiedenen KI-Bereichen umfassend eingesetzt; im Folgenden werden sie nach Domäne vorgestellt.
Verarbeitung natürlicher Sprache (NLP)
Computer Vision (CV)
Multimodale Aufgaben
Anwendungen von Transformer
Verarbeitung natürlicher Sprache (NLP):
Maschinelle Übersetzung (z. B. Google Translate)
Textgenerierung (z. B. Modelle der GPT-Serie)
Textklassifikation, Frage-Antwort-Systeme usw.
Computer Vision (CV):
Bildklassifikation (z. B. Vision Transformer)
Objekterkennung, Bildgenerierung usw.
Multimodale Aufgaben:
Aufgaben, die Text und Bilder kombinieren (z. B. CLIP, DALL-E).
PyTorch-Implementierungsbeispiel
Das Folgende ist ein vollständiges PyTorch-Transformer-Beispiel mit detaillierten Kommentaren, um Anfängern zu helfen, jeden Schritt zu verstehen:
Beispiel
import torch.nn as nn
import torch.optim as optim
# --- Transformer-Modell definieren ---
class TransformerModel(nn.Module):
def __init__(self, input_dim, model_dim, num_heads, num_layers, output_dim):
super(TransformerModel, self).__init__()
# Wort-Einbettung: bildet Wortindizes auf model_dim-dimensionale Vektoren ab
self.embedding = nn.Embedding(input_dim, model_dim)
# Positionskodierung: lernbare Positionsvektoren, maximale unterstützte Länge 1000
self.positional_encoding = nn.Parameter(
torch.zeros(1, 1000, model_dim)
)
# PyTorch-eingebauter Transformer (enthält Encoder + Decoder)
self.transformer = nn.Transformer(
d_model=model_dim, # Vektordimension
nhead=num_heads, # Anzahl der Köpfe für Multi-Head-Attention
num_encoder_layers=num_layers, # Anzahl der Encoder-Schichten
num_decoder_layers=num_layers # Anzahl der Decoder-Schichten
)
# Letzte lineare Schicht: bildet Vektoren zurück auf Vokabulargröße ab (zur Vorhersage des nächsten Wortes)
self.fc = nn.Linear(model_dim, output_dim)
def forward(self, src, tgt):
src_seq_length = src.size(1)
tgt_seq_length = tgt.size(1)
# Wort-Embedding + Positionskodierung (beide addieren)
src = self.embedding(src) + self.positional_encoding[:, :src_seq_length, :]
tgt = self.embedding(tgt) + self.positional_encoding[:, :tgt_seq_length, :]
# Durch den Transformer leiten (Encoder liest src, Decoder generiert tgt)
transformer_output = self.transformer(src, tgt)
# Lineare Schicht gibt Vokabularwahrscheinlichkeiten für jede Position aus
output = self.fc(transformer_output)
return output
# --- Hyperparametereinstellungen ---
input_dim = 10000 # Vokabulargröße (wie viele verschiedene Wörter es gibt)
model_dim = 512 # Vektordimension für jedes Wort (das Originalpapier verwendet 512)
num_heads = 8 # Anzahl der Multi-Head-Attention-Köpfe (muss model_dim teilen)
num_layers = 6 # Anzahl der Encoder/Decoder-Schichten (die Originalarbeit verwendet 6)
output_dim = 10000 # Ausgabedimension (entspricht der Vokabulargröße)
# --- Modell, Verlustfunktion und Optimierer initialisieren ---
model = TransformerModel(input_dim, model_dim, num_heads, num_layers, output_dim)
criterion = nn.CrossEntropyLoss() # Multi-Klassen-Cross-Entropy-Verlust
optimizer = optim.Adam(model.parameters(), lr=0.001) # Adam-Optimierer
# --- Beispieldaten erstellen (in der tatsächlichen Verwendung durch echten Korpus ersetzen) ---
# src: Quellsequenz (z. B. Chinesisch), Form = (sequence_length=10, batch_size=32)
src = torch.randint(0, input_dim, (10, 32))
# tgt: Zielsequenz (z. B. Englisch), Form = (sequence_length=20, batch_size=32)
tgt = torch.randint(0, input_dim, (20, 32))
# --- Vorwärtsdurchlauf ---
output = model(src, tgt)
# output.shape = (20, 32, 10000): vorhergesagte Verteilung über das Vokabular an jeder Position
# --- Verlust berechnen ---
# view(-1, output_dim) flacht (20,32,10000) zu (640, 10000) ab
loss = criterion(output.view(-1, output_dim), tgt.view(-1))
# --- Backpropagation + Gewichte aktualisieren ---
optimizer.zero_grad() # Gradienten aus dem vorherigen Schritt zurücksetzen
loss.backward() # Gradienten berechnen
optimizer.step() # Parameter aktualisieren
print(f"Verlustwert: {loss.item():.4f}")
Der obige Code verwendet nur zufällige Daten, um den Workflow zu demonstrieren. Für das eigentliche Training müssen Sie:
- 1) Bereiten Sie echte parallele Korpora vor (z. B. chinesisch-englische Übersetzungspaare);
- 2) Führen Sie Tokenisierung und Vokabularerstellung durch;
- 3) Implementieren Sie die schrittweise Inferenz des Decoders (autoregressive Generierung);
- 4) Passen Sie die Strategie zur Lernratenplanung an (die Originalarbeit verwendet Warmup).
Zusammenfassung
Die Entwicklung von RNN zu Transformer stellt einen wichtigen Paradigmenwechsel im Deep Learning dar.
Entwicklungspfad-DiagrammEvolutionärer Pfad von RNN zu Transformer
Die drei großen Innovationen des Transformers haben die Deep-Learning-Landschaft vollständig verändert:
- Selbstaufmerksamkeitsmechanismus– ermöglicht es zwei beliebigen Wörtern, direkt miteinander zu „reden“, und sagt verschwindenden Gradienten Lebewohl.
- Vollständige Parallelisierung– ein qualitativer Sprung bei der Trainingsgeschwindigkeit, der großskaliges Pretraining möglich macht.
- Universelle Architektur– von NLP über CV bis hin zu Multimodalem ist der Transformer zum „universellen Baustein“ des KI-Zeitalters geworden.
Beherrsche Transformer, und du hältst den Schlüssel zum Verständnis moderner KI-Modelle wie GPT, BERT und Stable Diffusion.
Kurzübersicht zur Terminologie
| Begriff | Englisch | Beschreibung |
|---|---|---|
| Selbstaufmerksamkeit | Self-Attention | Ein Mechanismus, der Korrelationen zwischen Elementen innerhalb einer Sequenz berechnet |
| Mehrkopf-Aufmerksamkeit | Multi-Head Attention | Mehrere Aufmerksamkeitsköpfe berechnen parallel, um Informationen aus verschiedenen Merkmalsunterräumen zu erfassen |
| Positionskodierung | Positionale Codierung | Eine Technik, die dem Modell Positionsinformationen der Elemente in einer Sequenz bereitstellt |
| Residualverbindung | Residualverbindung | Fügt die Eingabe direkt zur Ausgabe der Teilschicht hinzu, um verschwindende Gradienten zu mildern |
| Layer-Normalisierung | Layer-Normalisierung | Normalisiert die Aktivierungswerte jeder Schicht, um die Konvergenz des Trainings zu beschleunigen |
| Encoder | Encoder | Kodiert die Eingabesequenz in kontextuelle Repräsentationen |
| Decoder | Decoder | Erzeugt die Zielsequenz basierend auf der Ausgabe des Encoders |
| Cross-Attention | Cross-Attention | Ein Attention-Mechanismus, bei dem der Decoder auf die Ausgabe des Encoders achtet |
| Maskierte Attention | Maskierte Attention | Ein Mechanismus im Decoder, der verhindert, dass zukünftige Positionsinformationen berücksichtigt werden |
| Feedforward-Netzwerk | Feed-Forward-Netzwerk | Vollständig verbundene Schicht, die unabhängig auf jede Position angewendet wird |