Premier réseau de neurones avec PyTorch
Dans ce chapitre, nous allons présenter comment utiliser PyTorch pour implémenter un simple réseau de neurones feedforward afin de réaliser une tâche de classification binaire.
L'exemple suivant montre comment utiliser PyTorch pour implémenter un réseau de neurones simple pour l'entraînement à la classification binaire.
La structure du réseau comprend une couche d'entrée, une couche cachée et une couche de sortie, en utilisant la fonction d'activation ReLU et la fonction d'activation Sigmoid.
Il utilise la fonction de perte d'erreur quadratique moyenne et l'optimiseur de descente de gradient stochastique.
Le processus d'entraînement ajuste progressivement les paramètres du modèle via la propagation avant, le calcul de la perte, la rétropropagation et la mise à jour des paramètres.
Exemple
import torch
import torch.nn as nn
# Définir la taille de la couche d'entrée, la taille de la couche cachée, la taille de la couche de sortie et la taille du lot
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
# Créer des données d'entrée et des données cibles factices
x = torch.randn(batch_size, n_in) # Générer aléatoirement des données d'entrée
y = torch.tensor([[1.0], [0.0], [0.0],
[1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]]) # Données de sortie cibles
# Créer un modèle séquentiel avec des couches linéaires, une fonction d'activation ReLU et une fonction d'activation Sigmoid
model = nn.Sequential(
nn.Linear(n_in, n_h), # Transformation linéaire de la couche d'entrée vers la couche cachée
nn.ReLU(), # Fonction d'activation ReLU pour la couche cachée
nn.Linear(n_h, n_out), # Transformation linéaire de la couche cachée vers la couche de sortie
nn.Sigmoid() # Fonction d'activation Sigmoid pour la couche de sortie
)
# Définir la fonction de perte d'erreur quadratique moyenne et l'optimiseur de descente de gradient stochastique
criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # Le taux d'apprentissage est de 0.01
# Exécuter l'algorithme de descente de gradient pour l'entraînement du modèle
for epoch in range(50): # Itérer 50 fois
y_pred = model(x) # Propagation avant, calculer les valeurs prédites
loss = criterion(y_pred, y) # Calculer la perte
print('epoch: ', epoch, 'loss: ', loss.item()) # Afficher la valeur de la perte
optimizer.zero_grad() # Effacer les gradients
loss.backward() # Rétropropagation, calculer les gradients
optimizer.step() # Mettre à jour les paramètres du modèle
Le résultat de sortie est similaire à ce qui suit :
epoch:  0 loss:  0.2591968774795532
epoch:  1 loss:  0.25902628898620605
epoch:  2 loss:  0.25885599851608276
epoch:  3 loss:  0.25868603587150574
epoch:  4 loss:  0.25851646065711975
...
Définir les paramètres du réseau :
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
n_in: La taille de la couche d'entrée est de 10, ce qui signifie que chaque point de données a 10 caractéristiques.n_h: La taille de la couche cachée est de 5, ce qui signifie que la couche cachée contient 5 neurones.n_out: La taille de la couche de sortie est de 1, c'est-à-dire qu'elle produit un scalaire représentant le résultat de la classification binaire (0 ou 1).batch_size: Chaque batch contient 10 échantillons.
Générer les données d'entrée et les données cibles :
x = torch.randn(batch_size, n_in)  # 随机生成输入数据
y = torch.tensor([[1.0], [0.0], [0.0],
                 [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])  # 目标输出数据
x: Générer aléatoirement une forme de(10, 10)matrice de données d'entrée, représentant 10 échantillons, chaque échantillon possède 10 caractéristiques.y: Les données de sortie cibles (étiquettes), représentant l'étiquette de classe (0 ou 1) pour chaque échantillon d'entrée, constituent un tenseur 10×1.
Définir le modèle de réseau de neurones :
model = nn.Sequential(
   nn.Linear(n_in, n_h),  # 输入层到隐藏层的线性变换
   nn.ReLU(),            # 隐藏层的ReLU激活函数
   nn.Linear(n_h, n_out),  # 隐藏层到输出层的线性变换
   nn.Sigmoid()           # 输出层的Sigmoid激活函数
)
nn.SequentialUtilisé pour définir les couches du réseau en séquence.
nn.Linear(n_in, n_h): Définit la transformation linéaire de la couche d'entrée vers la couche cachée, avec 10 caractéristiques d'entrée et 5 neurones dans la couche cachée.nn.ReLU(): Ajoute la fonction d'activation ReLU après la couche cachée pour augmenter la non-linéarité.nn.Linear(n_h, n_out): Définit la transformation linéaire de la couche cachée vers la couche de sortie, avec 1 neurone de sortie.nn.Sigmoid(): La couche de sortie utilise la fonction d'activation sigmoïde pour mapper le résultat entre 0 et 1 pour la classification binaire.
Définir la fonction de perte et l'optimiseur :
criterion = torch.nn.MSELoss()  # 使用均方误差损失函数
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)  # 使用随机梯度下降优化器,学习率为 0.01
Boucle d'entraînement :
for epoch in range(50):  # 训练50轮
   y_pred = model(x)  # 前向传播,计算预测值
   loss = criterion(y_pred, y)  # 计算损失
   print('epoch: ', epoch, 'loss: ', loss.item())  # 打印损失值

   optimizer.zero_grad()  # 清零梯度
   loss.backward()  # 反向传播,计算梯度
   optimizer.step()  # 更新模型参数
for epoch in range(50): Effectuer 50 itérations d'entraînement.y_pred = model(x): Effectuer la propagation avant, en utilisant les paramètres actuels du modèle pour calculer les données d'entréex.loss = criterion(y_pred, y): Calculer les valeurs prédites et les valeurs ciblesyla perte entre.optimizer.zero_grad(): Effacer les valeurs de gradient de la précédente itération d'entraînement.loss.backward(): Rétropropagation, calculer le gradient de la fonction de perte par rapport aux paramètres du modèle.optimizer.step(): Mettre à jour les paramètres du modèle en fonction des gradients calculés.
Code de visualisation :
Exemple
import torch.nn as nn
import matplotlib.pyplot as plt
# Définir la taille de la couche d'entrée, la taille de la couche cachée, la taille de la couche de sortie et la taille du lot
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
# Créer des données d'entrée et des données cibles factices
x = torch.randn(batch_size, n_in) # Générer aléatoirement des données d'entrée
y = torch.tensor([[1.0], [0.0], [0.0],
[1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]]) # Données de sortie cibles
# Créer un modèle séquentiel avec des couches linéaires, une fonction d'activation ReLU et une fonction d'activation Sigmoid
model = nn.Sequential(
nn.Linear(n_in, n_h), # Transformation linéaire de la couche d'entrée vers la couche cachée
nn.ReLU(), # Fonction d'activation ReLU pour la couche cachée
nn.Linear(n_h, n_out), # Transformation linéaire de la couche cachée vers la couche de sortie
nn.Sigmoid() # Fonction d'activation Sigmoid pour la couche de sortie
)
# Définir la fonction de perte d'erreur quadratique moyenne et l'optimiseur de descente de gradient stochastique
criterion = torch.nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01) # Le taux d'apprentissage est de 0.01
# Utilisé pour stocker la valeur de la perte pour chaque époque
losses = []
# Exécuter l'algorithme de descente de gradient pour l'entraînement du modèle
for epoch in range(50): # Itérer 50 fois
y_pred = model(x) # Propagation avant, calculer les valeurs prédites
loss = criterion(y_pred, y) # Calculer la perte
losses.append(loss.item()) # Enregistrer la valeur de la perte
print(f'Époque [{epoch+1}/50], Perte : {loss.item():.4f}') # Afficher la valeur de la perte
optimizer.zero_grad() # Effacer les gradients
loss.backward() # Rétropropagation, calculer les gradients
optimizer.step() # Mettre à jour les paramètres du modèle
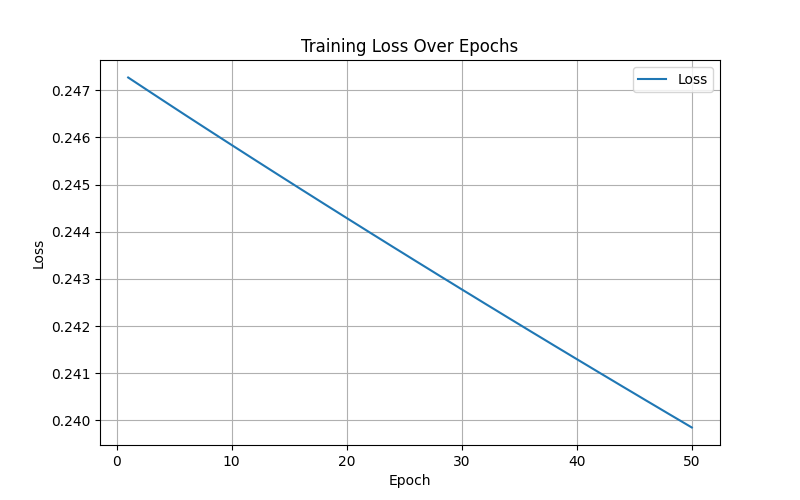
# Visualiser la courbe de perte
plt.figure(figsize=(8, 5))
plt.plot(range(1, 51), losses, label='Perte')
plt.xlabel('Époque')
plt.ylabel('Perte')
plt.title('Perte d’entraînement au fil des époques')
plt.legend()
plt.grid()
plt.show()
# Visualiser la comparaison des résultats prédits avec les valeurs cibles réelles
y_pred_final = model(x).detach().numpy() # Valeurs prédites finales
y_actual = y.numpy() # Valeurs réelles
plt.figure(figsize=(8, 5))
plt.plot(range(1, batch_size + 1), y_actual, 'o-', label='Réel', color='blue')
plt.plot(range(1, batch_size + 1), y_pred_final, 'x--', label='Prédit', color='red')
plt.xlabel('Index des échantillons')
plt.ylabel('Valeur')
plt.title('Valeurs réelles vs prédites')
plt.legend()
plt.grid()
plt.show()
Affiché comme suit :
Un autre exemple
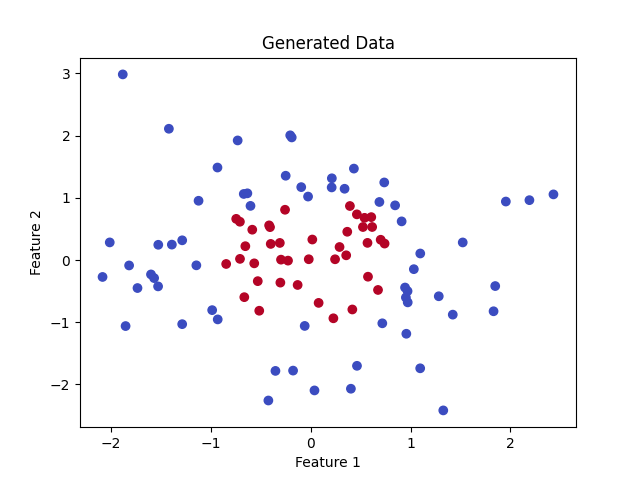
Nous supposons qu'il existe un ensemble de données bidimensionnel, et l'objectif est de classer les points en deux catégories en fonction de leurs positions (par exemple, des points rouges et bleus).
L'exemple suivant montre comment utiliser un réseau de neurones pour accomplir une tâche simple de classification binaire, posant ainsi les bases de tâches plus complexes. Avec l'interface modulaire de PyTorch, la construction, l'entraînement et la visualisation de réseaux de neurones sont très intuitifs.
1. Préparation des données
Tout d'abord, nous générons quelques données bidimensionnelles simples :
Exemple
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
# Générer des données aléatoires
n_samples = 100
data = torch.randn(n_samples, 2) # Générer 100 points de données bidimensionnels
labels = (data[:, 0]**2 + data[:, 1]**2 < 1).float().unsqueeze(1) # Un point à l'intérieur du cercle vaut 1, à l'extérieur du cercle vaut 0
# Visualiser les données
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm')
plt.title("Données générées")
plt.xlabel("Caractéristique 1")
plt.ylabel("Caractéristique 2")
plt.show()
Description des données :
dataL'entrée est un point bidimensionnel, chaque point possède deux caractéristiques.labelsIl s'agit de la classification cible : 1 si le point est à l'intérieur de la région circulaire, sinon 0.
Affiché comme suit :
2. Définir le réseau de neurones
Utilisez PyTorch pour créer un réseau de neurones feedforward simple.
Le réseau de neurones feedforward utilise une couche cachée, capturant les motifs non linéaires dans les données grâce à de simples transformations linéaires et fonctions d'activation.
Exemple
def __init__(self):
super(SimpleNN, self).__init__()
# Définir les couches du réseau de neurones
self.fc1 = nn.Linear(2, 4) # La couche d'entrée a 2 caractéristiques, la couche cachée a 4 neurones
self.fc2 = nn.Linear(4, 1) # La couche cachée produit une sortie vers 1 neurone (pour la classification binaire)
self.sigmoid = nn.Sigmoid() # Fonction d'activation pour la classification binaire
def forward(self, x):
x = torch.relu(self.fc1(x)) # Utiliser la fonction d'activation ReLU
x = self.sigmoid(self.fc2(x)) # La couche de sortie utilise la fonction d'activation Sigmoid
return x
# Instancier le modèle
model = SimpleNN()
3. Définir la fonction de perte et l'optimiseur
Exemple
criterion = nn.BCELoss() # Perte d'entropie croisée binaire
optimizer = optim.SGD(model.parameters(), lr=0.1) # Utiliser l'optimiseur de descente de gradient stochastique
4. Entraîner le modèle
Entraîner le modèle avec des données afin qu'il apprenne à classifier.
Exemple
époques = 100
for epoch in range(epochs):
# Propagation avant
outputs = model(data)
loss = criterion(outputs, labels)
# Rétropropagation
optimizer.zero_grad()
loss.backward()
optimizer.step()
# Afficher la perte toutes les 10 époques
if (epoch + 1) % 10 == 0:
print(f'Époque [{epoch + 1}/{epochs}], Perte: {loss.item():.4f}')
5. Tester le modèle et visualiser les résultats
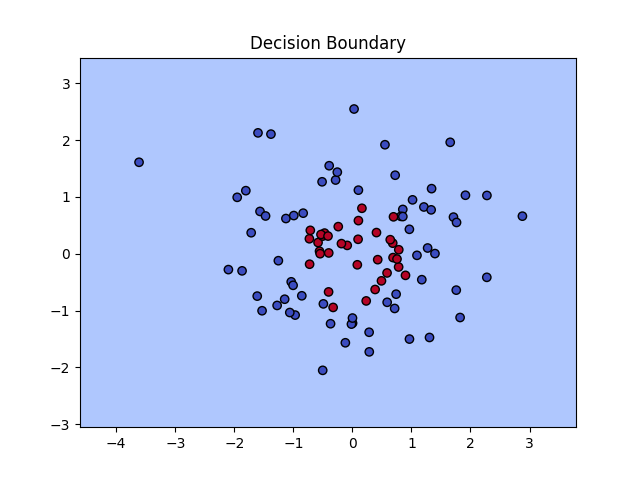
Nous testons le modèle et traçons la frontière de décision sur l'image.
Exemple
def plot_decision_boundary(model, data):
x_min, x_max = data[:, 0].min() - 1, data[:, 0].max() + 1
y_min, y_max = data[:, 1].min() - 1, data[:, 1].max() + 1
xx, yy = torch.meshgrid(torch.arange(x_min, x_max, 0.1), torch.arange(y_min, y_max, 0.1), indexing='ij')
grid = torch.cat([xx.reshape(-1, 1), yy.reshape(-1, 1)], dim=1)
predictions = model(grid).detach().numpy().reshape(xx.shape)
plt.contourf(xx, yy, predictions, levels=[0, 0.5, 1], cmap='coolwarm', alpha=0.7)
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm', edgecolors='k')
plt.title("Frontière de décision")
plt.show()
plot_decision_boundary(model, data)
6. Code complet
Le code complet est le suivant :
Exemple
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
# Générer des données aléatoires
n_samples = 100
data = torch.randn(n_samples, 2) # Générer 100 points de données bidimensionnels
labels = (data[:, 0]**2 + data[:, 1]**2 < 1).float().unsqueeze(1) # Un point à l'intérieur du cercle vaut 1, à l'extérieur du cercle vaut 0
# Visualiser les données
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm')
plt.title("Données générées")
plt.xlabel("Caractéristique 1")
plt.ylabel("Caractéristique 2")
plt.show()
# Définir le réseau de neurones à propagation avant
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
# Définir les couches du réseau de neurones
self.fc1 = nn.Linear(2, 4) # La couche d'entrée a 2 caractéristiques, la couche cachée a 4 neurones
self.fc2 = nn.Linear(4, 1) # La couche cachée produit une sortie vers 1 neurone (pour la classification binaire)
self.sigmoid = nn.Sigmoid() # Fonction d'activation pour la classification binaire
def forward(self, x):
x = torch.relu(self.fc1(x)) # Utiliser la fonction d'activation ReLU
x = self.sigmoid(self.fc2(x)) # La couche de sortie utilise la fonction d'activation Sigmoid
return x
# Instancier le modèle
model = SimpleNN()
# Définir la fonction de perte et l'optimiseur
criterion = nn.BCELoss() # Perte d'entropie croisée binaire
optimizer = optim.SGD(model.parameters(), lr=0.1) # Utiliser l'optimiseur de descente de gradient stochastique
# Entraîner
époques = 100
for epoch in range(epochs):
# Propagation avant
outputs = model(data)
loss = criterion(outputs, labels)
# Rétropropagation
optimizer.zero_grad()
loss.backward()
optimizer.step()
# Afficher la perte toutes les 10 époques
if (epoch + 1) % 10 == 0:
print(f'Époque [{epoch + 1}/{epochs}], Perte: {loss.item():.4f}')
# Visualiser la frontière de décision
def plot_decision_boundary(model, data):
x_min, x_max = data[:, 0].min() - 1, data[:, 0].max() + 1
y_min, y_max = data[:, 1].min() - 1, data[:, 1].max() + 1
xx, yy = torch.meshgrid(torch.arange(x_min, x_max, 0.1), torch.arange(y_min, y_max, 0.1), indexing='ij')
grid = torch.cat([xx.reshape(-1, 1), yy.reshape(-1, 1)], dim=1)
predictions = model(grid).detach().numpy().reshape(xx.shape)
plt.contourf(xx, yy, predictions, levels=[0, 0.5, 1], cmap='coolwarm', alpha=0.7)
plt.scatter(data[:, 0], data[:, 1], c=labels.squeeze(), cmap='coolwarm', edgecolors='k')
plt.title("Frontière de décision")
plt.show()
plot_decision_boundary(model, data)
Sortie de la perte pendant l'entraînement :
Epoch [10/100], Loss: 0.5247
Epoch [20/100], Loss: 0.3142
...
Epoch [100/100], Loss: 0.0957
La figure montre les points de données d'origine (rouges et bleus), ainsi que la frontière de classification apprise par le modèle.