PyTorch-Grundlagen
PyTorch ist ein Open-Source-Deep-Learning-Framework, das für seine Flexibilität und seinen dynamischen Berechnungsgraphen weithin beliebt ist.
PyTorch hat hauptsächlich die folgenden grundlegenden Konzepte: Tensor, Autograd, neuronales Netzwerkmodul (nn.Module), Optimierer (optim) usw.
- Tensor: PyTorchs zentrale Datenstruktur, unterstützt mehrdimensionale Arrays und kann beschleunigte Berechnungen auf CPU oder GPU ausführen.
- Autograd: PyTorch bietet eine automatische Differenzierungsfunktion, die die Berechnung von Modellgradienten für Backpropagation und Optimierung erleichtert.
- Neuronales Netz (nn.Module): PyTorch bietet eine einfache und leistungsstarke API zum Erstellen neuronaler Netzwerkmodelle, was die Durchführung von Vorwärtspropagation und Modelldefinition erleichtert.
- Optimierer: Verwenden Sie Optimierer (wie Adam, SGD usw.), um Modellparameter zu aktualisieren, um den Verlust zu minimieren.
- Gerät: Sie können Modelle und Tensoren auf die GPU verschieben, um die Berechnung zu beschleunigen.
Überblick über die PyTorch-Architektur
PyTorch verwendet ein modulares Design, das aus mehreren Kernkomponenten besteht, die zusammenwirken. Das Verständnis der Rollen und Beziehungen dieser Komponenten ist der Schlüssel zur Beherrschung von PyTorch.
Diagramm der PyTorch-Architektur
┌─────────────────────────────────────────────────────────────┐
│                    PyTorch 生态系统                          │
├─────────────────────────────────────────────────────────────┤
│  torchvision  │  torchtext  │  torchaudio  │  其他专业库     │
├─────────────────────────────────────────────────────────────┤
│                     PyTorch 核心                            │
├───────────────┬─────────────────┬───────────────────────────┤
│   torch.nn    │   torch.optim   │      torch.utils          │
│   (神经网络)   │   (优化器)      │      (工具函数)           │
├───────────────┼─────────────────┼───────────────────────────┤
│               │                 │   torch.utils.data        │
│  torch 核心   │  autograd       │   (数据加载)              │
│  (张量计算)   │  (自动微分)     │                           │
└───────────────┴─────────────────┴───────────────────────────┘
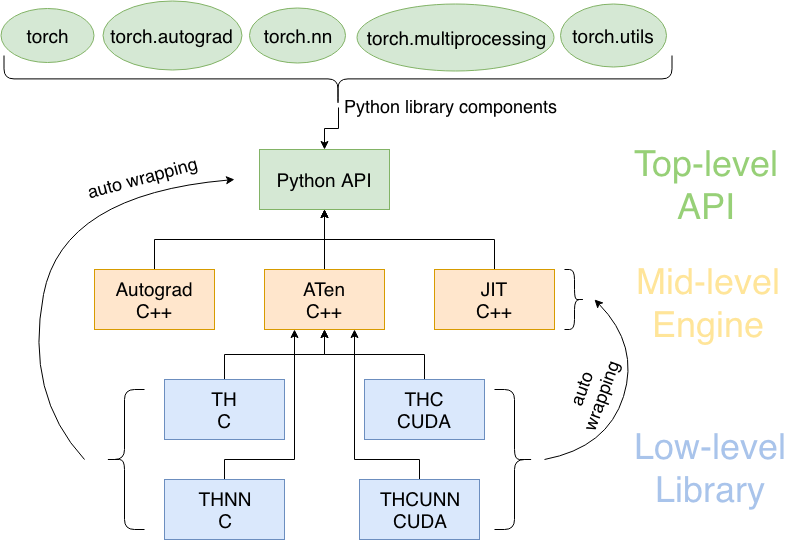
PyTorch verwendet ein Design mitgeschichteter Architektur, von oben nach unten wie folgt:
1. Python-API (oberste Ebene)
torch: Zentrale Tensorberechnung (ähnlich wie NumPy, unterstützt GPU).torch.nn: Neuronale Netzwerkschichten, Verlustfunktionen usw.torch.autograd: Automatische Differenzierung (Backpropagation).- Von Entwicklern direkt aufgerufene Schnittstellen, einfach und benutzerfreundlich.
2. C++-Kern (mittlere Ebene)
- ATen: Kernbibliothek für Tensoroperationen (400+ Operationen).
- JIT: Just-in-Time-Kompilierung zur Optimierung von Modellen.
- Autograd-Engine: Low-Level-Implementierung der automatischen Differenzierung.
- Hochleistungsrechnen, verbindet Python und die darunterliegende Hardware.
3. Grundlegende Bibliotheken (unterste Ebene)
- TH/THNN: Grundlegende Tensor- und Neuralnetzoperationen, implementiert in C.
- THC/THCUNN: Entsprechende CUDA-(GPU-)Version.
- Arbeitet direkt auf Hardware (CPU/GPU) und optimiert die Geschwindigkeit bis zum Äußersten.
Ausführungsablauf:
Python-Code → C++-Kernberechnung → Low-Level-Beschleunigung durch CUDA/C-Bibliotheken → Ergebnis zurückgeben.
Es behält die Benutzerfreundlichkeit bei und gewährleistet gleichzeitig hohe Leistung.
Tensor
Der Tensor ist die zentrale Datenstruktur in PyTorch und wird zum Speichern und Bearbeiten mehrdimensionaler Arrays verwendet.
Ein Tensor kann als mehrdimensionales Array betrachtet werden, das beschleunigte Berechnungsoperationen unterstützt.
In PyTorch sind Tensoren konzeptionell ähnlich wie Arrays in NumPy, aber PyTorch-Tensoren können auf verschiedenen Geräten wie CPU und GPU ausgeführt werden, was sie für groß angelegte parallele Berechnungen, insbesondere im Deep Learning, gut geeignet macht.
-
Dimensionalität: Die Dimensionalität eines Tensors bezieht sich auf die mehrdimensionale Array-Struktur der Daten. Zum Beispiel ist ein Skalar (0-dimensionaler Tensor) eine einzelne Zahl, ein Vektor (1-dimensionaler Tensor) ein eindimensionales Array, eine Matrix (2-dimensionaler Tensor) ein zweidimensionales Array und so weiter.
-
Form: Die Form eines Tensors bezieht sich auf die Größe jeder Dimension. Zum Beispiel ein Tensor mit der Form
(3, 4)bedeutet, dass er 3 Zeilen und 4 Spalten hat. -
Dtype: Der Datentyp in einem Tensor definiert die Speichergröße, die benötigt wird, um jedes Element zu speichern, und wie es interpretiert wird. PyTorch unterstützt mehrere Datentypen, darunter Ganzzahltypen (z. B.
torch.int8、torch.int32), Gleitkommatypen (z. B.torch.float32、torch.float64) und boolescher Typ (torch.bool)。
Tensor-Erstellung:
Beispiel
# Erstelle einen 2x3-Tensor mit lauter Nullen
a = torch.zeros(2, 3)
print(a)
# Erstelle einen 2x3-Tensor mit lauter Einsen
b = torch.ones(2, 3)
print(b)
# Erstelle einen 2x3-Tensor mit Zufallszahlen
c = torch.randn(2, 3)
print(c)
# Erstelle einen Tensor aus einem NumPy-Array
import numpy as np
numpy_array = np.array([[1, 2], [3, 4]])
tensor_from_numpy = torch.from_numpy(numpy_array)
print(tensor_from_numpy)
# Erstelle einen Tensor auf einem angegebenen Gerät (CPU/GPU)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
d = torch.randn(2, 3, device=device)
print(d)
Die Ausgabe ähnelt der folgenden:
tensor([[0., 0., 0.],
        [0., 0., 0.]])
tensor([[1., 1., 1.],
        [1., 1., 1.]])
tensor([[ 1.0189, -0.5718, -1.2814],
        [-0.5865,  1.0855,  1.1727]])
tensor([[1, 2],
        [3, 4]])
tensor([[-0.3360,  0.2203,  1.3463],
        [-0.5982, -0.2704,  0.5429]])
Gängige Tensor-Operationen:
Beispiel
e = torch.randn(2, 3)
f = torch.randn(2, 3)
print(e + f)
# elementweise Multiplikation
print(e * f)
# Tensor-Transponierung
g = torch.randn(3, 2)
print(g.t()) # oder g.transpose(0, 1)
# Tensor-Form
print(g.shape) # Form zurückgeben
Tensor und Gerät
PyTorch-Tensoren können auf verschiedenen Geräten existieren, einschließlich CPU und GPU. Sie können Tensoren auf die GPU verschieben, um die Berechnung zu beschleunigen:
if torch.cuda.is_available():
    tensor_gpu = tensor_from_list.to('cuda')  # 将张量移动到GPU
Gradienten und automatische Differenzierung
PyTorch-Tensoren unterstützen automatische Differenzierung, eine Schlüsselfunktion des Deep Learning. Wenn Sie einen Tensor erstellen, der Gradienten erfordert, kann PyTorch seinen Gradienten automatisch berechnen:
Beispiel
tensor_requires_grad = torch.tensor([1.0], requires_grad=True)
# Einige Operationen ausführen
tensor_result = tensor_requires_grad * 2
# Gradient berechnen
tensor_result.backward()
print(tensor_requires_grad.grad) # Ausgabegradient
Speicher und Leistung
PyTorch-Tensoren bieten außerdem einige Funktionen zur Speicherverwaltung, wie die Methoden .clone(), .detach() und .to(), die Ihnen helfen können, die Speichernutzung zu optimieren und die Leistung zu verbessern.
Autograd (Automatische Differenzierung)
Die automatische Differenzierung, abgekürzt Autograd, ist eine Kernfunktion in Deep-Learning-Frameworks, die es Computern ermöglicht, Ableitungen mathematischer Funktionen automatisch zu berechnen.
Im Deep Learning wird die automatische Differenzierung hauptsächlich für zwei Zwecke verwendet:Zum einen zur Berechnung von Gradienten beim Training neuronaler Netze,Zum anderen zur Implementierung des Backpropagation-Algorithmus。
Die automatische Differenzierung basiert auf der Kettenregel, einer mathematischen Regel zur Berechnung von Ableitungen komplexer Funktionen. Die Kettenregel besagt, dass die Ableitung einer zusammengesetzten Funktion das Produkt der Ableitungen ihrer Bestandteile ist. Im Deep Learning sind Modelle typischerweise komplexe Funktionen, die aus vielen Schichten bestehen, und die automatische Differenzierung kann die Gradienten dieser Schichten effizient berechnen.
Dynamischer Graph vs. statischer Graph:
-
Dynamischer Graph: In einem dynamischen Graphen wird der Berechnungsgraph zur Laufzeit dynamisch aufgebaut. Jedes Mal, wenn eine Operation ausgeführt wird, wird der Berechnungsgraph aktualisiert, was das Debuggen und Ändern von Modellen erleichtert. PyTorch verwendet dynamische Graphen.
-
Statischer Graph: In einem statischen Graphen wird der Berechnungsgraph vor Beginn der Ausführung erstellt und ändert sich nicht. TensorFlow verwendete ursprünglich statische Graphen, unterstützte später aber auch dynamische Graphen.
PyTorch bietet eine automatische Differenzierungsfunktion und verwendet das Modul autograd, um Gradienten automatisch zu berechnen.
Das Objekt torch.Tensor hat ein Attribut requires_grad, das angibt, ob der Gradient dieses Tensors berechnet werden muss.
Wenn Sie einen Tensor mit requires_grad=True erstellen, verfolgt PyTorch automatisch alle Operationen darauf, um später Gradienten zu berechnen.
Erstellen eines Tensors, der Gradienten benötigt:
Beispiel
x = torch.randn(2, 2, requires_grad=True)
print(x)
# Einige Operationen ausführen
y = x + 2
z = y * y * 3
out = z.mean()
print(out)
Die Ausgabe ähnelt der folgenden:
tensor([[0., 0., 0.],
        [0., 0., 0.]])
tensor([[1., 1., 1.],
        [1., 1., 1.]])
tensor([[ 1.0189, -0.5718, -1.2814],
        [-0.5865,  1.0855,  1.1727]])
tensor([[1, 2],
        [3, 4]])
tensor([[-0.3360,  0.2203,  1.3463],
        [-0.5982, -0.2704,  0.5429]])
tianqixin@Mac-mini example-test % python3 test.py
tensor([[-0.1908,  0.2811],
        [ 0.8068,  0.8002]], requires_grad=True)
tensor(18.1469, grad_fn=<MeanBackward0>)
Backpropagation
Sobald der Berechnungsgraph definiert ist, können Sie die.backward()Methode verwenden, um Gradienten zu berechnen.
Beispiel
out.backward()
# Den Gradienten von x anzeigen
print(x.grad)
Beim Training neuronaler Netze wird die automatische Differenzierung hauptsächlich verwendet, um den Backpropagation-Algorithmus zu implementieren.
Backpropagation ist eine Methode zum Trainieren neuronaler Netze, indem der Gradient der Verlustfunktion in Bezug auf die Netzwerkparameter berechnet wird. In jeder Iteration berechnet die Vorwärtspropagation des Netzwerks die Ausgabe und den Verlust, dann berechnet die Backpropagation den Gradienten des Verlusts in Bezug auf jeden Parameter und verwendet diese Gradienten, um die Parameter zu aktualisieren.
Stoppen der Gradientenberechnung
Wenn Sie nicht möchten, dass die Gradienten bestimmter Tensoren berechnet werden (z. B. wenn Sie keine Backpropagation benötigen), können Sietorch.no_grad()verwenden oderrequires_grad=False setzen。
Beispiel
with torch.no_grad():
y = x * 2
Neuronales Netz (nn.Module)
Ein neuronales Netz ist ein Berechnungsmodell, das die Verbindungen von Neuronen im menschlichen Gehirn nachahmt. Es besteht aus mehreren Schichten von Knoten (Neuronen) und wird verwendet, um komplexe Muster und Beziehungen in Daten zu lernen.
Neuronale Netze optimieren Vorhersageergebnisse durch Anpassung der Verbindungsgewichte zwischen Neuronen. Dieser Prozess umfasst Vorwärtspropagation, Verlustberechnung, Backpropagation und Parameteraktualisierungen.
Zu den Arten neuronaler Netze gehören Feedforward-Neuronale Netze, Convolutional Neural Networks (CNNs), Recurrent Neural Networks (RNNs) und Long Short-Term Memory Networks (LSTMs). Sie werden in Bereichen wie Bilderkennung, Sprachverarbeitung und Verarbeitung natürlicher Sprache weit verbreitet eingesetzt.
PyTorch bietet eine sehr praktische Schnittstelle zum Erstellen von Modellen neuronaler Netze, nämlichtorch.nn.Module。
Wir können von der nn.Module-Klasse erben und unsere eigenen Netzwerkschichten definieren.
Ein einfaches neuronales Netzwerk erstellen:
Beispiel
import torch.optim as optim
# Ein einfaches vollständig verbundenes neuronales Netzwerk definieren
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
self.fc1 = nn.Linear(2, 2) # Eingabeschicht zur verborgenen Schicht
self.fc2 = nn.Linear(2, 1) # Verborgene Schicht zur Ausgabeschicht
def forward(self, x):
x = torch.relu(self.fc1(x)) # ReLU-Aktivierungsfunktion
x = self.fc2(x)
return x
# Netzwerkinstanz erstellen
model = SimpleNN()
# Modellstruktur ausgeben
print(model)
Ausgabeergebnis:
SimpleNN(
  (fc1): Linear(in_features=2, out_features=2, bias=True)
  (fc2): Linear(in_features=2, out_features=1, bias=True)
)
Trainingsprozess:
-
Vorwärtspropagation: In der Phase der Vorwärtspropagation werden Eingabedaten durch die Netzwerkschichten geleitet, wobei jede Schicht Gewichte und Aktivierungsfunktionen anwendet, bis eine Ausgabe erzeugt wird.
-
Verlust berechnen: Berechnen Sie den Wert der Verlustfunktion basierend auf der Ausgabe des Netzwerks und den wahren Labels.
-
Backpropagation: Backpropagation verwendet Techniken der automatischen Differenzierung, um den Gradienten der Verlustfunktion in Bezug auf jeden Parameter zu berechnen.
-
Parameteraktualisierung: Verwenden Sie einen Optimierer, um die Gewichte und Bias-Werte des Netzwerks basierend auf den Gradienten zu aktualisieren.
-
Iteration: Wiederholen Sie den obigen Prozess, bis die Leistung des Modells auf den Trainingsdaten ein zufriedenstellendes Niveau erreicht.
Vorwärtspropagierung und Verlustberechnung
Beispiel
x = torch.randn(1, 2)
# Vorwärtspropagierung
output = model(x)
print(output)
# Verlustfunktion definieren (z. B. mittlerer quadratischer Fehler MSE)
criterion = nn.MSELoss()
# Angenommen, der Zielwert ist 1
target = torch.randn(1, 1)
# Verlust berechnen
loss = criterion(output, target)
print(loss)
Optimierer
Optimierer aktualisieren die Parameter eines neuronalen Netzwerks während des Trainings, um den Wert der Verlustfunktion zu reduzieren.
PyTorch bietet eine Vielzahl von Optimierern, wie SGD, Adam usw.
Verwendung eines Optimierers für Parameteraktualisierungen:
Beispiel
optimizer = optim.Adam(model.parameters(), lr=0.001)
# Trainingsschritt
optimizer.zero_grad() # Gradienten zurücksetzen
loss.backward() # Backpropagation
optimizer.step() # Parameter aktualisieren
Trainieren des Modells
Das Trainieren eines Modells ist der Kernprozess im maschinellen Lernen und im Deep Learning. Es zielt darauf ab, Modellparameter aus einer großen Datenmenge zu lernen, damit das Modell genaue Vorhersagen für neue, ungesehene Daten treffen kann.
Das Trainieren eines Modells umfasst typischerweise die folgenden Schritte:
-
Datenvorbereitung:
- Daten sammeln und verarbeiten, einschließlich Bereinigung, Standardisierung und Normalisierung.
- Die Daten in Trainings-, Validierungs- und Testsets aufteilen.
-
Das Modell definieren:
- Die Modellarchitektur auswählen, wie Entscheidungsbäume, neuronale Netze usw.
- Modellparameter initialisieren (Gewichte und Bias-Werte).
-
Eine Verlustfunktion auswählen:
- Wähle eine geeignete Verlustfunktion entsprechend dem Aufgabentyp (z. B. Klassifikation, Regression).
-
Einen Optimierer auswählen:
- Wähle einen Optimierungsalgorithmus wie SGD, Adam usw., um Modellparameter zu aktualisieren.
-
Vorwärtspropagation:
- In jeder Iteration die Eingabedaten durch das Modell leiten und die vorhergesagte Ausgabe berechnen.
-
Verlust berechnen:
- Die Verlustfunktion verwenden, um die Differenz zwischen der vorhergesagten Ausgabe und den wahren Labels zu bewerten.
-
Backpropagation:
- Verwenden Sie die automatische Differenzierung, um den Gradienten der Verlustfunktion in Bezug auf die Modellparameter zu berechnen.
-
Parameteraktualisierung:
- Aktualisieren Sie die Modellparameter gemäß den berechneten Gradienten und der Strategie des Optimierers.
-
Iterative Optimierung:
- Wiederholen Sie die Schritte 5-8, bis sich die Leistung des Modells auf dem Validierungssatz nicht mehr verbessert oder eine vorgegebene Anzahl von Iterationen erreicht ist.
-
Evaluierung und Testen:
- Verwenden Sie den Testsatz, um die endgültige Leistung des Modells zu evaluieren und sicherzustellen, dass das Modell nicht überangepasst ist.
-
Modelloptimierung:
- Passen Sie die Hyperparameter basierend auf der Leistung des Modells auf dem Testsatz an, z. B. durch Ändern der Lernrate, Hinzufügen von Regularisierung usw.
-
Das Modell bereitstellen:
- Stellen Sie das trainierte Modell in einer Produktionsumgebung für tatsächliche Vorhersageaufgaben bereit.
Beispiel
import torch.nn as nn
import torch.optim as optim
# 1. Definieren Sie ein einfaches neuronales Netzwerkmodell
class SimpleNN(nn.Module):
def __init__(self):
super(SimpleNN, self).__init__()
self.fc1 = nn.Linear(2, 2) # Eingabeschicht zur verborgenen Schicht
self.fc2 = nn.Linear(2, 1) # Verborgene Schicht zur Ausgabeschicht
def forward(self, x):
x = torch.relu(self.fc1(x)) # ReLU-Aktivierungsfunktion
x = self.fc2(x)
return x
# 2. Modellinstanz erstellen
model = SimpleNN()
# 3. Verlustfunktion und Optimierer definieren
criterion = nn.MSELoss() # Verlustfunktion für mittleren quadratischen Fehler
optimizer = optim.Adam(model.parameters(), lr=0.001) # Adam-Optimierer
# 4. Angenommen, wir haben Trainingsdaten X und Y
X = torch.randn(10, 2) # 10 Stichproben, 2 Merkmale
Y = torch.randn(10, 1) # 10 Zielwerte
# 5. Trainingsschleife
for epoch in range(100): # 100 Epochen trainieren
optimizer.zero_grad() # Vorherige Gradienten zurücksetzen
output = model(X) # Vorwärtspropagierung
loss = criterion(output, Y) # Verlust berechnen
loss.backward() # Backpropagation
optimizer.step() # Parameter aktualisieren
# Verlust alle 10 Epochen ausgeben
if (epoch+1) % 10 == 0:
print(f'Epoch [{epoch+1}/100], Loss: {loss.item():.4f}')
Das Ausgabeergebnis ist wie folgt:
Epoch [10/100], Loss: 1.7180
Epoch [20/100], Loss: 1.6352
Epoch [30/100], Loss: 1.5590
Epoch [40/100], Loss: 1.4896
Epoch [50/100], Loss: 1.4268
Epoch [60/100], Loss: 1.3704
Epoch [70/100], Loss: 1.3198
Epoch [80/100], Loss: 1.2747
Epoch [90/100], Loss: 1.2346
Epoch [100/100], Loss: 1.1991
Alle 10 Epochen gibt das Programm den aktuellen Loss-Wert aus, was uns hilft, den Trainingsfortschritt des Modells zu verfolgen. Im Verlauf des Trainings sollte der Loss-Wert allmählich abnehmen, was anzeigt, dass das Modell kontinuierlich lernt und seine Parameter optimiert.
Das Trainieren eines Modells ist ein iterativer Prozess, der kontinuierliche Anpassung und Optimierung erfordert, bis eine zufriedenstellende Leistung erreicht ist. Dieser Prozess umfasst eine große Anzahl von Experimenten und Tuning, mit dem Ziel, dem Modell eine gute Generalisierungsfähigkeit auf neuen, ungesehenen Daten zu verleihen.
Gerät
PyTorch ermöglicht es Ihnen, Modelle und Daten zur Beschleunigung auf eine GPU zu verschieben.
Verwenden Sietorch.device, um das Rechengerät anzugeben.
Verschieben Sie das Modell und die Daten auf die GPU:
Beispiel
# Verschieben Sie das Modell auf das Gerät
model.to(device)
# Verschieben Sie die Daten auf das Gerät
X = X.to(device)
Y = Y.to(device)
Während des Trainings sollten alle Tensoren und Modelle auf dasselbe Gerät verschoben werden (entweder alle auf der CPU oder alle auf der GPU).
Zusätzliche Erweiterungen