PyTorch-Modell speichern und laden
In Deep-Learning-Projekten ist das Speichern und Laden von Modellen ein entscheidender Schritt. Die Hauptgründe sind:
- Wiederherstellung nach Trainingsunterbrechung: Sie können das Training von einem Checkpoint aus fortsetzen, wenn der Trainingsprozess unerwartet unterbrochen wird
- Modellbereitstellung: Das trainierte Modell in einer Produktionsumgebung bereitstellen
- Modell-Sharing: Praktisch für das Teilen von Modellergebnissen unter Teammitgliedern
- Transferlernen: Vortrainierte Modelle für andere Aufgaben speichern
- Leistungsbewertung: Modelle aus verschiedenen Trainingsphasen zum Vergleich speichern
Grundlegende Methoden zum Speichern und Laden
Speichern des gesamten Modells
Dies ist die einfachste Methode, bei der die Architektur und die Parameter des Modells gespeichert werden:
Beispiel
import torchvision.models as models
# Ein Modell erstellen und trainieren
model = models.resnet18(pretrained=True)
# ... Trainingscode ...
# Das gesamte Modell speichern
torch.save(model, 'model.pth')
# Das gesamte Modell laden
loaded_model = torch.load('model.pth')
Vorteile:
- Einfacher und intuitiver Code
- Speichert die vollständige Modellstruktur
Nachteile:
- Größere Dateigröße
- Hängt von der Definition der Modellklasse ab
Nur Modellparameter speichern (empfohlen)
Eine empfehlenswertere Möglichkeit ist, nur das state_dict des Modells zu speichern:
Beispiel
torch.save(model.state_dict(), 'model_weights.pth')
# Modellparameter laden
model = models.resnet18() # Zuerst muss ein Modell mit derselben Architektur erstellt werden
model.load_state_dict(torch.load('model_weights.pth'))
model.eval() # In den Evaluierungsmodus versetzen
Vorteile:
- Kleinere Dateigröße
- Flexibler, kann in verschiedene Architekturen geladen werden
- Bessere Kompatibilität
Speichern und Laden des Trainingszustands
In echten Projekten müssen wir normalerweise auch den Optimiererzustand, die Epoche und andere Informationen speichern:
Beispiel
checkpoint = {
'epoch': epoch,
'model_state_dict': model.state_dict(),
'optimizer_state_dict': optimizer.state_dict(),
'loss': loss,
# Weitere Informationen können hinzugefügt werden, die gespeichert werden müssen
}
torch.save(checkpoint, 'checkpoint.pth')
# Checkpoint laden
checkpoint = torch.load('checkpoint.pth')
model.load_state_dict(checkpoint['model_state_dict'])
optimizer.load_state_dict(checkpoint['optimizer_state_dict'])
epoch = checkpoint['epoch']
loss = checkpoint['loss']
model.eval() # Oder model.train() je nach Bedarf
Geräteübergreifendes Laden von Modellen
Handhabung der CPU/GPU-Kompatibilität
Beispiel
torch.save(model.state_dict(), 'model_weights.pth')
# Auf CPU laden (wenn das Modell auf GPU trainiert wurde)
device = torch.device('cpu')
model.load_state_dict(torch.load('model_weights.pth', map_location=device))
# Auf GPU laden
device = torch.device('cuda')
model.load_state_dict(torch.load('model_weights.pth', map_location=device))
model.to(device)
Modelle laden, die mit mehreren GPUs trainiert wurden
Beispiel
torch.save(model.module.state_dict(), 'multigpu_model.pth')
# Auf eine einzelne GPU laden
model = ModelClass()
model.load_state_dict(torch.load('multigpu_model.pth'))
Modellkonvertierung und Kompatibilität
PyTorch-Versionskompatibilität
Beispiel
torch.save(model.state_dict(), 'model.pth', _use_new_zipfile_serialization=True)
Konvertierung in TorchScript
Beispiel
scripted_model = torch.jit.script(model)
torch.jit.save(scripted_model, 'model_scripted.pt')
# TorchScript-Modell laden
loaded_script = torch.jit.load('model_scripted.pt')
Best Practices und häufige Probleme
Best Practices
- Namenskonventionen: Verwenden Sie aussagekräftige Dateinamen, wie z. B.
resnet18_epoch50.pth - Regelmäßiges Speichern: Alle paar Epochen einen Checkpoint speichern
- Laden überprüfen: Die Ladefunktionalität direkt nach dem Speichern testen
- Dokumentation: Modellarchitektur und Trainingsparameter dokumentieren
- Versionskontrolle: Modelldateien in das Versionskontrollsystem aufnehmen
Lösungen für häufige Probleme
Problem 1:Fehlende Schlüssel in state_dict
Lösung: Stellen Sie sicher, dass die Modellarchitektur exakt übereinstimmt, oder verwenden Siestrict=FalseParameter:
model.load_state_dict(torch.load('model.pth'), strict=False)
Problem 2:CUDA-Speicher voll
Lösung: Beim Laden zuerst auf die CPU verschieben:
Beispiel
Problem 3: Modelle älterer Versionen können nicht geladen werden
Lösung: Versuchen Sie, in verschiedenen PyTorch-Versionen zu laden, oder konvertieren Sie das Modellformat
Praktische Anwendungsbeispiele
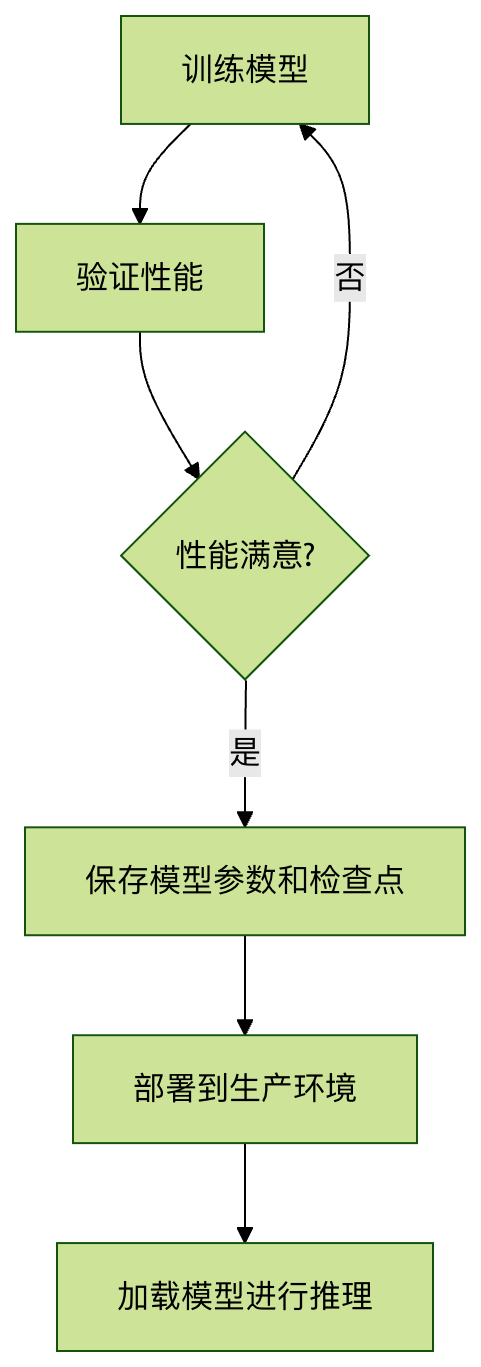
Prozess zum Speichern und Laden von Bildklassifizierungsmodellen
Vollständiges Codebeispiel
Beispiel
import torch.nn as nn
import torch.optim as optim
# Ein einfaches Modell definieren
class SimpleModel(nn.Module):
def __init__(self):
super(SimpleModel, self).__init__()
self.fc = nn.Linear(10, 2)
def forward(self, x):
return self.fc(x)
# Initialisierung
model = SimpleModel()
optimizer = optim.SGD(model.parameters(), lr=0.01)
criterion = nn.CrossEntropyLoss()
# Den Trainingsprozess simulieren
for epoch in range(5):
# Trainingsschritte simulieren
inputs = torch.randn(32, 10)
labels = torch.randint(0, 2, (32,))
optimizer.zero_grad()
outputs = model(inputs)
loss = criterion(outputs, labels)
loss.backward()
optimizer.step()
# Alle 2 Epochen einen Checkpoint speichern
if epoch % 2 == 0:
checkpoint = {
'epoch': epoch,
'model_state_dict': model.state_dict(),
'optimizer_state_dict': optimizer.state_dict(),
'loss': loss.item(),
}
torch.save(checkpoint, f'checkpoint_epoch{epoch}.pth')
print(f'Checkpoint gespeichert bei Epoche {epoch}')
# Endgültiges Speichern
torch.save(model.state_dict(), 'final_model.pth')
# Ladebeispiel
loaded_model = SimpleModel()
loaded_model.load_state_dict(torch.load('final_model.pth'))
loaded_model.eval()
# Das geladene Modell testen
test_input = torch.randn(1, 10)
with torch.no_grad():
output = loaded_model(test_input)
print(f'Test output: {output}')