PyTorch Rekurrentes Neuronales Netz (RNN)
Rekurrente Neuronale Netze (RNN) sind eine Klasse von neuronalen Netzarchitekturen, die speziell für die Verarbeitung von Sequenzdaten entwickelt wurden. Sie können dynamische Informationen aus Zeitreihen oder geordneten Daten erfassen und Sequenzdaten wie Text, Zeitreihen oder Audio verarbeiten.
RNN haben ein breites Anwendungsspektrum in Aufgaben wie Verarbeitung natürlicher Sprache (NLP), Spracherkennung und Zeitreihenvorhersage.
Ein Hauptmerkmal von RNN ist ihre Fähigkeit, einen versteckten Zustand beizubehalten, wodurch das Netzwerk Informationen aus vorherigen Zeitschritten speichern kann, was für die Verarbeitung von Sequenzdaten unerlässlich ist.
Grundstruktur von RNN
In einem traditionellen Feedforward-Neuronalen Netz fließen Daten von der Eingabeschicht zur Ausgabeschicht. In einem RNN hingegen fließen die Daten nicht nur durch die Netzwerkschichten, sondern breiten sich bei jedem Zeitschritt auch auf den aktuellen Zustand der versteckten Schicht aus, wodurch vorherige Informationen an den nächsten Zeitschritt weitergegeben werden.
Versteckter Zustand:RNN verwendet den versteckten Zustand, um Informationen in der Sequenz zu speichern.
Der versteckte Zustand wird aus dem versteckten Zustand des vorherigen Zeitschritts und der aktuellen Eingabe berechnet.
Die Struktur der rekurrenten Einheit ist wie folgt:
- Eingabe (\(x_t\)): der Eingabevektor zum Zeitschritt \(t\).
- Verborgener Zustand (\(h_t\)): der Vektor des verborgenen Zustands zum Zeitschritt \(t\), der verwendet wird, um Informationen aus vorherigen Zeitschritten zu speichern.
- Ausgabe (\(y_t\)): der Ausgabevektor zum Zeitschritt \(t\) (optional, abhängig von der spezifischen Aufgabe).
Formel:
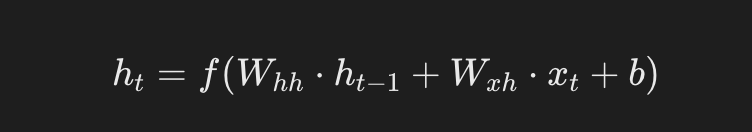
\[ h_t = f(W_{hh}h_{t-1} + W_{xh}x_t + b_h) \]
- ht: der verborgene Zustand zum aktuellen Zeitschritt.
- ht-1: der verborgene Zustand zum vorherigen Zeitschritt.
- Xt: die Eingabe zum aktuellen Zeitschritt.
- Whh、Wxh: Gewichtsmatrix.
- b: Bias-Term.
- f: Aktivierungsfunktion (wie Tanh oder ReLU).
Ausgabe:Die Ausgabe eines RNN hängt nicht nur von der aktuellen Eingabe, sondern auch von den historischen Informationen des verborgenen Zustands ab.
Formel:
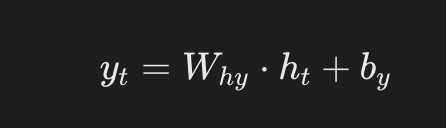
\[ y_t = W_{hy}h_t + b_y \]
- yt: der Ausgabevektor zum Zeitschritt t (optional, je nach spezifischer Aufgabe).
- Why: die Gewichtsmatrix vom verborgenen Zustand zur Ausgabe.
Wie RNN Sequenzdaten verarbeitet
Die entfaltete Darstellung eines rekurrenten neuronalen Netzes (RNN) bei der Verarbeitung von Sequenzdaten sieht wie folgt aus:
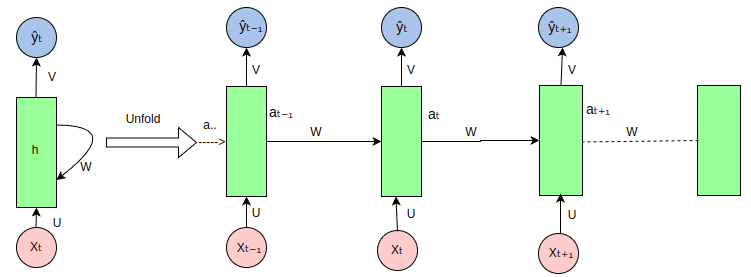
RNN ist ein neuronales Netz zur Verarbeitung von Sequenzdaten. Es verarbeitet jedes Element in der Sequenz durch rekurrente Verbindungen und gibt bei jedem Zeitschritt Informationen weiter. Im Folgenden wird jeder Teil in der Abbildung erläutert:
-
Eingabesequenz (Xt, Xt-1, Xt+1, ...): Die rosa Kreise in der Abbildung stellen Elemente der Eingabesequenz dar. Zum Beispiel ist Xt die Eingabe am aktuellen Zeitschritt, Xt-1 die Eingabe am vorherigen Zeitschritt und so weiter.
Verborgener Zustand (ht, ht-1, ht+1, ...): Die grünen Rechtecke stellen den verborgenen Zustand des RNN dar, der Informationen über die Sequenz zu jedem Zeitschritt speichert. ht ist der verborgene Zustand am aktuellen Zeitschritt, ht-1 ist der verborgene Zustand am vorherigen Zeitschritt.
Gewichtsmatrizen (U, W, V):
U: Die Gewichtsmatrix von der Eingabe zum verborgenen Zustand, die verwendet wird, um die EingabeXtin einen Teil des verborgenen Zustands umzuwandeln.W: Die Gewichtsmatrix vom verborgenen Zustand zum verborgenen Zustand, die verwendet wird, um den verborgenen Zustand des vorherigen Zeitschrittsht-1in einen Teil des verborgenen Zustands des aktuellen Zeitschritts umzuwandeln.V: Die Gewichtsmatrix vom versteckten Zustand zur Ausgabe, die verwendet wird, um den versteckten Zustandhtin die Ausgabe umzuwandeln.Yt。
Ausgabesequenz (Yt, Yt-1, Yt+1, ...): Die blauen Kreise repräsentieren die Ausgabe des RNN zu jedem Zeitschritt. Zum Beispiel ist Yt die Ausgabe zum aktuellen Zeitschritt.
Rekurrente Verbindung: Ein Merkmal von RNN ist die rekurrente Verbindung des versteckten Zustands, die es dem Netzwerk ermöglicht, Informationen aus vorherigen Zeitschritten zu berücksichtigen, wenn es die Eingabe am aktuellen Zeitschritt verarbeitet.
-
Entfalten: Die Abbildung zeigt den Entfaltungsprozess des RNN über eine Sequenz, was hilft zu verstehen, wie das RNN Sequenzdaten über die Zeit verarbeitet. In tatsächlichen RNN-Implementierungen werden diese Schritte parallel verarbeitet, aber konzeptionell können wir es entfalten, um zu verstehen, wie Informationen fließen.
Informationsfluss: Informationen fließen von der Eingabesequenz über die Gewichtsmatrix U zum versteckten Zustand, dann zwischen Zeitschritten über die Gewichtsmatrix W und schließlich vom versteckten Zustand über die Gewichtsmatrix V zur Ausgabesequenz.
RNN-Grundlagen in PyTorch
In PyTorch kann RNN verwendet werden, um komplexe Sequenzmodelle zu erstellen.
PyTorch bietet mehrere RNN-Module, darunter:
torch.nn.RNN: Einfache RNN-Zelle.torch.nn.LSTM: Long Short-Term Memory (LSTM)-Zelle, die langfristige Abhängigkeiten erlernen kann.torch.nn.GRU: Gated Recurrent Unit, eine vereinfachte Version von LSTM, aber normalerweise einfacher zu trainieren.
Bei der Verwendung der RNN-Klasse müssen Sie die Eingabedimension, die Dimension der verborgenen Schicht und einige andere Hyperparameter angeben.
PyTorch Implementierung eines einfachen RNN-Beispiels
Das Folgende ist ein einfaches PyTorch-Implementierungsbeispiel, das ein RNN-Modell verwendet, um Sequenzdaten zu verarbeiten und eine Klassifizierung durchzuführen.
1. Notwendige Bibliotheken importieren
Beispiel
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset
import numpy as np
2. Definiere das RNN-Modell
Beispiel
def __init__(self, input_size, hidden_size, output_size):
super(SimpleRNN, self).__init__()
# Definiere die RNN-Schicht
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
# Definiere die vollständig verbundene Schicht
self.fc = nn.Linear(hidden_size, output_size)
def forward(self, x):
# x: (batch_size, seq_len, input_size)
out, _ = self.rnn(x) # out: (batch_size, seq_len, hidden_size)
# Verwende die Ausgabe des letzten Zeitschritts der Sequenz als Modellausgabe
out = out[:, -1, :] # (batch_size, hidden_size)
out = self.fc(out) # Vollständig verbundene Schicht
return out
3. Trainingsdaten erstellen
Um das RNN zu trainieren, erzeugen wir einige zufällige Sequenzdaten. Hierbei ist das Ziel, den letzten Wert jeder Sequenz als Klassifikationsziel zu verwenden.
Beispiel
num_samples = 1000
seq_len = 10
input_size = 5
output_size = 2 # Binäres Klassifikationsproblem annehmen
# Eingabedaten zufällig generieren (batch_size, seq_len, input_size)
X = torch.randn(num_samples, seq_len, input_size)
# Ziel-Labels zufällig generieren (batch_size, output_size)
Y = torch.randint(0, output_size, (num_samples,))
# Data Loader erstellen
dataset = TensorDataset(X, Y)
train_loader = DataLoader(dataset, batch_size=32, shuffle=True)
4. Verlustfunktion und Optimierer definieren
Beispiel
model = SimpleRNN(input_size=input_size, hidden_size=64, output_size=output_size)
# Verlustfunktion und Optimierer definieren
criterion = nn.CrossEntropyLoss() # Multi-Klassen-Cross-Entropy-Verlust
optimizer = optim.Adam(model.parameters(), lr=0.001)
5. Das Modell trainieren
Beispiel
for epoch in range(num_epochs):
model.train() # Setze das Modell in den Trainingsmodus
total_loss = 0
correct = 0
total = 0
for inputs, labels in train_loader:
# Vorwärtsdurchlauf
outputs = model(inputs)
loss = criterion(outputs, labels)
# Backpropagation und Optimierung
optimizer.zero_grad()
loss.backward()
optimizer.step()
total_loss += loss.item()
# Genauigkeit berechnen
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Epoche [{epoch+1}/{num_epochs}], Verlust: {total_loss / len(train_loader):.4f}, Genauigkeit: {accuracy:.2f}%")
6. Das Modell testen
Nach dem Training können wir die Leistung des Modells auf dem Testset bewerten.
Beispiel
model.eval() # Modell in den Evaluierungsmodus versetzen
with torch.no_grad():
total = 0
correct = 0
for inputs, labels in train_loader:
outputs = model(inputs)
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
accuracy = 100 * correct / total
print(f"Testgenauigkeit: {accuracy:.2f}%")
7. Der vollständige Code lautet wie folgt:
Beispiel
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
import numpy as np
# Datensatz: Vorhersage von Zeichenfolgen (Hello -> Elloh)
char_set = list("hello")
char_to_idx = {c: i for i, c in enumerate(char_set)}
idx_to_char = {i: c for i, c in enumerate(char_set)}
# Datenvorbereitung
input_str = "hello"
target_str = "elloh"
input_data = [char_to_idx[c] for c in input_str]
target_data = [char_to_idx[c] for c in target_str]
# In One-Hot-Encoding umwandeln
input_one_hot = np.eye(len(char_set))[input_data]
# In PyTorch-Tensor konvertieren
inputs = torch.tensor(input_one_hot, dtype=torch.float32)
targets = torch.tensor(target_data, dtype=torch.long)
# Modell-Hyperparameter
input_size = len(char_set)
hidden_size = 8
output_size = len(char_set)
num_epochs = 200
learning_rate = 0.1
# RNN-Modell definieren
class RNNModel(nn.Module):
def __init__(self, input_size, hidden_size, output_size):
super(RNNModel, self).__init__()
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, output_size)
def forward(self, x, hidden):
out, hidden = self.rnn(x, hidden)
out = self.fc(out) # Vollständig verbundene Schicht anwenden
return out, hidden
model = RNNModel(input_size, hidden_size, output_size)
# Verlustfunktion und Optimierer definieren
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=learning_rate)
# Das RNN trainieren
losses = []
hidden = None # Anfänglicher Hidden-Zustand ist None
for epoch in range(num_epochs):
optimizer.zero_grad()
# Vorwärtsdurchlauf
outputs, hidden = model(inputs.unsqueeze(0), hidden)
hidden = hidden.detach() # Gradientenexplosion verhindern
# Verlust berechnen
loss = criterion(outputs.view(-1, output_size), targets)
loss.backward()
optimizer.step()
losses.append(loss.item())
if (epoch + 1) % 20 == 0:
print(f"Epoche [{epoch + 1}/{num_epochs}], Verlust: {loss.item():.4f}")
# Das RNN testen
with torch.no_grad():
test_hidden = None
test_output, _ = model(inputs.unsqueeze(0), test_hidden)
predicted = torch.argmax(test_output, dim=2).squeeze().numpy()
print("Eingabesequenz: ", ''.join([idx_to_char[i] for i in input_data]))
print("Vorhergesagte Sequenz: ", ''.join([idx_to_char[i] for i in predicted]))
Code-Erklärung:
Datenvorbereitung:
- Verwenden Sie die Zeichensequenz
hello, und konvertieren Sie sie in One-Hot-Encoding. - Die Zielsequenz ist
elloh, d. h., ein Zeichen nach rechts rotieren.
- Verwenden Sie die Zeichensequenz
Modellkonstruktion:
- Verwenden Sie
torch.nn.RNNErstellen Sie ein rekurrentes neuronales Netz. - Füge eine vollständig verbundene Schicht hinzu
torch.nn.LinearWird verwendet, um den verborgenen Zustand auf die Ausgabe abzubilden.
- Verwenden Sie
Trainingsteil:
- Jede Epoche berechnet den Verlust und führt eine Backpropagation durch.
- Der verborgene Zustand wird durchgeleitet
hidden.detach()um eine Gradientenexplosion zu verhindern.
Testteil:
- Das Modell gibt die vorhergesagten Zeichenergebnisse aus.
Visualisierung:
- Verwende Matplotlib, um den Trend des Trainingsverlusts darzustellen.
Angenommen, Ihr Modell ist gut trainiert, könnte die Ausgabe wie folgt aussehen:
Epoch [20/200], Loss: 0.0013
Epoch [40/200], Loss: 0.0003
Epoch [60/200], Loss: 0.0002
Epoch [80/200], Loss: 0.0001
Epoch [100/200], Loss: 0.0001
Epoch [120/200], Loss: 0.0001
Epoch [140/200], Loss: 0.0001
Epoch [160/200], Loss: 0.0001
Epoch [180/200], Loss: 0.0001
Epoch [200/200], Loss: 0.0001
Input sequence:  hello
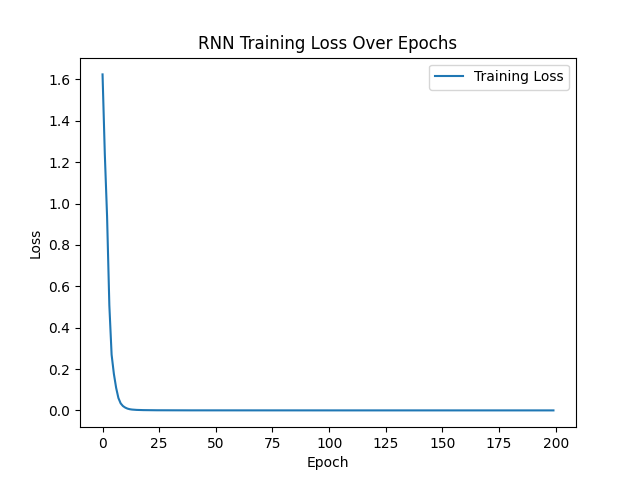
Anhand der Ergebnisse zeigt das Bild einen allmählichen Rückgang des Verlusts, was darauf hindeutet, dass das Modelltraining effektiv ist.
8. Visualisierungscode:Beispiel
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt
import numpy as np
# Datensatz: Vorhersage von Zeichenfolgen (Hello -> Elloh)
char_set = list("hello")
char_to_idx = {c: i for i, c in enumerate(char_set)}
idx_to_char = {i: c for i, c in enumerate(char_set)}
# Datenvorbereitung
input_str = "hello"
target_str = "elloh"
input_data = [char_to_idx[c] for c in input_str]
target_data = [char_to_idx[c] for c in target_str]
# In One-Hot-Encoding umwandeln
input_one_hot = np.eye(len(char_set))[input_data]
# In PyTorch-Tensor konvertieren
inputs = torch.tensor(input_one_hot, dtype=torch.float32)
targets = torch.tensor(target_data, dtype=torch.long)
# Modell-Hyperparameter
input_size = len(char_set)
hidden_size = 8
output_size = len(char_set)
num_epochs = 200
learning_rate = 0.1
# RNN-Modell definieren
class RNNModel(nn.Module):
def __init__(self, input_size, hidden_size, output_size):
super(RNNModel, self).__init__()
self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, output_size)
def forward(self, x, hidden):
out, hidden = self.rnn(x, hidden)
out = self.fc(out) # Vollständig verbundene Schicht anwenden
return out, hidden
model = RNNModel(input_size, hidden_size, output_size)
# Verlustfunktion und Optimierer definieren
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=learning_rate)
# RNN trainieren
losses = []
hidden = None # Anfänglicher Hidden-Zustand ist None
for epoch in range(num_epochs):
optimizer.zero_grad()
# Vorwärtspropagierung
outputs, hidden = model(inputs.unsqueeze(0), hidden)
hidden = hidden.detach() # Gradientenexplosion verhindern
# Verlust berechnen
loss = criterion(outputs.view(-1, output_size), targets)
loss.backward()
optimizer.step()
losses.append(loss.item())
if (epoch + 1) % 20 == 0:
print(f"Epoche [{epoch + 1}/{num_epochs}], Verlust: {loss.item():.4f}")
# RNN testen
with torch.no_grad():
test_hidden = None
test_output, _ = model(inputs.unsqueeze(0), test_hidden)
predicted = torch.argmax(test_output, dim=2).squeeze().numpy()
print("Eingabesequenz: ", ''.join([idx_to_char[i] for i in input_data]))
print("Vorhergesagte Sequenz: ", ''.join([idx_to_char[i] for i in predicted]))
# Verlust visualisieren
plt.plot(losses, label="Trainingsverlust")
plt.xlabel("Epoche")
plt.ylabel("Verlust")
plt.title("RNN Trainingsverlust über Epochen")
plt.legend()
plt.show()
Nach der Ausführung sieht das angezeigte Bild wie folgt aus: