Python urllib
Die Python-Bibliothek urllib wird verwendet, um mit Web-URLs zu arbeiten und Webinhalte zu scrapen.
Dieser Artikel stellt hauptsächlich Python3s urllib vor.
Das urllib-Paket enthält die folgenden Module:
- urllib.request- Öffnen und Lesen von URLs.
- urllib.error- Enthält die von urllib.request ausgelösten Ausnahmen.
- urllib.parse- URLs parsen.
- urllib.robotparser- robots.txt-Dateien parsen.

urllib.request
urllib.request definiert einige Funktionen und Klassen zum Öffnen von URLs, einschließlich Autorisierungsverifizierung, Weiterleitungen, Browser-Cookies usw.
urllib.request kann den Prozess der Anfrageinitiierung eines Browsers simulieren.
Wir können die urlopen-Methode von urllib.request verwenden, um eine URL zu öffnen; die Syntax lautet wie folgt:
urllib.request.urlopen(url, data=None, [timeout, ]*, cafile=None, capath=None, cadefault=False, context=None)
- url: URL-Adresse.
- data: Weitere an den Server gesendete Datenobjekte, Standardwert ist None.
- timeout: Legt das Zugriffs-Timeout fest.
- cafile und capath: cafile ist das CA-Zertifikat, capath ist der Pfad zum CA-Zertifikat, erforderlich für HTTPS.
- cadefault: Veraltet.
- context: Typ ssl.SSLContext, wird verwendet, um SSL-Einstellungen anzugeben.
Ein Beispiel ist wie folgt:
Beispiel
myURL = urlopen("https://www.example.com/")
print(myURL.read())
Der obige Code verwendet urlopen, um eine URL zu öffnen, und verwendet dann die Funktion read(), um den HTML-Quellcode der Webseite abzurufen.
read() liest den gesamten Inhalt der Webseite; wir können die zu lesende Länge angeben:
Beispiel
myURL = urlopen("https://www.example.com/")
print(myURL.read(300))
Zusätzlich zur Funktion read() enthält es außerdem die folgenden zwei Funktionen zum Lesen von Webseiteninhalten:
-
readline()- Liest eine Zeile der Datei
from urllib.request import urlopen myURL = urlopen("https://www.example.com/") print(myURL.readline()) #读取一行内容 -
readlines()- Liest den gesamten Inhalt der Datei und weist den gelesenen Inhalt einer Listen-Variablen zu.
from urllib.request import urlopen

myURL = urlopen("https://www.example.com/")
lines = myURL.readlines()
for line in lines:
    print(line)
Beim Scrapen von Webseiten müssen wir oft feststellen, ob auf die Webseite normal zugegriffen werden kann. Hier können wir die Funktion getcode() verwenden, um den Statuscode der Webseite abzurufen. Die Rückgabe von 200 bedeutet, dass die Webseite normal ist; die Rückgabe von 404 bedeutet, dass die Webseite nicht existiert:
Beispiel
myURL1 = urllib.request.urlopen("https://www.example.com/")
print(myURL1.getcode()) # 200
try:
myURL2 = urllib.request.urlopen("https://www.example.com/no.html")
except urllib.error.HTTPError as e:
if e.code == 404:
print(404) # 404
Weitere Webseiten-Statuscodes finden Sie unter:https://www.example.com/http/http-status-codes.html。
Wenn Sie die gescrapte Webseite lokal speichern möchten, können Sie diePython3-Datei-write()-MethodeFunktion verwenden:
Beispiel
myURL = urlopen("https://www.example.com/")
f = open("example_urllib_test.html", "wb")
content = myURL.read() # Webseiteninhalt lesen
f.write(content)
f.close()
Nach Ausführung des obigen Codes wird lokal eine Datei example_urllib_test.html erzeugt, die den Inhalt der Webseite https://www.example.com/ enthält.
Weitere Informationen zur Python-Dateiverarbeitung finden Sie unter:https://www.example.com/python3/python3-file-methods.html
。Zur URL-Kodierung und -Dekodierung können die Methodenurllib.request.quote()undurllib.request.unquote()verwendet werden:
Beispiel
encode_url = urllib.request.quote("https://www.example.com/") # Kodierung
print(encode_url)
unencode_url = urllib.request.unquote(encode_url) # Dekodierung
print(unencode_url)
Das Ausgabeergebnis ist:
https%3A//www.example.com/
https://www.example.com/
Header simulieren
Beim Scrapen von Webseiten müssen wir im Allgemeinen Header simulieren (Header-Informationen der Webseite). Zu diesem Zeitpunkt müssen wir die Klasse urllib.request.Request verwenden:
class urllib.request.Request(url, data=None, headers={}, origin_req_host=None, unverifiable=False, method=None)
- url: URL-Adresse.
- data: Weitere an den Server gesendete Datenobjekte, Standardwert ist None.
- headers: HTTP-Request-Header-Informationen im Dictionary-Format.
- origin_req_host: Die Hostadresse der Anfrage, IP-Adresse oder Domainname.
- unverifiable: Dieser Parameter wird selten verwendet. Er wird verwendet, um festzulegen, ob die Webseite eine Verifizierung erfordert. Standard ist False.
- method: Request-Methode, wie GET, POST, DELETE, PUT usw.
Beispiel - Code der Datei py3_urllib_test.py
import urllib.parse
url = 'https://www.example.com/?s=' # Beispiel-Tutorial-Suchseite
keyword = 'Python Tutorial'
key_code = urllib.request.quote(keyword) # Die Anfrage kodieren
url_all = url+key_code
header = {
'User-Agent':'Mozilla/5.0 (X11; Fedora; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36'
} # Header-Informationen
request = urllib.request.Request(url_all,headers=header)
reponse = urllib.request.urlopen(request).read()
fh = open("./urllib_test_example_search.html","wb") # Schreibe die Datei in das aktuelle Verzeichnis
fh.write(reponse)
fh.close()
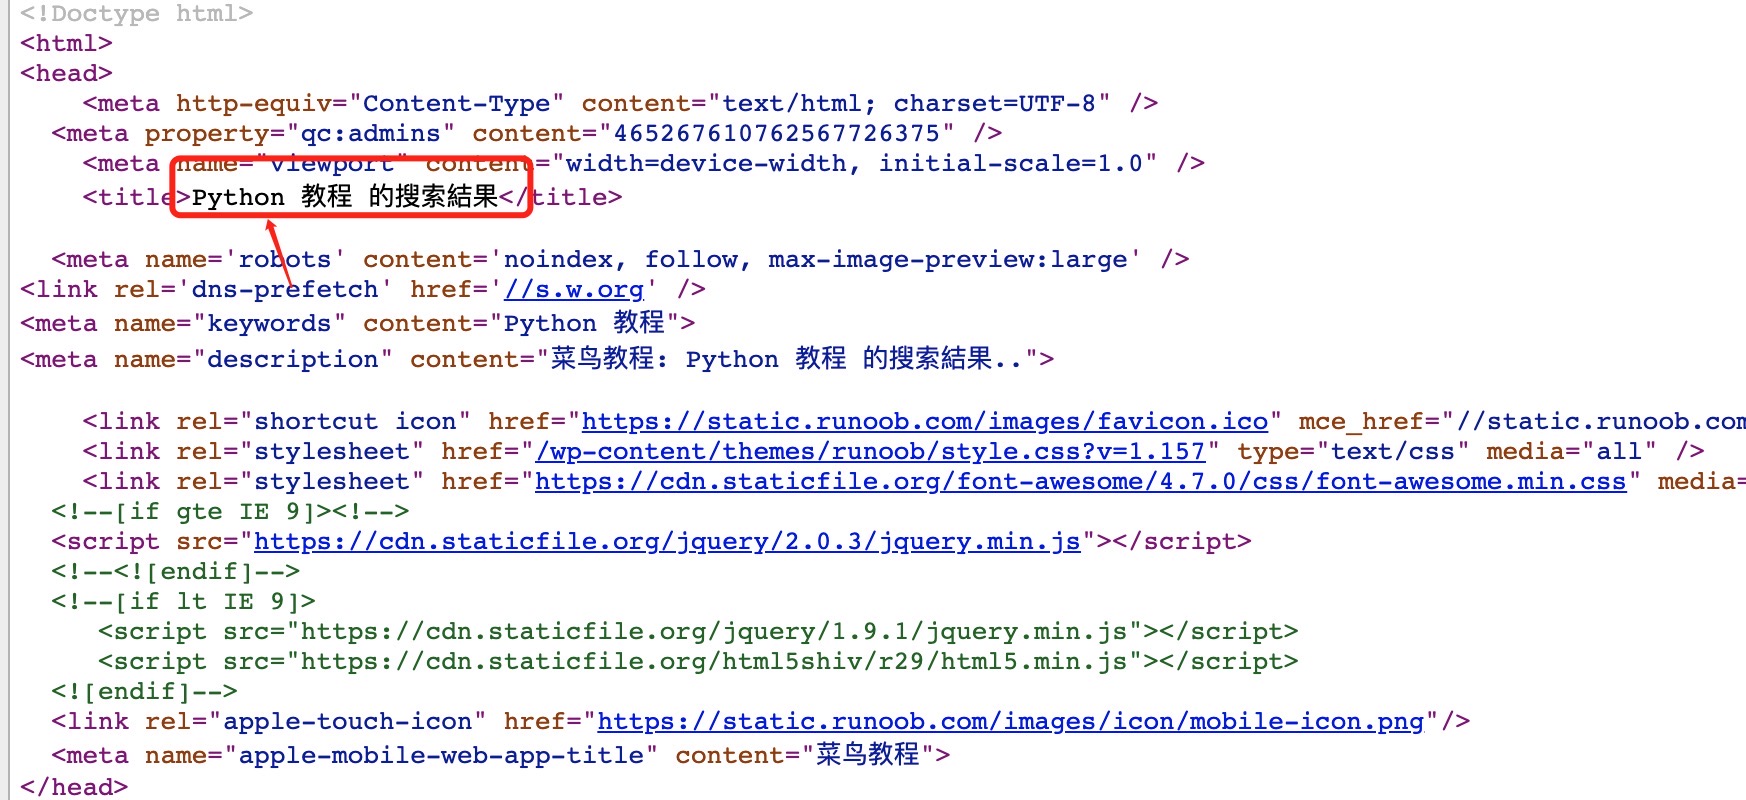
Nach Ausführung des obigen Python-Codes wird eine Datei urllib_test_example_search.html im aktuellen Verzeichnis erzeugt. Öffnen Sie die Datei urllib_test_example_search.html (Sie können sie mit einem Browser öffnen), der Inhalt ist wie folgt:
Für die Übertragung von Formulardaten per POST erstellen wir zunächst ein Formular. Der Code ist wie folgt. Hier verwende ich PHP-Code, um die Formulardaten zu erhalten:
Beispiel - Code der Datei py3_urllib_test.php:
<html>
<head>
<meta charset="utf-8">
<title>Beispiel-Tutorial (example.com) urllib POST Test</title>
</head>
<body>
<form action="" method="post" name="myForm">
Name: <input type="text" name="name"><br>
Tag: <input type="text" name="tag"><br>
<input type="submit" value="Submit">
</Form>
<hr>
<?php
//Verwende PHP, um die vom Formular übermittelten Daten abzurufen; du kannst es durch andere Sprachen ersetzen
if(isset($_POST['name']) && $_POST['tag'] ) {
echo $_POST["name"] . ', ' . $_POST['tag'];
}
?>
</body>
</html>
Beispiel
import urllib.parse
url = 'https://www.example.com/try/py3/py3_urllib_test.php' # An die Formularseite senden
data = {'name':'EXAMPLE', 'tag' : 'Rookie Tutorial'} # Daten übermitteln
header = {
'User-Agent':'Mozilla/5.0 (X11; Fedora; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36'
} # Header-Informationen
data = urllib.parse.urlencode(data).encode('utf8') # Parameter kodieren, urllib.parse.urldecode zum Dekodieren verwenden
request=urllib.request.Request(url, data, header) # Anfrageverarbeitung
reponse=urllib.request.urlopen(request).read() # Ergebnis lesen
fh = open("./urllib_test_post_example.html","wb") # Schreibe die Datei in das aktuelle Verzeichnis
fh.write(reponse)
fh.close()
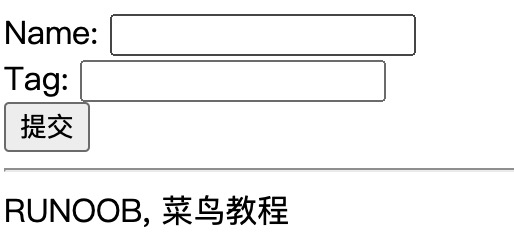
Wenn Sie den obigen Code ausführen, werden Formulardaten an die Datei py3_urllib_test.php übermittelt und das Ausgabeergebnis in die Datei urllib_test_post_example.html geschrieben.
Öffnen Sie die Datei urllib_test_post_example.html (Sie können sie mit einem Browser öffnen); das angezeigte Ergebnis ist wie folgt:
urllib.error
Das Modul urllib.error definiert Ausnahmeklassen für Ausnahmen, die von urllib.request ausgelöst werden, und die Basisausnahmeklasse ist URLError.
urllib.error enthält zwei Ausnahmeklassen, URLError und HTTPError.
URLError ist eine Unterklasse von OSError und wird verwendet, um Ausnahmen (oder abgeleitete Ausnahmen) zu behandeln, die das Programm beim Auftreten von Problemen auslöst. Das darin enthaltene Attribut reason ist die Ursache der Ausnahme.
HTTPError ist eine Unterklasse von URLError und wird verwendet, um spezielle HTTP-Fehler wie Authentifizierungsanfragen zu behandeln. Die Attribute, die es enthält, sind:codecode: der HTTP-Statuscode,reasonreason: die Ursache der Ausnahme,headersheaders: die HTTP-Antwortheader der spezifischen HTTP-Anfrage, die den HTTPError verursacht hat.
Rufen Sie eine nicht vorhandene Webseite ab und behandeln Sie Ausnahmen:
Beispiel
import urllib.error
myURL1 = urllib.request.urlopen("https://www.example.com/")
print(myURL1.getcode()) # 200
try:
myURL2 = urllib.request.urlopen("https://www.example.com/no.html")
except urllib.error.HTTPError as e:
if e.code == 404:
print(404) # 404
urllib.parse
urllib.parse wird zum Parsen von URLs verwendet, das Format ist wie folgt:
urllib.parse.urlparse(urlstring, scheme='', allow_fragments=True)
urlstring ist die URL-Adresse als String, scheme ist der Protokolltyp,
Wenn der Parameter allow_fragments false ist, können Fragmentbezeichner nicht erkannt werden. Stattdessen werden sie als Teil des Pfads, der Parameter oder der Query-Komponenten geparst, und fragment wird im Rückgabewert auf eine leere Zeichenkette gesetzt.
Beispiel
o = urlparse("https://www.example.com/?s=python+%E6%95%99%E7%A8%8B")
print(o)
Das Ausgabeergebnis des obigen Beispiels ist:
ParseResult(scheme='https', netloc='www.example.com', path='/', params='', query='s=python+%E6%95%99%E7%A8%8B', fragment='')
Dem Ergebnis kann entnommen werden, dass der Inhalt ein Tupel aus 6 Zeichenketten ist: Protokoll, Ort, Pfad, Parameter, Abfrage und Fragment.
Wir können den Protokollinhalt direkt auslesen:
Beispiel
o = urlparse("https://www.example.com/?s=python+%E6%95%99%E7%A8%8B")
print(o.scheme)
Das Ausgabeergebnis des obigen Beispiels ist:
https
Der vollständige Inhalt ist wie folgt:
Attribute |
Index |
Wert |
Wert (falls nicht vorhanden) |
|---|---|---|---|
|
0 |
URL-Protokoll |
schemeParameter |
|
1 |
Netzwerkadressteil |
Leere Zeichenfolge |
|
2 |
Hierarchischer Pfad |
Leere Zeichenfolge |
|
3 |
Parameter des letzten Pfadelements |
Leere Zeichenfolge |
|
4 |
Abfragekomponente |
Leere Zeichenfolge |
|
5 |
Fragmentbezeichner |
Leere Zeichenfolge |
|
Benutzername |
|
|
|
Password |
|
|
|
Hostname (kleingeschrieben) |
|
|
|
Portnummer als Ganzzahl (falls vorhanden) |
|
urllib.robotparser
urllib.robotparser wird verwendet, um robots.txt-Dateien zu parsen.
robots.txt (durchgängig kleingeschrieben) ist ein Robots-Protokoll, das im Stammverzeichnis einer Website gespeichert ist. Es wird üblicherweise verwendet, um Suchmaschinen die Crawling-Regeln für die Website mitzuteilen.
urllib.robotparser stellt die Klasse RobotFileParser bereit, die Syntax lautet wie folgt:
class urllib.robotparser.RobotFileParser(url='')
Diese Klasse bietet Methoden, die robots.txt-Dateien lesen und parsen können:
-
set_url(url) - Legt die URL der robots.txt-Datei fest.
-
read() - Liest die robots.txt-URL und übergibt sie an den Parser.
-
parse(lines) - Parst den Parameter lines.
-
can_fetch(useragent, url) - Gibt True zurück, wenn der useragent gemäß den Regeln in der geparsten robots.txt-Datei die url abrufen darf.
-
mtime() - Gibt die Zeit zurück, zu der die robots.txt-Datei zuletzt abgerufen wurde. Dies ist nützlich für lang laufende Web-Crawler, die regelmäßig auf Aktualisierungen der robots.txt prüfen müssen.
-
modified() - Setzt die Zeit, zu der die robots.txt-Datei zuletzt abgerufen wurde, auf die aktuelle Zeit.
-
crawl_delay(useragent) - Gibt den Crawl-delay-Parameter aus robots.txt für den angegebenen useragent zurück. Gibt None zurück, wenn dieser Parameter nicht existiert, nicht für den angegebenen useragent gilt oder wenn der robots.txt-Eintrag für diesen Parameter einen Syntaxfehler enthält.
-
request_rate(useragent) - Gibt den Inhalt des Request-rate-Parameters aus robots.txt als benanntes Tupel RequestRate(requests, seconds) zurück. Gibt None zurück, wenn dieser Parameter nicht existiert, nicht für den angegebenen useragent gilt oder wenn der robots.txt-Eintrag für diesen Parameter einen Syntaxfehler enthält.
-
site_maps() - Gibt den Inhalt des Sitemap-Parameters aus robots.txt als list() zurück. Gibt None zurück, wenn dieser Parameter nicht existiert oder wenn der robots.txt-Eintrag für diesen Parameter einen Syntaxfehler enthält.
Beispiel
>>> rp = urllib.robotparser.RobotFileParser()
>>> rp.set_url("http://www.musi-cal.com/robots.txt")
>>> rp.read()
>>> rrate = rp.request_rate("*")
>>> rrate.requests
3
>>> rrate.seconds
20
>>> rp.crawl_delay("*")
6
>>> rp.can_fetch("*", "http://www.musi-cal.com/cgi-bin/search?city=San+Francisco")
False
>>> rp.can_fetch("*", "http://www.musi-cal.com/")
True