Python urllib
La biblioteca Python urllib se utiliza para manipular URL de páginas web y realizar scraping del contenido de las páginas.
Este artículo se centra principalmente en urllib de Python3.
El paquete urllib contiene los siguientes módulos:
- urllib.request- Abrir y leer URL.
- urllib.error- Contiene las excepciones lanzadas por urllib.request.
- urllib.parse- Analizar (parsear) URL.
- urllib.robotparser- Analizar archivos robots.txt.

urllib.request
urllib.request define algunas funciones y clases para abrir URL, incluyendo verificación de autorización, redireccionamientos, cookies de navegador, etc.
urllib.request puede simular el proceso de iniciar una solicitud de un navegador.
Podemos usar el método urlopen de urllib.request para abrir una URL, la sintaxis es la siguiente:
urllib.request.urlopen(url, data=None, [timeout, ]*, cafile=None, capath=None, cadefault=False, context=None)
- url: dirección url.
- data: otros objetos de datos enviados al servidor, por defecto es None.
- timeout: establece el tiempo de espera de acceso.
- cafile y capath: cafile es el certificado CA, capath es la ruta del certificado CA, se necesitan para usar HTTPS.
- cadefault: está en desuso.
- context: tipo ssl.SSLContext, se utiliza para especificar la configuración SSL.
Ejemplo:
Ejemplo
myURL = urlopen("https://www.example.com/")
print(myURL.read())
El código anterior usa urlopen para abrir una URL y luego usa la función read() para obtener el código HTML de la página web.
read() lee todo el contenido de la página web, podemos especificar la longitud de lectura:
Ejemplo
myURL = urlopen("https://www.example.com/")
print(myURL.read(300))
Además de la función read(), también incluye las siguientes dos funciones para leer el contenido de una página web:
-
readline()- Lee el contenido de una línea del archivo.
from urllib.request import urlopen myURL = urlopen("https://www.example.com/") print(myURL.readline()) #读取一行内容 -
readlines()- Lee todo el contenido del archivo y asigna el contenido leído a una variable de lista.
from urllib.request import urlopen

myURL = urlopen("https://www.example.com/")
lines = myURL.readlines()
for line in lines:
    print(line)
Al hacer scraping de páginas web, a menudo necesitamos determinar si la página se puede acceder correctamente. Aquí podemos usar la función getcode() para obtener el código de estado de la página. Si devuelve 200, la página es normal; si devuelve 404, la página no existe:
Ejemplo
myURL1 = urllib.request.urlopen("https://www.example.com/")
print(myURL1.getcode()) # 200
try:
myURL2 = urllib.request.urlopen("https://www.example.com/no.html")
except urllib.error.HTTPError as e:
if e.code == 404:
print(404) # 404
Se pueden consultar más códigos de estado de páginas web en:https://www.example.com/http/http-status-codes.html。
Si desea guardar la página web raspada localmente, puede usarMétodo write() de archivo en Python3función:
Ejemplo
myURL = urlopen("https://www.example.com/")
f = open("ejemplo_urllib_test.html", "wb")
content = myURL.read() # Leer el contenido de la página web
f.write(content)
f.close()
Al ejecutar el código anterior, se generará localmente un archivo ejemplo_urllib_test.html que contiene el contenido de la página web https://www.example.com/.
Para más procesamiento de archivos en Python, consulte:https://www.example.com/python3/python3-file-methods.html
。La codificación y decodificación de URL se puede realizar conurllib.request.quote()yurllib.request.unquote()el método:
Ejemplo
encode_url = urllib.request.quote("https://www.example.com/") # Codificar
print(encode_url)
unencode_url = urllib.request.unquote(encode_url) # Decodificar
print(unencode_url)
El resultado de salida es:
https%3A//www.example.com/
https://www.example.com/
Simular encabezados
Al hacer scraping de páginas web, generalmente necesitamos simular los headers (información de cabecera de la página), en este caso necesitamos usar la clase urllib.request.Request:
class urllib.request.Request(url, data=None, headers={}, origin_req_host=None, unverifiable=False, method=None)
- url: dirección url.
- data: otros objetos de datos enviados al servidor, por defecto es None.
- headers: información de cabecera de la solicitud HTTP, en formato de diccionario.
- origin_req_host: dirección del host de la solicitud, IP o dominio.
- unverifiable: este parámetro rara vez se usa, se utiliza para establecer si la página web requiere verificación, por defecto es False.
- method: método de solicitud, como GET, POST, DELETE, PUT, etc.
Ejemplo - código del archivo py3_urllib_test.py
import urllib.parse
url = 'https://www.example.com/?s=' # Página de búsqueda de Ejemplo
keyword = 'Tutorial de Python'
key_code = urllib.request.quote(keyword) # Codificar la solicitud
url_all = url+key_code
header = {
'User-Agent':'Mozilla/5.0 (X11; Fedora; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36'
} #Información de cabecera
request = urllib.request.Request(url_all,headers=header)
reponse = urllib.request.urlopen(request).read()
fh = open("./urllib_test_ejemplo_search.html","wb") # Escribir el archivo en el directorio actual
fh.write(reponse)
fh.close()
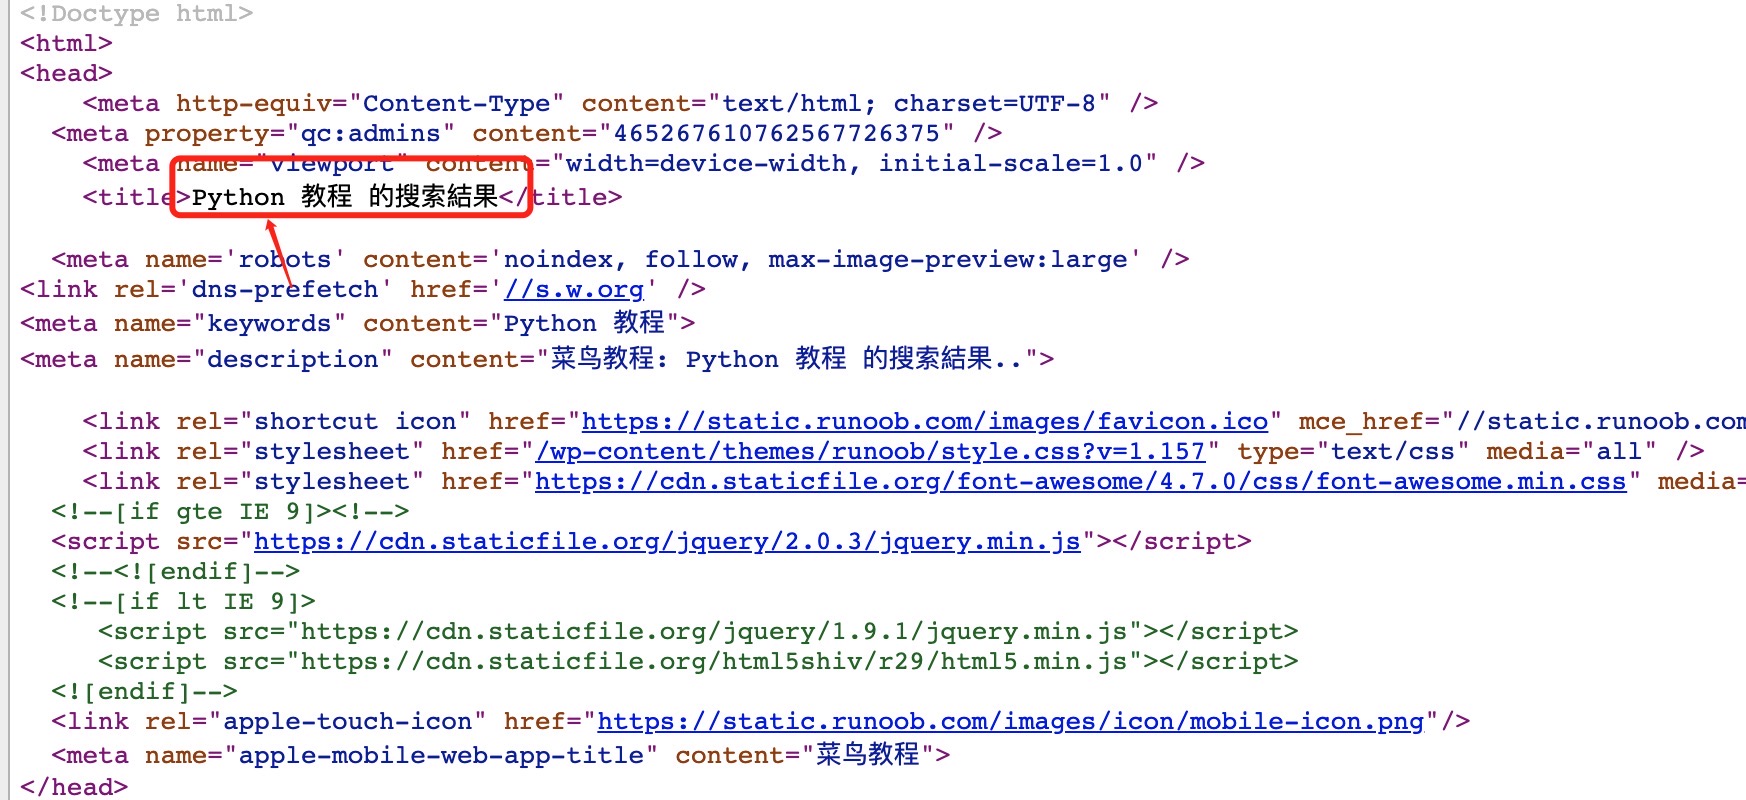
Al ejecutar el código Python anterior, se generará el archivo urllib_test_ejemplo_search.html en el directorio actual. Abra el archivo urllib_test_ejemplo_search.html (puede abrirlo con un navegador), el contenido es el siguiente:
Para enviar datos mediante POST de un formulario, primero creamos un formulario, el código es el siguiente. Aquí he usado código PHP para obtener los datos del formulario:
Ejemplo - código del archivo py3_urllib_test.php:
<html>
<head>
<meta charset="utf-8">
<title>Tutorial de Ejemplo (example.com) Prueba de urllib POST</title>
</head>
<body>
<form action="" method="post" name="myForm">
Name: <input type="text" name="name"><br>
Tag: <input type="text" name="tag"><br>
<input type="submit" value="Enviar">
</form>
<hr>
<?php
//Usa PHP para obtener los datos enviados por el formulario, puedes cambiarlo por otro lenguaje.
if(isset($_POST['name']) && $_POST['tag'] ) {
echo $_POST["name"] . ', ' . $_POST['tag'];
}
?>
</body>
</html>
Ejemplo
import urllib.parse
url = 'https://www.example.com/try/py3/py3_urllib_test.php' # Enviar a la página del formulario
data = {'name':'EJEMPLO', 'tag' : 'Ejemplo'} # Enviar datos
header = {
'User-Agent':'Mozilla/5.0 (X11; Fedora; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36'
} #Información de cabecera
data = urllib.parse.urlencode(data).encode('utf8') # Codificar los parámetros, decodificar usando urllib.parse.urldecode
request=urllib.request.Request(url, data, header) # Procesamiento de la solicitud
reponse=urllib.request.urlopen(request).read() # Leer el resultado
fh = open("./urllib_test_post_ejemplo.html","wb") # Escribir el archivo en el directorio actual
fh.write(reponse)
fh.close()
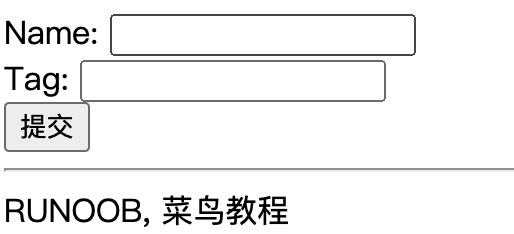
Al ejecutar el código anterior, se enviarán los datos del formulario al archivo py3_urllib_test.php, y el resultado de salida se escribirá en el archivo urllib_test_post_ejemplo.html.
Abra el archivo urllib_test_post_ejemplo.html (puede abrirlo con un navegador), el resultado mostrado es el siguiente:
urllib.error
El módulo urllib.error define clases de excepción para las excepciones planteadas por urllib.request; la clase de excepción base es URLError.
urllib.error contiene dos clases, URLError y HTTPError.
URLError es una subclase de OSError. Se utiliza para manejar excepciones (o excepciones derivadas) que se producen cuando el programa encuentra un problema; el atributo reason que contiene es la causa de la excepción.
HTTPError es una subclase de URLError, utilizada para manejar errores HTTP especiales, como en solicitudes de autenticación. Contiene los atributoscodeque son el código de estado HTTP,reasonla razón de la excepción,headersy las cabeceras de respuesta HTTP de la solicitud HTTP específica que causó el HTTPError.
Realizar scraping a una página web inexistente y manejar excepciones:
Ejemplo
import urllib.error
myURL1 = urllib.request.urlopen("https://www.example.com/")
print(myURL1.getcode()) # 200
try:
myURL2 = urllib.request.urlopen("https://www.example.com/no.html")
except urllib.error.HTTPError as e:
if e.code == 404:
print(404) # 404
urllib.parse
urllib.parse se utiliza para analizar (parsear) URL, el formato es el siguiente:
urllib.parse.urlparse(urlstring, scheme='', allow_fragments=True)
urlstring es la dirección url en forma de cadena, scheme es el tipo de protocolo,
Si el parámetro allow_fragments es false, no se pueden reconocer los identificadores de fragmento. Por el contrario, se analizan como parte de la ruta, parámetros o componentes de consulta, y fragment se establece como una cadena vacía en el valor de retorno.
Ejemplo
o = urlparse("https://www.example.com/?s=python+%E6%95%99%E7%A8%8B")
print(o)
El resultado de salida del ejemplo anterior es:
ParseResult(scheme='https', netloc='www.example.com', path='/', params='', query='s=python+%E6%95%99%E7%A8%8B', fragment='')
Del resultado se puede ver que el contenido es una tupla que contiene 6 cadenas: protocolo, ubicación, ruta, parámetros, consulta y fragmento.
Podemos leer directamente el contenido del protocolo:
Ejemplo
o = urlparse("https://www.example.com/?s=python+%E6%95%99%E7%A8%8B")
print(o.scheme)
El resultado de salida del ejemplo anterior es:
https
El contenido completo es el siguiente:
Atributo |
Índice |
Valor |
Valor (si no existe) |
|---|---|---|---|
|
0 |
Protocolo de URL |
schemeParámetros |
|
1 |
Parte de ubicación de red |
Cadena vacía |
|
2 |
Ruta jerárquica |
Cadena vacía |
|
3 |
Parámetros del último elemento de ruta |
Cadena vacía |
|
4 |
Componente de consulta |
Cadena vacía |
|
5 |
Identificador de fragmento |
Cadena vacía |
|
Nombre de usuario |
|
|
|
Contraseña |
|
|
|
Nombre de host (en minúsculas) |
|
|
|
Número de puerto como entero (si existe) |
|
urllib.robotparser
urllib.robotparser se utiliza para analizar archivos robots.txt.
robots.txt (siempre en minúsculas) es un protocolo de robots ubicado en el directorio raíz del sitio web. Generalmente se usa para indicar a los motores de búsqueda las reglas de rastreo del sitio web.
urllib.robotparser proporciona la clase RobotFileParser, la sintaxis es la siguiente:
class urllib.robotparser.RobotFileParser(url='')
Esta clase proporciona algunos métodos para leer y analizar archivos robots.txt:
-
set_url(url) - Establece la URL del archivo robots.txt.
-
read() - Lee la URL de robots.txt y la introduce en el analizador.
-
parse(lines) - Analiza el parámetro de líneas.
-
can_fetch(useragent, url) - Devuelve True si se permite que el useragent obtenga la url según las reglas del archivo robots.txt analizado.
-
mtime() - Devuelve la hora de la última obtención del archivo robots.txt. Esto es útil para rastreadores web de larga duración que necesitan comprobar periódicamente las actualizaciones del archivo robots.txt.
-
modified() - Establece la hora de la última obtención del archivo robots.txt a la hora actual.
-
crawl_delay(useragent) - Devuelve el parámetro Crawl-delay del robots.txt para el useragent especificado. Si este parámetro no existe o no es aplicable al useragent especificado, o si la entrada de robots.txt para este parámetro tiene un error de sintaxis, devuelve None.
-
request_rate(useragent) - Devuelve el contenido del parámetro Request-rate del robots.txt en forma de named tuple RequestRate(requests, seconds). Si este parámetro no existe o no es aplicable al useragent especificado, o si la entrada de robots.txt para este parámetro tiene un error de sintaxis, devuelve None.
-
site_maps() - Devuelve el contenido del parámetro Sitemap del robots.txt en forma de list(). Si este parámetro no existe o si la entrada de robots.txt para este parámetro tiene un error de sintaxis, devuelve None.
Ejemplo
>>> rp = urllib.robotparser.RobotFileParser()
>>> rp.set_url("http://www.musi-cal.com/robots.txt")
>>> rp.read()
>>> rrate = rp.request_rate("*")
>>> rrate.requests
3
>>> rrate.seconds
20
>>> rp.crawl_delay("*")
6
>>> rp.can_fetch("*", "http://www.musi-cal.com/cgi-bin/search?city=San+Francisco")
False
>>> rp.can_fetch("*", "http://www.musi-cal.com/")
True