Python urllib
Библиотека Python urllib используется для работы с веб-URL и извлечения веб-содержимого.
В этой статье в основном рассказывается об urllib в Python3.
Пакет urllib содержит следующие модули:
- urllib.request- Открытие и чтение URL.
- urllib.error- Содержит исключения, вызываемые urllib.request.
- urllib.parse- Разбор URL.
- urllib.robotparser- Разбор файлов robots.txt.

urllib.request
urllib.request определяет некоторые функции и классы для открытия URL, включая проверку авторизации, перенаправления, cookies браузера и т.д.
urllib.request может имитировать процесс инициирования запроса браузером.
Мы можем использовать метод urlopen из urllib.request для открытия URL, синтаксис следующий:
urllib.request.urlopen(url, data=None, [timeout, ]*, cafile=None, capath=None, cadefault=False, context=None)
- url: адрес URL.
- data: Другие объекты данных, отправляемые на сервер, по умолчанию — None.
- timeout: Задаёт тайм-аут доступа.
- cafile и capath: cafile — это сертификат CA, capath — путь к сертификату CA, требуется для HTTPS.
- cadefault: Устарело.
- context: тип ssl.SSLContext, используется для указания настроек SSL.
Пример выглядит следующим образом:
Пример
myURL = urlopen("https://www.example.com/")
print(myURL.read())
Приведённый выше код использует urlopen для открытия URL, затем использует функцию read() для получения исходного кода HTML веб-страницы.
read() читает всё содержимое веб-страницы; мы можем указать длину для чтения:
Пример
myURL = urlopen("https://www.example.com/")
print(myURL.read(300))
В дополнение к функции read() он также включает следующие две функции для чтения содержимого веб-страницы:
-
readline()— прочитать одну строку файла
from urllib.request import urlopen myURL = urlopen("https://www.example.com/") print(myURL.readline()) #读取一行内容 -
readlines()— прочитать всё содержимое файла; считанное содержимое присваивается переменной-списку.
from urllib.request import urlopen

myURL = urlopen("https://www.example.com/")
lines = myURL.readlines()
for line in lines:
    print(line)
При парсинге веб-страниц нам часто нужно определить, доступна ли веб-страница нормально. Здесь можно использовать функцию getcode() для получения кода состояния веб-страницы. Возврат 200 означает, что веб-страница в норме, возврат 404 означает, что веб-страница не существует:
Пример
myURL1 = urllib.request.urlopen("https://www.example.com/")
print(myURL1.getcode()) # 200
try:
myURL2 = urllib.request.urlopen("https://www.example.com/no.html")
except urllib.error.HTTPError as e:
if e.code == 404:
print(404) # 404
Дополнительные коды состояния веб-страниц см. здесь:https://www.example.com/http/http-status-codes.html。
Если вы хотите сохранить спарсенную веб-страницу локально, вы можете использоватьметод write() для файлов Python3как функцию:
Пример
myURL = urlopen("https://www.example.com/")
f = open("example_urllib_test.html", "wb")
content = myURL.read() # Прочитать содержимое веб-страницы
f.write(content)
f.close()
После выполнения приведённого выше кода локально будет создан файл example_urllib_test.html, содержащий содержимое веб-страницы https://www.example.com/.
Дополнительную информацию об обработке файлов в Python см. здесь:https://www.example.com/python3/python3-file-methods.html
。Для кодирования и декодирования URL можно использоватьurllib.request.quote()иurllib.request.unquote()методы:
Пример
encode_url = urllib.request.quote("https://www.example.com/") # Кодирование
print(encode_url)
unencode_url = urllib.request.unquote(encode_url) # Декодирование
print(unencode_url)
Результат вывода:
https%3A//www.example.com/
https://www.example.com/
Имитация заголовков
При парсинге веб-страниц обычно требуется имитировать заголовки (информацию заголовков веб-страницы). В этом случае нам нужно использовать класс urllib.request.Request:
class urllib.request.Request(url, data=None, headers={}, origin_req_host=None, unverifiable=False, method=None)
- url: адрес URL.
- data: Другие объекты данных, отправляемые на сервер, по умолчанию — None.
- headers: информация заголовков HTTP-запроса, в формате словаря.
- origin_req_host: адрес хоста запроса, IP или доменное имя.
- unverifiable: Этот параметр используется редко. Он задаёт, требует ли веб-страница проверки. По умолчанию — False.
- method: Метод запроса, например GET, POST, DELETE, PUT и т. д.
Пример — код файла py3_urllib_test.py
import urllib.parse
url = 'https://www.example.com/?s=' # Пример страницы поиска Tutorial
keyword = 'Python Tutorial'
key_code = urllib.request.quote(keyword) # Кодировать запрос
url_all = url+key_code
header = {
'User-Agent':'Mozilla/5.0 (X11; Fedora; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36'
} # Информация о заголовке
request = urllib.request.Request(url_all,headers=header)
reponse = urllib.request.urlopen(request).read()
fh = open("./urllib_test_example_search.html","wb") # Записать файл в текущий каталог
fh.write(reponse)
fh.close()
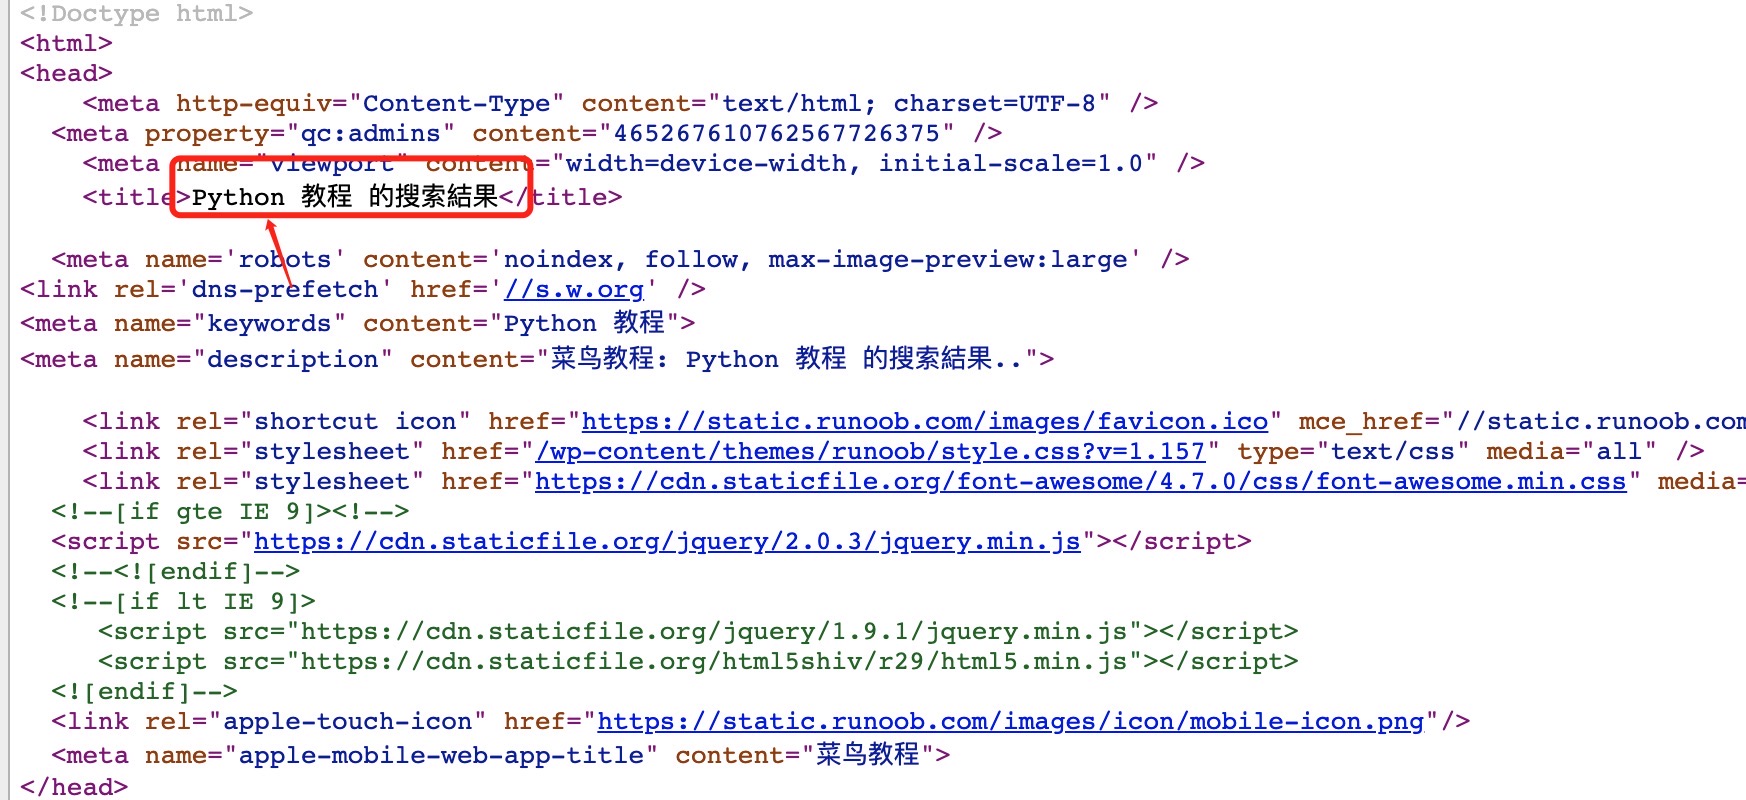
После выполнения приведённого выше Python-кода в текущем каталоге будет создан файл urllib_test_example_search.html. Откройте файл urllib_test_example_search.html (можно открыть в браузере), содержимое будет следующим:
Для передачи данных формы методом POST сначала создадим форму. Код выглядит следующим образом. Здесь я использую PHP-код для получения данных формы:
Пример - код файла py3_urllib_test.php:
<html>
<head>
<meta charset="utf-8">
<title>Пример руководства (example.com) urllib POST Тест</title>
</head>
<body>
<form action="" method="post" name="myForm">
Имя: <input type="text" name="name"><br>
Тег: <input type="text" name="tag"><br>
<input type="submit" value="Отправить">
</форма>
<hr>
<?php
//Используйте PHP для получения данных, отправленных формой; его можно заменить другими языками
if(isset($_POST['name']) && $_POST['tag'] ) {
echo $_POST["name"] . ', ' . $_POST['tag'];
}
?>
</body>
</html>
Пример
import urllib.parse
url = 'https://www.example.com/try/py3/py3_urllib_test.php' # Отправить на страницу формы
data = {'name':'EXAMPLE', 'tag' : 'Rookie Tutorial'} # Отправить данные
header = {
'User-Agent':'Mozilla/5.0 (X11; Fedora; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36'
} # Информация о заголовке
data = urllib.parse.urlencode(data).encode('utf8') # Закодируйте параметры, для декодирования используйте urllib.parse.urldecode
request=urllib.request.Request(url, data, header) # Обработка запроса
reponse=urllib.request.urlopen(request).read() # Чтение результата
fh = open("./urllib_test_post_example.html","wb") # Записать файл в текущий каталог
fh.write(reponse)
fh.close()
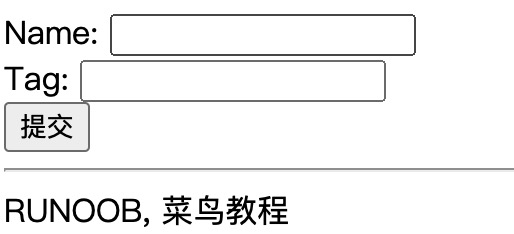
Выполнение приведённого выше кода отправит данные формы в файл py3_urllib_test.php и запишет результат вывода в файл urllib_test_post_example.html.
Откройте файл urllib_test_post_example.html (его можно открыть в браузере), отображаемый результат выглядит следующим образом:
urllib.error
Модуль urllib.error определяет классы исключений для исключений, возбуждаемых urllib.request, а базовым классом исключений является URLError.
urllib.error содержит два класса исключений: URLError и HTTPError.
URLError — подкласс OSError, используемый для обработки исключений (или производных исключений), которые программа возбуждает при возникновении проблем. Содержащийся в нём атрибут reason — это причина исключения.
HTTPError — подкласс URLError, используемый для обработки особых ошибок HTTP, таких как запросы аутентификации. Содержащиеся в нём атрибуты:codecode: код состояния HTTP,reasonreason: причина исключения,headersheaders: заголовки HTTP-ответа конкретного HTTP-запроса, вызвавшего HTTPError.
Собрать данные с несуществующей веб-страницы и обработать исключения:
Пример
import urllib.error
myURL1 = urllib.request.urlopen("https://www.example.com/")
print(myURL1.getcode()) # 200
try:
myURL2 = urllib.request.urlopen("https://www.example.com/no.html")
except urllib.error.HTTPError as e:
if e.code == 404:
print(404) # 404
urllib.parse
urllib.parse используется для разбора URL-адресов, формат следующий:
urllib.parse.urlparse(urlstring, scheme='', allow_fragments=True)
urlstring — это строковый URL-адрес, scheme — тип протокола,
Если параметр allow_fragments имеет значение false, идентификаторы фрагментов не могут быть распознаны. Вместо этого они разбираются как часть компонентов пути, параметров или запроса, а фрагмент устанавливается в пустую строку в возвращаемом значении.
Пример
o = urlparse("https://www.example.com/?s=python+%E6%95%99%E7%A8%8B")
print(o)
Результат вывода приведённого выше примера:
ParseResult(scheme='https', netloc='www.example.com', path='/', params='', query='s=python+%E6%95%99%E7%A8%8B', fragment='')
Из результата видно, что содержимое представляет собой кортеж из 6 строк: протокол, местоположение, путь, параметры, запрос и фрагмент.
Мы можем напрямую прочитать содержимое протокола:
Пример
o = urlparse("https://www.example.com/?s=python+%E6%95%99%E7%A8%8B")
print(o.scheme)
Результат вывода приведённого выше примера:
https
Полное содержимое выглядит следующим образом:
Attribute |
Index |
Значение |
Значение (если отсутствует) |
|---|---|---|---|
|
0 |
Протокол URL |
схемаПараметры |
|
1 |
Сетевая часть расположения |
Пустая строка |
|
2 |
Иерархический путь |
Пустая строка |
|
3 |
Параметры последнего элемента пути |
Пустая строка |
|
4 |
Компонент запроса |
Пустая строка |
|
5 |
Идентификатор фрагмента |
Пустая строка |
|
Имя пользователя |
|
|
|
Password |
|
|
|
Имя хоста (в нижнем регистре) |
|
|
|
Номер порта в виде целого числа (если присутствует) |
|
urllib.robotparser
urllib.robotparser используется для разбора файлов robots.txt.
robots.txt (все строчные буквы) — это протокол robots, хранящийся в корневом каталоге веб-сайта. Обычно он используется, чтобы сообщить поисковым системам правила сканирования сайта.
urllib.robotparser предоставляет класс RobotFileParser, синтаксис следующий:
class urllib.robotparser.RobotFileParser(url='')
Этот класс предоставляет методы для чтения и разбора файлов robots.txt:
-
set_url(url) — задает URL файла robots.txt.
-
read() — читает URL robots.txt и передает его парсеру.
-
parse(lines) — разбирает параметр lines.
-
can_fetch(useragent, url) — возвращает True, если useragent разрешено загружать url в соответствии с правилами в разобранном файле robots.txt.
-
mtime() — возвращает время последней загрузки файла robots.txt. Это полезно для длительно работающих веб-краулеров, которым нужно периодически проверять обновления robots.txt.
-
modified() — устанавливает время последней загрузки файла robots.txt равным текущему времени.
-
crawl_delay(useragent) — возвращает параметр Crawl-delay из robots.txt для указанного useragent. Возвращает None, если этот параметр не существует, не применяется к указанному useragent или если запись этого параметра в robots.txt содержит синтаксическую ошибку.
-
request_rate(useragent) — возвращает содержимое параметра Request-rate из robots.txt как именованный кортеж RequestRate(requests, seconds). Возвращает None, если этот параметр не существует, не применяется к указанному useragent или если запись этого параметра в robots.txt содержит синтаксическую ошибку.
-
site_maps() — возвращает содержимое параметра Sitemap из robots.txt в виде list(). Возвращает None, если этот параметр не существует или если запись этого параметра в robots.txt содержит синтаксическую ошибку.
Пример
>>> rp = urllib.robotparser.RobotFileParser()
>>> rp.set_url("http://www.musi-cal.com/robots.txt")
>>> rp.read()
>>> rrate = rp.request_rate("*")
>>> rrate.requests
3
>>> rrate.seconds
20
>>> rp.crawl_delay("*")
6
>>> rp.can_fetch("*", "http://www.musi-cal.com/cgi-bin/search?city=San+Francisco")
False
>>> rp.can_fetch("*", "http://www.musi-cal.com/")
True