Python urllib
Python urllib ライブラリは、WebページのURLを操作し、Webページのコンテンツをスクレイピング処理するために使用されます。
この記事では主に Python3 の urllib を紹介します。
urllib パッケージには、次のモジュールが含まれています:
- urllib.request- URL を開いて読み取ります。
- urllib.error- urllib.request がスローする例外を含みます。
- urllib.parse- URL を解析します。
- urllib.robotparser- robots.txt ファイルを解析します。

urllib.request
urllib.request は、URL を開くためのいくつかの関数とクラスを定義しており、認証、リダイレクト、ブラウザの Cookie などを含みます。
urllib.request は、ブラウザのリクエスト送信プロセスをシミュレートできます。
urllib.request の urlopen メソッドを使用して URL を開くことができます。構文は次のとおりです:
urllib.request.urlopen(url, data=None, [timeout, ]*, cafile=None, capath=None, cadefault=False, context=None)
- url:url アドレス。
- data:サーバーに送信される他のデータオブジェクト。デフォルトは None です。
- timeout:アクセスのタイムアウト時間を設定します。
- cafile と capath:cafile は CA 証明書、capath は CA 証明書のパスであり、HTTPS を使用する場合に必要です。
- cadefault:すでに非推奨です。
- context:ssl.SSLContext 型で、SSL 設定を指定するために使用します。
実例は次のとおりです:
実例
myURL = urlopen("https://www.example.com/")
print(myURL.read())
上記のコードは、urlopen を使用して URL を開き、次に read() 関数を使用して Webページの HTML ソースコードを取得します。
read() は Webページ全体のコンテンツを読み取ります。読み取る長さを指定することもできます:
実例
myURL = urlopen("https://www.example.com/")
print(myURL.read(300))
read() 関数の他に、Webページのコンテンツを読み取るための次の2つの関数も含まれています:
-
readline()- ファイルの1行のコンテンツを読み取ります
from urllib.request import urlopen myURL = urlopen("https://www.example.com/") print(myURL.readline()) #读取一行内容 -
readlines()- ファイルの全コンテンツを読み取り、読み取ったコンテンツをリスト変数に代入します。
from urllib.request import urlopen

myURL = urlopen("https://www.example.com/")
lines = myURL.readlines()
for line in lines:
    print(line)
Webページをスクレイピングする際、Webページに正常にアクセスできるかどうかを判断する必要がよくあります。ここでは、getcode() 関数を使用して Webページのステータスコードを取得できます。200 が返された場合は Webページが正常であることを意味し、404 が返された場合は Webページが存在しないことを意味します:
実例
myURL1 = urllib.request.urlopen("https://www.example.com/")
print(myURL1.getcode()) # 200
try:
myURL2 = urllib.request.urlopen("https://www.example.com/no.html")
except urllib.error.HTTPError as e:
if e.code == 404:
print(404) # 404
その他の Webページのステータスコードについては、次を参照してください:https://www.example.com/http/http-status-codes.html。
スクレイピングした Webページをローカルに保存する場合は、次を使用できます:Python3 File write() メソッド関数:
実例
myURL = urlopen("https://www.example.com/")
f = open("サンプル_urllib_test.html", "wb")
content = myURL.read() # Webページのコンテンツを読み取る
f.write(content)
f.close()
上記のコードを実行すると、ローカルに サンプル_urllib_test.html ファイルが生成され、その中に https://www.example.com/ の Webページのコンテンツが含まれます。
Python File 処理の詳細については、次を参照してください:https://www.example.com/python3/python3-file-methods.html
。URL のエンコードとデコードには、次を使用できます:urllib.request.quote()とurllib.request.unquote()メソッド:
実例
encode_url = urllib.request.quote("https://www.example.com/") # エンコード
print(encode_url)
unencode_url = urllib.request.unquote(encode_url) # デコード
print(unencode_url)
出力結果は次のとおりです:
https%3A//www.example.com/
https://www.example.com/
ヘッダー情報のシミュレーション
Webページをスクレイピングする際、通常は headers(Webページのヘッダー情報)をシミュレートする必要があります。この場合、urllib.request.Request クラスを使用する必要があります:
class urllib.request.Request(url, data=None, headers={}, origin_req_host=None, unverifiable=False, method=None)
- url:url アドレス。
- data:サーバーに送信される他のデータオブジェクト。デフォルトは None です。
- headers:HTTP リクエストのヘッダー情報。辞書形式です。
- origin_req_host:リクエストのホストアドレス。IP またはドメイン名。
- unverifiable:このパラメータはほとんど使用されません。Webページの検証が必要かどうかを設定するために使用され、デフォルトは False です。
- method:リクエストメソッド。例:GET、POST、DELETE、PUT など。
実例 - py3_urllib_test.py ファイルコード
import urllib.parse
url = 'https://www.example.com/?s=' # サンプル 検索ページ
keyword = 'Python チュートリアル'
key_code = urllib.request.quote(keyword) # リクエストをエンコードする
url_all = url+key_code
header = {
'User-Agent':'Mozilla/5.0 (X11; Fedora; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36'
} #ヘッダー情報
request = urllib.request.Request(url_all,headers=header)
reponse = urllib.request.urlopen(request).read()
fh = open("./urllib_test_サンプル_search.html","wb") # ファイルを現在のディレクトリに書き込む
fh.write(reponse)
fh.close()
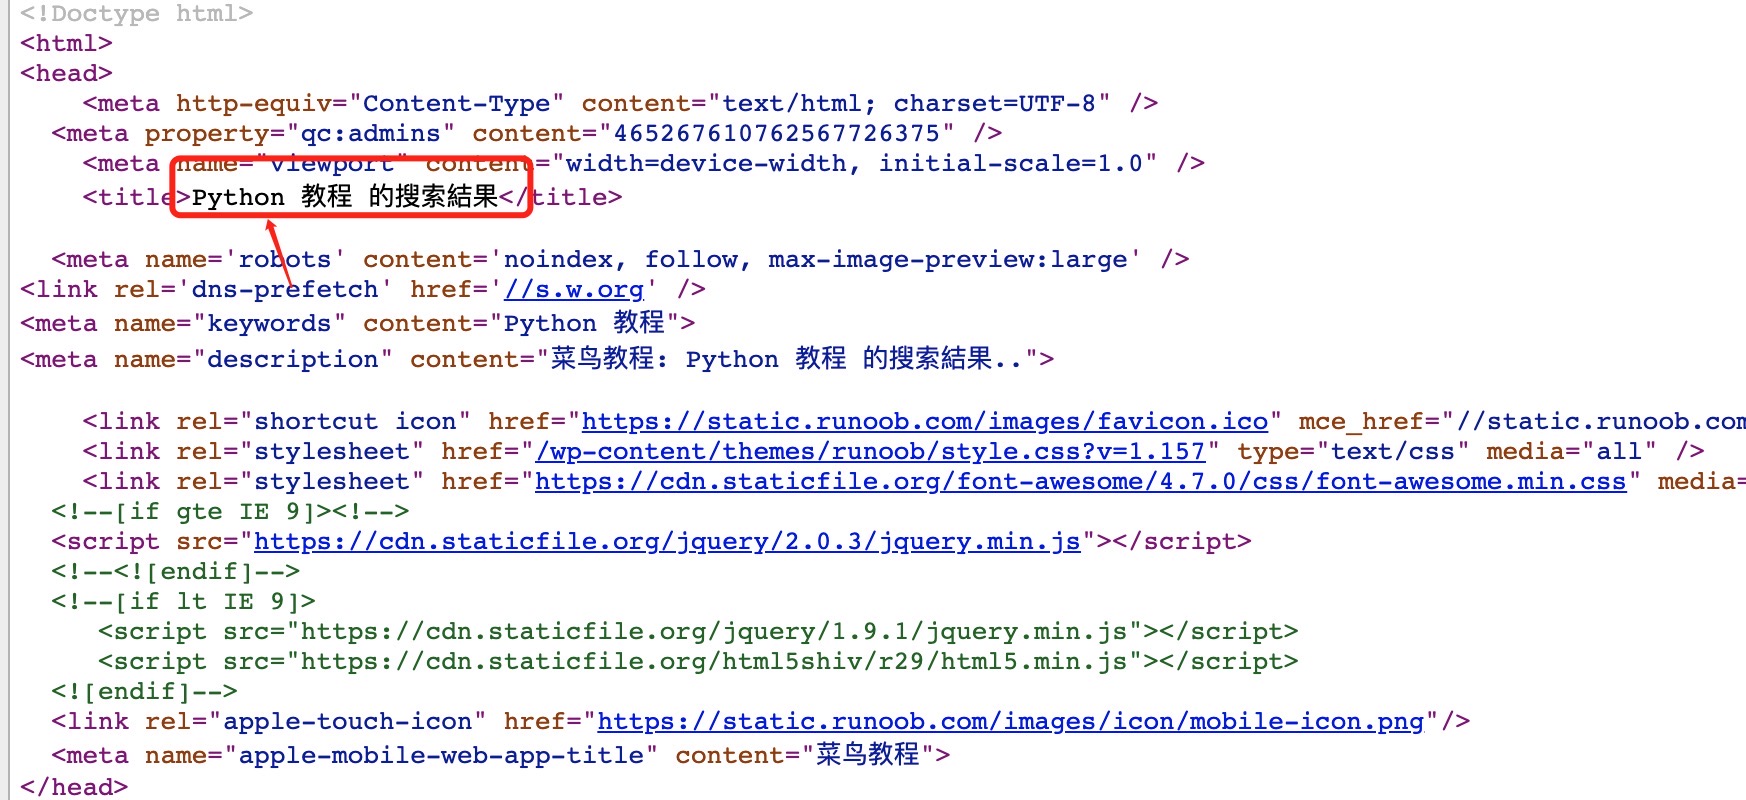
上記の Python コードを実行すると、現在のディレクトリに urllib_test_サンプル_search.html ファイルが生成されます。urllib_test_サンプル_search.html ファイルを開くと(ブラウザで開くことができます)、内容は次のとおりです:
フォームの POST データ転送では、まずフォームを作成します。コードは次のとおりです。ここでは PHP コードを使用してフォームのデータを取得しています:
実例 - py3_urllib_test.php ファイルコード:
<html>
<head>
<meta charset="utf-8">
<title>サンプル(example.com) urllib POST テスト</title>
</head>
<body>
<form action="" method="post" name="myForm">
Name: <input type="text" name="name"><br>
Tag: <input type="text" name="tag"><br>
<input type="submit" value='送信'>
</form>
<hr>
<?php
//PHP を使用してフォームから送信されたデータを取得します。他のものに置き換えることもできます。
if(isset($_POST['name']) && $_POST['tag'] ) {
echo $_POST["name"] . ', ' . $_POST['tag'];
}
?>
</body>
</html>
実例
import urllib.parse
url = 'https://www.example.com/try/py3/py3_urllib_test.php' # フォームページに送信
data = {'name':'サンプル', 'tag' : 'サンプル'} # データを送信
header = {
'User-Agent':'Mozilla/5.0 (X11; Fedora; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36'
} #ヘッダー情報
data = urllib.parse.urlencode(data).encode('utf8') # パラメータをエンコードします。デコードには urllib.parse.urldecode を使用します
request=urllib.request.Request(url, data, header) # リクエスト処理
reponse=urllib.request.urlopen(request).read() # 結果を読み取る
fh = open("./urllib_test_post_サンプル.html","wb") # ファイルを現在のディレクトリに書き込む
fh.write(reponse)
fh.close()
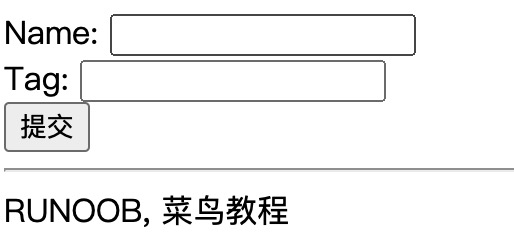
上記のコードを実行すると、フォームデータが py3_urllib_test.php ファイルに送信され、出力結果が urllib_test_post_サンプル.html ファイルに書き込まれます。
urllib_test_post_サンプル.html ファイルを開くと(ブラウザで開くことができます)、表示結果は次のとおりです:
urllib.error
urllib.error モジュールは、urllib.request によって発生する例外に対して例外クラスを定義しています。基本例外クラスは URLError です。
urllib.error には、URLError と HTTPError という2つの例外クラスが含まれています。
URLError は OSError のサブクラスであり、プログラムが問題に遭遇したときにこの例外(またはその派生例外)を発生させるために使用されます。含まれる属性 reason は例外が発生した原因です。
HTTPError は URLError のサブクラスであり、認証リクエストなどの特別な HTTP エラーを処理するために使用されます。含まれる属性は、codeHTTP ステータスコード、reason例外が発生した原因、headersHTTPError を引き起こした特定の HTTP リクエストの HTTP レスポンスヘッダーです。
存在しない Webページをスクレイピングし、例外を処理します:
実例
import urllib.error
myURL1 = urllib.request.urlopen("https://www.example.com/")
print(myURL1.getcode()) # 200
try:
myURL2 = urllib.request.urlopen("https://www.example.com/no.html")
except urllib.error.HTTPError as e:
if e.code == 404:
print(404) # 404
urllib.parse
urllib.parse は URL を解析するために使用されます。形式は次のとおりです:
urllib.parse.urlparse(urlstring, scheme='', allow_fragments=True)
urlstring は文字列の URL アドレス、scheme はプロトコルタイプです。
allow_fragments パラメータが false の場合、フラグメント識別子は認識されません。代わりに、それらはパス、パラメータ、またはクエリコンポーネントの一部として解析され、戻り値の fragment は空文字列に設定されます。
実例
o = urlparse("https://www.example.com/?s=python+%E6%95%99%E7%A8%8B")
print(o)
上記の実例の出力結果は次のとおりです:
ParseResult(scheme='https', netloc='www.example.com', path='/', params='', query='s=python+%E6%95%99%E7%A8%8B', fragment='')
結果からわかるように、内容はタプルであり、プロトコル、ネットワーク位置、パス、パラメータ、クエリ、フラグメントの6つの文字列が含まれています。
プロトコルの内容を直接読み取ることができます:
実例
o = urlparse("https://www.example.com/?s=python+%E6%95%99%E7%A8%8B")
print(o.scheme)
上記の実例の出力結果は次のとおりです:
https
完全な内容は次のとおりです:
属性 |
インデックス |
值 |
値(存在しない場合) |
|---|---|---|---|
|
0 |
URLプロトコル |
schemeパラメータ |
|
1 |
ネットワーク位置部分 |
空文字列 |
|
2 |
階層パス |
空文字列 |
|
3 |
最後のパス要素のパラメータ |
空文字列 |
|
4 |
クエリコンポーネント |
空文字列 |
|
5 |
フラグメント識別子 |
空文字列 |
|
ユーザー名 |
|
|
|
パスワード |
|
|
|
ホスト名(小文字) |
|
|
|
ポート番号は整数です(存在する場合) |
|
urllib.robotparser
urllib.robotparser は robots.txt ファイルを解析するために使用されます。
robots.txt(統一して小文字)は、Webサイトのルートディレクトリに置かれる robots プロトコルであり、通常は検索エンジンにWebサイトのクロールルールを知らせるために使用されます。
urllib.robotparser は RobotFileParser クラスを提供します。構文は次のとおりです:
class urllib.robotparser.RobotFileParser(url='')
このクラスは、robots.txt ファイルを読み取り、解析できるいくつかのメソッドを提供します:
-
set_url(url) - robots.txt ファイルの URL を設定します。
-
read() - robots.txt の URL を読み取り、パーサーに入力します。
-
parse(lines) - lines 引数を解析します。
-
can_fetch(useragent, url) - 解析された robots.txt ファイル内のルールに従って useragent が url を取得することを許可されている場合は True を返します。
-
mtime() - robots.txt ファイルを最後に取得した時刻を返します。これは、robots.txt ファイルの更新状況を定期的に確認する必要がある長時間実行されるウェブクローラーに適しています。
-
modified() - robots.txt ファイルを最後に取得した時刻を現在の時刻に設定します。
-
crawl_delay(useragent) - 指定された useragent に対して robots.txt から Crawl-delay パラメータを返します。このパラメータが存在しない場合、指定された useragent に適用されない場合、またはこのパラメータの robots.txt エントリに構文エラーがある場合は、None を返します。
-
request_rate(useragent) - robots.txt から Request-rate パラメータの内容を named tuple RequestRate(requests, seconds) の形式で返します。このパラメータが存在しない場合、指定された useragent に適用されない場合、またはこのパラメータの robots.txt エントリに構文エラーがある場合は、None を返します。
-
site_maps() - robots.txt から Sitemap パラメータの内容を list() の形式で返します。このパラメータが存在しない場合、またはこのパラメータの robots.txt エントリに構文エラーがある場合は、None を返します。
実例
>>> rp = urllib.robotparser.RobotFileParser()
>>> rp.set_url("http://www.musi-cal.com/robots.txt")
>>> rp.read()
>>> rrate = rp.request_rate("*")
>>> rrate.requests
3
>>> rrate.seconds
20
>>> rp.crawl_delay("*")
6
>>> rp.can_fetch("*", "http://www.musi-cal.com/cgi-bin/search?city=San+Francisco")
False
>>> rp.can_fetch("*", "http://www.musi-cal.com/")
True