Python3 Strings
Strings sind der am häufigsten verwendete Datentyp in Python. Wir können Anführungszeichen ('oder") verwenden, um Strings zu erstellen.
Das Erstellen eines Strings ist einfach; weisen Sie einfach einer Variablen einen Wert zu. Zum Beispiel:
Python Zugriff auf Werte in Zeichenketten
Python unterstützt keinen Einzelzeichen-Typ; ein einzelnes Zeichen wird in Python auch als Zeichenkette verwendet.
Python greift mit eckigen Klammern auf Teilzeichenketten zu[], um Zeichenketten zu extrahieren. Die Syntax für das Slicing von Zeichenketten lautet wie folgt:
variable[start index:end index]
Indexwerte beginnen mit0als Startwert,-1ist die Startposition vom Ende.

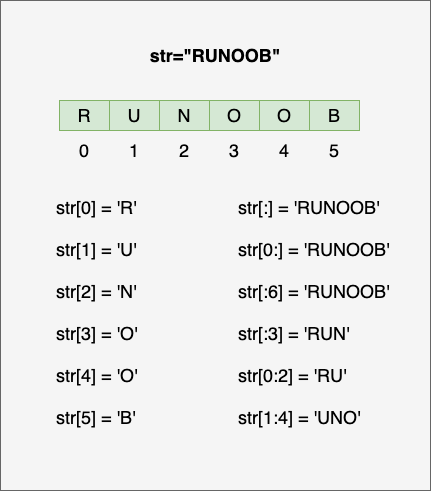
Wie im folgenden Beispiel:
Beispiele (Python 3.0+)
Das Ausführungsergebnis des obigen Beispiels ist:
var1[0]:  H
var2[1:5]:  unoo
Python-Zeichenketten-Aktualisierung
Sie können einen Teil einer Zeichenkette herausnehmen und ihn mit anderen Feldern verketten, wie im folgenden Beispiel:
Beispiele (Python 3.0+)
Das Ausführungsergebnis des obigen Beispiels ist:
已更新字符串 : Hello Example!
Python-Escape-Zeichen
Wenn in Zeichen Sonderzeichen benötigt werden, verwendet Python Backslash\Escape-Zeichen. Wie in der folgenden Tabelle:
| Escape-Zeichen | Beschreibung | Beispiel |
|---|---|---|
| \ (am Ende der Zeile) | Zeilenfortsetzung |
>>> print("line1 \
... line2 \
... line3")
line1 line2 line3
>>>
|
| \\ | Backslash-Symbol |
>>> print("\\")
\
|
| \' | Einfaches Anführungszeichen |
>>> print('\'')
'
|
| \" | Doppeltes Anführungszeichen |
>>> print("\"")
"
|
| \a | Glocke |
>>> print("\a")Der Computer gibt nach der Ausführung einen Ton aus. |
| \b | Rücktaste |
>>> print("Hello \b World!")
Hello World!
|
| \000 | Leer |
>>> print("\000")

>>>
|
| \n | Zeilenumbruch |
>>> print("\n")


>>>
|
| \v | Vertikaltabulator |
>>> print("Hello \v World!")
Hello
       World!
>>>
|
| \t | Horizontaler Tabulator |
>>> print("Hello \t World!")
Hello      World!
>>>
|
| \r | Wagenrücklauf: verschiebt\rden Inhalt danach an den Anfang der Zeichenkette und ersetzt die Zeichen am Anfang nacheinander, bis der\rInhalt danach vollständig ersetzt ist. |
>>> print("Hello\rWorld!")
World!
>>> print('google example taobao\r123456')
123456 example taobao
|
| \f | Seitenvorschub |
>>> print("Hello \f World!")
Hello
       World!
>>>
|
| \yyy | Oktalzahl, y steht für Zeichen von 0 bis 7, zum Beispiel: \012 steht für einen Zeilenumbruch. |
>>> print("\110\145\154\154\157\40\127\157\162\154\144\41")
Hello World!
|
| \xyy | Hexadezimalzahl, beginnt mit \x, y steht für ein Zeichen, zum Beispiel: \x0a steht für einen Zeilenumbruch. |
>>> print("\x48\x65\x6c\x6c\x6f\x20\x57\x6f\x72\x6c\x64\x21")
Hello World!
|
| \other | Andere Zeichen werden im normalen Format ausgegeben. |
Verwenden Sie\r , um den prozentualen Fortschritt umzusetzen:
Beispiele
for i in range(101): # Grafik für Fortschrittsbalken und Prozentangabe hinzufügen
bar = '[' + '=' * (i // 2) + ' ' * (50 - i // 2) + ']'
print(f"\r{bar} {i:3}%", end='', flush=True)
time.sleep(0.05)
print()
Im folgenden Beispiel haben wir verschiedene Escape-Zeichen verwendet, um die Auswirkungen von einfachen Anführungszeichen, Zeilenumbruch, Tabulator, Rücktaste, Seitenvorschub, ASCII, Binär-, Oktal- und Hexadezimalzahlen zu demonstrieren:
Beispiele
print("Hello, world!\nHow are you?") # Ausgabe: Hello, world!
# Wie geht es dir?
print("Hallo, Welt!\tWie geht es dir?") # Ausgabe: Hallo, Welt! Wie geht es dir?
print("Hallo,\b Welt!") # Ausgabe: Hallo Welt!
print("Hallo,\f Welt!") # Ausgabe:
# Hallo,
# Welt!
print("Der ASCII-Wert von A ist:", ord('A')) # Ausgabe: Der ASCII-Wert von A ist: 65
print("\x41 ist der ASCII-Code von A) # Ausgabe: A ist der ASCII-Code von A
decimal_number = 42
binary_number = bin(decimal_number) # Dezimal in Binär umwandeln
print('In Binär umgewandelt:', binary_number) # In Binär umgewandelt: 0b101010
octal_number = oct(decimal_number) # Dezimal in Oktal umwandeln
print('In Oktal umgewandelt:', octal_number) # In Oktal umgewandelt: 0o52
hexadecimal_number = hex(decimal_number) # Dezimal in Hexadezimal umwandeln
print('In Hexadezimal umgewandelt:', hexadecimal_number) # In Hexadezimal umgewandelt: 0x2a
Python-String-Operatoren
In der folgenden Tabelle hat die Variable a in den Beispielen den String-Wert "Hello", und die Variable b hat den Wert "Python":
| Operator | Beschreibung | Beispiel |
|---|---|---|
| + | String-Verkettung | a + b Ausgabe: HelloPython |
| * | Zeichenkette wiederholt ausgeben | a*2 Ausgabe: HelloHello |
| [] | Zeichen in einer Zeichenkette über den Index abrufen | ae |
| [ : ] | Einen Teil einer Zeichenkette abschneiden, nach derlinks geschlossen und rechts offenRegel; str[0:2] enthält nicht das dritte Zeichen. | a[1:4] Ausgabeell |
| in | Mitgliedschaftsoperator - gibt True zurück, wenn die Zeichenkette das angegebene Zeichen enthält | 'H' in aAusgabeergebnis True |
| not in | Mitgliedschaftsoperator - gibt True zurück, wenn die Zeichenkette das angegebene Zeichen nicht enthält | 'M' not in aAusgabeergebnis True |
| r/R | Raw-String - Raw-Strings: Alle Zeichenketten werden direkt nach ihrer wörtlichen Bedeutung verwendet, ohne Sonderzeichen oder nicht druckbare Zeichen zu escapen. Raw-Strings haben fast die gleiche Syntax wie gewöhnliche Zeichenketten, außer dass der Buchstaber(Groß-/Kleinschreibung wird nicht unterschieden) vor das erste Anführungszeichen der Zeichenkette gesetzt wird. | print( r'\n' ) print( R'\n' ) |
| % | Formatzeichenkette | Siehe nächsten Abschnitt. |
Beispiele (Python 3.0+)
Das Ausgabeergebnis des obigen Beispiels ist:
a + b 输出结果: HelloPython
a * 2 输出结果: HelloHello
a[1] 输出结果: e
a[1:4] 输出结果: ell
H 在变量 a 中
M 不在变量 a 中
\n
\n
Python-String-Formatierung
Python unterstützt formatierte String-Ausgabe. Obwohl dies sehr komplexe Ausdrücke umfassen kann, ist die grundlegendste Verwendung das Einfügen eines Werts in einen String mit dem String-Formatbezeichner %s.
In Python verwendet die String-Formatierung dieselbe Syntax wie die Funktion sprintf in C.
Beispiele (Python 3.0+)
Das Ausgabeergebnis des obigen Beispiels ist:
我叫 小明 今年 10 岁!
Symbole für die Python-String-Formatierung:
| Symbol | Beschreibung |
|---|---|
| %c | Formatzeichen und sein ASCII-Code |
| %s | Formatzeichenkette |
| %d | Ganzzahl formatieren |
| %u | Vorzeichenlose Ganzzahl formatieren |
| %o | Vorzeichenlose Oktalzahl formatieren |
| %x | Vorzeichenlose Hexadezimalzahl formatieren |
| %X | Vorzeichenlose Hexadezimalzahl formatieren (Großbuchstaben) |
| %f | Gleitkommazahlen formatieren, Genauigkeit nach dem Dezimalpunkt kann angegeben werden |
| %e | Gleitkommazahlen in wissenschaftlicher Notation formatieren |
| %E | Funktioniert genauso wie %e, formatiert Gleitkommazahlen in wissenschaftlicher Notation |
| %g | Kurzform für %f und %e |
| %G | Kurzschreibweise für %f und %E |
| %p | Variablenadresse mit Hexadezimalzahl formatieren |
Hilfsdirektiven für Formatierungsoperatoren:
| Symbol | Funktion |
|---|---|
| * | Definiert die Breite oder die Genauigkeit nach dem Dezimalpunkt |
| - | Wird für linksbündige Ausrichtung verwendet |
| + | Pluszeichen ( + ) vor positiven Zahlen anzeigen |
| <sp> | Zeigt ein Leerzeichen vor positiven Zahlen an |
| # | '0' vor Oktalzahlen anzeigen und '0x' oder '0X' vor Hexadezimalzahlen (abhängig davon, ob 'x' oder 'X' verwendet wird) |
| 0 | Die angezeigte Zahl mit '0' anstelle des Standard-Leerzeichens auffüllen |
| % | '%%' gibt ein einzelnes '%' aus |
| (var) | Zugeordnete Variable (Dictionary-Argument) |
| m.n. | m ist die minimale Gesamtbreite für die Anzeige, n ist die Anzahl der Ziffern nach dem Dezimalpunkt (falls verfügbar) |
Ab Python 2.6 wurde eine neue Funktion zur Formatierung von Zeichenketten hinzugefügtstr.format(), die die Funktionalität der Zeichenkettenformatierung erweitert.
Dreifache Anführungszeichen in Python
Python-Dreifachanführungszeichen ermöglichen, dass sich eine Zeichenkette über mehrere Zeilen erstreckt; die Zeichenkette kann Zeilenumbrüche, Tabulatoren und andere Sonderzeichen enthalten. Ein Beispiel ist wie folgt:
Beispiele (Python 3.0+)
Die Ausgabe des obigen Beispiels ist:
这是一个多行字符串的实例
多行字符串可以使用制表符
TAB (    ).
也可以使用换行符 [
 ]。
Dreifache Anführungszeichen befreien Programmierer aus dem Sumpf der Anführungszeichen und speziellen Strings und halten einen kleinen Stringblock von Anfang bis Ende in einem sogenannten WYSIWYG-Format (Was du siehst, ist was du bekommst).
Ein typischer Anwendungsfall ist, wenn Sie einen Block aus HTML oder SQL benötigen. Dann wäre die Verwendung von String-Verkettung und speziellem String-Escaping sehr umständlich.
f-string
f-string wurde in Python 3.6 und späteren Versionen hinzugefügt. Er wird als formatiertes String-Literal bezeichnet und ist eine neue Syntax zur Formatierung von Strings.
Bisher waren wir es gewohnt, das Prozentzeichen (%) zu verwenden:
Beispiele
>>> 'Hello %s' % name
'Hello Example'
f-stringDer formatierte String beginnt mitf, gefolgt von dem String. Ausdrücke im String werden in geschweifte Klammern {} gesetzt. Er ersetzt sie durch den berechneten Wert der Variable oder des Ausdrucks. Beispiel:
Beispiele
>>> f'Hello {name}' # Variable ersetzen
'Hello Example'
>>> f'{1+2}' # Ausdruck verwenden
'3'
>>> w = {'name': 'Example', 'url': 'www.example.com'}
>>> f'{w["name"]}: {w["url"]}'
'Example: www.example.com'
Die Verwendung dieser Methode ist eindeutig einfacher; Sie müssen nicht mehr entscheiden, ob Sie %s oder %d verwenden.
In Python 3.8 und später können Sie=das Symbol verwenden, um den Operationsausdruck und sein Ergebnis zu verketten:
Beispiele
>>> print(f'{x+1}') # Python 3.6
2
>>> x = 1
>>> print(f'{x+1=}') # Python 3.8
x+1=2
Unicode-Strings
In Python 2 werden gewöhnliche Strings als 8-Bit-ASCII-Codes gespeichert, während Unicode-Strings als 16-Bit-Unicode-Strings gespeichert werden, die mehr Zeichensätze darstellen können. Die verwendete Syntax besteht darin, ein Präfix vor den String zu setzenu。
In Python 3 sind alle Strings Unicode-Strings.
In Python integrierte String-Funktionen
Die in Python häufig verwendeten integrierten String-Methoden sind wie folgt:
| Nein. | Methode und Beschreibung |
|---|---|
| 1 | capitalize() |
| 2 | Gibt einen zentrierten String mit einer angegebenen Breite zurück. fillchar ist das Füllzeichen, standardmäßig ein Leerzeichen. |
| 3 | count(str, beg= 0,end=len(string)) Gibt die Anzahl der Vorkommen von str in string zurück. Wenn beg oder end angegeben ist, gibt es die Anzahl der Vorkommen von str im angegebenen Bereich zurück. |
| 4 | bytes.decode(encoding="utf-8", errors="strict") In Python 3 gibt es keine decode-Methode, aber wir können die decode()-Methode des bytes-Objekts verwenden, um ein gegebenes bytes-Objekt zu dekodieren. Dieses bytes-Objekt kann durch str.encode() kodiert und zurückgegeben werden. |
| 5 | encode(encoding='UTF-8',errors='strict') Kodiert den String im durch encoding angegebenen Kodierungsformat. Wenn ein Fehler auftritt, wird standardmäßig eine ValueError-Ausnahme ausgelöst, es sei denn, errors ist als 'ignore' oder 'replace' angegeben. |
| 6 | endswith(suffix, beg=0, end=len(string)) |
| 7 | Wandelt Tabulatorzeichen in der Zeichenkette in Leerzeichen um. Die Standardanzahl an Leerzeichen für ein Tabulatorzeichen beträgt 8. |
| 8 | find(str, beg=0, end=len(string)) Ermittelt, ob str in der Zeichenkette enthalten ist. Wenn der Bereich beg und end angegeben ist, wird überprüft, ob sie im angegebenen Bereich enthalten ist. Wenn enthalten, wird der Startindexwert zurückgegeben; andernfalls -1. |
| 9 | index(str, beg=0, end=len(string)) Entspricht der Methode find(), außer dass eine Ausnahme ausgelöst wird, wenn str nicht in der Zeichenkette ist. |
| 10 | Überprüft, ob die Zeichenkette aus Buchstaben und Zahlen besteht, d. h., alle Zeichen in der Zeichenkette sind Buchstaben oder Ziffern. Wenn die Zeichenkette mindestens ein Zeichen enthält und alle Zeichen Buchstaben oder Ziffern sind, wird True zurückgegeben; andernfalls False. |
| 11 | Gibt True zurück, wenn die Zeichenkette mindestens ein Zeichen enthält und alle Zeichen Buchstaben oder chinesische Zeichen sind; andernfalls wird False zurückgegeben. |
| 12 | Gibt True zurück, wenn die Zeichenkette nur Ziffern enthält; andernfalls wird False zurückgegeben. |
| 13 | Gibt True zurück, wenn die Zeichenkette mindestens ein groß-/kleinschreibungssensitives Zeichen enthält und alle diese (groß-/kleinschreibungssensitiven) Zeichen Kleinbuchstaben sind; andernfalls wird False zurückgegeben. |
| 14 | Gibt True zurück, wenn die Zeichenkette nur numerische Zeichen enthält; andernfalls wird False zurückgegeben. |
| 15 | Gibt True zurück, wenn die Zeichenkette nur Leerraum enthält; andernfalls wird False zurückgegeben. |
| 16 | Gibt True zurück, wenn die Zeichenkette in Titel-Schreibweise vorliegt (siehe title()); andernfalls wird False zurückgegeben. |
| 17 | Gibt True zurück, wenn die Zeichenkette mindestens ein Zeichen mit Groß-/Kleinschreibung enthält und alle diese (groß-/kleinschreibungsabhängigen) Zeichen großgeschrieben sind; andernfalls wird False zurückgegeben. |
| 18 | Verwendet die angegebene Zeichenkette als Trennzeichen, um alle Elemente (ihre Zeichenketten-Darstellungen) in seq zu einer neuen Zeichenkette zusammenzufügen. |
| 19 | Gibt die Länge des Strings zurück. |
| 20 | Gibt eine neue Zeichenkette zurück, bei der die ursprüngliche Zeichenkette linksbündig ausgerichtet und mit fillchar auf die Länge width aufgefüllt wird. fillchar ist standardmäßig ein Leerzeichen. |
| 21 | Wandelt alle Großbuchstaben in der Zeichenkette in Kleinbuchstaben um. |
| 22 | Entfernt die Leerzeichen oder angegebenen Zeichen auf der linken Seite der Zeichenkette. |
| 23 | Erstellt eine Konvertierungstabelle für die Zeichenzuordnung. In der einfachsten Aufrufform mit zwei Parametern ist der erste Parameter eine Zeichenkette, die die umzuwandelnden Zeichen darstellt, und der zweite Parameter ist ebenfalls eine Zeichenkette, die das Umwandlungsziel darstellt. |
| 24 | Gibt den größten Buchstaben in der Zeichenkette str zurück. |
| 25 | Gibt den kleinsten Buchstaben in der Zeichenkette str zurück. |
| 26 | Ersetzt old in der Zeichenkette durch new. Wenn max angegeben ist, überschreitet die Ersetzung max nicht. |
| 27 | rfind(str, beg=0,end=len(string)) Ähnlich wie die Funktion find(), sucht aber von rechts. |
| 28 | rindex( str, beg=0, end=len(string)) Ähnlich wie index(), beginnt aber von rechts. |
| 29 | Gibt eine neue Zeichenkette zurück, bei der die ursprüngliche Zeichenkette rechtsbündig ausgerichtet und mit fillchar (Standard: Leerzeichen) auf die Länge width aufgefüllt wird. |
| 30 | Entfernt Leerzeichen oder angegebene Zeichen am Ende der Zeichenkette. |
| 31 | split(str="", num=string.count(str)) Teilt die Zeichenkette unter Verwendung von str als Trennzeichen. Wenn num einen angegebenen Wert hat, werden nur num+1 Teilzeichenketten extrahiert. |
| 32 | Teilt nach Zeilen ('\r', '\r\n', '\n') und gibt eine Liste zurück, die jede Zeile als Element enthält. Wenn der Parameter keepends False ist, werden keine Zeilenumbruchzeichen eingeschlossen; wenn True, werden Zeilenumbruchzeichen beibehalten. |
| 33 | startswith(substr, beg=0,end=len(string)) Prüft, ob die Zeichenkette mit der angegebenen Teilzeichenkette substr beginnt. Wenn ja, wird True zurückgegeben; andernfalls False. Wenn beg und end angegeben sind, wird innerhalb des angegebenen Bereichs geprüft. |
| 34 | Wendet lstrip() und rstrip() auf die Zeichenkette an. |
| 35 | Wandelt in der Zeichenkette Großbuchstaben in Kleinbuchstaben und Kleinbuchstaben in Großbuchstaben um. |
| 36 | Gibt eine Zeichenkette in "Title-Case"-Schreibweise zurück, was bedeutet, dass alle Wörter mit einem Großbuchstaben beginnen und die übrigen Buchstaben Kleinbuchstaben sind (siehe istitle()). |
| 37 | translate(table, deletechars="") Konvertiert Zeichen der Zeichenkette gemäß der durch table angegebenen Tabelle (mit 256 Zeichen). Zeichen, die herausgefiltert werden sollen, werden in den Parameter deletechars gesetzt. |
| 38 | Konvertiert Kleinbuchstaben in der Zeichenkette in Großbuchstaben. |
| 39 | Gibt eine Zeichenkette der Länge width zurück, wobei die ursprüngliche Zeichenkette rechtsbündig ausgerichtet und vorne mit 0 aufgefüllt wird. |
| 40 | Prüft, ob die Zeichenkette nur Dezimalzeichen enthält. Wenn ja, wird true zurückgegeben; andernfalls false. |