Python urllib
La bibliothèque Python urllib est utilisée pour manipuler des URL web et extraire du contenu web.
Cet article présente principalement urllib de Python3.
Le paquet urllib contient les modules suivants :
- urllib.request- Ouvrir et lire des URL.
- urllib.error- Contient les exceptions levées par urllib.request.
- urllib.parse- Analyser des URL.
- urllib.robotparser- Analyser les fichiers robots.txt.

urllib.request
urllib.request définit certaines fonctions et classes pour ouvrir des URL, notamment la vérification d'autorisation, les redirections, les cookies du navigateur, etc.
urllib.request peut simuler le processus de lancement de requête d'un navigateur.
Nous pouvons utiliser la méthode urlopen de urllib.request pour ouvrir une URL, la syntaxe est la suivante :
urllib.request.urlopen(url, data=None, [timeout, ]*, cafile=None, capath=None, cadefault=False, context=None)
- url: adresse URL.
- data: Autres objets de données envoyés au serveur, la valeur par défaut est None.
- timeout: Définir le délai d'accès.
- cafile et capath: cafile est le certificat CA, capath est le chemin du certificat CA, requis pour HTTPS.
- cadefault: Obsolète.
- context: type ssl.SSLContext, utilisé pour spécifier les paramètres SSL.
Voici un exemple :
Exemple
myURL = urlopen("https://www.example.com/")
print(myURL.read())
Le code ci-dessus utilise urlopen pour ouvrir une URL, puis utilise la fonction read() pour obtenir le code source HTML de la page web.
read() lit tout le contenu de la page web ; nous pouvons spécifier la longueur à lire :
Exemple
myURL = urlopen("https://www.example.com/")
print(myURL.read(300))
En plus de la fonction read(), il inclut également les deux fonctions suivantes pour lire le contenu de la page web :
-
readline()- Lire une ligne du fichier
from urllib.request import urlopen myURL = urlopen("https://www.example.com/") print(myURL.readline()) #读取一行内容 -
readlines()- Lire tout le contenu du fichier, cela affecte le contenu lu à une variable de type liste.
from urllib.request import urlopen

myURL = urlopen("https://www.example.com/")
lines = myURL.readlines()
for line in lines:
    print(line)
Lorsqu'on scrape des pages web, nous devons souvent déterminer si la page web est accessible normalement. Ici, nous pouvons utiliser la fonction getcode() pour obtenir le code d'état de la page web. Un retour 200 signifie que la page web est normale, un retour 404 signifie que la page web n'existe pas :
Exemple
myURL1 = urllib.request.urlopen("https://www.example.com/")
print(myURL1.getcode()) # 200
try:
myURL2 = urllib.request.urlopen("https://www.example.com/no.html")
except urllib.error.HTTPError as e:
if e.code == 404:
print(404) # 404
Pour plus de codes d'état de pages web, reportez-vous à :https://www.example.com/http/http-status-codes.html。
Si vous souhaitez enregistrer localement la page web scrapée, vous pouvez utiliserla méthode write() de fichier Python3fonction :
Exemple
myURL = urlopen("https://www.example.com/")
f = open("example_urllib_test.html", "wb")
content = myURL.read() # Lire le contenu de la page web
f.write(content)
f.close()
Après avoir exécuté le code ci-dessus, un fichier example_urllib_test.html sera généré localement, contenant le contenu de la page web https://www.example.com/.
Pour plus d'informations sur la gestion des fichiers Python, consultez :https://www.example.com/python3/python3-file-methods.html
。L'encodage et le décodage d'URL peuvent utiliser les méthodesurllib.request.quote()eturllib.request.unquote():
Exemple
encode_url = urllib.request.quote("https://www.example.com/") # Encodage
print(encode_url)
unencode_url = urllib.request.unquote(encode_url) # Décodage
print(unencode_url)
Le résultat de sortie est:
https%3A//www.example.com/
https://www.example.com/
Simuler les en-têtes
Lors de l'extraction de pages web, nous devons généralement simuler des en-têtes (informations d'en-tête de page web). À ce moment-là, nous devons utiliser la classe urllib.request.Request :
class urllib.request.Request(url, data=None, headers={}, origin_req_host=None, unverifiable=False, method=None)
- url: adresse URL.
- data: Autres objets de données envoyés au serveur, la valeur par défaut est None.
- headers: informations d'en-tête de requête HTTP, au format dictionnaire.
- origin_req_host: L'adresse de l'hôte de la requête, IP ou nom de domaine.
- unverifiable: Ce paramètre est rarement utilisé. Il est utilisé pour définir si la page web nécessite une vérification. La valeur par défaut est False.
- method: Méthode de requête, telle que GET, POST, DELETE, PUT, etc.
Exemple - code du fichier py3_urllib_test.py
import urllib.parse
url = 'https://www.example.com/?s=' # Page de recherche du tutoriel d'exemple
keyword = 'Python Tutorial'
key_code = urllib.request.quote(keyword) # Encoder la requête
url_all = url+key_code
header = {
'User-Agent':'Mozilla/5.0 (X11; Fedora; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36'
} # Informations d'en-tête
request = urllib.request.Request(url_all,headers=header)
reponse = urllib.request.urlopen(request).read()
fh = open("./urllib_test_example_search.html","wb") # Écrire le fichier dans le répertoire courant
fh.write(reponse)
fh.close()
Après avoir exécuté le code Python ci-dessus, un fichier urllib_test_example_search.html sera généré dans le répertoire courant. Ouvrez le fichier urllib_test_example_search.html (vous pouvez l'ouvrir avec un navigateur), le contenu est le suivant :
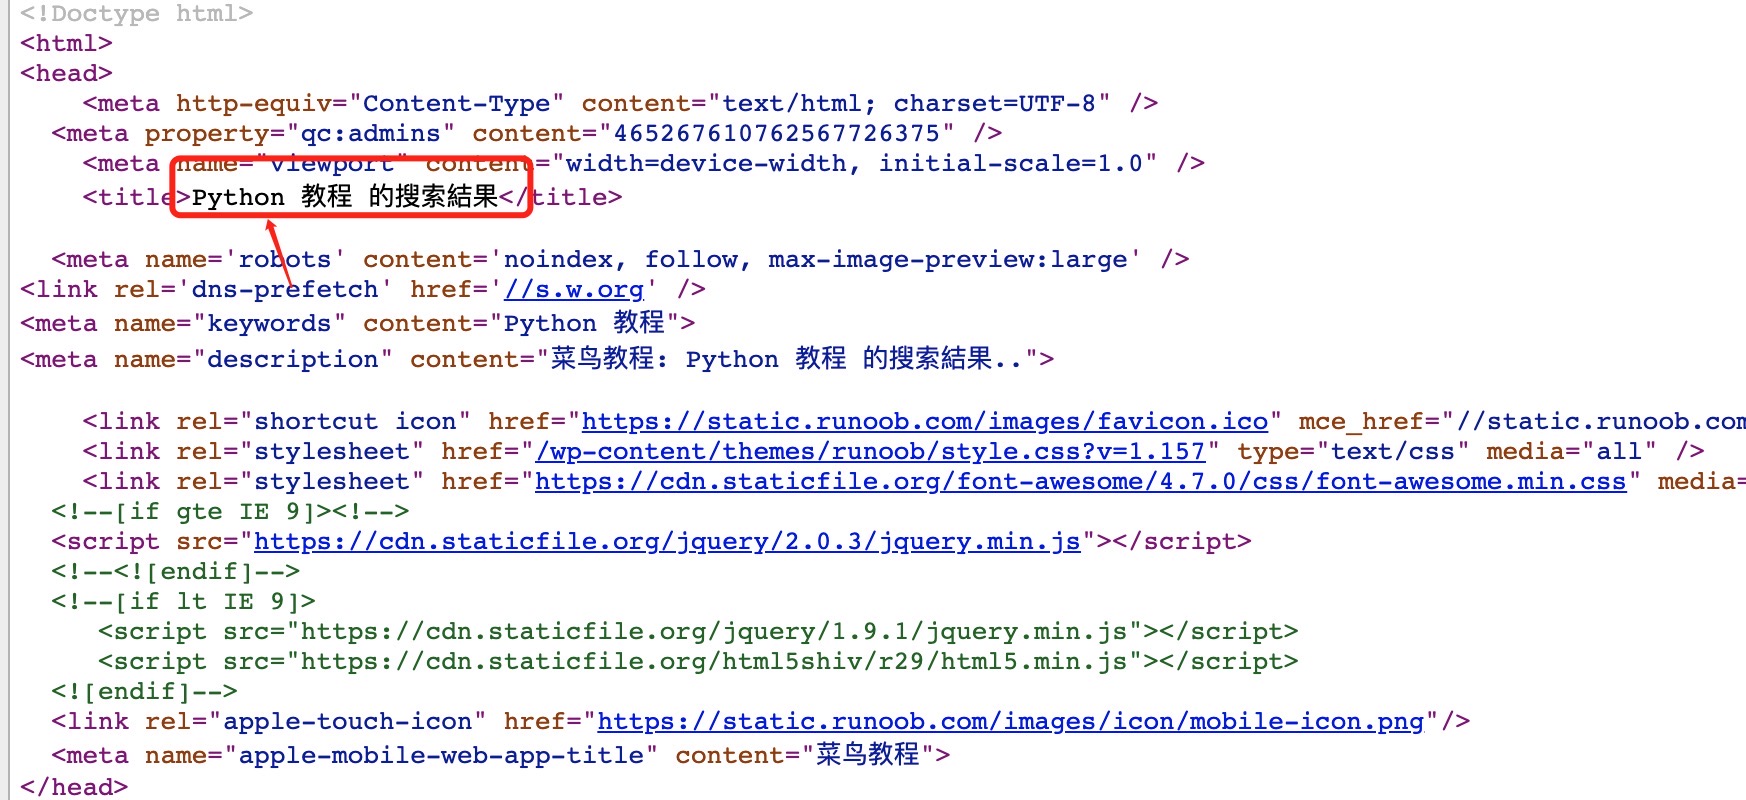
Pour la transmission de données de formulaire en POST, créons d'abord un formulaire. Le code est le suivant. Ici, j'utilise du code PHP pour récupérer les données du formulaire :
Exemple - code du fichier py3_urllib_test.php :
<html>
<head>
<meta charset="utf-8">
<title>Tutoriel d'exemple (example.com) urllib POST Test</title>
</head>
<body>
<form action="" method="post" name="myForm">
Nom : <input type="text" name="name"><br>
Étiquette : <input type="text" name="tag"><br>
<input type="submit" value="Submit">
</forme>
<hr>
<?php
//Utilisez PHP pour récupérer les données soumises par le formulaire, vous pouvez le remplacer par d'autres langages
if(isset($_POST['name']) && $_POST['tag'] ) {
echo $_POST["name"] . ', ' . $_POST['tag'];
}
?>
</body>
</html>
Exemple
import urllib.parse
url = 'https://www.example.com/try/py3/py3_urllib_test.php' # Soumettre à la page du formulaire
data = {'name':'EXAMPLE', 'tag' : 'Rookie Tutorial'} # Soumettre les données
header = {
'User-Agent':'Mozilla/5.0 (X11; Fedora; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36'
} # Informations d'en-tête
data = urllib.parse.urlencode(data).encode('utf8') # Encoder les paramètres, utiliser urllib.parse.urldecode pour le décodage
request=urllib.request.Request(url, data, header) # Traitement de la requête
reponse=urllib.request.urlopen(request).read() # Lire le résultat
fh = open("./urllib_test_post_example.html","wb") # Écrire le fichier dans le répertoire courant
fh.write(reponse)
fh.close()
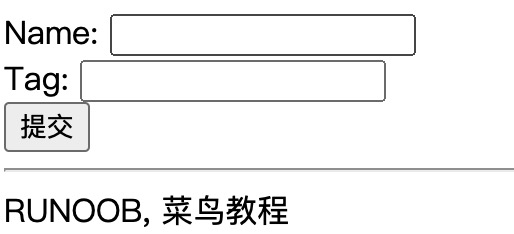
L'exécution du code ci-dessus soumettra les données du formulaire au fichier py3_urllib_test.php et écrira le résultat de sortie dans le fichier urllib_test_post_example.html.
Ouvrez le fichier urllib_test_post_example.html (vous pouvez l'ouvrir avec un navigateur), le résultat affiché est le suivant :
urllib.error
Le module urllib.error définit des classes d'exception pour les exceptions levées par urllib.request, et la classe d'exception de base est URLError.
urllib.error contient deux classes d'exception, URLError et HTTPError.
URLError est une sous-classe d'OSError, utilisée pour gérer les exceptions (ou exceptions dérivées) que le programme lève lorsqu'il rencontre des problèmes. L'attribut reason qu'il contient est la cause de l'exception.
HTTPError est une sous-classe d'URLError, utilisée pour gérer des erreurs HTTP particulières telles que les demandes d'authentification. Les attributs qu'il contient sont :codecode : le code de statut HTTP,reasonreason : la cause de l'exception,headersheaders : les en-têtes de réponse HTTP de la requête HTTP spécifique qui a provoqué l'HTTPError.
Récupérer une page web inexistante et gérer les exceptions :
Exemple
import urllib.error
myURL1 = urllib.request.urlopen("https://www.example.com/")
print(myURL1.getcode()) # 200
try:
myURL2 = urllib.request.urlopen("https://www.example.com/no.html")
except urllib.error.HTTPError as e:
if e.code == 404:
print(404) # 404
urllib.parse
urllib.parse sert à analyser les URL, le format est le suivant :
urllib.parse.urlparse(urlstring, scheme='', allow_fragments=True)
urlstring est l'adresse URL sous forme de chaîne, scheme est le type de protocole,
Si le paramètre allow_fragments vaut false, les identifiants de fragment ne peuvent pas être reconnus. Au lieu de cela, ils sont analysés comme faisant partie du chemin, des paramètres ou des composants de requête, et fragment est défini sur une chaîne vide dans la valeur de retour.
Exemple
o = urlparse("https://www.example.com/?s=python+%E6%95%99%E7%A8%8B")
print(o)
Le résultat de sortie de l'exemple ci-dessus est :
ParseResult(scheme='https', netloc='www.example.com', path='/', params='', query='s=python+%E6%95%99%E7%A8%8B', fragment='')
D'après le résultat, on peut voir que le contenu est un tuple contenant 6 chaînes : protocole, emplacement, chemin, paramètres, requête et fragment.
Nous pouvons directement lire le contenu du protocole :
Exemple
o = urlparse("https://www.example.com/?s=python+%E6%95%99%E7%A8%8B")
print(o.scheme)
Le résultat de sortie de l'exemple ci-dessus est :
https
Le contenu complet est le suivant :
Attribut |
Index |
Valeur |
Valeur (si absente) |
|---|---|---|---|
|
0 |
Protocole URL |
schémaParamètres |
|
1 |
Partie de localisation réseau |
Chaîne vide |
|
2 |
Chemin hiérarchique |
Chaîne vide |
|
3 |
Paramètres du dernier élément de chemin |
Chaîne vide |
|
4 |
Composant de requête |
Chaîne vide |
|
5 |
Identificateur de fragment |
Chaîne vide |
|
Nom d'utilisateur |
|
|
|
Password |
|
|
|
Nom d'hôte (en minuscules) |
|
|
|
Numéro de port sous forme d'entier (si présent) |
|
urllib.robotparser
urllib.robotparser est utilisé pour analyser les fichiers robots.txt.
robots.txt (tout en minuscules) est un protocole robots stocké dans le répertoire racine d'un site web. Il est généralement utilisé pour indiquer aux moteurs de recherche les règles d'exploration du site web.
urllib.robotparser fournit la classe RobotFileParser, la syntaxe est la suivante :
class urllib.robotparser.RobotFileParser(url='')
Cette classe fournit des méthodes permettant de lire et d'analyser les fichiers robots.txt :
-
set_url(url) - Définit l'URL du fichier robots.txt.
-
read() - Lit l'URL du robots.txt et la transmet à l'analyseur.
-
parse(lines) - Analyse le paramètre lines.
-
can_fetch(useragent, url) - Renvoie True si l'agent utilisateur est autorisé à récupérer l'url selon les règles du fichier robots.txt analysé.
-
mtime() - Renvoie l'heure à laquelle le fichier robots.txt a été récupéré pour la dernière fois. Ceci est utile pour les robots d'exploration web de longue durée qui doivent vérifier périodiquement les mises à jour de robots.txt.
-
modified() - Définit à l'heure actuelle l'heure à laquelle le fichier robots.txt a été récupéré pour la dernière fois.
-
crawl_delay(useragent) - Renvoie le paramètre Crawl-delay de robots.txt pour l'agent utilisateur spécifié. Renvoie None si ce paramètre n'existe pas, ne s'applique pas à l'agent utilisateur spécifié, ou si l'entrée robots.txt pour ce paramètre contient une erreur de syntaxe.
-
request_rate(useragent) - Renvoie le contenu du paramètre Request-rate de robots.txt sous forme d'un tuple nommé RequestRate(requests, seconds). Renvoie None si ce paramètre n'existe pas, ne s'applique pas à l'agent utilisateur spécifié, ou si l'entrée robots.txt pour ce paramètre contient une erreur de syntaxe.
-
site_maps() - Renvoie le contenu du paramètre Sitemap de robots.txt sous forme d'une list(). Renvoie None si ce paramètre n'existe pas ou si l'entrée robots.txt pour ce paramètre contient une erreur de syntaxe.
Exemple
>>> rp = urllib.robotparser.RobotFileParser()
>>> rp.set_url("http://www.musi-cal.com/robots.txt")
>>> rp.read()
>>> rrate = rp.request_rate("*")
>>> rrate.requests
3
>>> rrate.seconds
20
>>> rp.crawl_delay("*")
6
>>> rp.can_fetch("*", "http://www.musi-cal.com/cgi-bin/search?city=San+Francisco")
False
>>> rp.can_fetch("*", "http://www.musi-cal.com/")
True