Python Scrapy-Bibliothek
Scrapy ist ein leistungsstarkes Python-Web-Scraping-Framework, das speziell für das Crawlen von Webseiten und das Extrahieren von Informationen entwickelt wurde.
Scrapy wird häufig in Anwendungen wie Data Mining, Informationsverarbeitung oder der Speicherung historischer Daten eingesetzt.
Scrapy verfügt über viele nützliche integrierte Funktionen, wie z. B. die Behandlung von Anfragen, die Zustandsverfolgung, die Fehlerbehandlung, die Verwaltung von Anfragenratenbegrenzungen usw., was es sehr gut für effizientes, verteiltes Web-Crawling geeignet macht.
Im Gegensatz zu einfachen Web-Scraping-Bibliotheken (wierequestsundBeautifulSoup) ist Scrapy ein voll funktionsfähiges Web-Scraping-Framework mit hoher Skalierbarkeit und Flexibilität, das sich für komplexe und groß angelegte Web-Scraping-Aufgaben eignet.
Offizielle Scrapy-Website:https://scrapy.org/。
Scrapy-Funktionen und Einführung:https://www.example.com/w3cnote/scrapy-detail.html。
Scrapy-Architekturdiagramm (grüne Linie ist der Datenfluss):
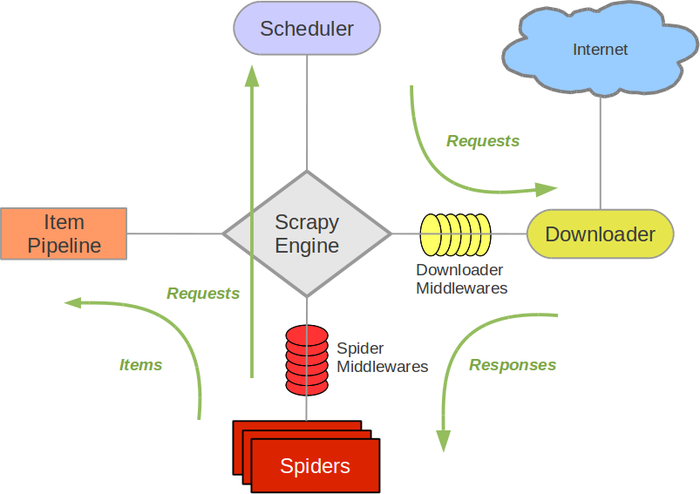
Die Funktionsweise von Scrapy basiert auf den folgenden Kernkomponenten:
- Spider: Spider-Klasse, wird verwendet, um zu definieren, wie Daten aus Webseiten extrahiert werden und wie Links auf Webseiten gefolgt wird.
- Item: Wird verwendet, um die gescrapten Daten zu definieren und zu speichern. Es entspricht einem Datenmodell.
- Pipeline: Wird verwendet, um die gescrapten Daten zu verarbeiten, häufig für Bereinigungs-, Speicher- und andere Operationen.
- Middleware: Wird verwendet, um Anfragen und Antworten zu verarbeiten; kann verwendet werden, um Proxys festzulegen, Cookies, User-Agents usw. zu behandeln.
- Einstellungen: Wird verwendet, um verschiedene Einstellungen des Scrapy-Projekts zu konfigurieren, wie z. B. Anfrageverzögerung, Anzahl gleichzeitiger Anfragen usw.
Scrapy installieren
Bevor Sie Scrapy verwenden, müssen Sie es zuerst installieren. Wir verwenden pip zur Installation:
pip install scrapy
Scrapy-Projektstruktur
Ein Scrapy-Projekt ist ein strukturiertes Verzeichnis, das mehrere Ordner und Module enthält und Ihnen helfen soll, Ihren Spider-Code zu organisieren.
Scrapy verwendet Kommandozeilen-Tools, um Spider-Projekte zu erstellen und zu verwalten. Sie können den folgenden Befehl verwenden, um ein neues Scrapy-Projekt zu erstellen:
scrapy startproject myproject
Dadurch wird ein Projekt namens myproject erstellt, mit einer Projektstruktur, die ungefähr wie folgt aussieht:
myproject/
    scrapy.cfg            # 项目的配置文件
    myproject/            # 项目源代码文件夹
        __init__.py
        items.py          # 定义抓取的数据结构
        middlewares.py    # 定义中间件
        pipelines.py      # 定义数据处理管道
        settings.py       # 项目的设置文件
        spiders/           # 存放爬虫代码的文件夹
            __init__.py
            myspider.py   # 自定义的爬虫代码
Einen einfachen Scrapy-Spider schreiben
Das Folgende ist ein grundlegendes Scrapy-Spider-Beispiel, das zeigt, wie man Daten von Webseiten scrapt.
Wir erstellen ein Spider-Projekt:
scrapy startproject example_test_spiders
Führen Sie den obigen Befehl aus; wenn er erfolgreich ist, wird Folgendes ausgegeben:
templates/project', created in:/Users/Example/example-test/example_test_spiders

You can start your first spider with:
    cd example_test_spiders
    scrapy genspider example example.com
Die generierte Projektstruktur sieht wie folgt aus:

Wechseln Sie dann in dieses Verzeichnis:
cd example_test_spiders
Verwenden Sie als Nächstes denscrapy genspiderBefehl, um einen Spider zu erstellen:
scrapy genspider douban_spider movie.douban.com
Die Verzeichnisstruktur ist wie folgt:
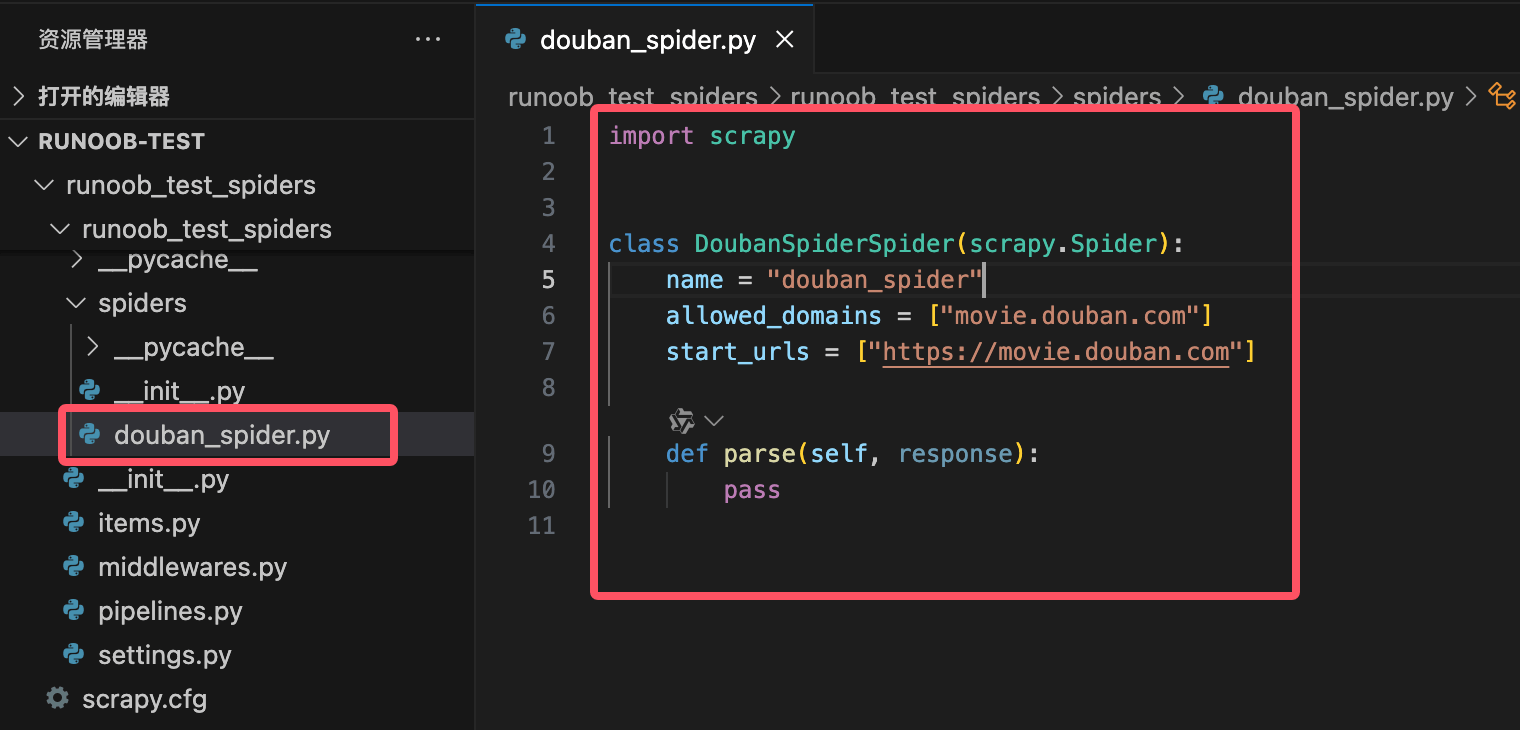
Im Verzeichnis example_test_spiders wird eine Datei namens douban_spider.py mit folgendem Code generiert:
Beispiel
class DoubanSpiderSpider(scrapy.Spider):
name = "douban_spider"
allowed_domains = ["movie.douban.com"]
start_urls = ["https://movie.douban.com"]
def parse(self, response):
pass
Code-Erklärung:
name: Definiert den Namen des Spiders; er muss eindeutig sein.allowed_domains: Beschränkt die Zugriffsdomain des Spiders und verhindert, dass der Spider Seiten auf anderen Domains crawlt.start_urls: Definiert die Startseiten des Spiders; der Spider beginnt mit dem Crawlen von diesen Seiten.parse:parseDie Methode ist der Kernbestandteil jedes Spiders; sie wird verwendet, um Antworten zu verarbeiten und Daten zu extrahieren. Sie empfängt einresponseObjekt, das den vom Server zurückgegebenen Seiteninhalt darstellt.
Spider-Code schreiben
Bevor wir den Spider-Code schreiben, müssen wir einige Punkte beachten:
- Websites wie Douban können Spider-Verhalten erkennen; es wird empfohlen, USER_AGENT und DOWNLOAD_DELAY festzulegen, um normales Nutzerverhalten zu simulieren.
- Beim Scrapen von Daten beachten Sie bitte die Regeln der robots.txt-Datei der Zielwebsite, um den Server nicht zu stark zu belasten.
- Wenn Sie zu häufig crawlen, kann dies zu einer IP-Sperre führen.
settings.py-Konfiguration ändern
Fügen Sie die folgende Konfiguration in settings.py hinzu, um Browseranfragen zu simulieren und Anti-Scraping-Mechanismen zu umgehen:
# 设置 User-Agent
USER_AGENT = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36'

# 不遵守 robots.txt 规则
ROBOTSTXT_OBEY = False

# 设置下载延迟,避免过快请求
DOWNLOAD_DELAY = 2

# 启用自动限速扩展
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 2
AUTOTHROTTLE_MAX_DELAY = 5
Fügen Sie im Spider-Code benutzerdefinierte Anfrage-Header (wie User-Agent und Referer) hinzu, um das Browserverhalten weiter zu simulieren.
Öffnen Sie die Datei douban_spider.py und ändern Sie ihren Inhalt wie folgt:
Beispiel
class DoubanSpider(scrapy.Spider):
name = "douban_spider"
start_urls = [
'https://movie.douban.com/top250',
]
def start_requests(self):
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36',
'Referer': 'https://movie.douban.com/',
}
for url in self.start_urls:
yield scrapy.Request(url, headers=headers, callback=self.parse)
def parse(self, response):
for movie in response.css('div.item'):
yield {
'title': movie.css('span.title::text').get(),
'rating': movie.css('span.rating_num::text').get(),
'quote': movie.css('span.inq::text').get(),
}
# Paginierung behandeln
next_page = response.css('span.next a::attr(href)').get()
if next_page is not None:
yield response.follow(next_page, callback=self.parse)
Codeanalyse:
name = "douban_spider": Definiert den Namen des Spiders.start_urls: Definiert die anfängliche URL, von der aus der Spider zu crawlen beginnt (die Douban Movie Top 250-Seite).parsemethod:Verwendet CSS-Selektoren, um den Titel, die Bewertung und die Einführung jedes Films zu extrahieren.
span.title::text: Extrahiert den Filmtitel.span.rating_num::text: Extrahiert die Filmbewertung.span.inq::text: Extrahiert die Einführung des Films.
Handhabung der Paginierung:
Verwenden Sie
span.next a::attr(href)um den Link zur nächsten Seite zu extrahieren.Wenn die nächste Seite existiert, verwende
response.followum das Crawling fortzusetzen.
Führen Sie den folgenden Befehl in der Befehlszeile aus, um den Spider zu starten:
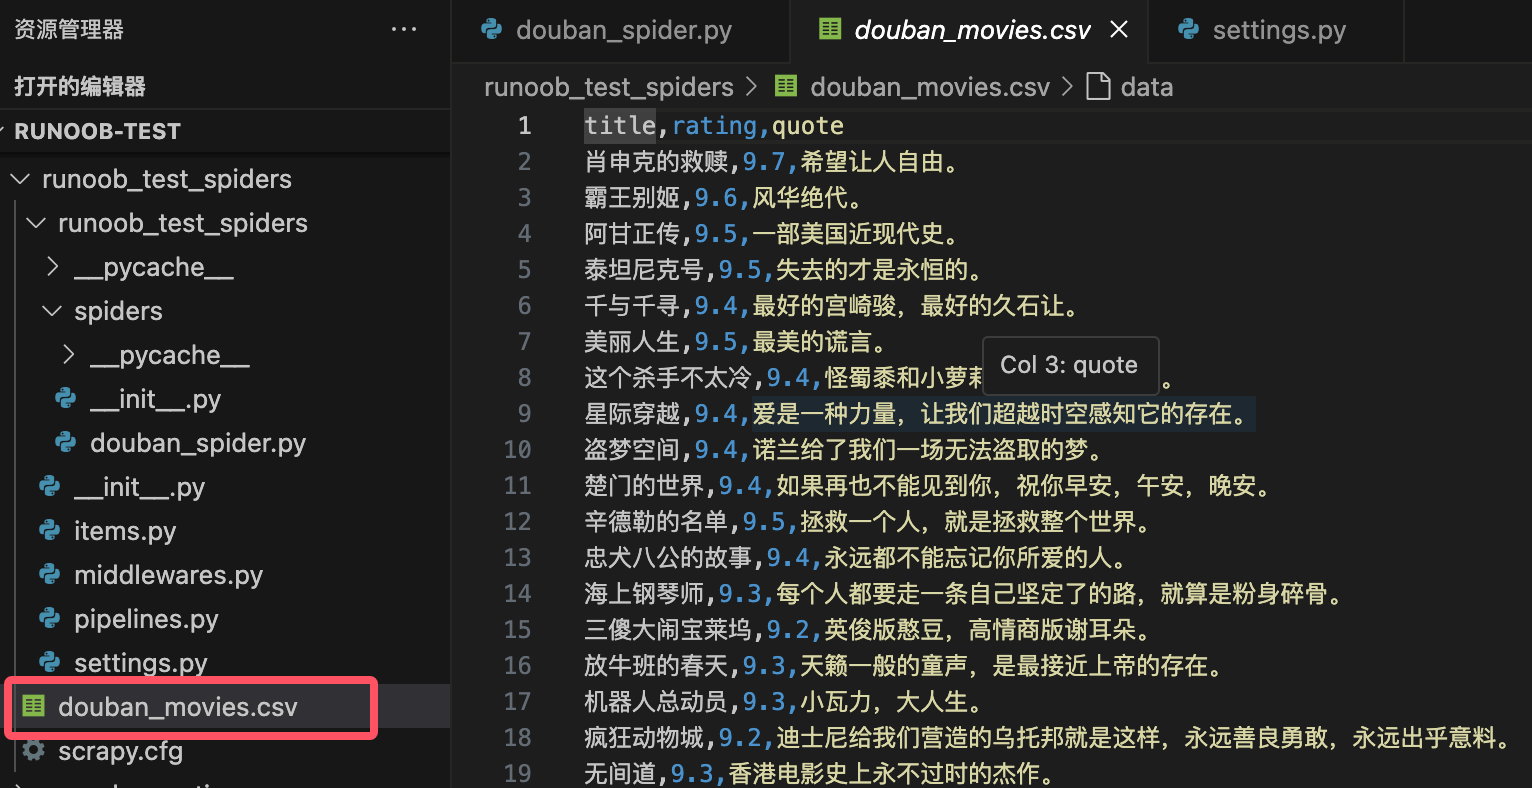
scrapy crawl douban_spider -o douban_movies.csv
Dadurch wird der Spider gestartet und die extrahierten Daten werden in der Datei douban_movies.csv gespeichert.
Hinweis: Der obige Inhalt dient nur zu Lernzwecken. Beachten Sie beim Scrapen von Daten bitte die Regeln der robots.txt-Datei der Zielwebsite.
Häufige Methoden
1. Spider-Methoden
| Methodenname | Beschreibung | Beispiel |
|---|---|---|
start_requests() |
Generieren Sie die erste Anfrage; Sie können Anfrage-Header, Anfragemethoden usw. anpassen. | yield scrapy.Request(url, callback=self.parse) |
parse(response) |
Verarbeiten Sie die Antwort und extrahieren Sie Daten; dies ist die Kernmethode des Spiders. | yield {'title': response.css('h1::text').get()} |
follow(url, callback) |
Verarbeitet automatisch relative URLs und generiert neue Anfragen für Paginierung oder Link-Navigation. | yield response.follow(next_page, callback=self.parse) |
closed(reason) |
Wird aufgerufen, wenn der Spider geschlossen wird; wird zum Bereinigen von Ressourcen oder zum Aufzeichnen von Protokollen verwendet. | def closed(self, reason): print('Spider closed:', reason) |
log(message) |
Protokollinformationen. | self.log('This is a log message') |
2. Methoden zur Datenextraktion
| Methodenname | Beschreibung | Beispiel |
|---|---|---|
response.css(selector) |
Verwenden Sie CSS-Selektoren, um Daten zu extrahieren. | title = response.css('h1::text').get() |
response.xpath(selector) |
Verwenden Sie XPath-Selektoren, um Daten zu extrahieren. | title = response.xpath('//h1/text()').get() |
get() |
fromSelectorListExtrahieren Sie das erste übereinstimmende Ergebnis (Zeichenfolge) aus |
title = response.css('h1::text').get() |
getall() |
fromSelectorListExtrahieren Sie alle übereinstimmenden Ergebnisse (Liste) aus |
titles = response.css('h1::text').getall() |
attrib |
Extrahieren Sie die Attribute des aktuellen Knotens. | link = response.css('a::attr(href)').get() |
3. Request- und Response-Methoden
| Methodenname | Beschreibung | Beispiel |
|---|---|---|
scrapy.Request(url, callback, method, headers, meta) |
Erstellen Sie eine neue Anfrage. | yield scrapy.Request(url, callback=self.parse, headers=headers) |
response.url |
Rufen Sie die URL der aktuellen Antwort ab. | current_url = response.url |
response.status |
Rufen Sie den Statuscode der Antwort ab. | if response.status == 200: print('Success') |
response.meta |
Rufen Sie die zusätzlichen Daten ab, die in der Anfrage übergeben wurden. | value = response.meta.get('key') |
response.headers |
Die Header der Antwort abrufen. | content_type = response.headers.get('Content-Type') |
4. Middleware- und Pipeline-Methoden
| Methodenname | Beschreibung | Beispiel |
|---|---|---|
process_request(request, spider) |
Die Anfrage vor dem Senden verarbeiten (Downloader-Middleware). | request.headers['User-Agent'] = 'Mozilla/5.0' |
process_response(request, response, spider) |
Die Antwort nach ihrer Rückgabe verarbeiten (Downloader-Middleware). | if response.status == 403: return request.replace(dont_filter=True) |
process_item(item, spider) |
Die extrahierten Daten verarbeiten (Pipeline). | if item['price'] < 0: raise DropItem('Invalid price') |
open_spider(spider) |
Wird aufgerufen, wenn der Spider startet (Pipeline). | def open_spider(self, spider): self.file = open('items.json', 'w') |
close_spider(spider) |
Wird aufgerufen, wenn der Spider geschlossen wird (Pipeline). | def close_spider(self, spider): self.file.close() |
5. Werkzeug- und Erweiterungsmethoden
| Methodenname | Beschreibung | Beispiel |
|---|---|---|
scrapy shell |
Die interaktive Shell zum Debuggen und Testen von Selektoren starten. | scrapy shell 'http://example.com' |
scrapy crawl <spider_name> |
Den angegebenen Spider ausführen. | scrapy crawl myspider -o output.json |
scrapy check |
Die Korrektheit des Spider-Codes überprüfen. | scrapy check |
scrapy fetch |
Den Inhalt der angegebenen URL herunterladen. | scrapy fetch 'http://example.com' |
scrapy view |
Die von Scrapy heruntergeladene Seite in einem Browser anzeigen. | scrapy view 'http://example.com' |
6. Häufige Einstellungen (fürsettings.py)
| Einstellungselement | Beschreibung | Beispiel |
|---|---|---|
USER_AGENT |
Setzt den User-Agent im Anfrage-Header. | USER_AGENT = 'Mozilla/5.0' |
ROBOTSTXT_OBEY |
Ob befolgt werden sollrobots.txtRegeln. |
ROBOTSTXT_OBEY = False |
DOWNLOAD_DELAY |
Download-Verzögerung festlegen, um zu schnelle Anfragen zu vermeiden. | DOWNLOAD_DELAY = 2 |
CONCURRENT_REQUESTS |
Die Anzahl der gleichzeitigen Anfragen festlegen. | CONCURRENT_REQUESTS = 16 |
ITEM_PIPELINES |
Pipelines aktivieren. | ITEM_PIPELINES = {'myproject.pipelines.MyPipeline': 300} |
AUTOTHROTTLE_ENABLED |
Die auto-throttle-Erweiterung aktivieren. | AUTOTHROTTLE_ENABLED = True |
7. Weitere häufige Methoden
| Methodenname | Beschreibung | Beispiel |
|---|---|---|
response.follow_all(links, callback) |
Links in Stapeln verarbeiten und Anfragen generieren. | yield from response.follow_all(links, callback=self.parse) |
response.json() |
Den Antwortinhalt in das JSON-Format parsen. | data = response.json() |
response.text |
Den Textinhalt der Antwort abrufen. | html = response.text |
response.selector |
Den Inhalt der Antwort abrufenSelectorObjekt. |
title = response.selector.css('h1::text').get() |
Die obige Tabelle listet die in Scrapy häufig verwendeten Methoden und ihre Funktionen auf. Diese Methoden decken verschiedene Aspekte der Crawler-Entwicklung ab, einschließlich Anfragenerzeugung, Datenextraktion, Middleware-Verarbeitung, Pipeline-Operationen usw. Wenn Sie diese Methoden beherrschen, können Sie Scrapy-Crawler effizient schreiben und verwalten. Weitere detaillierte Funktionen finden Sie unterOffizielle Scrapy-Dokumentation。
Beispiele für die Verwendung der Methode
1. start_requests()
start_requests()Die Methode ist der Einstiegspunkt eines Scrapy-Crawlers und dient zum Erzeugen initialer Anfragen. Üblicherweise wird die Start-URL des Crawlers in dieser Methode definiert.
Beispiel
class MySpider(scrapy.Spider):
name = 'myspider'
def start_requests(self):
urls = [
'http://example.com/page1',
'http://example.com/page2',
]
for url in urls:
yield scrapy.Request(url=url, callback=self.parse)
2. parse()
parse()Die Methode ist die Standardmethode zur Antwortverarbeitung, die verwendet wird, um Antworten zu analysieren und Daten zu extrahieren oder neue Anfragen zu generieren.
Beispiel
# Seitentitel extrahieren
title = response.css('title::text').get()
yield {
'title': title
}
3. parse_item()
parse_item()Die Methode wird verwendet, um die Antwort eines einzelnen Elements (Item) zu analysieren, normalerweise um strukturierte Daten zu extrahieren.
Beispiel
item = {}
item['name'] = response.css('div.name::text').get()
item['price'] = response.css('div.price::text').get()
yield item
4. follow()
follow()Die Methode wird verwendet, um neue Anfragen zu generieren und Antworten automatisch zu verarbeiten, normalerweise für die Linkverfolgung.
Beispiel
for link in response.css('a::attr(href)'):
yield response.follow(link, self.parse_item)
5. yield
yieldDas Schlüsselwort wird verwendet, um Requests oder Items (Item) zu erzeugen und sie an die Scrapy-Engine zur Verarbeitung zu übergeben.
Beispiel
yield {
'title': response.css('title::text').get()
}
6. Item
ItemDie Klasse wird verwendet, um Datenstrukturen zu definieren, normalerweise zum Speichern von Daten, die aus Webseiten extrahiert wurden.
Beispiel
class MyItem(scrapy.Item):
name = scrapy.Field()
price = scrapy.Field()
7. ItemLoader
ItemLoaderDie Klasse wird verwendet, um Item-Objekte zu laden und zu befüllen, wodurch der Workflow zur Datenextraktion und -verarbeitung vereinfacht wird.
Beispiel
from myproject.items import MyItem
def parse(self, response):
loader = ItemLoader(item=MyItem(), response=response)
loader.add_css('name', 'div.name::text')
loader.add_css('price', 'div.price::text')
yield loader.load_item()
8. Request
RequestDie Klasse wird verwendet, um HTTP-Request-Objekte zu erzeugen, normalerweise zum Definieren von Request-URLs, Callback-Methoden usw.
Beispiel
def parse(self, response):
yield scrapy.Request(url='http://example.com/page3', callback=self.parse_item)
9. Response
ResponseDie Klasse repräsentiert ein HTTP-Response-Objekt, das Informationen wie HTML-Inhalt und den vom Server zurückgegebenen Statuscode enthält.
Beispiel
print(response.status) # Antwortstatuscode ausgeben
print(response.body) # Antwortinhalt ausgeben
10. Selector
SelectorDie Klasse wird verwendet, um Daten aus HTML- oder XML-Dokumenten zu extrahieren und unterstützt XPath- und CSS-Selektoren.
Beispiel
title = response.xpath('//title/text()').get()
yield {
'title': title
}
11. CrawlSpider
CrawlSpiderEs ist eine spezielle Spider-Klasse, die verwendet wird, um komplexe Crawling-Regeln und Link-Tracking zu verarbeiten.
Beispiel
from scrapy.linkextractors import LinkExtractor
class MyCrawlSpider(CrawlSpider):
name = 'mycrawlspider'
allowed_domains = ['example.com']
start_urls = ['http://example.com']
rules = (
Rule(LinkExtractor(allow=('page/\d+',)), callback='parse_item'),
)
def parse_item(self, response):
yield {
'title': response.css('title::text').get()
}
12. LinkExtractor
LinkExtractorDie Klasse wird verwendet, um Links aus Antworten zu extrahieren, normalerweise zum automatischen Verfolgen von Links auf Seiten.
Beispiel
def parse(self, response):
extractor = LinkExtractor(allow=('page/\d+',))
links = extractor.extract_links(response)
for link in links:
yield scrapy.Request(link.url, callback=self.parse_item)
13. Pipeline
PipelineDie Klasse wird verwendet, um gescrapte Daten zu verarbeiten, normalerweise für Datenbereinigung, Speicherung und andere Operationen.
Beispiel
def process_item(self, item, spider):
# Item-Daten verarbeiten
return item
14. Middleware
MiddlewareDie Klasse wird für die Middleware-Verarbeitung von Anfragen und Antworten verwendet, üblicherweise zum Ändern von Anfrage-Headern, Behandeln von Ausnahmen usw.
Beispiel
def process_request(self, request, spider):
# Anfrage-Header ändern
request.headers['User-Agent'] = 'MyCustomUserAgent'
return None