Python библиотека Scrapy
Scrapy — это мощный фреймворк для веб-скрапинга на Python, специально предназначенный для обхода веб-страниц и извлечения информации.
Scrapy часто используется в таких приложениях, как интеллектуальный анализ данных, обработка информации или хранение исторических данных.
Scrapy имеет множество встроенных полезных функций, таких как обработка запросов, отслеживание состояния, обработка ошибок, управление ограничениями частоты запросов и т. д., что делает его очень подходящим для эффективного распределённого веб-скрапинга.
В отличие от простых библиотек веб-скрапинга (таких какrequestsиBeautifulSoup), Scrapy — это полнофункциональный фреймворк для веб-скрапинга с высокой степенью масштабируемости и гибкости, подходящий для сложных и крупномасштабных задач веб-скрапинга.
Официальный сайт Scrapy:https://scrapy.org/。
Возможности и введение в Scrapy:https://www.example.com/w3cnote/scrapy-detail.html。
Схема архитектуры Scrapy (зелёная линия — поток данных):
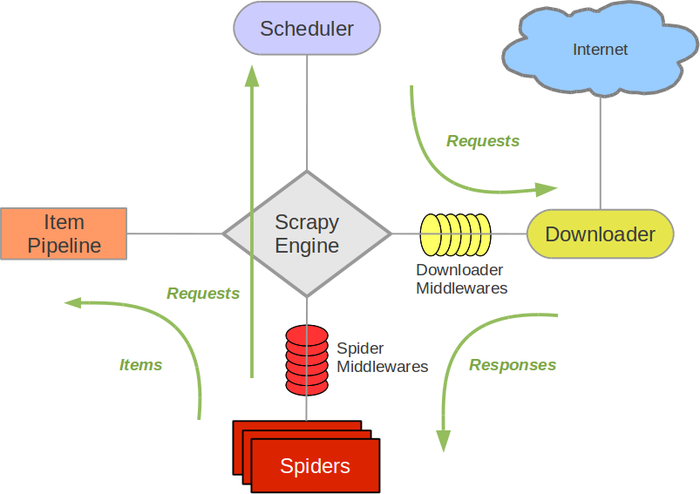
Работа Scrapy основана на следующих основных компонентах:
- Spider: класс Spider, используемый для определения того, как извлекать данные с веб-страниц и как переходить по ссылкам на веб-страницах.
- Item: Используется для определения и хранения собранных данных. Эквивалентен модели данных.
- Pipeline: Используется для обработки собранных данных, обычно для очистки, хранения данных и других операций.
- Промежуточное ПО: используется для обработки запросов и ответов, может использоваться для настройки прокси, обработки куки, пользовательских агентов и т. д.
- Настройки: используются для настройки различных параметров проекта Scrapy, таких как задержка запросов, количество одновременных запросов и т. д.
Установка Scrapy
Перед использованием Scrapy его нужно сначала установить. Для установки мы используем pip:
pip install scrapy
Структура проекта Scrapy
Проект Scrapy — это структурированный каталог, содержащий несколько папок и модулей, предназначенный для того, чтобы помочь вам организовать код ваших пауков.
Scrapy использует инструменты командной строки для создания проектов пауков и управления ими. Вы можете использовать следующую команду для создания нового проекта Scrapy:
scrapy startproject myproject
Это создаст проект с именем myproject, со следующей примерной структурой проекта:
myproject/
    scrapy.cfg            # 项目的配置文件
    myproject/            # 项目源代码文件夹
        __init__.py
        items.py          # 定义抓取的数据结构
        middlewares.py    # 定义中间件
        pipelines.py      # 定义数据处理管道
        settings.py       # 项目的设置文件
        spiders/           # 存放爬虫代码的文件夹
            __init__.py
            myspider.py   # 自定义的爬虫代码
Написание простого паука Scrapy
Ниже приведён базовый пример паука Scrapy, который показывает, как извлекать данные с веб-страниц.
Мы создаём проект паука:
scrapy startproject example_test_spiders
Выполните указанную выше команду; в случае успеха будет выведено:
templates/project', created in:/Users/Example/example-test/example_test_spiders

You can start your first spider with:
    cd example_test_spiders
    scrapy genspider example example.com
Структура сгенерированного проекта выглядит следующим образом:
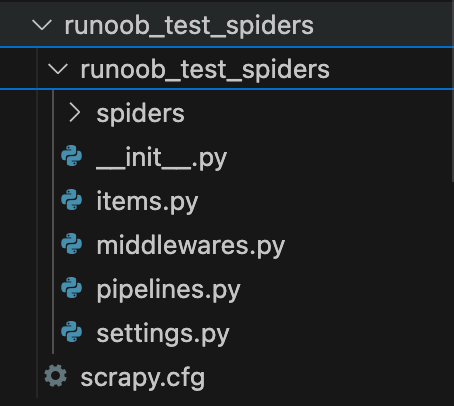
Затем перейдите в этот каталог:
cd example_test_spiders
Далее используйтеscrapy genspiderкоманду для создания паука:
scrapy genspider douban_spider movie.douban.com
Структура каталогов выглядит следующим образом:
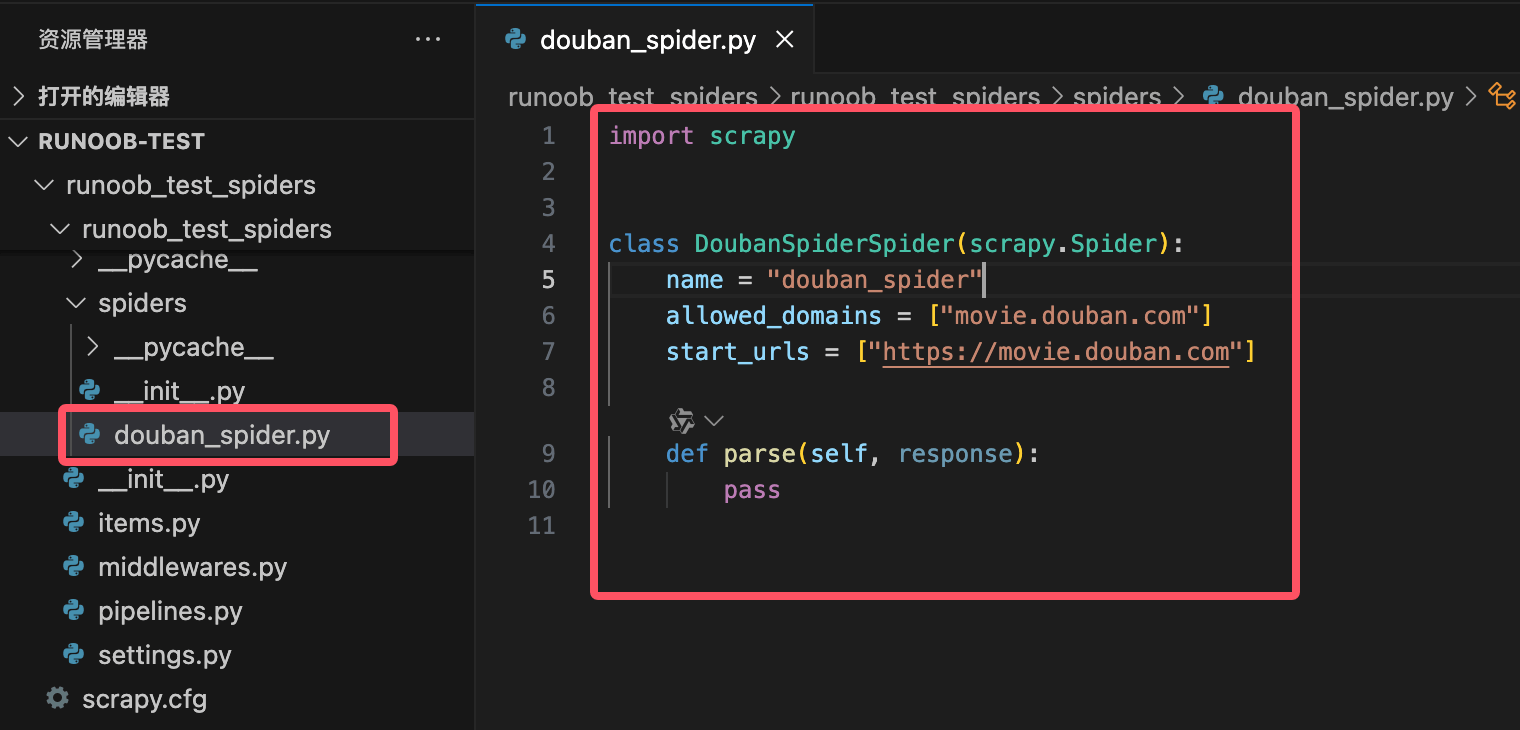
В каталоге example_test_spiders создаётся файл с именем douban_spider.py, код которого выглядит следующим образом:
Пример
class DoubanSpiderSpider(scrapy.Spider):
name = "douban_spider"
allowed_domains = ["movie.douban.com"]
start_urls = ["https://movie.douban.com"]
def parse(self, response):
pass
Пояснение к коду:
name: Определяет имя паука; оно должно быть уникальным.allowed_domains: Ограничивает домен доступа паука, не позволяя пауку обходить страницы на других доменах.start_urls: Определяет начальные страницы паука; паук начнет обход с этих страниц.parse:parseМетод является основной частью каждого паука, используется для обработки ответов и извлечения данных. Он получаетresponseобъект, представляющий содержимое страницы, возвращенное сервером.
Напишите код паука
Перед написанием кода паука нам нужно учесть несколько моментов:
- Такие сайты, как Douban, могут обнаружить поведение паука; рекомендуется установить USER_AGENT и DOWNLOAD_DELAY, чтобы имитировать поведение обычного пользователя.
- При сборе данных, пожалуйста, соблюдайте правила файла robots.txt целевого сайта, чтобы не создавать слишком большую нагрузку на сервер.
- Если вы сканируете слишком часто, вы можете вызвать блокировку по IP.
Измените конфигурацию settings.py
Добавьте следующую конфигурацию в settings.py, чтобы имитировать запросы браузера и обойти механизмы защиты от сбора данных:
# 设置 User-Agent
USER_AGENT = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36'

# 不遵守 robots.txt 规则
ROBOTSTXT_OBEY = False

# 设置下载延迟,避免过快请求
DOWNLOAD_DELAY = 2

# 启用自动限速扩展
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 2
AUTOTHROTTLE_MAX_DELAY = 5
В коде паука добавьте пользовательские заголовки запросов (такие как User-Agent и Referer), чтобы еще больше имитировать поведение браузера.
Откройте файл douban_spider.py и измените его содержимое следующим образом:
Пример
class DoubanSpider(scrapy.Spider):
name = "douban_spider"
start_urls = [
'https://movie.douban.com/top250',
]
def start_requests(self):
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36',
'Referer': 'https://movie.douban.com/',
}
for url in self.start_urls:
yield scrapy.Request(url, headers=headers, callback=self.parse)
def parse(self, response):
for movie in response.css('div.item'):
yield {
'title': movie.css('span.title::text').get(),
'rating': movie.css('span.rating_num::text').get(),
'quote': movie.css('span.inq::text').get(),
}
# Обработка пагинации
next_page = response.css('span.next a::attr(href)').get()
if next_page is not None:
yield response.follow(next_page, callback=self.parse)
Анализ кода:
name = "douban_spider": Определяет имя паука.start_urls: Определяет начальный URL, с которого паук начинает обход (страница Douban Movie Top 250).parsemethod:Использует CSS-селекторы для извлечения названия, рейтинга и описания каждого фильма.
span.title::text: Извлекает название фильма.span.rating_num::text: Извлекает рейтинг фильма.span.inq::text: Извлекает описание фильма.
Обработка пагинации:
Используйте
span.next a::attr(href)чтобы извлечь ссылку на следующую страницу.Если следующая страница существует, используйте
response.followчтобы продолжить сканирование.
Выполните следующую команду в командной строке, чтобы запустить паука:
scrapy crawl douban_spider -o douban_movies.csv
Это запустит паука и сохранит извлечённые данные в файл douban_movies.csv.
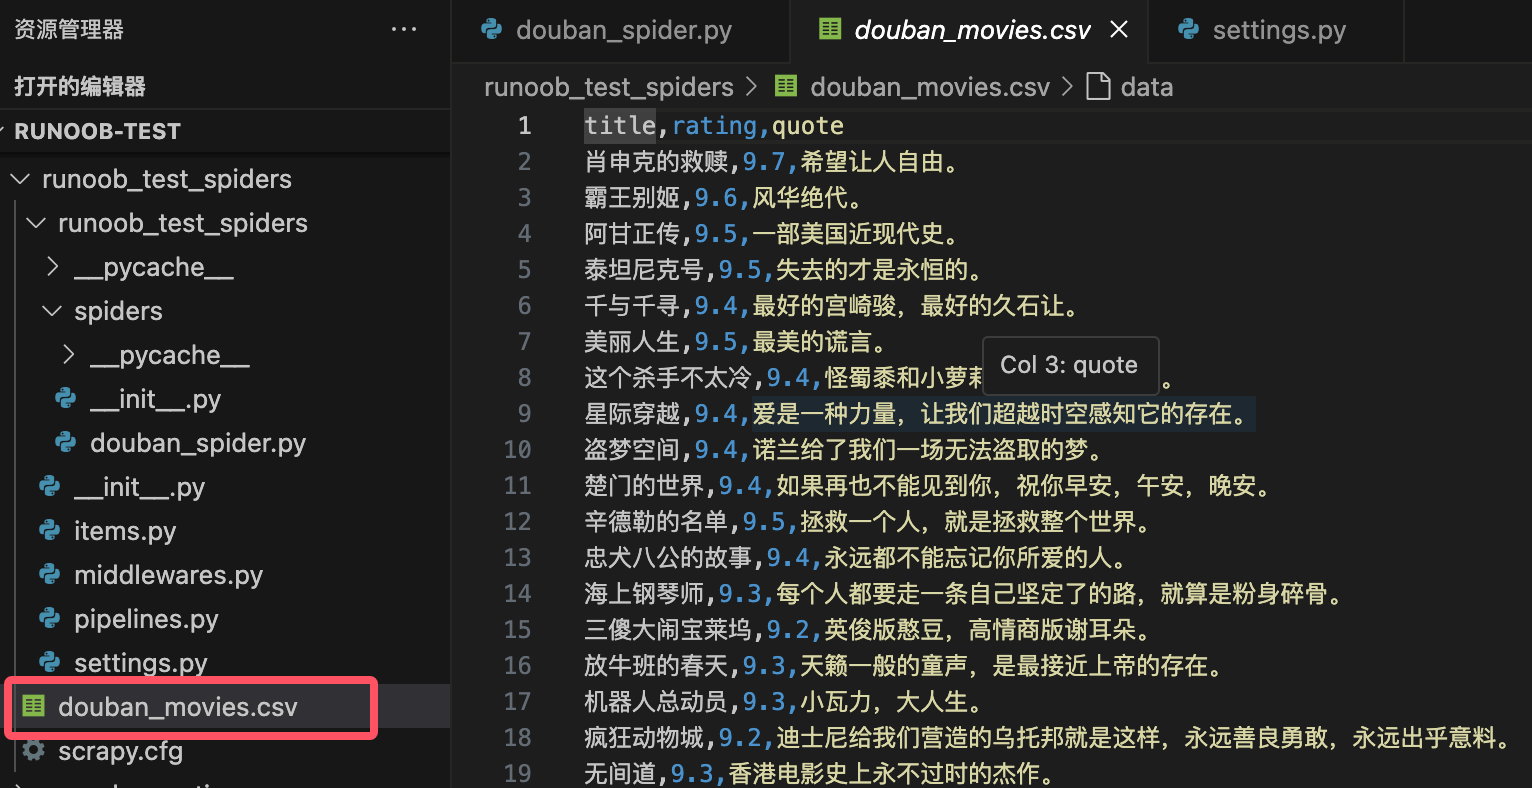
Примечание: вышеуказанный контент предназначен только для учебных целей. При сборе данных соблюдайте правила файла robots.txt целевого веб-сайта.
Общие методы
1. Методы паука
| Название метода | Описание | Пример |
|---|---|---|
start_requests() |
Генерирует начальный запрос; вы можете настроить заголовки запроса, методы запроса и т. д. | yield scrapy.Request(url, callback=self.parse) |
parse(response) |
Обрабатывает ответ и извлекает данные; это основной метод паука. | yield {'title': response.css('h1::text').get()} |
follow(url, callback) |
Автоматически обрабатывает относительные URL-адреса и генерирует новые запросы для пагинации или навигации по ссылкам. | yield response.follow(next_page, callback=self.parse) |
closed(reason) |
Вызывается при закрытии паука, используется для очистки ресурсов или записи логов. | def closed(self, reason): print('Spider closed:', reason) |
log(message) |
Информация журнала. | self.log('This is a log message') |
2. Методы извлечения данных
| Название метода | Описание | Пример |
|---|---|---|
response.css(selector) |
Используйте CSS-селекторы для извлечения данных. | title = response.css('h1::text').get() |
response.xpath(selector) |
Используйте XPath-селекторы для извлечения данных. | title = response.xpath('//h1/text()').get() |
get() |
fromSelectorListИзвлечь первый совпадающий результат (строку) из |
title = response.css('h1::text').get() |
getall() |
fromSelectorListИзвлечь все совпадающие результаты (список) из |
titles = response.css('h1::text').getall() |
attrib |
Извлечь атрибуты текущего узла. | link = response.css('a::attr(href)').get() |
3. Методы запроса и ответа
| Название метода | Описание | Пример |
|---|---|---|
scrapy.Request(url, callback, method, headers, meta) |
Создать новый запрос. | yield scrapy.Request(url, callback=self.parse, headers=headers) |
response.url |
Получить URL текущего ответа. | current_url = response.url |
response.status |
Получить код состояния ответа. | if response.status == 200: print('Success') |
response.meta |
Получить дополнительные данные, переданные в запросе. | value = response.meta.get('key') |
response.headers |
Получить заголовки ответа. | content_type = response.headers.get('Content-Type') |
4. Методы промежуточного ПО и конвейера
| Название метода | Описание | Пример |
|---|---|---|
process_request(request, spider) |
Обработать запрос перед его отправкой (промежуточное ПО загрузчика). | request.headers['User-Agent'] = 'Mozilla/5.0' |
process_response(request, response, spider) |
Обработать ответ после его возврата (промежуточное ПО загрузчика). | if response.status == 403: return request.replace(dont_filter=True) |
process_item(item, spider) |
Обработать извлечённые данные (конвейер). | if item['price'] < 0: raise DropItem('Invalid price') |
open_spider(spider) |
Вызывается при запуске паука (конвейер). | def open_spider(self, spider): self.file = open('items.json', 'w') |
close_spider(spider) |
Вызывается при закрытии паука (конвейер). | def close_spider(self, spider): self.file.close() |
5. Инструменты и методы расширений
| Название метода | Описание | Пример |
|---|---|---|
scrapy shell |
Запустить интерактивную оболочку Shell для отладки и тестирования селекторов. | scrapy shell 'http://example.com' |
scrapy crawl <spider_name> |
Запустить указанного паука. | scrapy crawl myspider -o output.json |
scrapy check |
Проверить корректность кода паука. | scrapy check |
scrapy fetch |
Скачать содержимое указанного URL. | scrapy fetch 'http://example.com' |
scrapy view |
Посмотреть страницу, загруженную Scrapy, в браузере. | scrapy view 'http://example.com' |
6. Общие настройки (дляsettings.py)
| Параметр настройки | Описание | Пример |
|---|---|---|
USER_AGENT |
Установите User-Agent в заголовке запроса. | USER_AGENT = 'Mozilla/5.0' |
ROBOTSTXT_OBEY |
Соблюдать лиrobots.txtправила. |
ROBOTSTXT_OBEY = False |
DOWNLOAD_DELAY |
Установите задержку загрузки, чтобы не делать запросы слишком быстро. | DOWNLOAD_DELAY = 2 |
CONCURRENT_REQUESTS |
Установите количество одновременных запросов. | CONCURRENT_REQUESTS = 16 |
ITEM_PIPELINES |
Включите конвейеры. | ITEM_PIPELINES = {'myproject.pipelines.MyPipeline': 300} |
AUTOTHROTTLE_ENABLED |
Включите расширение auto-throttle. | AUTOTHROTTLE_ENABLED = True |
7. Другие распространённые методы
| Название метода | Описание | Пример |
|---|---|---|
response.follow_all(links, callback) |
Обрабатывайте ссылки пакетами и генерируйте запросы. | yield from response.follow_all(links, callback=self.parse) |
response.json() |
Преобразовать содержимое ответа в формат JSON. | data = response.json() |
response.text |
Получить текстовое содержимое ответа. | html = response.text |
response.selector |
Получить содержимое ответаSelectorобъект. |
title = response.selector.css('h1::text').get() |
В таблице выше перечислены часто используемые методы в Scrapy и их функции. Эти методы охватывают различные аспекты разработки краулеров, включая генерацию запросов, извлечение данных, обработку промежуточного ПО, операции с конвейером и т. д. Освоив эти методы, вы сможете эффективно писать и управлять краулерами Scrapy. Для более подробных возможностей обратитесь кОфициальная документация Scrapy。
Примеры использования метода
1. start_requests()
start_requests()Метод является точкой входа краулера Scrapy, используемой для генерации начальных запросов. Обычно начальный URL краулера задаётся в этом методе.
Пример
class MySpider(scrapy.Spider):
name = 'myspider'
def start_requests(self):
urls = [
'http://example.com/page1',
'http://example.com/page2',
]
for url in urls:
yield scrapy.Request(url=url, callback=self.parse)
2. parse()
parse()Этот метод — метод обработки ответов по умолчанию, используемый для разбора ответов и извлечения данных или создания новых запросов.
Пример
# Извлечь заголовок страницы
title = response.css('title::text').get()
yield {
'title': title
}
3. parse_item()
parse_item()Метод используется для разбора ответа отдельного элемента (Item), обычно для извлечения структурированных данных.
Пример
item = {}
item['name'] = response.css('div.name::text').get()
item['price'] = response.css('div.price::text').get()
yield item
4. follow()
follow()Метод используется для создания новых запросов и автоматической обработки ответов, обычно для отслеживания ссылок.
Пример
for link in response.css('a::attr(href)'):
yield response.follow(link, self.parse_item)
5. yield
yieldКлючевое слово используется для генерации запросов или элементов (Item) и передачи их движку Scrapy для обработки.
Пример
yield {
'title': response.css('title::text').get()
}
6. Item
ItemКласс используется для определения структур данных, обычно для хранения данных, извлечённых с веб-страниц.
Пример
class MyItem(scrapy.Item):
name = scrapy.Field()
price = scrapy.Field()
7. ItemLoader
ItemLoaderКласс используется для загрузки и заполнения объектов Item, упрощая рабочий процесс извлечения и обработки данных.
Пример
from myproject.items import MyItem
def parse(self, response):
loader = ItemLoader(item=MyItem(), response=response)
loader.add_css('name', 'div.name::text')
loader.add_css('price', 'div.price::text')
yield loader.load_item()
8. Request
RequestКласс используется для создания объектов HTTP-запросов, обычно для определения URL-адресов запросов, методов обратного вызова и т. д.
Пример
def parse(self, response):
yield scrapy.Request(url='http://example.com/page3', callback=self.parse_item)
9. Response
ResponseКласс представляет объект HTTP-ответа, содержащий такую информацию, как содержимое HTML и код состояния, возвращаемый сервером.
Пример
print(response.status) # Вывести код состояния ответа
print(response.body) # Вывести содержимое ответа
10. Selector
SelectorКласс используется для извлечения данных из документов HTML или XML, поддерживая селекторы XPath и CSS.
Пример
title = response.xpath('//title/text()').get()
yield {
'title': title
}
11. CrawlSpider
CrawlSpiderЭто специальный класс Spider, используемый для обработки сложных правил обхода и отслеживания ссылок.
Пример
from scrapy.linkextractors import LinkExtractor
class MyCrawlSpider(CrawlSpider):
name = 'mycrawlspider'
allowed_domains = ['example.com']
start_urls = ['http://example.com']
rules = (
Rule(LinkExtractor(allow=('page/\d+',)), callback='parse_item'),
)
def parse_item(self, response):
yield {
'title': response.css('title::text').get()
}
12. LinkExtractor
LinkExtractorКласс используется для извлечения ссылок из ответов, обычно для автоматического отслеживания ссылок на страницах.
Пример
def parse(self, response):
extractor = LinkExtractor(allow=('page/\d+',))
links = extractor.extract_links(response)
for link in links:
yield scrapy.Request(link.url, callback=self.parse_item)
13. Pipeline
PipelineКласс используется для обработки собранных данных, обычно для очистки данных, хранения и других операций.
Пример
def process_item(self, item, spider):
# Обработка данных элемента
return item
14. Middleware
MiddlewareКласс используется для промежуточной обработки запросов и ответов, обычно для изменения заголовков запросов, обработки исключений и т. д.
Пример
def process_request(self, request, spider):
# Изменить заголовки запроса
request.headers['User-Agent'] = 'MyCustomUserAgent'
return None