Bibliothèque Scrapy Python
Scrapy est un puissant framework Python de web scraping spécialement conçu pour parcourir les pages web et extraire des informations.
Scrapy est souvent utilisé dans des applications telles que l'exploration de données, le traitement de l'information ou le stockage de données historiques.
Scrapy dispose de nombreuses fonctionnalités intégrées utiles, telles que la gestion des requêtes, le suivi de l'état, la gestion des erreurs, la gestion des limites de débit des requêtes, etc., ce qui le rend très adapté à l'exploration web distribuée et efficace.
Contrairement aux simples bibliothèques de web scraping (telles querequestsetBeautifulSoup), Scrapy est un framework de web scraping complet avec un haut degré d'évolutivité et de flexibilité, adapté aux tâches de web scraping complexes et à grande échelle.
Site officiel de Scrapy :https://scrapy.org/。
Fonctionnalités et présentation de Scrapy :https://www.example.com/w3cnote/scrapy-detail.html。
Schéma d'architecture de Scrapy (la ligne verte représente le flux de données) :
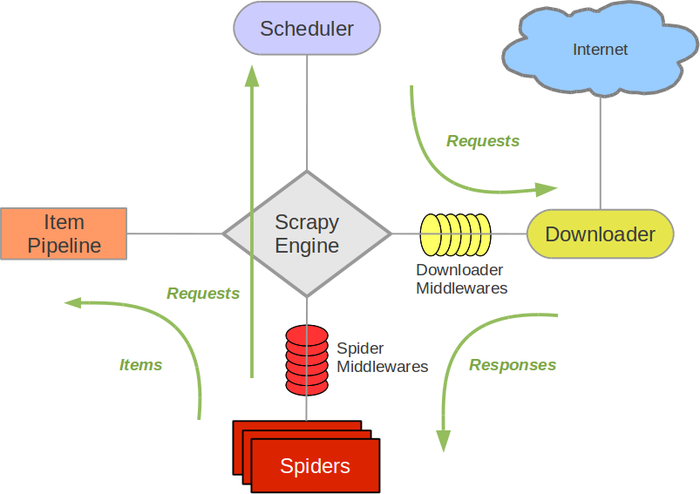
Le fonctionnement de Scrapy repose sur les composants principaux suivants :
- Spider: classe Spider, utilisée pour définir comment extraire des données des pages web et comment suivre les liens sur les pages web.
- Item: utilisé pour définir et stocker les données extraites. Il équivaut à un modèle de données.
- Pipeline: utilisé pour traiter les données extraites, couramment utilisé pour le nettoyage, le stockage des données et d'autres opérations.
- Middleware: Utilisé pour gérer les requêtes et les réponses, peut être utilisé pour définir des proxies, gérer les cookies, les agents utilisateurs, etc.
- Paramètres: Utilisé pour configurer divers paramètres du projet Scrapy, tels que le délai entre les requêtes, le nombre de requêtes simultanées, etc.
Installation de Scrapy
Avant d'utiliser Scrapy, vous devez d'abord l'installer. Nous utilisons pip pour l'installation :
pip install scrapy
Structure d'un projet Scrapy
Un projet Scrapy est un répertoire structuré contenant plusieurs dossiers et modules, conçu pour vous aider à organiser le code de votre spider.
Scrapy utilise des outils en ligne de commande pour créer et gérer des projets de spider. Vous pouvez utiliser la commande suivante pour créer un nouveau projet Scrapy :
scrapy startproject myproject
Cela créera un projet nommé myproject, avec une structure de projet approximativement comme suit :
myproject/
    scrapy.cfg            # 项目的配置文件
    myproject/            # 项目源代码文件夹
        __init__.py
        items.py          # 定义抓取的数据结构
        middlewares.py    # 定义中间件
        pipelines.py      # 定义数据处理管道
        settings.py       # 项目的设置文件
        spiders/           # 存放爬虫代码的文件夹
            __init__.py
            myspider.py   # 自定义的爬虫代码
Écrire un spider Scrapy simple
Voici un exemple de base de spider Scrapy qui montre comment extraire des données de pages web.
Nous créons un projet de spider :
scrapy startproject example_test_spiders
Exécutez la commande ci-dessus ; si elle réussit, elle affichera :
templates/project', created in:/Users/Example/example-test/example_test_spiders

You can start your first spider with:
    cd example_test_spiders
    scrapy genspider example example.com
La structure du projet générée est la suivante :
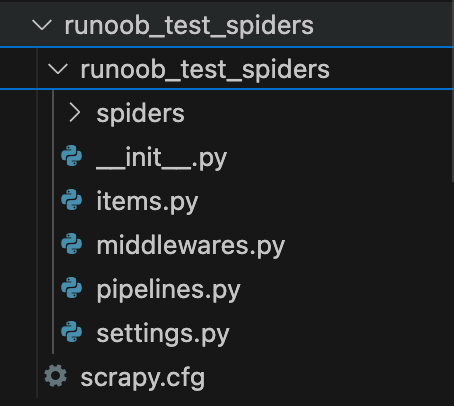
Ensuite, entrez dans ce répertoire :
cd example_test_spiders
Ensuite, utilisez la commandescrapy genspiderpour créer un spider :
scrapy genspider douban_spider movie.douban.com
La structure du répertoire est la suivante :
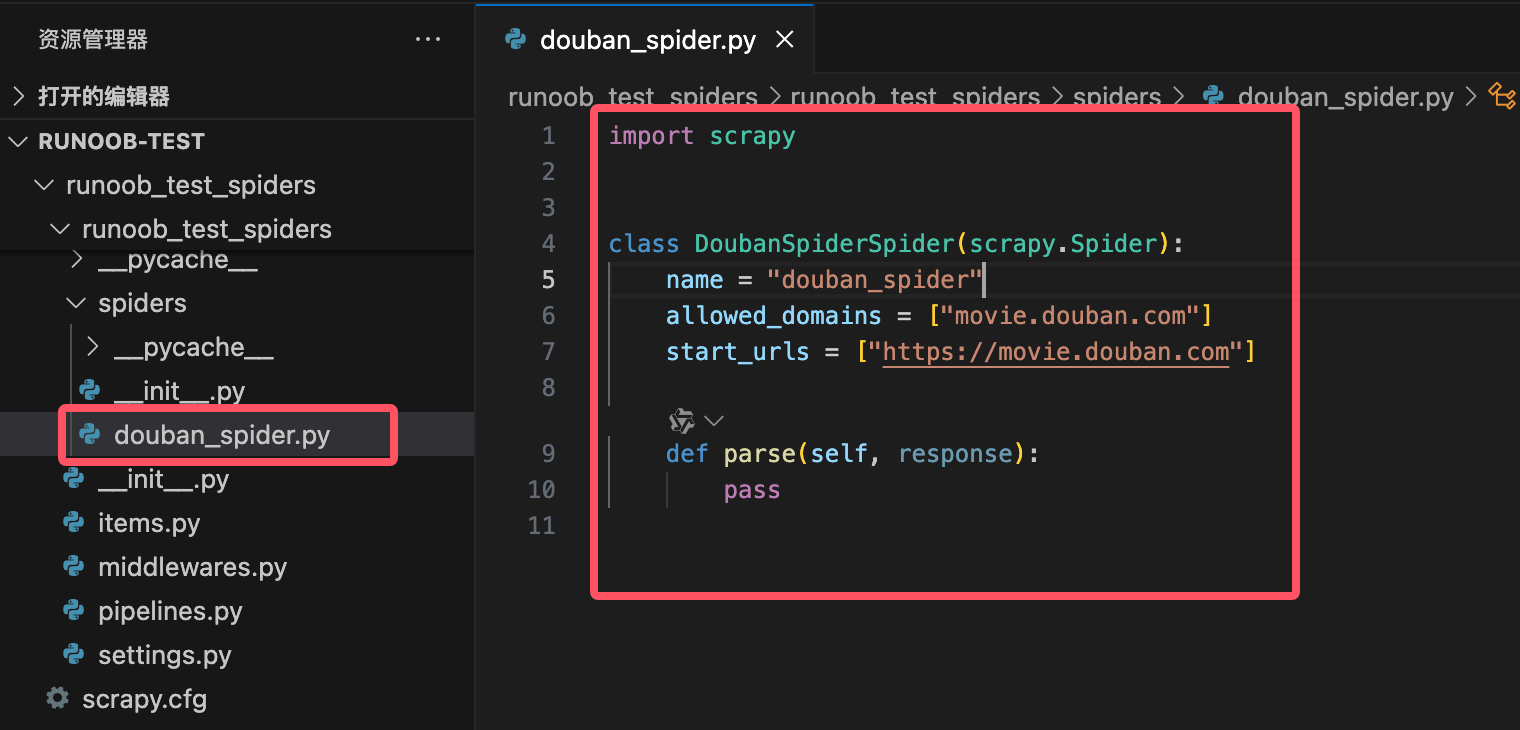
Un fichier nommé douban_spider.py est généré dans le répertoire example_test_spiders, avec le code comme suit :
Exemple
class DoubanSpiderSpider(scrapy.Spider):
name = "douban_spider"
allowed_domains = ["movie.douban.com"]
start_urls = ["https://movie.douban.com"]
def parse(self, response):
pass
Explication du code :
name: Définit le nom du spider ; il doit être unique.allowed_domains: Restreint le domaine d'accès du spider, empêchant le spider de parcourir des pages sur d'autres domaines.start_urls: Définit les pages de départ du spider ; le spider commencera à explorer à partir de ces pages.parse:parseLa méthode est la partie centrale de chaque spider, utilisée pour traiter les réponses et extraire des données. Elle reçoit unresponseobjet, représentant le contenu de la page renvoyé par le serveur.
Écrire le code du spider
Avant d'écrire le code du spider, nous devons noter quelques points :
- Les sites web tels que Douban peuvent détecter le comportement d'un spider ; il est recommandé de définir USER_AGENT et DOWNLOAD_DELAY pour simuler le comportement d'un utilisateur normal.
- Lors de l'extraction de données, veuillez respecter les règles du fichier robots.txt du site cible afin d'éviter de trop solliciter le serveur.
- Si vous explorez trop fréquemment, vous risquez de déclencher un bannissement d'IP.
Modifier la configuration de settings.py
Ajoutez la configuration suivante dans settings.py pour simuler les requêtes du navigateur et contourner les mécanismes anti-scraping :
# 设置 User-Agent
USER_AGENT = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36'

# 不遵守 robots.txt 规则
ROBOTSTXT_OBEY = False

# 设置下载延迟,避免过快请求
DOWNLOAD_DELAY = 2

# 启用自动限速扩展
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 2
AUTOTHROTTLE_MAX_DELAY = 5
Dans le code du spider, ajoutez des en-têtes de requête personnalisés (tels que User-Agent et Referer) pour simuler davantage le comportement du navigateur.
Ouvrez le fichier douban_spider.py et modifiez son contenu comme suit :
Exemple
class DoubanSpider(scrapy.Spider):
name = "douban_spider"
start_urls = [
'https://movie.douban.com/top250',
]
def start_requests(self):
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36',
'Referer': 'https://movie.douban.com/',
}
for url in self.start_urls:
yield scrapy.Request(url, headers=headers, callback=self.parse)
def parse(self, response):
for movie in response.css('div.item'):
yield {
'title': movie.css('span.title::text').get(),
'rating': movie.css('span.rating_num::text').get(),
'quote': movie.css('span.inq::text').get(),
}
# Gérer la pagination
next_page = response.css('span.next a::attr(href)').get()
if next_page is not None:
yield response.follow(next_page, callback=self.parse)
Analyse du code :
name = "douban_spider": Définit le nom du spider.start_urls: Définit l'URL initiale à partir de laquelle le spider commence à explorer (la page Douban Movie Top 250).parsemethod:Utilise des sélecteurs CSS pour extraire le titre, la note et l'introduction de chaque film.
span.title::text: Extrait le titre du film.span.rating_num::text: Extrait la note du film.span.inq::text: Extrait l'introduction du film.
Gestion de la pagination:
Utiliser
span.next a::attr(href)pour extraire le lien de la page suivante.Si la page suivante existe, utilisez
response.followpour continuer l'exploration.
Exécutez la commande suivante dans la ligne de commande pour démarrer le spider :
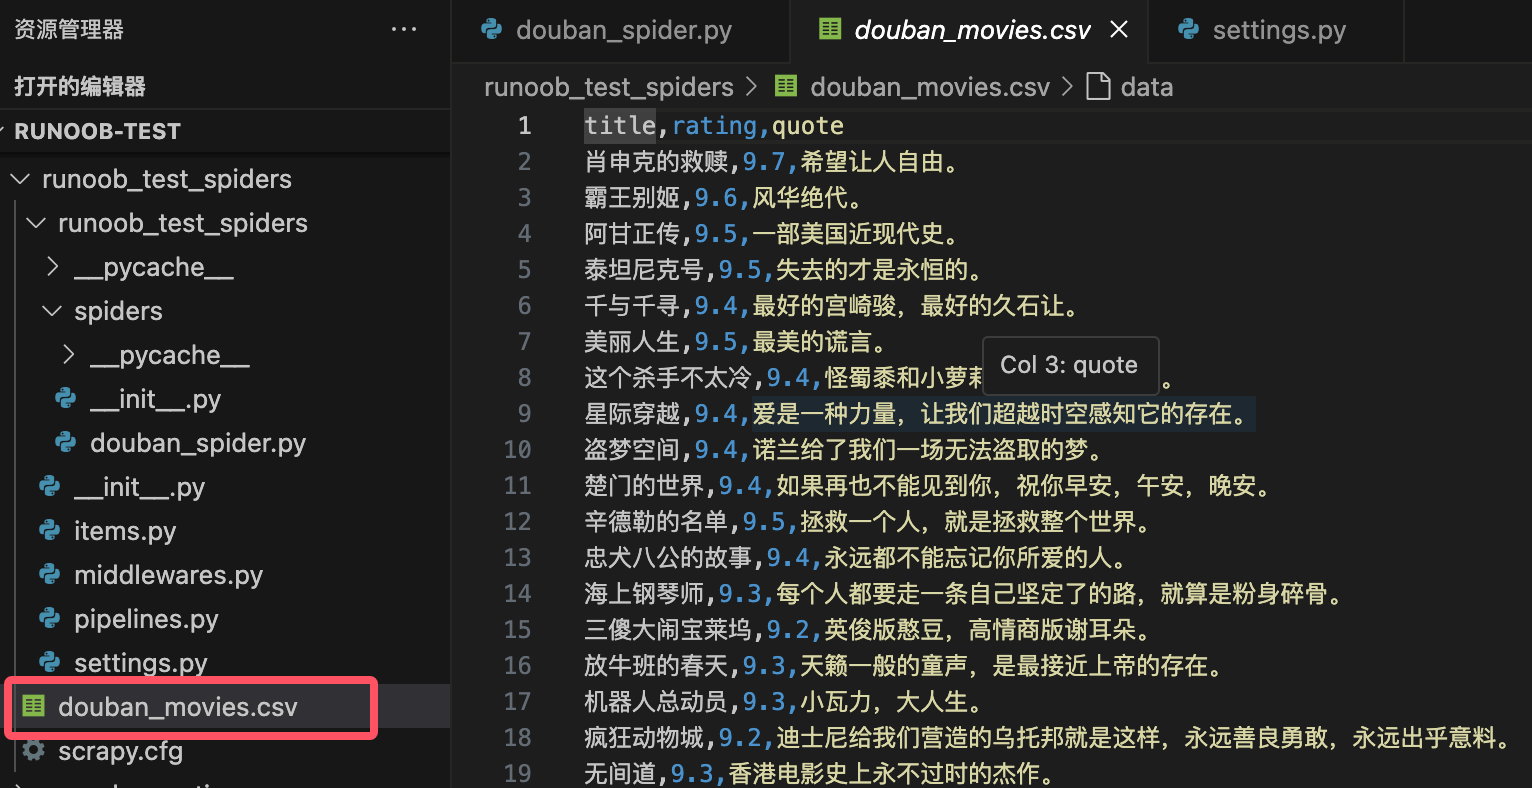
scrapy crawl douban_spider -o douban_movies.csv
Cela démarrera le spider et enregistrera les données extraites dans le fichier douban_movies.csv.
Remarque : Le contenu ci-dessus est uniquement à des fins d'apprentissage. Lors du scraping de données, veuillez respecter les règles du fichier robots.txt du site web cible.
Méthodes courantes
1. Méthodes du spider
| Nom de la méthode | Description | Exemple |
|---|---|---|
start_requests() |
Générer la requête initiale ; vous pouvez personnaliser les en-têtes de requête, les méthodes de requête, etc. | yield scrapy.Request(url, callback=self.parse) |
parse(response) |
Traiter la réponse et extraire les données ; c'est la méthode principale du spider. | yield {'title': response.css('h1::text').get()} |
follow(url, callback) |
Gérer automatiquement les URL relatives et générer de nouvelles requêtes pour la pagination ou la navigation par liens. | yield response.follow(next_page, callback=self.parse) |
closed(reason) |
Appelée lorsque le spider se ferme, utilisée pour nettoyer les ressources ou enregistrer les journaux. | def closed(self, reason): print('Spider closed:', reason) |
log(message) |
Journaliser les informations. | self.log('This is a log message') |
2. Méthodes d'extraction de données
| Nom de la méthode | Description | Exemple |
|---|---|---|
response.css(selector) |
Utiliser les sélecteurs CSS pour extraire des données. | title = response.css('h1::text').get() |
response.xpath(selector) |
Utiliser les sélecteurs XPath pour extraire des données. | title = response.xpath('//h1/text()').get() |
get() |
fromSelectorListExtraire le premier résultat correspondant (chaîne) de |
title = response.css('h1::text').get() |
getall() |
fromSelectorListExtraire tous les résultats correspondants (liste) de |
titles = response.css('h1::text').getall() |
attrib |
Extraire les attributs du nœud actuel. | link = response.css('a::attr(href)').get() |
3. Méthodes de requête et de réponse
| Nom de la méthode | Description | Exemple |
|---|---|---|
scrapy.Request(url, callback, method, headers, meta) |
Créer une nouvelle requête. | yield scrapy.Request(url, callback=self.parse, headers=headers) |
response.url |
Obtenir l'URL de la réponse actuelle. | current_url = response.url |
response.status |
Obtenir le code d'état de la réponse. | if response.status == 200: print('Success') |
response.meta |
Obtenir les données supplémentaires transmises dans la requête. | value = response.meta.get('key') |
response.headers |
Obtenir les en-têtes de la réponse. | content_type = response.headers.get('Content-Type') |
4. Méthodes de middleware et de pipeline
| Nom de la méthode | Description | Exemple |
|---|---|---|
process_request(request, spider) |
Traiter la requête avant son envoi (middleware du downloader). | request.headers['User-Agent'] = 'Mozilla/5.0' |
process_response(request, response, spider) |
Traiter la réponse après son retour (middleware du downloader). | if response.status == 403: return request.replace(dont_filter=True) |
process_item(item, spider) |
Traiter les données extraites (pipeline). | if item['price'] < 0: raise DropItem('Invalid price') |
open_spider(spider) |
Appelé au démarrage du spider (pipeline). | def open_spider(self, spider): self.file = open('items.json', 'w') |
close_spider(spider) |
Appelé à la fermeture du spider (pipeline). | def close_spider(self, spider): self.file.close() |
5. Outils et méthodes d'extension
| Nom de la méthode | Description | Exemple |
|---|---|---|
scrapy shell |
Démarrer le Shell interactif pour le débogage et le test des sélecteurs. | scrapy shell 'http://example.com' |
scrapy crawl <spider_name> |
Exécuter le spider spécifié. | scrapy crawl myspider -o output.json |
scrapy check |
Vérifier l'exactitude du code du spider. | scrapy check |
scrapy fetch |
Télécharger le contenu de l'URL spécifiée. | scrapy fetch 'http://example.com' |
scrapy view |
Afficher la page téléchargée par Scrapy dans un navigateur. | scrapy view 'http://example.com' |
6. Paramètres courants (poursettings.py)
| Élément de configuration | Description | Exemple |
|---|---|---|
USER_AGENT |
Définir le User-Agent dans l'en-tête de la requête. | USER_AGENT = 'Mozilla/5.0' |
ROBOTSTXT_OBEY |
S'il faut obéir auxrobots.txtrègles. |
ROBOTSTXT_OBEY = False |
DOWNLOAD_DELAY |
Définir un délai de téléchargement pour éviter d'effectuer des requêtes trop rapidement. | DOWNLOAD_DELAY = 2 |
CONCURRENT_REQUESTS |
Définir le nombre de requêtes simultanées. | CONCURRENT_REQUESTS = 16 |
ITEM_PIPELINES |
Activer les pipelines. | ITEM_PIPELINES = {'myproject.pipelines.MyPipeline': 300} |
AUTOTHROTTLE_ENABLED |
Activer l'extension auto-throttle. | AUTOTHROTTLE_ENABLED = True |
7. Autres méthodes courantes
| Nom de la méthode | Description | Exemple |
|---|---|---|
response.follow_all(links, callback) |
Traiter les liens par lots et générer des requêtes. | yield from response.follow_all(links, callback=self.parse) |
response.json() |
Analyser le contenu de la réponse au format JSON. | data = response.json() |
response.text |
Obtenir le contenu textuel de la réponse. | html = response.text |
response.selector |
Obtenir le contenu de la réponseSelectorobjet. |
title = response.selector.css('h1::text').get() |
Le tableau ci-dessus répertorie les méthodes couramment utilisées dans Scrapy et leurs fonctions. Ces méthodes couvrent divers aspects du développement de crawlers, notamment la génération de requêtes, l'extraction de données, le traitement des middlewares, les opérations de pipeline, etc. En maîtrisant ces méthodes, vous pouvez écrire et gérer efficacement des crawlers Scrapy. Pour des fonctionnalités plus détaillées, veuillez vous référer àDocumentation officielle de Scrapy。
Exemples d'utilisation de la méthode
1. start_requests()
start_requests()La méthode est le point d'entrée d'un crawler Scrapy, utilisée pour générer les requêtes initiales. Habituellement, l'URL de départ du crawler est définie dans cette méthode.
Exemple
class MySpider(scrapy.Spider):
name = 'myspider'
def start_requests(self):
urls = [
'http://example.com/page1',
'http://example.com/page2',
]
for url in urls:
yield scrapy.Request(url=url, callback=self.parse)
2. parse()
parse()La méthode est la méthode de gestion des réponses par défaut, utilisée pour analyser les réponses et extraire des données ou générer de nouvelles requêtes.
Exemple
# Extraire le titre de la page
title = response.css('title::text').get()
yield {
'title': title
}
3. parse_item()
parse_item()La méthode est utilisée pour analyser la réponse d'un seul élément (Item), généralement pour extraire des données structurées.
Exemple
item = {}
item['name'] = response.css('div.name::text').get()
item['price'] = response.css('div.price::text').get()
yield item
4. follow()
follow()La méthode est utilisée pour générer de nouvelles requêtes et gérer automatiquement les réponses, généralement pour le suivi des liens.
Exemple
for link in response.css('a::attr(href)'):
yield response.follow(link, self.parse_item)
5. yield
yieldLe mot-clé est utilisé pour générer des requêtes ou des éléments (Item), et les transmettre au moteur Scrapy pour traitement.
Exemple
yield {
'title': response.css('title::text').get()
}
6. Item
ItemLa classe est utilisée pour définir des structures de données, généralement pour stocker les données extraites des pages web.
Exemple
class MyItem(scrapy.Item):
name = scrapy.Field()
price = scrapy.Field()
7. ItemLoader
ItemLoaderLa classe est utilisée pour charger et remplir des objets Item, simplifiant le flux de travail d'extraction et de traitement des données.
Exemple
from myproject.items import MyItem
def parse(self, response):
loader = ItemLoader(item=MyItem(), response=response)
loader.add_css('name', 'div.name::text')
loader.add_css('price', 'div.price::text')
yield loader.load_item()
8. Request
RequestLa classe est utilisée pour générer des objets de requête HTTP, généralement pour définir des URL de requête, des méthodes de rappel, etc.
Exemple
def parse(self, response):
yield scrapy.Request(url='http://example.com/page3', callback=self.parse_item)
9. Response
ResponseLa classe représente un objet de réponse HTTP, contenant des informations telles que le contenu HTML et le code d'état renvoyés par le serveur.
Exemple
print(response.status) # Afficher le code d'état de la réponse
print(response.body) # Afficher le contenu de la réponse
10. Selector
SelectorLa classe est utilisée pour extraire des données de documents HTML ou XML, en prenant en charge les sélecteurs XPath et CSS.
Exemple
title = response.xpath('//title/text()').get()
yield {
'title': title
}
11. CrawlSpider
CrawlSpiderIl s'agit d'une classe Spider spéciale utilisée pour gérer des règles d'exploration complexes et le suivi des liens.
Exemple
from scrapy.linkextractors import LinkExtractor
class MyCrawlSpider(CrawlSpider):
name = 'mycrawlspider'
allowed_domains = ['example.com']
start_urls = ['http://example.com']
rules = (
Rule(LinkExtractor(allow=('page/\d+',)), callback='parse_item'),
)
def parse_item(self, response):
yield {
'title': response.css('title::text').get()
}
12. LinkExtractor
LinkExtractorLa classe est utilisée pour extraire les liens à partir des réponses, généralement pour suivre automatiquement les liens dans les pages.
Exemple
def parse(self, response):
extractor = LinkExtractor(allow=('page/\d+',))
links = extractor.extract_links(response)
for link in links:
yield scrapy.Request(link.url, callback=self.parse_item)
13. Pipeline
PipelineLa classe est utilisée pour traiter les données extraites, généralement pour le nettoyage des données, le stockage et d'autres opérations.
Exemple
def process_item(self, item, spider):
# Traiter les données de l'élément
return item
14. Middleware
MiddlewareLa classe est utilisée pour le traitement par middleware des requêtes et des réponses, généralement pour modifier les en-têtes de requête, gérer les exceptions, etc.
Exemple
def process_request(self, request, spider):
# Modifier les en-têtes de requête
request.headers['User-Agent'] = 'MyCustomUserAgent'
return None