Python Scrapy ライブラリ
Scrapy は、Web ページのデータを取得して情報を抽出するために特化した、強力な Python クローラーフレームワークです。
Scrapy は、データマイニング、情報処理、履歴データの保存などのアプリケーションでよく使用されます。
Scrapy には、リクエストの処理、ステータスの追跡、エラーの処理、リクエスト頻度の制限などの便利な機能が組み込まれており、効率的で分散型の Web クロールに非常に適しています。
単純なクローラーライブラリ(例えばrequestsとBeautifulSoup)とは異なり、Scrapy はフル機能のクローラーフレームワークであり、高度な拡張性と柔軟性を備え、複雑で大規模な Web スクレイピングタスクに適しています。
Scrapy 公式サイト:https://scrapy.org/。
Scrapy の特徴と紹介:https://www.example.com/w3cnote/scrapy-detail.html。
Scrapy アーキテクチャ図(緑線はデータフロー):
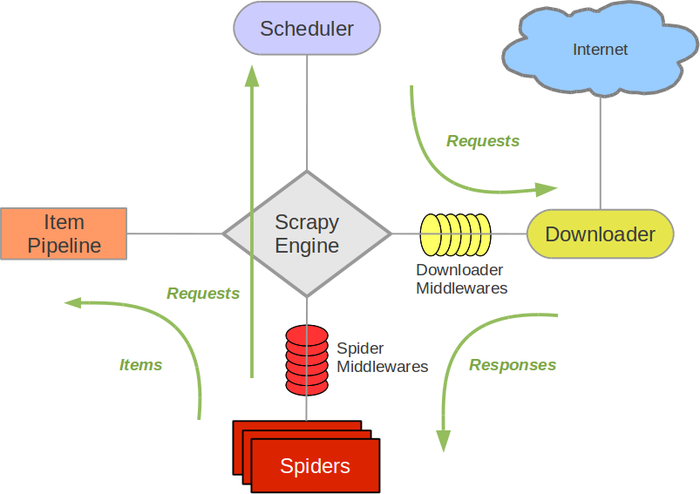
Scrapy の動作は、以下のいくつかのコアコンポーネントに基づいています:
- Spider:クローラークラス。Webページからデータを抽出する方法と、Webページのリンクを追跡する方法を定義するために使用されます。
- Item:取得したデータを定義および保存するために使用します。データモデルに相当します。
- Pipeline:取得したデータを処理するために使用され、データのクリーニングや保存などの操作によく使用されます。
- Middleware:リクエストとレスポンスを処理するために使用され、プロキシの設定、Cookie の処理、ユーザーエージェントなどに使用できます。
- Settings:Scrapy プロジェクトの各種設定(リクエスト遅延、同時リクエスト数など)を構成するために使用します。
Scrapy のインストール
Scrapy を使用する前に、まずインストールする必要があります。pip を使用してインストールします:
pip install scrapy
Scrapy プロジェクト構造
Scrapy プロジェクトは構造化されたディレクトリであり、複数のフォルダーとモジュールが含まれていて、クローラーのコードを整理するのに役立ちます。
Scrapy はコマンドラインツールを使用してクローラープロジェクトを作成および管理します。次のコマンドを使用して新しい Scrapy プロジェクトを作成できます:
scrapy startproject myproject
これにより、myproject という名前のプロジェクトが作成されます。プロジェクト構造はおおよそ次のとおりです:
myproject/
    scrapy.cfg            # 项目的配置文件
    myproject/            # 项目源代码文件夹
        __init__.py
        items.py          # 定义抓取的数据结构
        middlewares.py    # 定义中间件
        pipelines.py      # 定义数据处理管道
        settings.py       # 项目的设置文件
        spiders/           # 存放爬虫代码的文件夹
            __init__.py
            myspider.py   # 自定义的爬虫代码
簡単な Scrapy クローラーを作成する
以下は、Web ページからデータを取得する方法を示す基本的な Scrapy クローラーの例です。
クローラープロジェクトを作成します:
scrapy startproject サンプル_test_spiders
上記のコマンドを実行すると、成功した場合次のように出力されます:
templates/project', created in:/Users/サンプル/サンプル-test/サンプル_test_spiders

You can start your first spider with:
    cd サンプル_test_spiders
    scrapy genspider example example.com
生成されたプロジェクト構造は次のとおりです:
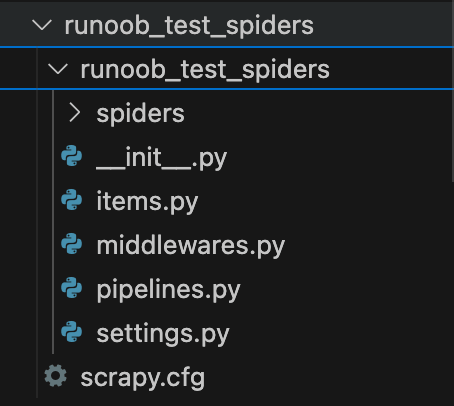
次に、そのディレクトリに移動します:
cd サンプル_test_spiders
次に、scrapy genspiderコマンドを使用してクローラーを作成します:
scrapy genspider douban_spider movie.douban.com
ディレクトリ構造は次のとおりです:
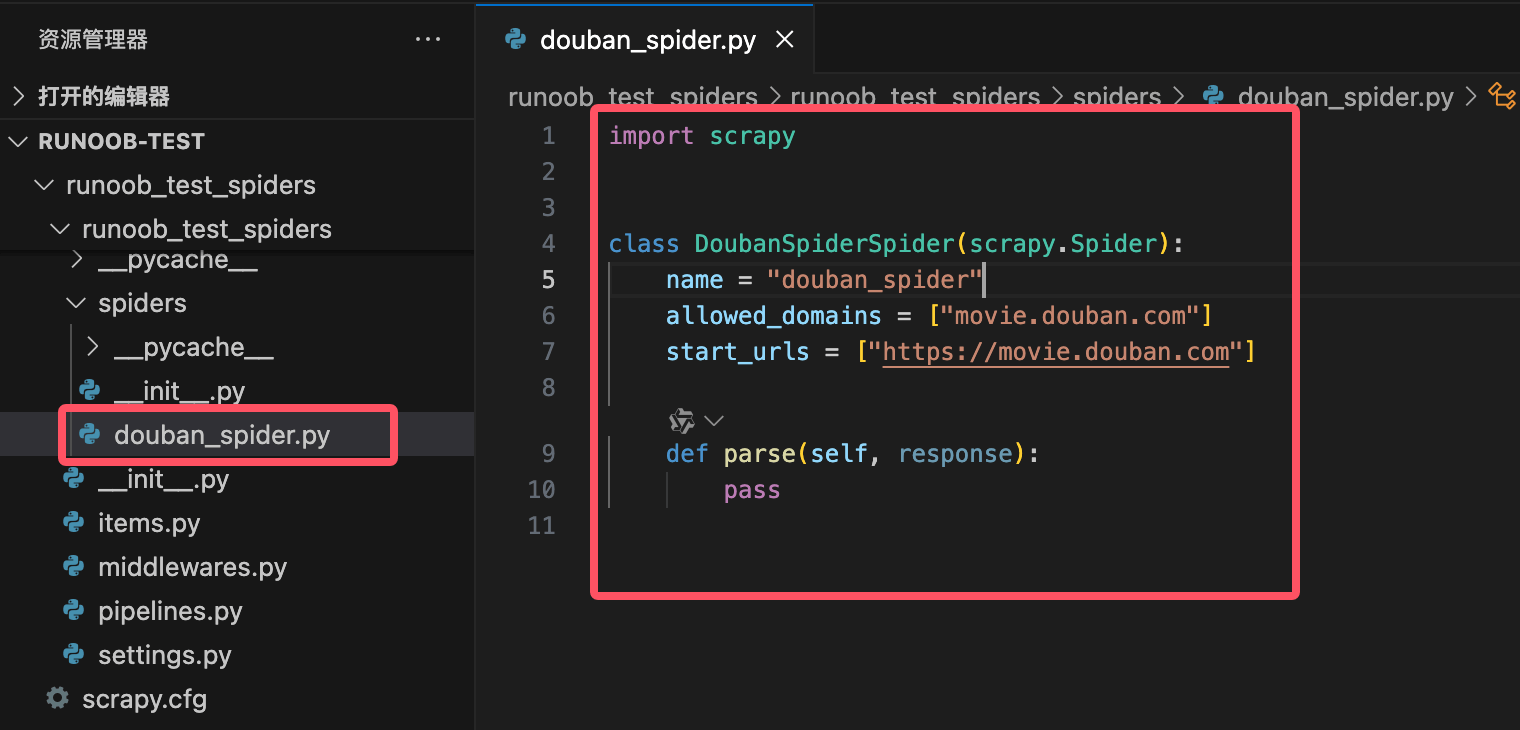
サンプル_test_spiders ディレクトリに douban_spider.py という名前のファイルが生成されます。コードは次のとおりです:
例
class DoubanSpiderSpider(scrapy.Spider):
name = "douban_spider"
allowed_domains = ["movie.douban.com"]
start_urls = ["https://movie.douban.com"]
def parse(self, response):
pass
コードの説明:
name:クローラーの名前を定義します。一意である必要があります。allowed_domains:クローラーのアクセスドメインを制限し、他のドメインの Web ページをクロールしないようにします。start_urls:クローラーの開始ページを定義します。クローラーはこれらのページから取得を開始します。parse:parseメソッドは各クローラーのコア部分であり、レスポンスを処理してデータを抽出するために使用されます。これはresponseオブジェクトを受け取ります。サーバーが返すページのコンテンツを表します。
クローラーコードを書く
クローラーコードを書く前に、いくつか注意すべき点があります:
- 豆瓣などの Web サイトはクローラーの動作を検出する可能性があるため、USER_AGENT と DOWNLOAD_DELAY を設定して通常のユーザーの動作をシミュレートすることをお勧めします。
- データをクロールする際は、対象 Web サイトの robots.txt ファイルの規定を遵守し、サーバーに過度な負荷をかけないようにしてください。
- 頻繁にクロールすると、IP がブロックされる可能性があります。
settings.py の設定を変更する
settings.py に以下の設定を追加して、ブラウザのリクエストをシミュレートし、アンチクローリングメカニズムを回避します:
# 设置 User-Agent
USER_AGENT = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36'

# 不遵守 robots.txt 规则
ROBOTSTXT_OBEY = False

# 设置下载延迟,避免过快请求
DOWNLOAD_DELAY = 2

# 启用自动限速扩展
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 2
AUTOTHROTTLE_MAX_DELAY = 5
クローラーコードでは、カスタムリクエストヘッダー(User-Agent や Referer など)を追加して、ブラウザの動作をさらにシミュレートします。
douban_spider.py ファイルを開き、その内容を次のように変更します:
例
class DoubanSpider(scrapy.Spider):
name = "douban_spider"
start_urls = [
'https://movie.douban.com/top250',
]
def start_requests(self):
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36',
'Referer': 'https://movie.douban.com/',
}
for url in self.start_urls:
yield scrapy.Request(url, headers=headers, callback=self.parse)
def parse(self, response):
for movie in response.css('div.item'):
yield {
'title': movie.css('span.title::text').get(),
'rating': movie.css('span.rating_num::text').get(),
'quote': movie.css('span.inq::text').get(),
}
# ページネーションを処理
next_page = response.css('span.next a::attr(href)').get()
if next_page is not None:
yield response.follow(next_page, callback=self.parse)
コードの解析:
name = "douban_spider":クローラーの名前を定義します。start_urls:クローラーがクロールを開始する初期 URL(豆瓣电影 Top 250 ページ)を定義します。parseメソッド:CSS セレクターを使用して、各映画のタイトル、評価、概要を抽出します。
span.title::text:映画のタイトルを抽出します。span.rating_num::text:映画の評価を抽出します。span.inq::text:映画の概要を抽出します。
ページネーション処理:
使用して
span.next a::attr(href)次のページのリンクを抽出します。次のページが存在する場合、使用
response.followしてクロールを続行します。
コマンドラインで次のコマンドを実行してクローラーを起動します:
scrapy crawl douban_spider -o douban_movies.csv
これによりクローラーが起動し、抽出したデータが douban_movies.csv ファイルに保存されます。
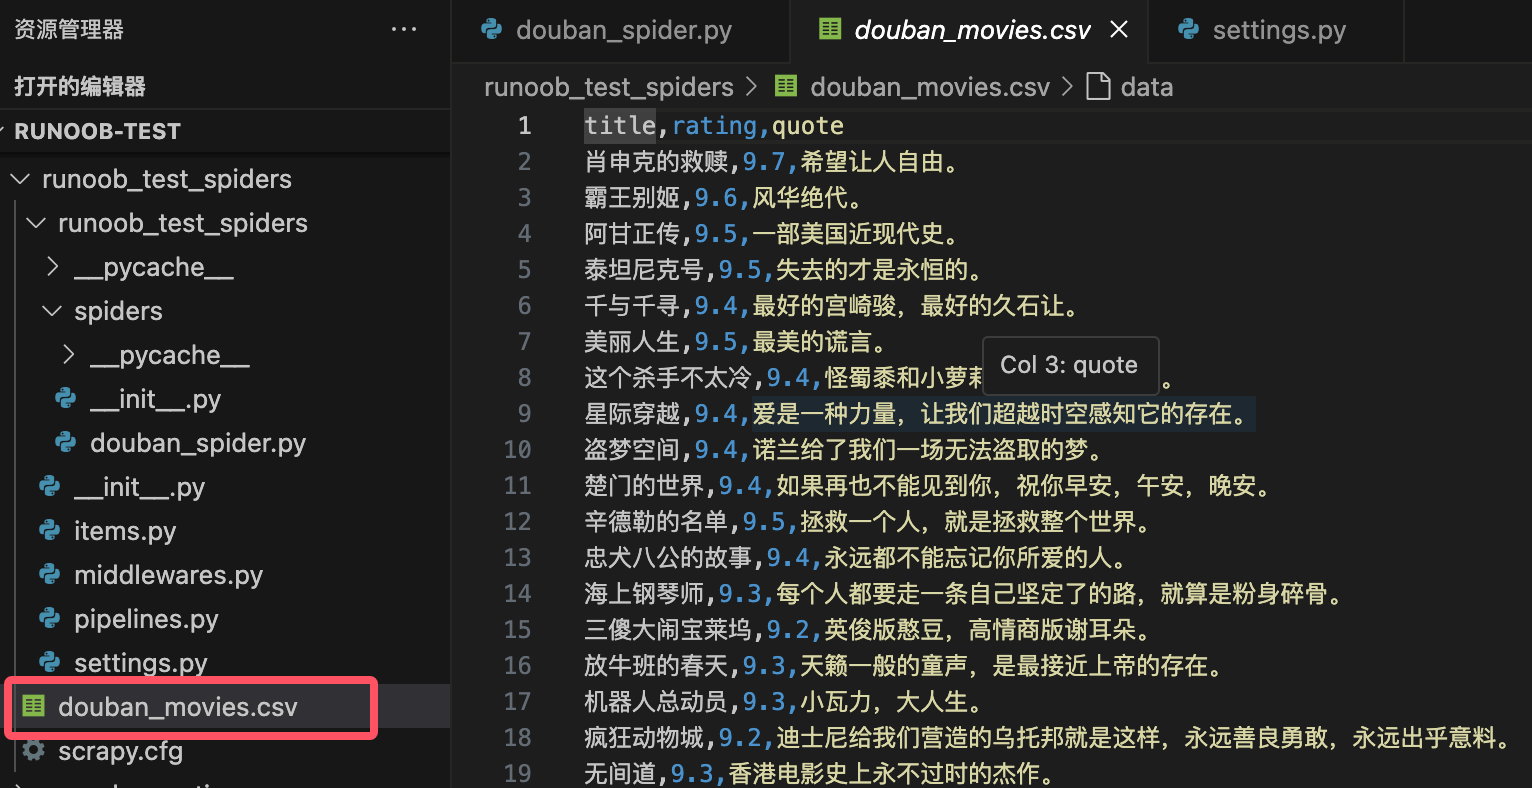
注意:上記の内容は学習のみを目的としています。データをクロールする際は、対象 Web サイトの robots.txt ファイルの規定を遵守してください。
よく使うメソッド
1. クローラーメソッド
| メソッド名 | 機能説明 | 例 |
|---|---|---|
start_requests() |
初期リクエストを生成し、リクエストヘッダーやリクエストメソッドなどをカスタマイズできます。 | yield scrapy.Request(url, callback=self.parse) |
parse(response) |
レスポンスを処理してデータを抽出する、クローラーのコアメソッドです。 | yield {'title': response.css('h1::text').get()} |
follow(url, callback) |
相対 URL を自動的に処理して新しいリクエストを生成し、ページネーションやリンクジャンプに使用します。 | yield response.follow(next_page, callback=self.parse) |
closed(reason) |
クローラーが閉じられるときに呼び出され、リソースのクリーンアップやログの記録に使用します。 | def closed(self, reason): print('Spider closed:', reason) |
log(message) |
ログ情報を記録します。 | self.log('This is a log message') |
2. データ抽出メソッド
| メソッド名 | 機能説明 | 例 |
|---|---|---|
response.css(selector) |
CSS セレクターを使用してデータを抽出します。 | title = response.css('h1::text').get() |
response.xpath(selector) |
XPath セレクターを使用してデータを抽出します。 | title = response.xpath('//h1/text()').get() |
get() |
からSelectorListから最初に一致する結果(文字列)を抽出します。 |
title = response.css('h1::text').get() |
getall() |
からSelectorListから一致するすべての結果(リスト)を抽出します。 |
titles = response.css('h1::text').getall() |
attrib |
現在のノードの属性を抽出します。 | link = response.css('a::attr(href)').get() |
3. リクエストとレスポンスのメソッド
| メソッド名 | 機能説明 | 例 |
|---|---|---|
scrapy.Request(url, callback, method, headers, meta) |
新しいリクエストを作成します。 | yield scrapy.Request(url, callback=self.parse, headers=headers) |
response.url |
現在のレスポンスの URL を取得します。 | current_url = response.url |
response.status |
レスポンスのステータスコードを取得します。 | if response.status == 200: print('Success') |
response.meta |
リクエストで渡された追加データを取得します。 | value = response.meta.get('key') |
response.headers |
レスポンスのヘッダー情報を取得します。 | content_type = response.headers.get('Content-Type') |
4. ミドルウェアとパイプラインメソッド
| メソッド名 | 機能説明 | 例 |
|---|---|---|
process_request(request, spider) |
リクエスト送信前にリクエストを処理します(ダウンローダーミドルウェア)。 | request.headers['User-Agent'] = 'Mozilla/5.0' |
process_response(request, response, spider) |
レスポンス返却後にレスポンスを処理します(ダウンローダーミドルウェア)。 | if response.status == 403: return request.replace(dont_filter=True) |
process_item(item, spider) |
抽出したデータを処理します(パイプライン)。 | if item['price'] < 0: raise DropItem('Invalid price') |
open_spider(spider) |
クローラー起動時に呼び出されます(パイプライン)。 | def open_spider(self, spider): self.file = open('items.json', 'w') |
close_spider(spider) |
クローラー終了時に呼び出されます(パイプライン)。 | def close_spider(self, spider): self.file.close() |
5. ツールと拡張メソッド
| メソッド名 | 機能説明 | 例 |
|---|---|---|
scrapy shell |
対話型シェルを起動し、セレクターのデバッグとテストに使用します。 | scrapy shell 'http://example.com' |
scrapy crawl <spider_name> |
指定したクローラーを実行します。 | scrapy crawl myspider -o output.json |
scrapy check |
クローラーコードの正確性を確認します。 | scrapy check |
scrapy fetch |
指定した URL のコンテンツをダウンロードします。 | scrapy fetch 'http://example.com' |
scrapy view |
ブラウザで Scrapy がダウンロードしたページを表示します。 | scrapy view 'http://example.com' |
6. よく使う設定(settings.py)
| 設定項目 | 機能説明 | 例 |
|---|---|---|
USER_AGENT |
リクエストヘッダーの User-Agent を設定します。 | USER_AGENT = 'Mozilla/5.0' |
ROBOTSTXT_OBEY |
遵守するかどうかrobots.txtルール。 |
ROBOTSTXT_OBEY = False |
DOWNLOAD_DELAY |
ダウンロード遅延を設定して、リクエストが速すぎないようにします。 | DOWNLOAD_DELAY = 2 |
CONCURRENT_REQUESTS |
同時リクエスト数を設定します。 | CONCURRENT_REQUESTS = 16 |
ITEM_PIPELINES |
パイプラインを有効にします。 | ITEM_PIPELINES = {'myproject.pipelines.MyPipeline': 300} |
AUTOTHROTTLE_ENABLED |
自動速度制限拡張を有効にします。 | AUTOTHROTTLE_ENABLED = True |
7. その他のよく使うメソッド
| メソッド名 | 機能説明 | 例 |
|---|---|---|
response.follow_all(links, callback) |
リンクを一括処理してリクエストを生成します。 | yield from response.follow_all(links, callback=self.parse) |
response.json() |
レスポンスのコンテンツを JSON 形式に解析します。 | data = response.json() |
response.text |
レスポンスのテキストコンテンツを取得します。 | html = response.text |
response.selector |
レスポンスコンテンツのSelectorオブジェクト。 |
title = response.selector.css('h1::text').get() |
上記の表は、Scrapyでよく使われるメソッドとその役割をまとめたものです。これらのメソッドは、リクエスト生成、データ抽出、ミドルウェア処理、パイプライン操作など、クローラー開発のあらゆる側面をカバーしています。これらのメソッドを習得することで、Scrapyクローラーを効率的に作成・管理できます。より詳細な機能が必要な場合は、次を参照してください。Scrapy公式ドキュメント。
メソッド使用例
1. start_requests()
start_requests()メソッドはScrapyクローラーのエントリーポイントであり、初期リクエストの生成に使用されます。通常、このメソッドでクローラーの開始URLを定義します。
例
class MySpider(scrapy.Spider):
name = 'myspider'
def start_requests(self):
urls = [
'http://example.com/page1',
'http://example.com/page2',
]
for url in urls:
yield scrapy.Request(url=url, callback=self.parse)
2. parse()
parse()メソッドはデフォルトのレスポンス処理メソッドであり、レスポンスを解析してデータを抽出したり、新しいリクエストを生成したりするために使用されます。
例
# ページタイトルを抽出
title = response.css('title::text').get()
yield {
'title': title
}
3. parse_item()
parse_item()メソッドは、単一のアイテム(Item)のレスポンスを解析するために使用され、通常は構造化データの抽出に使用されます。
例
item = {}
item['name'] = response.css('div.name::text').get()
item['price'] = response.css('div.price::text').get()
yield item
4. follow()
follow()メソッドは、新しいリクエストを生成してレスポンスを自動処理するために使用され、通常はリンクの追跡に使用されます。
例
for link in response.css('a::attr(href)'):
yield response.follow(link, self.parse_item)
5. yield
yieldキーワードは、リクエストまたはアイテム(Item)を生成し、Scrapyエンジンに渡して処理するために使用されます。
例
yield {
'title': response.css('title::text').get()
}
6. Item
Itemクラスはデータ構造を定義するために使用され、通常はWebページから抽出したデータを格納するために使用されます。
例
class MyItem(scrapy.Item):
name = scrapy.Field()
price = scrapy.Field()
7. ItemLoader
ItemLoaderクラスはItemオブジェクトをロードして値を入力するために使用され、データ抽出と処理のフローを簡素化します。
例
from myproject.items import MyItem
def parse(self, response):
loader = ItemLoader(item=MyItem(), response=response)
loader.add_css('name', 'div.name::text')
loader.add_css('price', 'div.price::text')
yield loader.load_item()
8. Request
RequestクラスはHTTPリクエストオブジェクトを生成するために使用され、通常はリクエストのURLやコールバックメソッドなどを定義するために使用されます。
例
def parse(self, response):
yield scrapy.Request(url='http://example.com/page3', callback=self.parse_item)
9. Response
ResponseクラスはHTTPレスポンスオブジェクトを表し、サーバーから返されたHTMLコンテンツ、ステータスコードなどの情報を含みます。
例
print(response.status) # レスポンスステータスコードを出力
print(response.body) # レスポンス内容を出力
10. Selector
SelectorクラスはHTMLまたはXMLドキュメントからデータを抽出するために使用され、XPathおよびCSSセレクターをサポートしています。
例
title = response.xpath('//title/text()').get()
yield {
'title': title
}
11. CrawlSpider
CrawlSpiderは特殊なSpiderクラスであり、複雑なクロールルールとリンク追跡を処理するために使用されます。
例
from scrapy.linkextractors import LinkExtractor
class MyCrawlSpider(CrawlSpider):
name = 'mycrawlspider'
allowed_domains = ['example.com']
start_urls = ['http://example.com']
rules = (
Rule(LinkExtractor(allow=('page/\d+',)), callback='parse_item'),
)
def parse_item(self, response):
yield {
'title': response.css('title::text').get()
}
12. LinkExtractor
LinkExtractorクラスはレスポンスからリンクを抽出するために使用され、通常はページ内のリンクを自動追跡するために使用されます。
例
def parse(self, response):
extractor = LinkExtractor(allow=('page/\d+',))
links = extractor.extract_links(response)
for link in links:
yield scrapy.Request(link.url, callback=self.parse_item)
13. Pipeline
Pipelineクラスはクロールされたデータを処理するために使用され、通常はデータのクリーニングや保存などの操作に使用されます。
例
def process_item(self, item, spider):
# アイテムデータを処理
return item
14. Middleware
Middlewareクラスはリクエストとレスポンスを処理するミドルウェアであり、通常はリクエストヘッダーの変更や例外処理などの操作に使用されます。
例
def process_request(self, request, spider):
# リクエストヘッダーを変更
request.headers['User-Agent'] = 'MyCustomUserAgent'
return None