Scrapy ist ein in Python geschriebenes Anwendungsframework zum Crawlen von Website-Daten und zum Extrahieren strukturierter Daten.
Scrapy wird häufig in einer Reihe von Programmen eingesetzt, darunter Data Mining, Informationsverarbeitung oder Speicherung historischer Daten.
Normalerweise können wir mit dem Scrapy-Framework leicht einen Crawler implementieren, um die Inhalte oder Bilder einer bestimmten Website abzurufen.
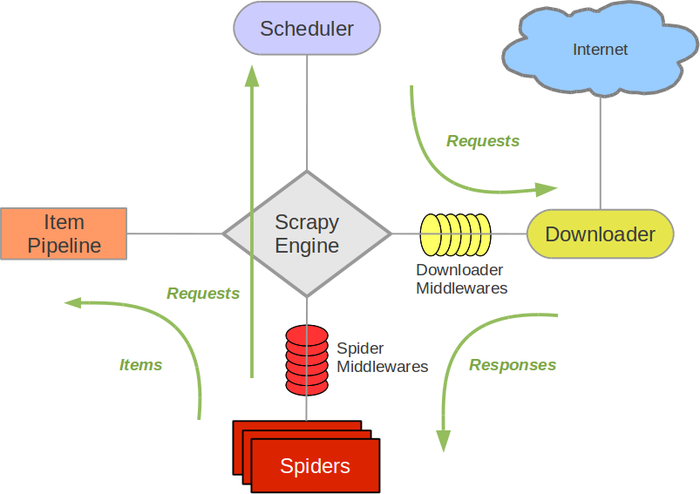
Scrapy-Architekturdiagramm (grüne Linien zeigen den Datenfluss an)
-
Scrapy Engine: Verantwortlich für Kommunikation, Signale, Datenübertragung usw. zwischen Spider, ItemPipeline, Downloader und Scheduler.
-
Scheduler: Er ist dafür verantwortlich, die von der Engine gesendeten Request-Anfragen anzunehmen, sie auf eine bestimmte Weise zu organisieren und anzuordnen, in eine Warteschlange einzureihen und sie an die Engine zurückzugeben, wenn die Engine sie benötigt.
-
Downloader: Er ist dafür verantwortlich, alle von der Scrapy Engine gesendeten Requests herunterzuladen und die erhaltenen Responses an die Scrapy Engine zurückzugeben, die sie dann zur Verarbeitung an den Spider übergibt.
-
Spider: Er ist dafür verantwortlich, alle Responses zu verarbeiten, Daten daraus zu analysieren und zu extrahieren, die für Item-Felder benötigten Daten zu erhalten und die URLs, denen gefolgt werden muss, an die Engine zu übermitteln, die dann wieder in den Scheduler gelangt.
-
Item Pipeline: Sie ist für die Verarbeitung der vom Spider erhaltenen Items verantwortlich und der Ort für die Nachbearbeitung (detaillierte Analyse, Filterung, Speicherung usw.).
-
Downloader Middlewares: Man kann sie sich als eine Komponente vorstellen, die eine benutzerdefinierte Erweiterung der Download-Funktionalität ermöglicht.
-
Spider Middlewares: Man kann sie als eine funktionale Komponente verstehen, die eine benutzerdefinierte Erweiterung und Manipulation der Kommunikation zwischen der Engine und dem Spider ermöglicht (z. B. Responses, die in den Spider gelangen; und Requests, die den Spider verlassen).
Scrapy-Arbeitsprozess
Sobald der Code geschrieben ist, startet das Programm...
- 1 Engine: Hallo! Spider, welche Website möchtest du verarbeiten?
- 2 Spider: Der Chef möchte, dass ich xxxx.com bearbeite.
- 3 Engine: Gib mir die erste URL zum Verarbeiten.
- 4 Spider: Hier bitte, die erste URL ist xxxxxxx.com.
- 5 Engine: Hallo! Scheduler, ich habe hier einen Request, bitte sortiere ihn und reihe ihn für mich in die Warteschlange ein.
- 6 Scheduler: Okay, ich verarbeite ihn, warte einen Moment.
- 7 Engine: Hallo! Scheduler, gib mir den verarbeiteten Request.
- 8 Scheduler: Hier bitte, das ist der verarbeitete Request.
- 9 Engine: Hallo! Downloader, bitte lade diesen Request gemäß den Downloader-Middleware-Einstellungen des Chefs herunter.
- 10 Downloader: Okay! Hier bitte, das ist der heruntergeladene Inhalt. (Wenn es fehlschlägt: Entschuldigung, dieser Request konnte nicht heruntergeladen werden. Dann teilt die Engine dem Scheduler mit, dass dieser Request nicht heruntergeladen werden konnte; notiere ihn, und wir werden ihn später erneut herunterladen.)
- 11 Engine: Hallo! Spider, dies sind die heruntergeladenen Inhalte, und sie wurden bereits gemäß der Downloader-Middleware des Bosses verarbeitet. Kümmere dich selbst darum. (Hinweis! Hier wird die Antwort standardmäßig an die Funktion def parse() zur Verarbeitung übergeben.)
- 12 Spider: (Nach der Verarbeitung der Daten, für URLs, die weiterverfolgt werden müssen), Hallo! Engine, ich habe hier zwei Ergebnisse. Dies ist die URL, die ich weiterverfolgen muss, und dies sind die Item-Daten, die ich erhalten habe.
- 13 Engine: Hallo! Pipeline, ich habe hier ein Item, bitte verarbeite es für mich! Scheduler! Dies ist die URL, die weiterverfolgt werden muss, bitte verarbeite sie für mich. Dann wiederhole ab Schritt 4, bis alle Informationen, die der Boss benötigt, erhalten wurden.
- 14 Pipeline und Scheduler: Okay, wir erledigen es sofort!
Hinweis! Das gesamte Programm wird erst beendet, wenn keine weiteren Anfragen mehr im Scheduler vorhanden sind. (Das heißt, Scrapy wird URLs, die nicht heruntergeladen werden konnten, ebenfalls erneut herunterladen.)
Das Erstellen eines Scrapy-Crawlers erfordert insgesamt 4 Schritte:
- Ein neues Projekt erstellen (scrapy startproject xxx): Ein neues Crawler-Projekt erstellen.
- Das Ziel definieren (items.py schreiben): Definieren Sie das Ziel, das Sie crawlen möchten.
- Den Crawler erstellen (spiders/xxspider.py): Erstellen Sie einen Crawler, um mit dem Crawlen von Webseiten zu beginnen.
- Inhalte speichern (pipelines.py): Entwerfen Sie Pipelines, um die gecrawlten Inhalte zu speichern.
Installation
Windows-Installationsmethode
Die pip-Version aktualisieren:
pip install --upgrade pip
Installieren Sie das Scrapy-Framework über pip:
pip install Scrapy
Ubuntu-Installationsmethode
Nicht-Python-Abhängigkeiten installieren:
sudo apt-get install python-dev python-pip libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev
Installieren Sie das Scrapy-Framework über pip:
sudo pip install scrapy
Mac-OS-Installationsmethode
Beim Mac-OS-System kann, da das System selbst auf seine integrierten python2.x-Bibliotheken verweist, die standardmäßig installierten Pakete nicht gelöscht werden. Allerdings führt die Installation von Scrapy mit python2.x zu einem Fehler, und die Installation mit python3.x führt ebenfalls zu einem Fehler. Letztendlich habe ich keinen Weg gefunden, Scrapy direkt zu installieren, daher verwende ich eine andere Installationsmethode, um die Installationsschritte zu erläutern. Die Lösung besteht darin, virtualenv für die Installation zu verwenden.
$ sudo pip install virtualenv
$ virtualenv scrapyenv
$ cd scrapyenv
$ source bin/activate
$ pip install Scrapy
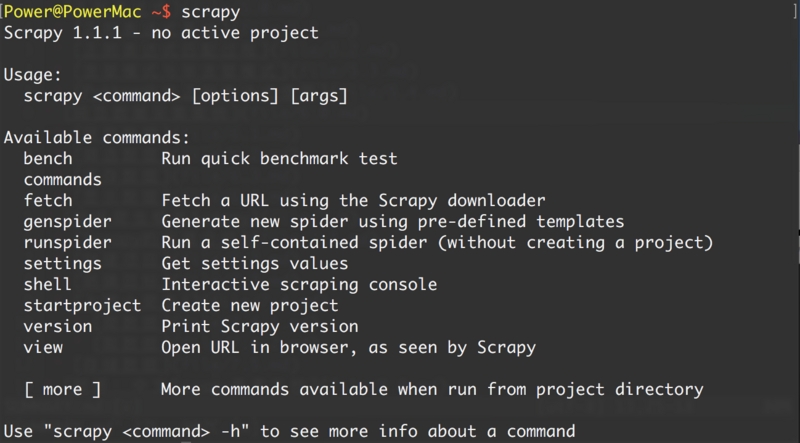
Geben Sie nach der Installation einfach scrapy im Befehls-Terminal ein. Wenn ein Ergebnis ähnlich dem folgenden angezeigt wird, bedeutet dies, dass die Installation erfolgreich war.
Einstiegsbeispiel
Lernziele
- Ein Scrapy-Projekt erstellen
- Die zu extrahierenden strukturierten Daten (Item) definieren
- Schreiben Sie einen Spider, um die Website zu crawlen und strukturierte Daten (Item) zu extrahieren
- Schreiben Sie Item Pipelines, um die extrahierten Items (d. h. strukturierte Daten) zu speichern
1. Ein neues Projekt erstellen (scrapy startproject)
Bevor Sie mit dem Crawlen beginnen, müssen Sie ein neues Scrapy-Projekt erstellen. Wechseln Sie in das benutzerdefinierte Projektverzeichnis und führen Sie den folgenden Befehl aus:
scrapy startproject mySpider
Hier ist mySpider der Projektname. Sie werden sehen, dass ein mySpider-Ordner erstellt wird, und die Verzeichnisstruktur sieht ungefähr wie folgt aus:
Lassen Sie uns kurz die Rolle jeder Hauptdatei vorstellen:
mySpider/
    scrapy.cfg
    mySpider/
        __init__.py
        items.py
        pipelines.py
        settings.py
        spiders/
            __init__.py
            ...
Diese Dateien sind:
- scrapy.cfg: Die Projektkonfigurationsdatei.
- mySpider/: Das Python-Modul des Projekts, von hier aus wird Code referenziert.
- mySpider/items.py: Die Zieldatei des Projekts.
- mySpider/pipelines.py: Die Pipeline-Datei des Projekts.
- mySpider/settings.py: Die Einstellungsdatei des Projekts.
- mySpider/spiders/: Das Verzeichnis, in dem Crawler-Code gespeichert wird.
2. Das Ziel definieren (mySpider/items.py)
Wir planen,http://www.itcast.cn/channel/teacher.shtmldie Namen, Titel und persönlichen Informationen aller Lehrkräfte auf der Website zu crawlen.
Öffne items.py im Verzeichnis mySpider.
Item definiert strukturierte Datenfelder, die zum Speichern der gecrawlten Daten verwendet werden. Es ähnelt ein wenig einem dict in Python, bietet jedoch einen zusätzlichen Schutz, um Fehler zu reduzieren.
Du kannst ein Item definieren, indem du eine scrapy.Item-Klasse erstellst und Klassenattribute vom Typ scrapy.Field definierst (was man als ähnlich zu einer ORM-Mapping-Beziehung verstehen kann).
Als Nächstes erstellst du eine ItcastItem-Klasse und konstruierst das Item-Modell.
import scrapy

class ItcastItem(scrapy.Item):
   name = scrapy.Field()
   title = scrapy.Field()
   info = scrapy.Field()
3. Erstelle den Crawler (spiders/itcastSpider.py)
Die Crawler-Funktionalität muss in zwei Schritte unterteilt werden:
1. Die Daten crawlen
Gib den Befehl im aktuellen Verzeichnis ein; er erstellt einen Crawler namens itcast im Verzeichnis mySpider/spider und gibt den Bereich der Crawl-Domain an:
scrapy genspider itcast "itcast.cn"
Öffne itcast.py im Verzeichnis mySpider/spider. Der folgende Code wird standardmäßig hinzugefügt:
import scrapy

class ItcastSpider(scrapy.Spider):
    name = "itcast"
    allowed_domains = ["itcast.cn"]
    start_urls = (
        'http://www.itcast.cn/',
    )

    def parse(self, response):
        pass
Eigentlich können wir itcast.py auch selbst erstellen und den obigen Code schreiben, aber die Verwendung des Befehls erspart uns die Mühe, festen Boilerplate-Code zu schreiben.
Um einen Spider zu erstellen, musst du eine Unterklasse mit der scrapy.Spider-Klasse erstellen und drei erforderliche Attribute und eine Methode definieren.
name = "" : der Identifikationsname dieses Spiders. Er muss eindeutig sein; verschiedene Spider müssen unterschiedliche Namen definieren.
allow_domains = [] ist der Suchdomänenbereich, also der eingeschränkte Bereich des Spiders. Er legt fest, dass der Spider nur Seiten unter dieser Domäne crawlt, und nicht vorhandene URLs werden ignoriert.
start_urls = () : das URL-Tuple/die URL-Liste zum Crawlen. Der Spider beginnt hier mit dem Abrufen von Daten, daher werden die zuerst heruntergeladenen Daten von diesen URLs stammen. Andere Unter-URLs werden durch Vererbung von diesen Start-URLs aus erzeugt.
parse(self, response) : die parse-Methode. Sie wird aufgerufen, nachdem jede anfängliche URL heruntergeladen wurde. Beim Aufruf nimmt sie das von jeder URL zurückgegebene Response-Objekt als einzigen Parameter. Ihre Hauptfunktionen sind wie folgt:
Verantwortlich für das Parsen der zurückgegebenen Webseitendaten (response.body) und das Extrahieren strukturierter Daten (Generieren von items).
URL-Anfragen für die nächste Seite generieren.
Den Wert von start_urls auf die erste URL ändern, die gecrawlt werden muss.
start_urls = ("http://www.itcast.cn/channel/teacher.shtml",)
Die parse()-Methode ändern.
def parse(self, response):
    filename = "teacher.html"
    open(filename, 'w').write(response.body)
Dann führe es aus, um das Ergebnis zu sehen. Führe im Verzeichnis mySpider aus:
scrapy crawl itcast
Ja, es ist itcast. Wenn man sich den obigen Code ansieht, ist es das name-Attribut der Klasse ItcastSpider, also der eindeutige Spider-Name bei Verwendung des Befehls scrapy genspider.
Wenn nach der Ausführung im ausgegebenen Log [scrapy] INFO: Spider closed (finished) angezeigt wird, bedeutet das, dass die Ausführung abgeschlossen ist. Danach erscheint im aktuellen Ordner eine Datei teacher.html, die alle Quellcodeinformationen der gerade gecrawlten Webseite enthält.
Hinweis:Die Standardkodierungsumgebung von Python2.x ist ASCII. Wenn sie nicht mit dem Kodierungsformat der abgerufenen Daten übereinstimmt, kann es zu verstümmeltem Text kommen; wir können das Kodierungsformat des gespeicherten Inhalts angeben. Im Allgemeinen können wir oben im Code Folgendes hinzufügen:
import sys
reload(sys)
sys.setdefaultencoding("utf-8")
Diese drei Codezeilen sind der universelle Schlüssel zur Lösung chinesischer Kodierungsprobleme in Python2.x. Nach all den Jahren der Beschwerden hat Python3 seine Lektion gelernt, und seine Standardkodierung ist Unicode... (Ich wünsche euch allen, dass ihr bald auf Python3 umsteigt)
2. Daten extrahieren
Nach dem Crawlen der gesamten Webseite ist der nächste Schritt der Extraktionsprozess. Betrachten Sie zuerst den Quellcode der Seite:
<div class="li_txt">
    <h3>  xxx  </h3>
    <h4> xxxxx </h4>
    <p> xxxxxxxx </p>
Ist es nicht auf einen Blick klar? Verwenden Sie direkt XPath, um mit dem Extrahieren der Daten zu beginnen.
Für die xpath-Methode müssen wir nur die xpath-Regeln eingeben, um die entsprechenden HTML-Tag-Knoten zu lokalisieren. Details können Sie hier nachsehen:xpath-Tutorial。
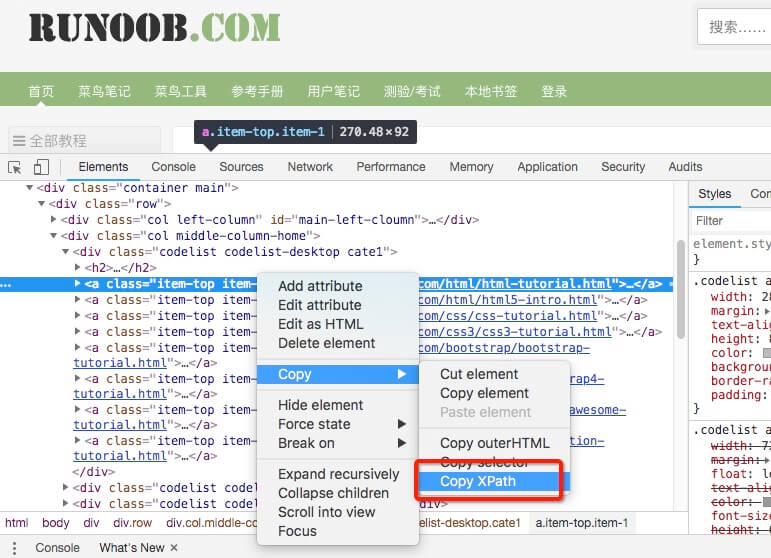
Es macht nichts, wenn Sie die xpath-Syntax nicht kennen. Chrome bietet uns eine Ein-Klick-Methode, um die xpath-Adresse zu erhalten (Rechtsklick -> Inspect -> Copy -> Copy XPath), wie unten gezeigt:
Hier sind einige Beispiele für XPath-Ausdrücke und ihre entsprechenden Bedeutungen:
/html/head/title: Im HTML-Dokument auswählen<head>das darin enthaltene Tag<title>element/html/head/title/text(): Das oben genannte auswählen<title>Text des Elements//td: Alle auswählen<td>Elemente//div[@class="mine"]: Alles auswählen mitclass="mine"AttributdivElemente
Zum Beispiel lesen wir den Websitehttp://www.itcast.cn/Website-Titel. Ändern Sie den Code der Datei itcast.py wie folgt:
# -*- coding: utf-8 -*-
import scrapy

# 以下三行是在 Python2.x版本中解决乱码问题,Python3.x 版本的可以去掉
import sys
reload(sys)
sys.setdefaultencoding("utf-8")

class Opp2Spider(scrapy.Spider):
    name = 'itcast'
    allowed_domains = ['itcast.com']
    start_urls = ['http://www.itcast.cn/']

    def parse(self, response):
        # 获取网站标题
        context = response.xpath('/html/head/title/text()')

        # 提取网站标题
        title = context.extract_first()
        print(title)
        pass
Führen Sie den folgenden Befehl aus:
$ scrapy crawl itcast
...
...
传智播客官网-好口碑IT培训机构,一样的教育,不一样的品质
...
...
Wir haben zuvor eine ItcastItem-Klasse in mySpider/items.py definiert. Hier importieren wir sie:
from mySpider.items import ItcastItem
Dann kapseln wir die von uns erhaltenen Daten in ein ItcastItem-Objekt, das die Attribute jedes Lehrers speichern kann:
from mySpider.items import ItcastItem

def parse(self, response):
    #open("teacher.html","wb").write(response.body).close()

    # 存放老师信息的集合
    items = []

    for each in response.xpath("//div[@class='li_txt']"):
        # 将我们得到的数据封装到一个 `ItcastItem` 对象
        item = ItcastItem()
        #extract()方法返回的都是unicode字符串
        name = each.xpath("h3/text()").extract()
        title = each.xpath("h4/text()").extract()
        info = each.xpath("p/text()").extract()

        #xpath返回的是包含一个元素的列表
        item['name'] = name[0]
        item['title'] = title[0]
        item['info'] = info[0]

        items.append(item)

    # 直接返回最后数据
    return items
Wir werden uns vorerst nicht mit der Pipeline befassen; wir werden sie später ausführlich vorstellen.
Daten speichern
Die einfachsten Möglichkeiten für scrapy, Informationen zu speichern, umfassen hauptsächlich vier Typen. -o gibt Dateien im angegebenen Format aus, mit den folgenden Befehlen:
scrapy crawl itcast -o teachers.json
json lines-Format, Standard ist Unicode-Kodierung
scrapy crawl itcast -o teachers.jsonl
csv-Format mit Komma als Trennzeichen, kann mit Excel geöffnet werden
scrapy crawl itcast -o teachers.csv
xml-Format
scrapy crawl itcast -o teachers.xml
Nachdenken
Wenn Sie den Code in die folgende Form ändern, ist das Ergebnis genau dasselbe.
Bitte denken Sie über die Rolle von yield hier nach (Eine kurze Analyse der Verwendung von Python yield):
# -*- coding: utf-8 -*-
import scrapy
from mySpider.items import ItcastItem

# 以下三行是在 Python2.x版本中解决乱码问题,Python3.x 版本的可以去掉
import sys
reload(sys)
sys.setdefaultencoding("utf-8")

class Opp2Spider(scrapy.Spider):
    name = 'itcast'
    allowed_domains = ['itcast.com']
    start_urls = ("http://www.itcast.cn/channel/teacher.shtml",)

    def parse(self, response):
        #open("teacher.html","wb").write(response.body).close()

        # 存放老师信息的集合
        items = []

        for each in response.xpath("//div[@class='li_txt']"):
            # 将我们得到的数据封装到一个 `ItcastItem` 对象
            item = ItcastItem()
            #extract()方法返回的都是unicode字符串
            name = each.xpath("h3/text()").extract()
            title = each.xpath("h4/text()").extract()
            info = each.xpath("p/text()").extract()

            #xpath返回的是包含一个元素的列表
            item['name'] = name[0]
            item['title'] = title[0]
            item['info'] = info[0]

            items.append(item)

        # 直接返回最后数据
        return items
Original-Link: https://segmentfault.com/a/1190000013178839