Modelo Transformer
Transformer es un modelo de aprendizaje profundo basado en el mecanismo de atención, propuesto originalmente por Vaswani et al. en el artículo de 2017 "Attention is All You Need".
Ha revolucionado el campo del procesamiento de lenguaje natural (NLP) y se ha expandido gradualmente a casi todas las direcciones de la IA, como la visión por computadora.
La idea central de Transformer es abandonar por completo el procesamiento tradicional palabra por palabra (RNN) y, en su lugar, utilizar el mecanismo de atención para que el modelo vea toda la oración de una vez, determinando simultáneamente la relación de cada palabra con las demás, logrando así un entrenamiento más rápido y una mayor capacidad de comprensión.
¿Por qué se necesita Transformer?
Antes de la aparición de Transformer, el campo del NLP dependía principalmente de los modelos de la familia RNN (redes neuronales recurrentes), como LSTM y GRU, que procesan el texto secuencialmente y presentan dos defectos clave.
Limitaciones de las RNN
La RNN procesa el texto como un ser humano que "lee palabra por palabra", lo que conlleva los siguientes problemas:
- Desaparición del gradiente:Al procesar textos largos, el modelo "olvida" la información anterior. Por ejemplo, en "Ayer tomé prestado un libro sobre física cuántica en la biblioteca", al leer "libro" ya se ha olvidado de que "yo" es el sujeto; las dependencias de largo alcance son extremadamente difíciles de captar.
- Imposibilidad de paralelización:La RNN debe procesar cada palabra en orden, no puede aprovechar la capacidad de cálculo paralelo de la GPU, y es extremadamente lenta al entrenar con textos muy largos.
La solución de Transformer
Mediante el mecanismo de autoatención, el modelo procesa todas las palabras simultáneamente y calcula dinámicamente la fuerza de asociación entre cada par de palabras, resolviendo por completo los dos problemas anteriores.
Diagrama de comparación RNN vs TransformerComparación: RNN procesamiento secuencial vs Transformer paralelo + atención global
Arquitectura general de Transformer
Transformer consta de dos partes principales: el codificador (Encoder) y el decodificador (Decoder), cada una formada por múltiples capas de módulos idénticos apilados.
Analogía para entenderlo: el codificador es como un "lector" que convierte la oración china de entrada en un conjunto de vectores ricos en semántica; el decodificador es como un "traductor" que, tomando como referencia esos vectores, genera la salida en inglés palabra por palabra.
El siguiente es el diagrama de arquitectura de Transformer; a la izquierda está el codificador y a la derecha el decodificador.
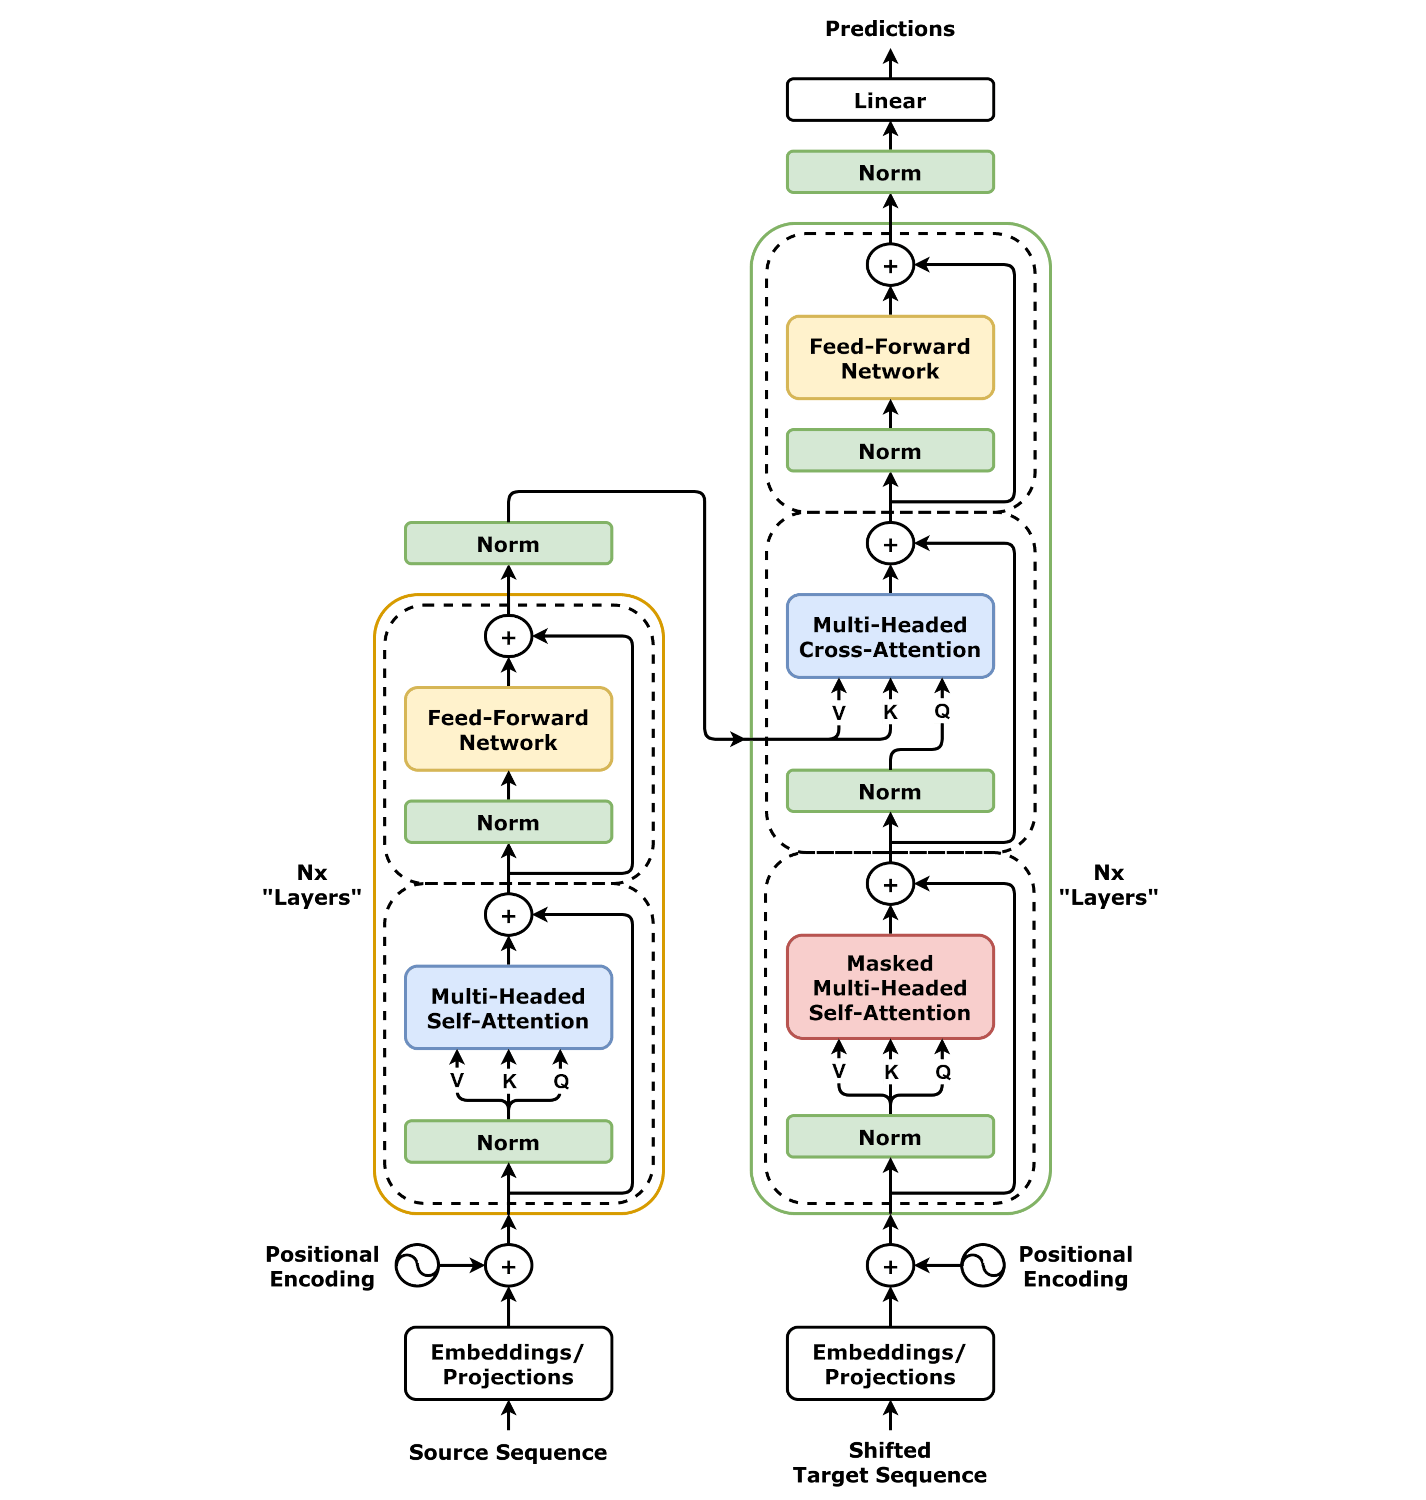
Arquitectura completa del codificador + decodificador de Transformer (las flechas naranjas son el flujo de información de Cross-Attention)
El modelo Transformer se compone de dos partes: el codificador (Encoder) y el decodificador (Decoder), cada una formada por múltiples capas de módulos idénticos apilados.
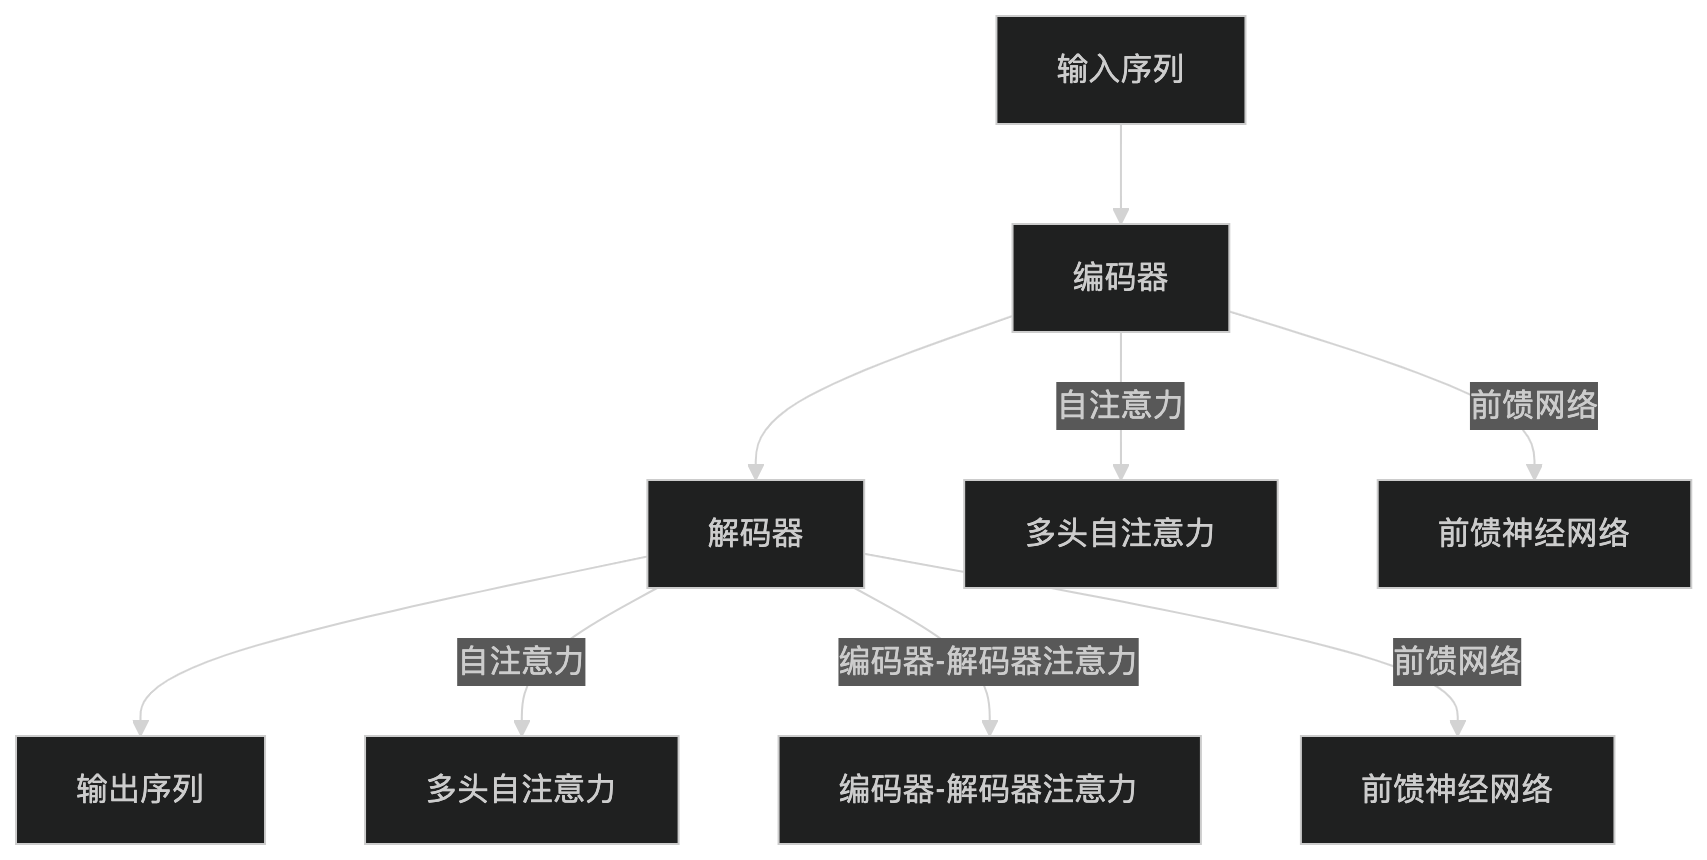
Codificador (Encoder)
El codificador está formado por el apilamiento de N módulos idénticos, y cada capa contiene dos subcapas:
- Mecanismo de autoatención de múltiples cabezas (Multi-Head Self-Attention):Calcula la relevancia de cada palabra con las demás dentro de la secuencia de entrada.
- Red neuronal de avance (Feed-Forward Neural Network):Aplica una transformación no lineal independiente a cada palabra.
Después de cada subcapa hay una conexión residual (Residual Connection) y una normalización de capa (Layer Normalization).
Decodificador (Decoder)
El decodificador también está formado por el apilamiento de N módulos idénticos, y cada capa contiene tres subcapas:
- Mecanismo de autoatención de múltiples cabezas con máscara (Masked Multi-Head Self-Attention):Calcula la relevancia de cada palabra con las palabras anteriores en la secuencia de salida (usa una máscara para evitar la fuga de información futura).
- Mecanismo de atención codificador-decodificador (Encoder-Decoder Attention):Calcula la relevancia entre la secuencia de salida y la secuencia de entrada.
- Red neuronal de avance (Feed-Forward Neural Network):Aplica una transformación no lineal independiente a cada palabra.
Del mismo modo, después de cada subcapa hay una conexión residual y normalización de capa.
Antes de la aparición del modelo Transformer, los modelos dominantes en el campo del NLP se basaban en arquitecturas RNN, como las redes de memoria a largo y corto plazo (LSTM) y las unidades recurrentes con compuerta (GRU). Estos modelos capturan las dependencias de la secuencia procesando secuencialmente los datos de entrada, pero presentan los siguientes problemas:
Problema de desaparición del gradiente: es difícil capturar dependencias de largo alcance.
Limitaciones del cálculo secuencial: no se puede aprovechar plenamente la capacidad de cálculo paralelo del hardware moderno, lo que resulta en una baja eficiencia de entrenamiento.

Transformer resolvió estos problemas mediante la introducción del mecanismo de autoatención, que permite al modelo procesar simultáneamente toda la secuencia de entrada y asignar dinámicamente diferentes pesos a cada posición de la secuencia.
Núcleo: mecanismo de autoatención
El mecanismo de autoatención es el componente más importante de Transformer; responde a la pregunta: "Al procesar esta palabra, ¿en qué otras palabras de la oración debería centrarme?"
¿Qué son Q, K y V?
El vector de cada palabra se transforma linealmente en tres roles: Query (consulta), Key (clave) y Value (valor).
Diagrama de Q K VOrigen de Q, K, V y proceso de cálculo de la atención
Usa una analogía con un motor de búsqueda para entender Q/K/V:
Q (Query) = las palabras clave que escribes en el cuadro de búsqueda, que representan "¿qué quiero consultar?"
K (Key) = las etiquetas de título de cada página web, que representan "¿qué palabras puedo hacer coincidir?"
V (Value) = el contenido real de cada página web, representa "¿qué información puedo ofrecer?"
Peso de atención = similitud entre Q y cada K; resultado final = suma ponderada de todos los V usando los pesos.
Fórmula de atención
\[ \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V \]
Donde:
- \(Q\)es la matriz de consultas (Q),\(K\)es la matriz de claves (K),\(V\)es la matriz de valores (V).
- \(d_k\)es la dimensión del vector, utilizada para escalar el producto punto y evitar la explosión del gradiente.
- softmax convierte las puntuaciones brutas en una distribución de probabilidad entre 0 y 1 (la suma de los pesos es 1).
Atención de múltiples cabezas (Multi-Head Attention)
Una atención única tiene una perspectiva limitada, como ver un problema desde un solo ángulo.
La atención de múltiples cabezas divide la entrada en h subespacios; cada "cabeza" aprende de forma independiente diferentes patrones de atención y, finalmente, se concatenan los resultados.

Codificación posicional (Positional Encoding)
Transformer procesa todas las palabras simultáneamente y, de forma natural, no tiene "sentido del orden": "el gato come pescado" y "el pescado come al gato" se tratarían como iguales.
La codificación posicional consiste en añadir a cada palabra un "número de asiento" para indicar al modelo la posición de cada palabra en la oración.
Dado que Transformer no tiene información secuencial explícita (como los pasos de tiempo en RNN), se utiliza la codificación posicional para añadir información de posición a cada palabra de la secuencia de entrada. Normalmente se generan codificaciones posicionales con funciones seno y coseno:Analogía: igual que se marca "Pregunta 1, Pregunta 2" en un examen, la codificación posicional permite que Transformer sepa que "yo" es la primera palabra y "amo" es la segunda.
\[ PE_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right) \] \[ PE_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right) \]
Donde:
\(pos\) es la posición de la palabra, \(i\) es el índice de dimensión.
Visualización de la codificación posicionalLa codificación posicional se suma a la incrustación de palabras para inyectar información posicional al modelo.
Arquitectura codificador-decodificador
El modelo Transformer se compone de dos partes: el codificador y el decodificador.
- Codificador:Convierte la secuencia de entrada en una serie de representaciones ocultas. Cada capa del codificador contiene un mecanismo de autoatención y una red neuronal feed-forward.
- Decodificador:Genera la secuencia objetivo a partir de la salida del codificador. Cada capa del decodificador contiene dos mecanismos de atención (autoatención y atención codificador-decodificador) y una red neuronal feed-forward.
Conexiones residuales y normalización de capas
Después de la salida de cada subcapa (autoatención, red feed-forward), se realizan dos operaciones: conexión residual y normalización de capa, que ayudan a estabilizar el entrenamiento de redes profundas.
Diagrama de conexión residualLa conexión residual permite que el gradiente fluya por un "cortocircuito", y la normalización de capa estabiliza el entrenamiento.
- Conexión residual:Suma directamente la entrada de la subcapa a su salida (output = F(x) + x), evitando la desaparición del gradiente en redes profundas y permitiendo que el modelo "ignore selectivamente" la transformación de una capa.
- Normalización de capa:Normaliza los valores de activación de cada capa para que el entrenamiento sea más estable y la convergencia más rápida.
Ventajas de Transformer
En comparación con la arquitectura RNN tradicional, Transformer tiene las siguientes ventajas notables:
Computación paralela
Procesa toda la secuencia a la vez, aprovechando al máximo la capacidad paralela de la GPU, y su velocidad de entrenamiento supera con creces a la de RNN.
Dependencias de largo alcance
El mecanismo de autoatención hace que la "distancia de comunicación" entre dos palabras cualesquiera sea siempre 1, sin estar limitado por la longitud de la secuencia.
Alta escalabilidad
Apilar más capas y aumentar la dimensión permite mejorar el rendimiento, lo que ha dado lugar a potentes modelos como BERT y GPT.
Aplicaciones de Transformer
La arquitectura Transformer se ha aplicado ampliamente en diversos campos de la IA; a continuación se presenta una clasificación por áreas.
Procesamiento de lenguaje natural (NLP)
Visión por computadora (CV)
Tareas multimodales
Aplicaciones de Transformer
Procesamiento del lenguaje natural (NLP):
Traducción automática (p. ej., Google Translate)
Generación de texto (p. ej., modelos de la serie GPT)
Clasificación de texto, sistemas de preguntas y respuestas, etc.
Visión por computadora (CV):
Clasificación de imágenes (p. ej., Vision Transformer)
Detección de objetos, generación de imágenes, etc.
Tareas multimodales:
Tareas que combinan texto e imágenes (p. ej., CLIP, DALL-E).
Ejemplo de implementación en PyTorch
A continuación se muestra un ejemplo completo de Transformer en PyTorch, con comentarios detallados para ayudar a los principiantes a entender cada paso:
Ejemplo
import torch.nn as nn
import torch.optim as optim
# --- Definir el modelo Transformer ---
class TransformerModel(nn.Module):
def __init__(self, input_dim, model_dim, num_heads, num_layers, output_dim):
super(TransformerModel, self).__init__()
# Incrustación de palabras: asigna los índices de palabras a vectores de dimensión model_dim
self.embedding = nn.Embedding(input_dim, model_dim)
# Codificación posicional: vector posicional aprendible, con una longitud máxima admitida de 1000
self.positional_encoding = nn.Parameter(
torch.zeros(1, 1000, model_dim)
)
# Transformer incorporado en PyTorch (incluye codificador + decodificador)
self.transformer = nn.Transformer(
d_model=model_dim, # Dimensión del vector
nhead=num_heads, # Número de cabezas de atención múltiple
num_encoder_layers=num_layers, # Número de capas del codificador
num_decoder_layers=num_layers # Número de capas del decodificador
)
# Capa lineal final: asigna el vector de vuelta al tamaño del vocabulario (para predecir la siguiente palabra)
self.fc = nn.Linear(model_dim, output_dim)
def forward(self, src, tgt):
src_seq_length = src.size(1)
tgt_seq_length = tgt.size(1)
# Incrustación de palabras + codificación posicional (se suman ambas)
src = self.embedding(src) + self.positional_encoding[:, :src_seq_length, :]
tgt = self.embedding(tgt) + self.positional_encoding[:, :tgt_seq_length, :]
# Pasar por Transformer (el codificador lee src, el decodificador genera tgt)
transformer_output = self.transformer(src, tgt)
# La capa lineal produce la probabilidad de vocabulario en cada posición
output = self.fc(transformer_output)
return output
# --- Configuración de hiperparámetros ---
input_dim = 10000 # Tamaño del vocabulario (cuántas palabras diferentes hay en total)
model_dim = 512 # Dimensión del vector de cada palabra (el artículo original usa 512)
num_heads = 8 # Número de cabezas de atención múltiple (debe dividir exactamente a model_dim)
num_layers = 6 # Número de capas del codificador/decodificador (el artículo original usa 6)
output_dim = 10000 # Dimensión de salida (igual al tamaño del vocabulario)
# --- Inicializar el modelo, la función de pérdida y el optimizador ---
model = TransformerModel(input_dim, model_dim, num_heads, num_layers, output_dim)
criterion = nn.CrossEntropyLoss() # Pérdida de entropía cruzada para clasificación multiclase
optimizer = optim.Adam(model.parameters(), lr=0.001) # Optimizador Adam
# --- Construir datos de ejemplo (usar corpus reales en la práctica) ---
# src: secuencia fuente (p. ej., chino), shape = (longitud de secuencia=10, tamaño de lote=32)
src = torch.randint(0, input_dim, (10, 32))
# tgt: secuencia objetivo (p. ej., inglés), shape = (longitud de secuencia=20, tamaño de lote=32)
tgt = torch.randint(0, input_dim, (20, 32))
# --- Propagación hacia adelante ---
output = model(src, tgt)
# output.shape = (20, 32, 10000): distribución de predicción sobre el vocabulario en cada posición
# --- Calcular la pérdida ---
# view(-1, output_dim) aplana (20,32,10000) a (640, 10000)
loss = criterion(output.view(-1, output_dim), tgt.view(-1))
# --- Retropropagación + actualización de pesos ---
optimizer.zero_grad() # Vaciar los gradientes del paso anterior
loss.backward() # Calcular los gradientes
optimizer.step() # Actualizar los parámetros
print(f"Valor de pérdida: {loss.item():.4f}")
El código anterior utiliza datos aleatorios solo para demostrar el flujo. Para el entrenamiento real se necesita:
- 1) Preparar corpus paralelos reales (p. ej., pares de traducción chino-inglés);
- 2) Realizar correctamente la tokenización y la construcción del vocabulario;
- 3) Implementar la inferencia paso a paso del decodificador (generación autorregresiva);
- 4) Ajustar la estrategia de programación de la tasa de aprendizaje (el artículo original usa Warmup).
Resumen
La evolución de RNN a Transformer representa un importante cambio de paradigma en el campo del aprendizaje profundo.
Diagrama de la ruta de evoluciónLa ruta de evolución de RNN a Transformer
Las tres grandes innovaciones de Transformer han cambiado por completo el panorama del aprendizaje profundo:
- Mecanismo de autoatención—permite que dos palabras cualesquiera "conversen" directamente, diciendo adiós al gradiente desaparecido.
- Paralelización completa—un salto cualitativo en la velocidad de entrenamiento, haciendo posible el preentrenamiento a gran escala.
- Arquitectura universal—desde NLP hasta CV y multimodal, Transformer se ha convertido en el "bloque de construcción universal" de la era de la IA.
Dominar Transformer es tener la llave para entender modelos modernos de IA como GPT, BERT, Stable Diffusion.
Referencia rápida de términos relacionados
| Término | Inglés | Descripción |
|---|---|---|
| Autoatención | Self-Attention | Mecanismo que calcula la relevancia entre los elementos de una secuencia. |
| Atención multi-cabeza | Multi-Head Attention | Múltiples cabezas de atención calculan en paralelo, capturando información de distintos subespacios de características. |
| Codificación posicional | Positional Encoding | Técnica que proporciona al modelo información sobre la posición de los elementos en la secuencia. |
| Conexión residual | Residual Connection | Suma la entrada directamente a la salida de la subcapa, aliviando el problema del gradiente desaparecido. |
| Normalización de capa | Layer Normalization | Normaliza los valores de activación de cada capa, acelerando la convergencia del entrenamiento. |
| Codificador | Encoder | Codifica la secuencia de entrada en representaciones contextuales. |
| Decodificador | Decoder | Genera la secuencia objetivo a partir de la salida del codificador. |
| Atención cruzada | Cross-Attention | Mecanismo de atención en el que el decodificador atiende a la salida del codificador. |
| Atención enmascarada | Masked Attention | Mecanismo en el decodificador que evita atender a posiciones futuras. |
| Red feed-forward | Feed-Forward Network | Capa totalmente conectada aplicada independientemente a cada posición. |