Модель Transformer
Transformer — это модель глубокого обучения, основанная на механизме внимания, впервые предложенная Vaswani et al. в их статье 2017 года «Attention is All You Need».
Он произвёл революцию в области обработки естественного языка (NLP) и постепенно распространился почти на все области ИИ, такие как компьютерное зрение.
Основная идея Transformer — полностью отказаться от традиционного метода обработки слово за словом (RNN) и вместо этого использовать механизм внимания, чтобы модель читала всё предложение сразу, одновременно определяя связи каждого слова с другими словами, тем самым обеспечивая более быстрое обучение и более сильную способность к пониманию.
Зачем нам нужен Transformer?
До появления Transformer в области NLP в основном использовались модели семейства RNN (рекуррентная нейронная сеть) (например, LSTM, GRU), которые обрабатывают текст последовательно и имеют два ключевых недостатка.
Ограничения RNN
RNN обрабатывает текст как человек, «читая слово за словом», что порождает следующие проблемы:
- Исчезающий градиент:При обработке длинного текста модель «забывает» более раннюю информацию. Например, во фразе «Вчера я взял в библиотеке книгу по квантовой физике», к моменту, когда она доходит до слова «книгу», она уже давно забыла, что «я» — подлежащее, из-за чего дальние зависимости становится крайне трудно улавливать.
- Отсутствие параллелизма:RNN должен обрабатывать каждое слово последовательно и не может использовать возможности параллельных вычислений GPU, из-за чего обучение на очень длинных текстах становится очень медленным.
Решение Transformer
Благодаря механизму самовнимания (self-attention) модель обрабатывает все слова одновременно и динамически вычисляет силу связи между каждой парой слов, полностью решая две вышеуказанные проблемы.
Схема сравнения RNN и TransformerСравнение последовательной обработки RNN и параллельного + глобального внимания Transformer
Общая архитектура Transformer
Transformer состоит из двух основных частей: энкодера и декодера, каждый из которых состоит из нескольких слоёв одинаковых модулей.
Аналогия: энкодер похож на «читателя», который понимает входное предложение на китайском языке как набор семантически богатых векторов; декодер похож на «переводчика», который обращается к этим векторам и генерирует вывод на английском слово за словом.
Ниже представлена схема архитектуры Transformer, где энкодер находится слева, а декодер — справа.
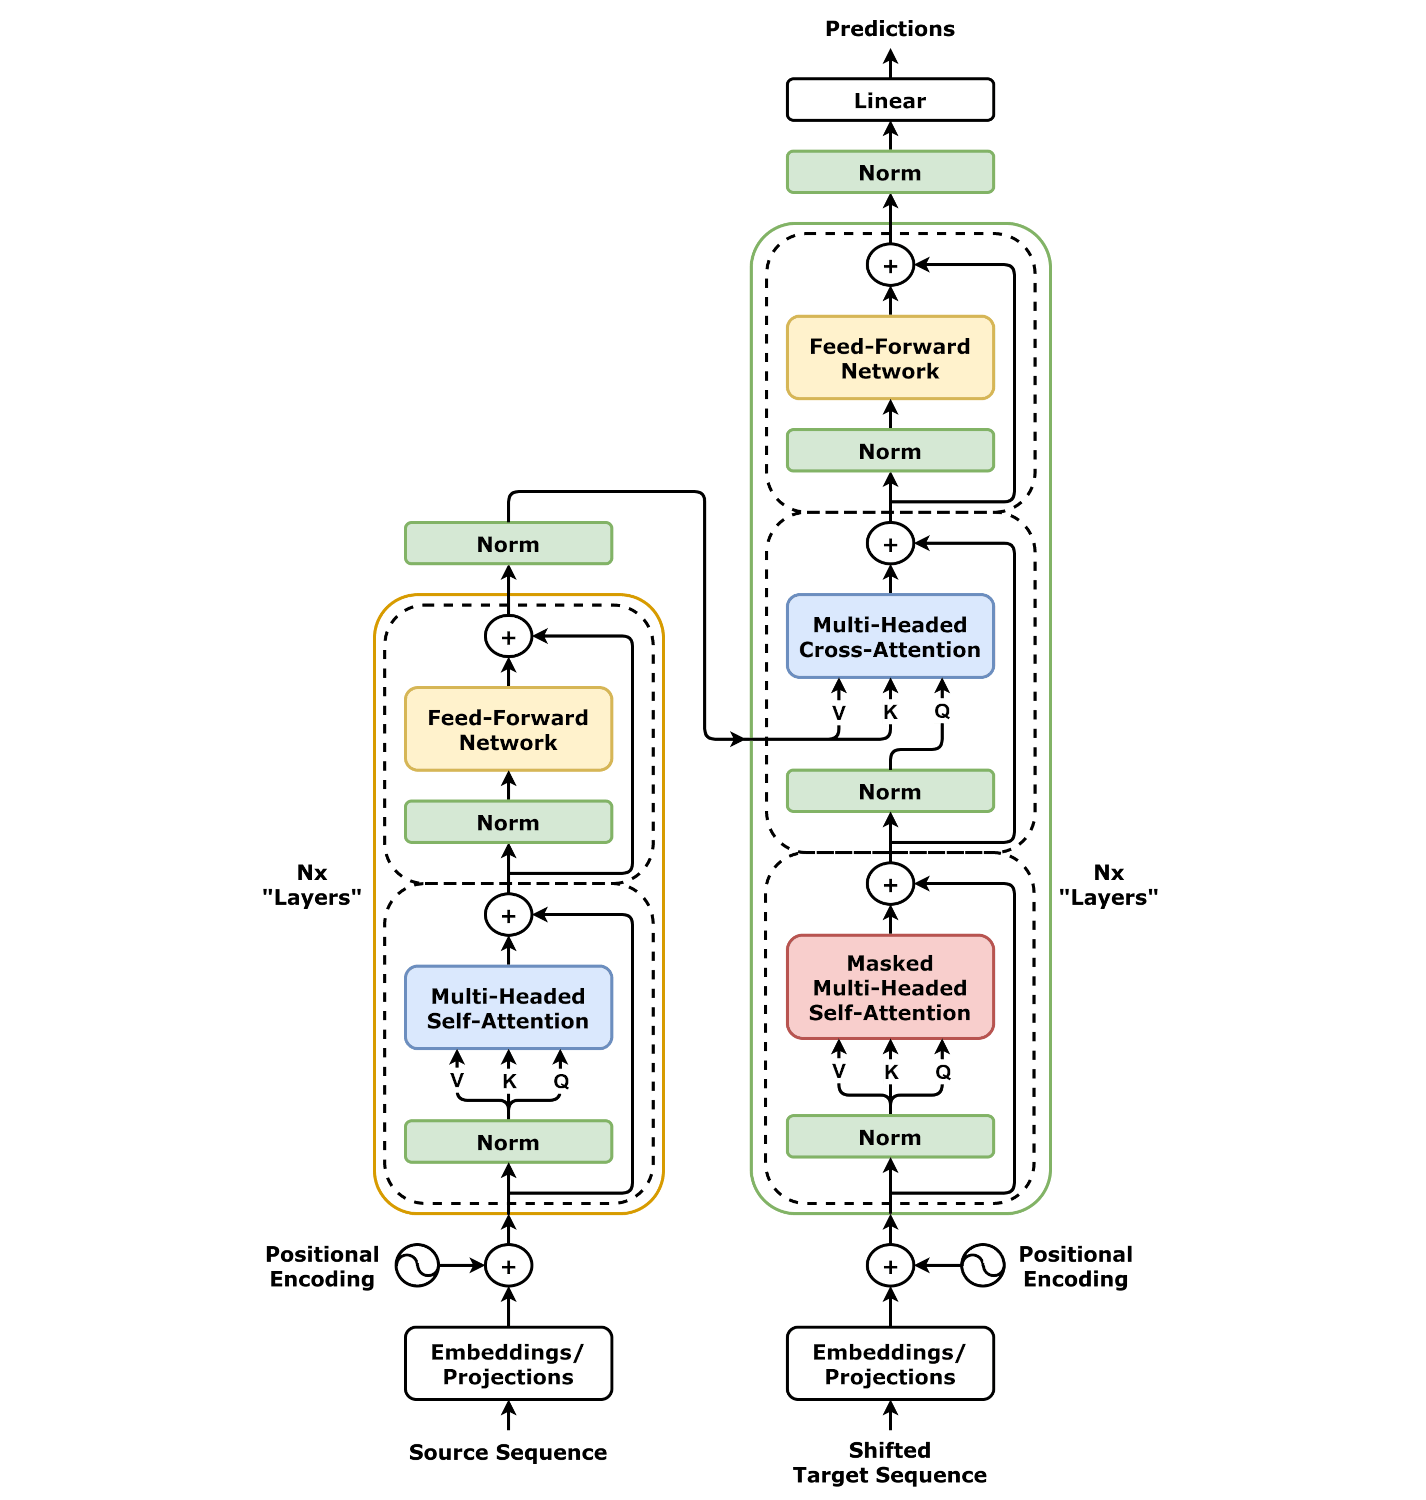
Полная архитектура энкодера + декодера Transformer (оранжевые стрелки обозначают поток информации Cross-Attention)
Модель Transformer состоит из двух частей — энкодера и декодера, каждый из которых составлен из нескольких одинаковых модулей, уложенных в стек.
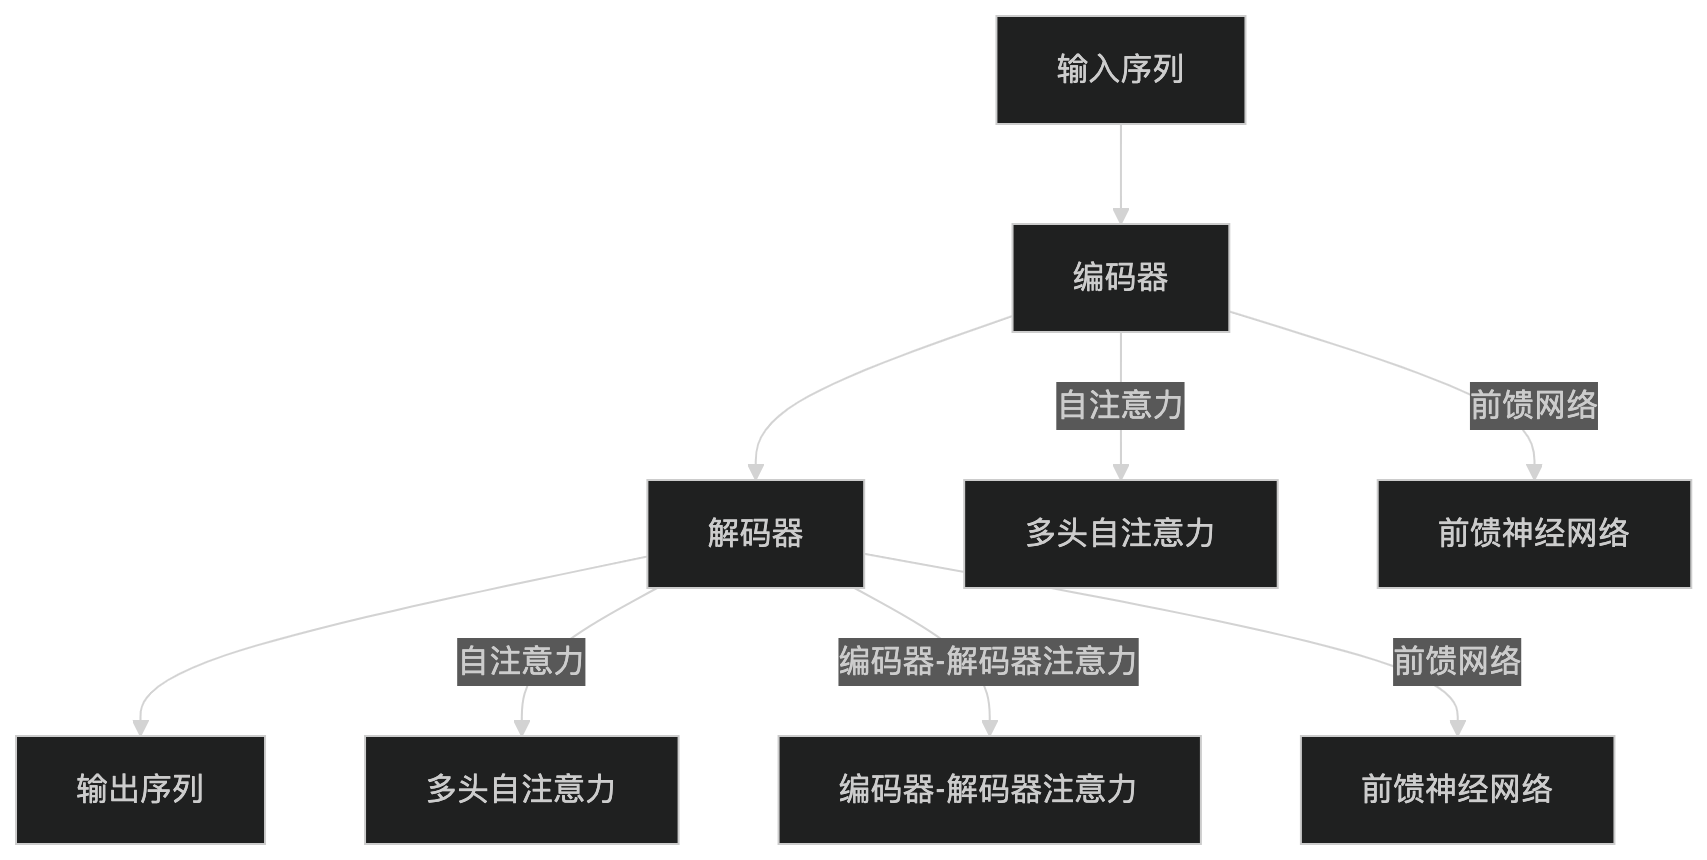
Энкодер
Энкодер составлен из N одинаковых модулей, уложенных в стек, и каждый слой содержит два подслоя:
- Механизм Multi-Head Self-Attention:Вычисляет релевантность каждого слова по отношению к другим словам во входной последовательности.
- Нейронная сеть прямого распространения:Выполняет независимое нелинейное преобразование для каждого слова.
За каждым подслоем следуют остаточное соединение и Layer Normalization.
Декодер
Декодер также составлен из N одинаковых модулей, уложенных в стек, и каждый слой содержит три подслоя:
- Механизм маскированного многоголового самовнимания:Вычисляет релевантность каждого слова предшествующим словам в выходной последовательности (с использованием масок для предотвращения утечки будущей информации).
- Механизм внимания кодировщика-декодера:Вычисляет релевантность между выходной последовательностью и входной последовательностью.
- Нейронная сеть прямого распространения:Выполняет независимое нелинейное преобразование для каждого слова.
Аналогично, за каждым подуровнем следует остаточное соединение и нормализация слоя.
До появления модели Transformer основными моделями в NLP были архитектуры на основе RNN, такие как сети с долгой краткосрочной памятью (LSTM) и управляемые рекуррентные блоки (GRU). Эти модели улавливают зависимости в последовательностях, обрабатывая входные данные последовательно, но у них есть следующие проблемы:
Проблема исчезающего градиента: дальние зависимости трудно уловить.
Ограничение последовательных вычислений: Оно не позволяет полностью использовать возможности параллельных вычислений современного оборудования, что приводит к низкой эффективности обучения.
Transformer решает эти проблемы, вводя механизм самовнимания, позволяя модели обрабатывать всю входную последовательность одновременно и динамически назначать разные веса каждой позиции в последовательности.
Основное: механизм самовнимания
Механизм самовнимания — важнейший компонент Transformer. Он отвечает на вопрос: "На какие другие слова в предложении мне следует обращать внимание при обработке этого слова?"
Что такое Q, K, V?
Вектор каждого слова линейно преобразуется в три роли: Query, Key и Value.
Схема Q K VПроисхождение Q, K, V и процесс вычисления внимания
Используйте аналогию с поисковой системой, чтобы понять Q/K/V:
Q (Query) = ключевое слово, которое вы вводите в поисковую строку, обозначающее "Что я хочу найти?"
K (Key) = тег заголовка каждой веб-страницы, обозначающий "С какими словами я могу сопоставиться?"
V (Value) = фактическое содержимое каждой веб-страницы, обозначающее "Какую информацию я могу предоставить?"
Веса внимания = сходство между Q и каждым K; итоговый результат = взвешенная сумма всех V с использованием этих весов.
Формула внимания
\[ \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V \]
где:
- \(Q\)— матрица запросов,\(K\)— матрица ключей,\(V\)— матрица значений.
- \(d_k\)— размерность векторов, используемая для масштабирования скалярного произведения и предотвращения взрыва градиентов.
- softmax преобразует исходные оценки в распределение вероятностей от 0 до 1 (при этом сумма весов равна 1)
Многоголовое внимание
Единичная перспектива внимания ограничена, подобно взгляду на проблему только с одной стороны.
Многоголовое внимание разбивает вход на h подпространств; каждая "голова" независимо изучает свой паттерн внимания, а результаты в конце конкатенируются.

Позиционное кодирование
Transformer обрабатывает все слова одновременно и по своей природе не имеет «чувства порядка» — «кошка ест рыбу» и «рыба ест кошку» обрабатывались бы одинаково.
Позиционное кодирование похоже на добавление «номера места» каждому слову, сообщая модели позицию каждого слова в предложении.
Поскольку Transformer не имеет явной информации о последовательности (например, временных шагов в RNN), позиционное кодирование используется для добавления информации о позиции каждому слову во входной последовательности. Обычно для генерации позиционных кодирований используются функции синуса и косинуса:Аналогия: так же как вы отмечаете «Вопрос 1, Вопрос 2» на экзаменационном листе, позиционное кодирование позволяет Transformer понять, что «Я» — это 1-е слово, «люблю» — 2-е слово.
\[ PE_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right) \] \[ PE_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right) \]
где:
\(pos\) — это позиция слова, а \(i\) — индекс размерности.
Визуализация позиционного кодированияПозиционное кодирование добавляется к эмбеддингам слов, чтобы внедрить информацию о позиции в модель.
Архитектура энкодер-декодер
Модель Transformer состоит из двух частей: энкодера и декодера:
- Энкодер:Преобразует входную последовательность в серию скрытых представлений. Каждый слой энкодера содержит механизм самовнимания и полносвязную нейронную сеть.
- Декодер:Генерирует целевую последовательность на основе выходных данных энкодера. Каждый слой декодера содержит два механизма внимания (самовнимание и внимание энкодер-декодер) и полносвязную нейронную сеть.
Остаточное соединение и слойная нормализация
После выхода каждого подуровня (самовнимания, сети прямого распространения) выполняются две операции: остаточное соединение и нормализация слоя, которые помогают стабилизировать обучение в глубоких сетях.
Схема остаточного соединенияОстаточные соединения позволяют градиентам «закорачиваться», а нормализация слоя стабилизирует обучение.
- Остаточное соединение:Добавляет вход подуровня непосредственно к его выходу (output = F(x) + x), избегая затухания градиентов в глубоких сетях и позволяя модели «избирательно игнорировать» преобразование слоя.
- Нормализация слоя:Нормализует активации каждого слоя, делая обучение более стабильным, а сходимость — более быстрой.
Преимущества трансформера
По сравнению с традиционными архитектурами RNN Transformer имеет следующие заметные преимущества:
Параллельные вычисления
Обрабатывает всю последовательность сразу, полностью используя параллелизм GPU, при этом скорость обучения значительно превосходит RNN.
Дальние зависимости
Механизм самовнимания поддерживает «дистанцию связи» между любыми двумя словами на уровне 1, и она больше не ограничена длиной последовательности.
Высокая масштабируемость
Наращивание большего числа слоёв и увеличение размерностей может повысить производительность, что привело к появлению мощных моделей, таких как BERT и GPT.
Применения Transformer
Архитектура Transformer широко применяется в различных областях ИИ; ниже они представлены по областям.
Обработка естественного языка (NLP)
Компьютерное зрение (CV)
Мультимодальные задачи
Применения Transformer
Обработка естественного языка (NLP):
Машинный перевод (например, Google Translate)
Генерация текста (например, модели серии GPT)
Классификация текста, ответы на вопросы и т. д.
Компьютерное зрение (CV):
Классификация изображений (например, Vision Transformer)
Обнаружение объектов, генерация изображений и т. д.
Мультимодальные задачи:
Задачи, объединяющие текст и изображения (например, CLIP, DALL-E).
Пример реализации на PyTorch
Ниже приведён полный пример Transformer на PyTorch с подробными комментариями, помогающими новичкам понять каждый шаг:
Пример
import torch.nn as nn
import torch.optim as optim
# --- Определение модели Transformer ---
class TransformerModel(nn.Module):
def __init__(self, input_dim, model_dim, num_heads, num_layers, output_dim):
super(TransformerModel, self).__init__()
# Встраивание слов: сопоставляет индексы слов с model_dim-мерными векторами
self.embedding = nn.Embedding(input_dim, model_dim)
# Позиционное кодирование: обучаемые векторы позиций, максимальная поддерживаемая длина 1000
self.positional_encoding = nn.Parameter(
torch.zeros(1, 1000, model_dim)
)
# Встроенный Transformer в PyTorch (включает энкодер + декодер)
self.transformer = nn.Transformer(
d_model=model_dim, # Размерность вектора
nhead=num_heads, # Количество голов для многоголового внимания
num_encoder_layers=num_layers, # Количество слоёв энкодера
num_decoder_layers=num_layers # Количество слоёв декодера
)
# Финальный линейный слой: отображает векторы обратно в размер словаря (для предсказания следующего слова)
self.fc = nn.Linear(model_dim, output_dim)
def forward(self, src, tgt):
src_seq_length = src.size(1)
tgt_seq_length = tgt.size(1)
# Эмбеддинг слов + позиционное кодирование (сложить их вместе)
src = self.embedding(src) + self.positional_encoding[:, :src_seq_length, :]
tgt = self.embedding(tgt) + self.positional_encoding[:, :tgt_seq_length, :]
# Прогон через Transformer (энкодер читает src, декодер генерирует tgt)
transformer_output = self.transformer(src, tgt)
# Линейный слой выводит вероятности словаря для каждой позиции
output = self.fc(transformer_output)
return output
# --- Настройки гиперпараметров ---
input_dim = 10000 # Размер словаря (сколько существует различных слов)
model_dim = 512 # Размерность вектора для каждого слова (в оригинальной статье используется 512)
num_heads = 8 # Количество голов многоголового внимания (должно делить model_dim)
num_layers = 6 # Количество слоёв энкодера/декодера (в оригинальной статье используется 6)
output_dim = 10000 # Размерность выхода (совпадает с размером словаря)
# --- Инициализация модели, функции потерь и оптимизатора ---
model = TransformerModel(input_dim, model_dim, num_heads, num_layers, output_dim)
criterion = nn.CrossEntropyLoss() # Многоклассовая кросс-энтропийная потеря
optimizer = optim.Adam(model.parameters(), lr=0.001) # Оптимизатор Adam
# --- Создание примера данных (в реальном использовании замените на настоящий корпус) ---
# src: исходная последовательность (например, китайская), shape = (sequence_length=10, batch_size=32)
src = torch.randint(0, input_dim, (10, 32))
# tgt: целевая последовательность (например, английская), shape = (sequence_length=20, batch_size=32)
tgt = torch.randint(0, input_dim, (20, 32))
# --- Прямой проход ---
output = model(src, tgt)
# output.shape = (20, 32, 10000): предсказанное распределение по словарю в каждой позиции
# --- Вычисление потерь ---
# view(-1, output_dim) разворачивает (20,32,10000) в (640, 10000)
loss = criterion(output.view(-1, output_dim), tgt.view(-1))
# --- Обратное распространение + обновление весов ---
optimizer.zero_grad() # Очистить градиенты предыдущего шага
loss.backward() # Вычислите градиенты
optimizer.step() # Обновить параметры
print(f"значение loss: {loss.item():.4f}")
Приведённый выше код использует случайные данные только для демонстрации рабочего процесса. Для фактического обучения необходимо:
- 1) Подготовить реальные параллельные корпуса (например, пары для перевода с китайского на английский);
- 2) Выполнить токенизацию и построение словаря;
- 3) Реализовать пошаговый инференс Decoder (авторегрессионную генерацию);
- 4) Скорректировать стратегию планирования скорости обучения (в исходной статье используется Warmup).
Итог
Эволюция от RNN к Transformer представляет собой важный сдвиг парадигмы в глубоком обучении.
Диаграмма пути эволюцииЭволюционный путь от RNN к Transformer
Три главных инновации Transformer полностью преобразили ландшафт глубокого обучения:
- Механизм самовнимания—позволяя любым двум словам напрямую «разговаривать», прощаясь с исчезающими градиентами.
- Полная параллелизация—качественный скачок в скорости обучения, делая возможным крупномасштабное предобучение.
- Универсальная архитектура—от NLP до CV и мультимодальных задач, Transformer стал «универсальным строительным блоком» эпохи ИИ.
Освойте Transformer — и вы получите ключ к пониманию современных моделей ИИ, таких как GPT, BERT и Stable Diffusion.
Краткий справочник терминов
| Термин | Английский | Описание |
|---|---|---|
| Самовнимание | Самовнимание | Механизм, который вычисляет корреляции между элементами внутри последовательности |
| Многоголовое внимание | Многоголовое внимание | Несколько голов внимания вычисляют параллельно, чтобы улавливать информацию из разных подпространств признаков |
| Позиционное кодирование | Позиционное кодирование | Метод, предоставляющий модели позиционную информацию об элементах последовательности |
| Остаточное соединение | Остаточное соединение | Напрямую добавляет вход к выходу подслоя, чтобы смягчить проблему исчезающих градиентов |
| Нормализация слоя | Нормализация слоя | Нормализует значения активаций каждого слоя, чтобы ускорить сходимость обучения |
| Энкодер | Энкодер | Кодирует входную последовательность в контекстные представления |
| Декодер | Декодер | Генерирует целевую последовательность на основе выхода энкодера |
| Перекрёстное внимание | Перекрёстное внимание | Механизм внимания, в котором декодер обращается к выходу энкодера |
| Маскированный | Маскированное внимание | Механизм в декодере предотвращает обращение к позиционной информации |
| Сеть прямого распространения | Сеть прямого распространения | Полносвязный слой, применяемый независимо к каждой позиции |