Modèle Transformer
Transformer est un modèle d'apprentissage profond basé sur le mécanisme d'attention, proposé pour la première fois par Vaswani et al. dans leur article de 2017 « Attention is All You Need ».
Il a révolutionné le domaine du traitement du langage naturel (NLP) et s'est progressivement étendu à presque tous les domaines de l'IA, tels que la vision par ordinateur.
L'idée centrale du Transformer est d'abandonner complètement la méthode de traitement traditionnelle mot à mot (RNN), et d'utiliser plutôt le mécanisme d'attention pour permettre au modèle de lire la phrase entière en une seule fois tout en déterminant la relation entre chaque mot et les autres mots, ce qui permet un entraînement plus rapide et une capacité de compréhension plus forte.
Pourquoi avons-nous besoin du Transformer ?
Avant l'avènement du Transformer, le domaine du NLP reposait principalement sur les modèles de la famille RNN (réseau de neurones récurrent), tels que LSTM et GRU, qui traitent le texte séquentiellement et présentent deux inconvénients majeurs.
Limites des RNN
Le RNN traite le texte comme un humain « lisant mot à mot », ce qui entraîne les problèmes suivants :
- Disparition du gradient :Lors du traitement de textes longs, le modèle « oublie » les informations antérieures. Par exemple, dans « J'ai emprunté hier à la bibliothèque un livre sur la physique quantique », au moment où il arrive à « livre », il a depuis longtemps oublié que « je » est le sujet, ce qui rend les dépendances à longue distance extrêmement difficiles à capturer.
- Absence de parallélisme :Le RNN doit traiter chaque mot séquentiellement et ne peut pas exploiter la capacité de calcul parallèle des GPU, ce qui rend l'entraînement sur des textes extrêmement longs très lent.
La solution du Transformer
Grâce au mécanisme d'auto-attention, le modèle traite tous les mots simultanément et calcule dynamiquement la force d'association entre chaque paire de mots, résolvant complètement les deux problèmes ci-dessus.
Diagramme de comparaison RNN vs TransformerComparaison : traitement séquentiel des RNN vs traitement parallèle + attention globale du Transformer
Architecture globale du Transformer
Le Transformer se compose de deux parties principales : un encodeur et un décodeur, chacun empilé à partir de plusieurs couches de modules identiques.
Analogie : l'encodeur est comme un « lecteur » qui comprend une phrase chinoise d'entrée comme un ensemble de vecteurs sémantiquement riches ; le décodeur est comme un « traducteur » qui s'appuie sur ces vecteurs et génère une sortie en anglais mot par mot.
Voici le diagramme d'architecture du Transformer, avec l'encodeur à gauche et le décodeur à droite.
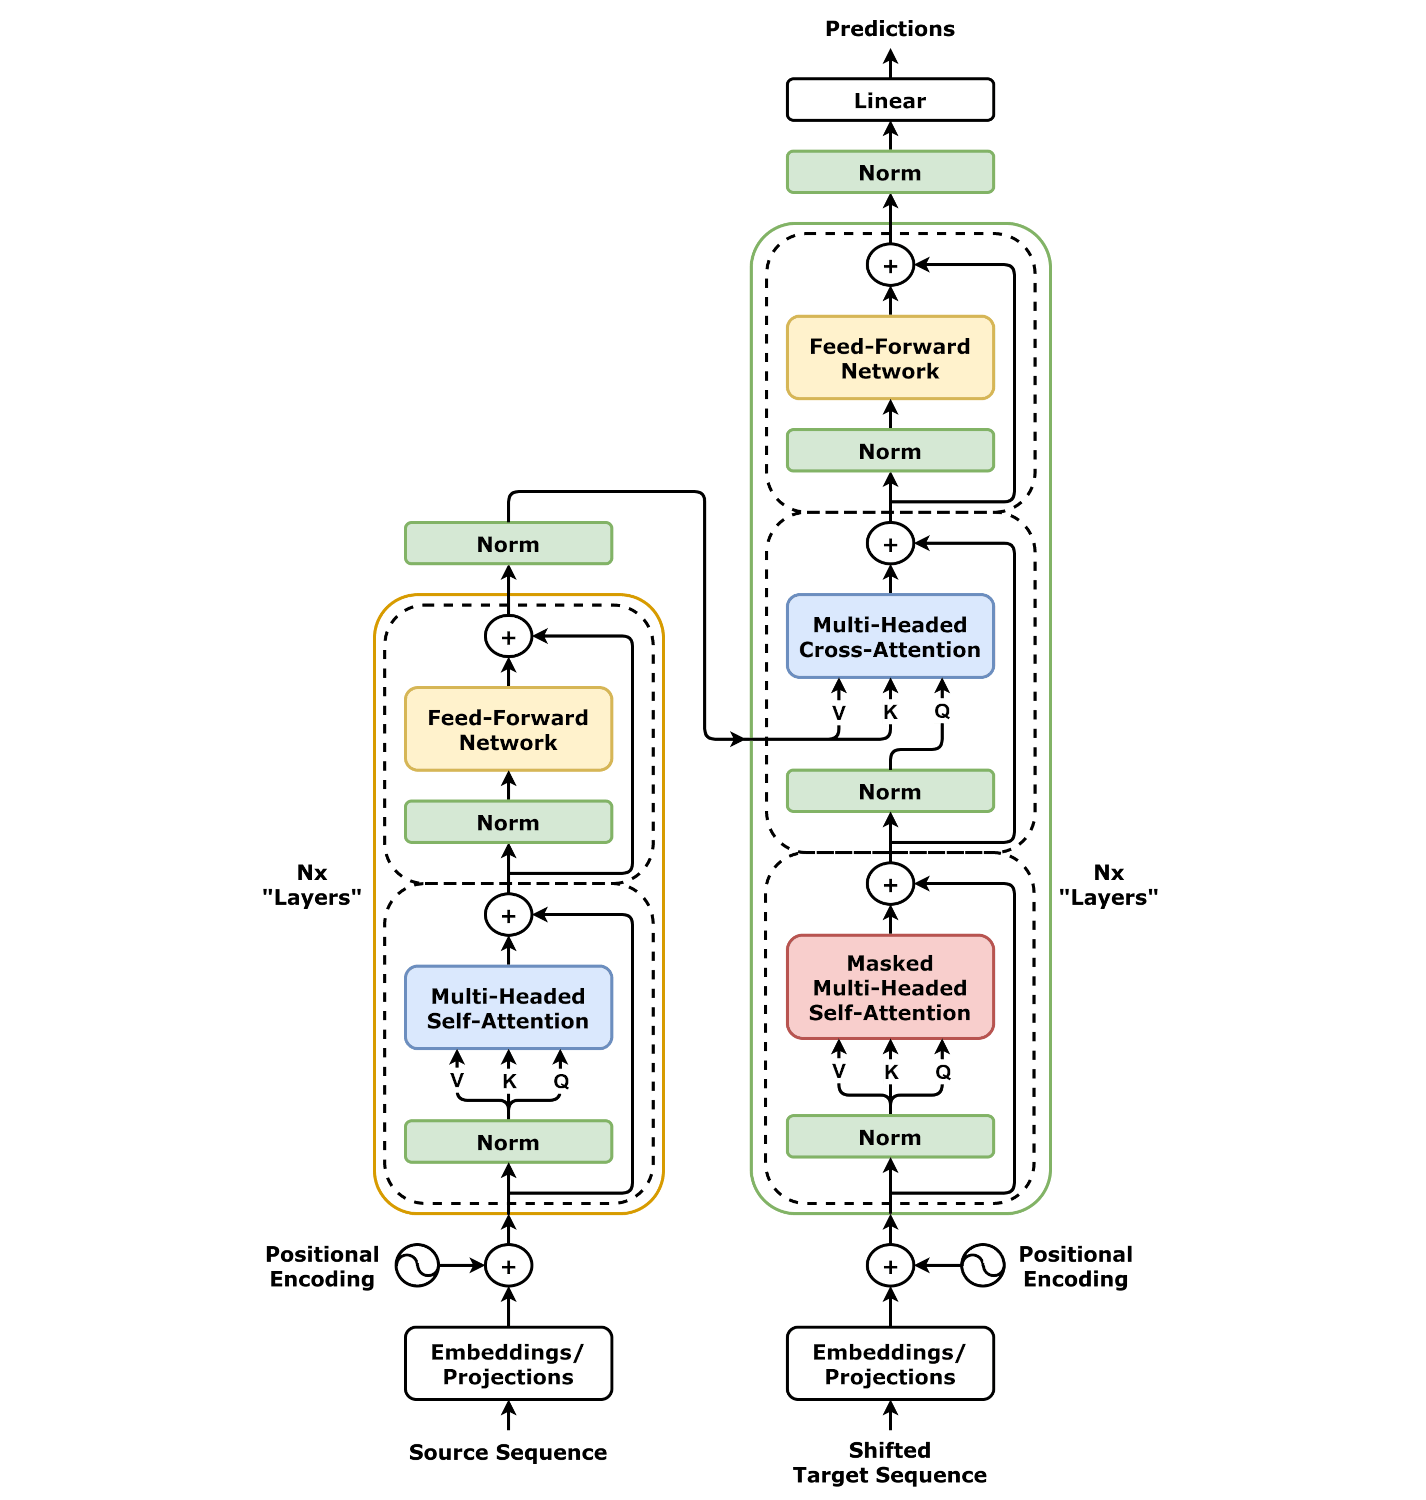
Architecture complète de l'encodeur + décodeur Transformer (les flèches orange indiquent le flux d'informations de l'attention croisée)
Le modèle Transformer se compose de deux parties, un encodeur et un décodeur, chacun composé de plusieurs modules identiques empilés.
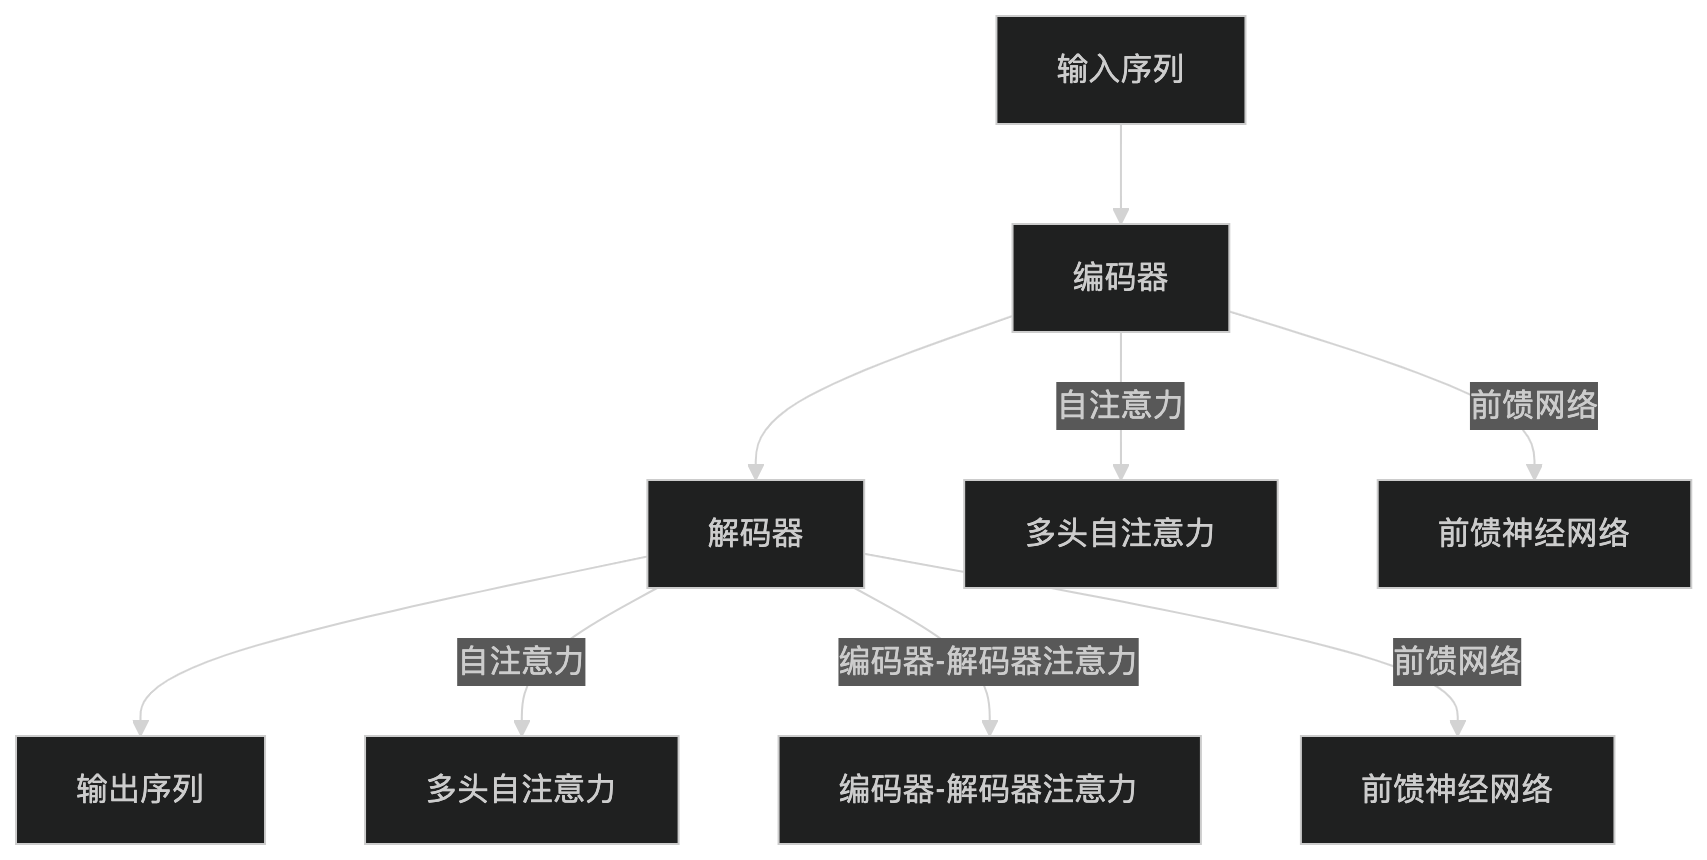
Encodeur
L'encodeur est empilé à partir de N modules identiques, et chaque couche contient deux sous-couches :
- Mécanisme d'auto-attention multi-têtes :Calcule la pertinence de chaque mot par rapport aux autres mots de la séquence d'entrée.
- Réseau de neurones feed-forward :Effectue une transformation non linéaire indépendante sur chaque mot.
Chaque sous-couche est suivie d'une connexion résiduelle et d'une normalisation de couche.
Décodeur
Le décodeur est également empilé à partir de N modules identiques, et chaque couche contient trois sous-couches :
- Mécanisme d'auto-attention multi-têtes masquée :Calcule la pertinence de chaque mot par rapport aux mots précédents dans la séquence de sortie (à l'aide de masques pour empêcher la fuite d'informations futures).
- Mécanisme d'attention Encodeur-Décodeur :Calcule la pertinence entre la séquence de sortie et la séquence d'entrée.
- Réseau de neurones feed-forward :Effectue une transformation non linéaire indépendante sur chaque mot.
De même, chaque sous-couche est suivie d'une connexion résiduelle et d'une normalisation de couche.
Avant l'apparition du modèle Transformer, les principaux modèles en NLP étaient des architectures basées sur les RNN, telles que les réseaux Long Short-Term Memory (LSTM) et les Gated Recurrent Units (GRU). Ces modèles capturent les dépendances dans les séquences en traitant les données d'entrée séquentiellement, mais ils présentent les problèmes suivants :
Problème de disparition du gradient: Les dépendances à longue distance sont difficiles à capturer.
Limitation du calcul séquentiel: Il ne peut pas exploiter pleinement la capacité de calcul parallèle du matériel moderne, ce qui entraîne une faible efficacité d'entraînement.
Transformer résout ces problèmes en introduisant le mécanisme d'auto-attention, permettant au modèle de traiter toute la séquence d'entrée simultanément et d'attribuer dynamiquement différents poids à chaque position de la séquence.
Cœur : Mécanisme d'auto-attention
Le mécanisme d'auto-attention est le composant le plus important du Transformer. Il répond à la question : « Lors du traitement de ce mot, sur quels autres mots de la phrase dois-je me concentrer ? »
Que sont Q, K, V ?
Le vecteur de chaque mot est transformé linéairement en trois rôles : Requête, Clé et Valeur.
Diagramme Q K VL'origine de Q, K, V et le processus de calcul de l'attention
Utiliser une analogie avec un moteur de recherche pour comprendre Q/K/V :
Q (Query) = le mot-clé que vous saisissez dans la zone de recherche, représentant « Que veux-je rechercher ? »
K (Key) = la balise de titre de chaque page web, représentant « Quels mots puis-je faire correspondre ? »
V (Value) = le contenu réel de chaque page web, représentant « Quelle information puis-je fournir ? »
Poids d'attention = la similarité entre Q et chaque K ; le résultat final = une somme pondérée de tous les V à l'aide des poids.
Formule d'attention
\[ \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V \]
où :
- \(Q\)est la matrice de requête,\(K\)est la matrice de clé,\(V\)est la matrice de valeur.
- \(d_k\)est la dimension des vecteurs, utilisée pour mettre à l'échelle le produit scalaire et éviter l'explosion du gradient.
- softmax convertit les scores bruts en une distribution de probabilité entre 0 et 1 (avec des poids dont la somme vaut 1)
Attention multi-têtes
Une seule perspective d'attention est limitée, tout comme le fait de considérer un problème sous un seul angle.
L'attention multi-têtes divise l'entrée en h sous-espaces ; chaque « tête » apprend indépendamment un schéma d'attention différent, et les résultats sont concaténés à la fin.

Encodage positionnel
Le Transformer traite tous les mots simultanément et n'a intrinsèquement aucune « notion d'ordre » — « cat eats fish » et « fish eats cat » seraient traités de la même manière.
L'encodage positionnel est comme ajouter un « numéro de siège » à chaque mot, indiquant au modèle la position de chaque mot dans la phrase.
Comme le Transformer n'a pas d'information explicite sur la séquence (comme les pas de temps dans un RNN), l'encodage positionnel est utilisé pour ajouter des informations de position à chaque mot de la séquence d'entrée. Généralement, les fonctions sinus et cosinus sont utilisées pour générer les encodages positionnels :Analogie : tout comme vous marquez « Question 1, Question 2 » sur une copie d'examen, l'encodage positionnel permet au Transformer de savoir que « I » est le 1er mot, « love » est le 2e mot.
\[ PE_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right) \] \[ PE_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right) \]
où :
\(pos\) est la position du mot, et \(i\) est l'indice de dimension.
Visualisation de l'encodage positionnelL'encodage positionnel est ajouté aux plongements de mots pour injecter des informations de position dans le modèle.
Architecture encodeur-décodeur
Le modèle Transformer se compose de deux parties : un encodeur et un décodeur :
- Encodeur :Convertit la séquence d'entrée en une série de représentations cachées. Chaque couche d'encodeur contient un mécanisme d'auto-attention et un réseau de neurones feed-forward.
- Décodeur :Génère la séquence cible à partir de la sortie de l'encodeur. Chaque couche de décodeur contient deux mécanismes d'attention (auto-attention et attention encodeur-décodeur) et un réseau de neurones feed-forward.
Connexion résiduelle et normalisation par couche
Après la sortie de chaque sous-couche (auto-attention, réseau feed-forward), deux opérations sont effectuées : connexion résiduelle et normalisation de couche, qui aident à stabiliser l'entraînement dans les réseaux profonds.
Schéma de la connexion résiduelleLes connexions résiduelles permettent aux gradients de « court-circuiter » le passage, et la normalisation de couche stabilise l'entraînement.
- Connexion résiduelle :Ajoute directement l'entrée de la sous-couche à sa sortie (output = F(x) + x), évitant les gradients évanescents dans les réseaux profonds et permettant au modèle d'« ignorer sélectivement » la transformation d'une couche.
- Normalisation de couche :Normalise les activations de chaque couche, ce qui rend l'entraînement plus stable et la convergence plus rapide.
Avantages du Transformer
Par rapport aux architectures RNN traditionnelles, le Transformer présente les avantages notables suivants :
Calcul parallèle
Traite la séquence entière en une seule fois, en exploitant pleinement le parallélisme des GPU, avec une vitesse d'entraînement dépassant de loin celle des RNN.
Dépendances à longue portée
Le mécanisme d'auto-attention maintient la « distance de communication » entre deux mots quelconques à 1, n'étant plus limité par la longueur de la séquence.
Forte scalabilité
L'empilement de plus de couches et l'augmentation des dimensions peuvent améliorer les performances, donnant naissance à des modèles puissants tels que BERT et GPT.
Applications du Transformer
L'architecture Transformer a été largement appliquée dans divers domaines de l'IA ; ce qui suit les présente par domaine.
Traitement du langage naturel (NLP)
Vision par ordinateur (CV)
Tâches multimodales
Applications du Transformer
Traitement du langage naturel (NLP):
Traduction automatique (par ex., Google Translate)
Génération de texte (par ex., modèles de la série GPT)
Classification de texte, réponse aux questions, etc.
Vision par ordinateur (CV):
Classification d'images (par ex., Vision Transformer)
Détection d'objets, génération d'images, etc.
Tâches multimodales:
Tâches combinant texte et images (par ex., CLIP, DALL-E).
Exemple d'implémentation PyTorch
Ce qui suit est un exemple complet de Transformer PyTorch avec des commentaires détaillés pour aider les débutants à comprendre chaque étape :
Exemple
import torch.nn as nn
import torch.optim as optim
# --- Définir le modèle Transformer ---
class TransformerModel(nn.Module):
def __init__(self, input_dim, model_dim, num_heads, num_layers, output_dim):
super(TransformerModel, self).__init__()
# Plongement de mots : associe les indices de mots à des vecteurs de dimension model_dim
self.embedding = nn.Embedding(input_dim, model_dim)
# Encodage positionnel : vecteurs de position apprenables, longueur maximale prise en charge 1000
self.positional_encoding = nn.Parameter(
torch.zeros(1, 1000, model_dim)
)
# Transformer intégré de PyTorch (inclut encodeur + décodeur)
self.transformer = nn.Transformer(
d_model=model_dim, # Dimension du vecteur
nhead=num_heads, # Nombre de têtes pour l'attention multi-têtes
num_encoder_layers=num_layers, # Nombre de couches d'encodeur
num_decoder_layers=num_layers # Nombre de couches de décodeur
)
# Couche linéaire finale : projette les vecteurs vers la taille du vocabulaire (pour prédire le mot suivant)
self.fc = nn.Linear(model_dim, output_dim)
def forward(self, src, tgt):
src_seq_length = src.size(1)
tgt_seq_length = tgt.size(1)
# Plongement de mots + encodage positionnel (additionner les deux)
src = self.embedding(src) + self.positional_encoding[:, :src_seq_length, :]
tgt = self.embedding(tgt) + self.positional_encoding[:, :tgt_seq_length, :]
# Passer à travers le Transformer (l'encodeur lit src, le décodeur génère tgt)
transformer_output = self.transformer(src, tgt)
# La couche linéaire produit des probabilités de vocabulaire pour chaque position
output = self.fc(transformer_output)
return output
# --- Réglages des hyperparamètres ---
input_dim = 10000 # Taille du vocabulaire (combien de mots distincts il y a)
model_dim = 512 # Dimension vectorielle pour chaque mot (l'article original utilise 512)
num_heads = 8 # Nombre de têtes d'attention multi-têtes (doit diviser model_dim)
num_layers = 6 # Nombre de couches encodeur/décodeur (l'article original en utilise 6)
output_dim = 10000 # Dimension de sortie (identique à la taille du vocabulaire)
# --- Initialiser le modèle, la fonction de perte et l'optimiseur ---
model = TransformerModel(input_dim, model_dim, num_heads, num_layers, output_dim)
criterion = nn.CrossEntropyLoss() # Perte d'entropie croisée multiclasse
optimizer = optim.Adam(model.parameters(), lr=0.001) # Optimiseur Adam
# --- Construire des données d'exemple (remplacer par un corpus réel en utilisation réelle) ---
# src : séquence source (par ex., chinois), shape = (sequence_length=10, batch_size=32)
src = torch.randint(0, input_dim, (10, 32))
# tgt : séquence cible (par ex., anglais), shape = (sequence_length=20, batch_size=32)
tgt = torch.randint(0, input_dim, (20, 32))
# --- Passe avant ---
output = model(src, tgt)
# output.shape = (20, 32, 10000) : distribution prédite sur le vocabulaire à chaque position
# --- Calculer la perte ---
# view(-1, output_dim) aplatit (20,32,10000) en (640, 10000)
loss = criterion(output.view(-1, output_dim), tgt.view(-1))
# --- Rétropropagation + mise à jour des poids ---
optimizer.zero_grad() # Effacer les gradients de l'étape précédente
loss.backward() # Calculer les gradients
optimizer.step() # Mettre à jour les paramètres
print(f"loss value: {loss.item():.4f}")
Le code ci-dessus utilise des données aléatoires uniquement pour démontrer le flux de travail. Pour un entraînement réel, vous devez :
- 1) Préparez de vrais corpus parallèles (par exemple, des paires de traduction chinois-anglais) ;
- 2) Effectuez la tokenisation et la construction du vocabulaire ;
- 3) Implémentez l'inférence pas à pas du décodeur (génération autorégressive) ;
- 4) Ajustez la stratégie de planification du taux d'apprentissage (l'article original utilise Warmup).
Résumé
L'évolution de RNN à Transformer représente un changement de paradigme important en apprentissage profond.
Diagramme du chemin d'évolutionChemin d'évolution du RNN au Transformer
Les trois innovations majeures du Transformer ont complètement transformé le paysage de l'apprentissage profond :
- Mécanisme d'auto-attention—permettant à deux mots quelconques de « parler » directement, en disant adieu aux gradients évanescents.
- Parallélisation complète—un bond qualitatif en vitesse d'entraînement, rendant possible le pré-entraînement à grande échelle.
- Architecture universelle—du NLP à la CV et au multimodal, le Transformer est devenu la « brique universelle » de l'ère de l'IA.
Maîtrisez le Transformer, et vous détenez la clé pour comprendre les modèles d'IA modernes comme GPT, BERT et Stable Diffusion.
Aide-mémoire terminologique
| Terme | Anglais | Description |
|---|---|---|
| Auto-attention | Auto-attention | Un mécanisme qui calcule les corrélations entre les éléments d'une séquence |
| Attention multi-têtes | Attention multi-têtes | Plusieurs têtes d'attention calculent en parallèle pour capturer des informations provenant de différents sous-espaces de caractéristiques |
| Encodage positionnel | Encodage positionnel | Une technique qui fournit au modèle des informations positionnelles sur les éléments d'une séquence |
| Connexion résiduelle | Connexion résiduelle | Ajoute directement l'entrée à la sortie de la sous-couche pour atténuer la disparition des gradients |
| Normalisation de couche | Normalisation par couche | Normalise les valeurs d'activation de chaque couche pour accélérer la convergence de l'entraînement |
| Encodeur | Encodeur | Encode la séquence d'entrée en représentations contextuelles |
| Décodeur | Décodeur | Génère la séquence cible à partir de la sortie de l'encodeur |
| Attention croisée | Attention croisée | Un mécanisme d'attention où le décodeur prête attention à la sortie de l'encodeur |
| Attention masquée | Attention masquée | Un mécanisme dans le décodeur qui empêche de prêter attention aux informations positionnelles futures |
| Réseau feed-forward | Réseau feed-forward | Couche entièrement connectée appliquée indépendamment à chaque position |